
Bei statischer Analyse geht es nicht nur darum, Fehler direkt zu finden, sondern auch fehleranfällige Situationen aufzudecken, die Lesbarkeit und Wartbarkeit des Codes beeinträchtigen können. Statische Analyse kann viele weitere Eigenschaften des Codes untersuchen:
- Code-Metriken: Methoden mit zu vielen Schleifen sowie if-, else-, switch- und case-Anweisungen werden beispielsweise schwer verständlich und damit schwer wartbar. Die Erfassung dieser Strukturen über die Code-Metrik der zyklomatischen Komplexität ist eine gute Möglichkeit zu beurteilen, wann eine Methode zu komplex wird.
- Abhängigkeiten: Wenn die Klassen Ihres Programms stark miteinander verflochten sind, werden die Auswirkungen von Codeänderungen unvorhersehbar. Statische Analyse hilft dabei zu erkennen, wann Klassen und Komponenten zu eng gekoppelt sind.
- Unveränderlichkeit: Typen, die gleichzeitig von mehreren Threads verwendet werden, sollten unveränderlich sein. Andernfalls müssen Lese- und Schreibzugriffe auf den Zustand durch komplexe Locking-Strategien geschützt werden, die letztlich kaum wartbar sind. Statische Analyse kann sicherstellen, dass bestimmte Klassen unveränderlich bleiben.
- Toter Code: Toter Code ist Code, der sicher entfernt werden kann, weil er zur Laufzeit nicht mehr aufgerufen wird. Er kann nicht nur entfernt werden, sondern muss entfernt werden, weil dieser zusätzliche Code dem Programm unnötige Komplexität hinzufügt. Statische Analyse kann den größten Teil des toten Codes in Ihrem Programm finden, wenn auch nicht vollständig.
- API-Breaking-Changes: Wenn Sie Ihren Kunden eine API bereitstellen, kann leicht unbemerkt ein öffentliches Member entfernt und dadurch der Code Ihrer Kunden beschädigt werden. Statische Analyse kann zwei Zustände eines Programms vergleichen und vor dieser Gefahr warnen.
- API-Nutzung: Manche APIs müssen mit besonderer Sorgfalt verwendet werden. Eine Klasse mit freizugebenden Feldern sollte beispielsweise in der Regel selbst freigebbar sein – außer wenn die Lebensdauer des betreffenden Feldes nicht mit der Lebensdauer der Klasseninstanz übereinstimmt. Das wiederum deutet auf ein Designproblem hin.
Ein Code Smell kann ebenfalls als fehleranfällige Situation betrachtet werden. Hier ist die Definition aus Wikipedia:
In computer programming, code smell, (or bad smell) is any symptom in the source code of a program that possibly indicates a deeper problem. According to Martin Fowler, "a code smell is a surface indication that usually corresponds to a deeper problem in the system". Another way to look at smells is with respect to principles and quality: "smells are certain structures in the code that indicate violation of fundamental design principles and negatively impact design quality". Code smells are usually not bugs—they are not technically incorrect and do not currently prevent the program from functioning. Instead, they indicate weaknesses in design that may be slowing down development or increasing the risk of bugs or failures in the future. Bad code smells can be an indicator of factors that contribute to technical debt. Robert C. Martin calls a list of code smells a "value system" for software craftsmanship.Viele nützliche Tools können Fehler in einer C++-Codebasis erkennen, darunter Cppcheck, Clang-Tidy und der Visual-Studio-Analyzer. Doch wie sieht es mit der Erkennung von Code Smells aus?
Während die Entwickler statischer Analysetools festlegen können, welche Situationen als Fehler gelten, sind Code Smells subjektiver und hängen von den Entscheidungen des Entwicklungsteams ab. Ein Team kann beispielsweise eine Methode mit mehr als 20 Zeilen als komplex einstufen, während ein anderes die Grenze bei 30 Zeilen setzt. Wenn ein Tool Code Smells erkennt, muss es Teams daher auch ermöglichen, die entsprechenden Regeln und Schwellenwerte anzupassen.
Code als Daten zu behandeln ist der beste Weg, Code Smells zu erkennen
Statische Analyse bedeutet, Quellcode auf verschiedene Eigenschaften zu untersuchen und darüber zu berichten. Philosophisch betrachtet bedeutet sie aber auch, Code als Daten zu behandeln. Für Anwendungsentwickler kann das zunächst ungewohnt wirken, weil wir Quellcode normalerweise als Anweisungen, Abläufe und Algorithmen verstehen. Code als Daten zu behandeln ist jedoch äußerst leistungsfähig.
Nach der Analyse einer Quelldatei können wir ihren AST extrahieren und ein Modell erzeugen, das eine Fülle nützlicher Informationen über den Code enthält. Dieses Modell lässt sich anschließend mit einer SQL-ähnlichen Code-Abfragesprache durchsuchen.
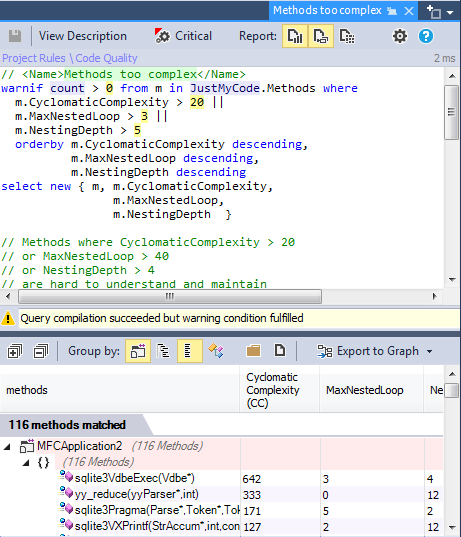
CppDepend stellt eine Code-Abfragesprache namens CQLinq bereit, mit der sich die Codebasis wie eine Datenbank abfragen lässt. Entwickler, Designer und Architekten können eigene Abfragen definieren, um Code Smells einfach zu finden.
Mit CQLinq lassen sich Daten aus Code-Metriken, Abhängigkeiten, API-Nutzung und weiteren Modellinformationen kombinieren, um anspruchsvolle Abfragen zu definieren, die bestimmte Code Smells identifizieren.
Hier ist ein Beispiel für eine CQLinq-Abfrage, die die komplexesten Methoden findet:
Zusammenfassung
Oft ist es sinnvoll, mehrere C++-Tools zu kombinieren, um Probleme in Ihrer Codebasis zu erkennen: Einige konzentrieren sich auf Fehler, andere können zusätzlich Code Smells aufdecken. CppDepend führt diese Ansätze zusammen, indem es eine einfache Möglichkeit bietet, eigene Abfragen zu definieren und Ergebnisse anderer statischer Analysetools zu importieren, sodass auch diese mit CQLinq abgefragt werden können.