
Wenn Sie im Web nach dem besten C++-Quellcode suchen, wird der Doom-3-Quellcode immer wieder genannt – oft mit Kommentaren wie diesem.
Ich habe einige Zeit damit verbracht, den Doom-3-Quellcode durchzugehen. Er ist wahrscheinlich der sauberste und am besten aussehende Code, den ich je gesehen habe.
Doom 3 ist ein Videospiel, das von id Software entwickelt und von Activision. Das Spiel war für id Software ein kommerzieller Erfolg und verkaufte sich mehr als 3,5 Millionen Mal.
Am 23. November 2011 setzte id Software seine Tradition fort und veröffentlichte den Quellcode der vorherigen Engine. Viele Entwickler haben diesen Quellcode untersucht; hier ist beispielsweise eine Einschätzung von Fabien (Originalquelle):
Doom 3 BFG ist in C++ geschrieben, einer so umfangreichen Sprache, dass sich damit hervorragender Code, aber auch erschreckend schlechter Code erzeugen lässt. Glücklicherweise entschied sich id Software für eine C++-Teilmenge, die „C with Classes“ nahekommt und sich vergleichsweise leicht nachvollziehen lässt:
- Keine Exceptions.
- Keine Referenzen (stattdessen Pointer).
- Minimaler Einsatz von Templates.
- Const überall.
- Klassen.
- Polymorphie.
- Vererbung.
Viele C++-Experten empfehlen den Ansatz „C with Classes“ heute nicht mehr. Doom 3 wurde jedoch zwischen 2000 und 2004 entwickelt, was das Fehlen moderner C++-Mechanismen erklären kann.
Sehen wir uns den Quellcode mit CppDepend genauer an und finden wir heraus, was ihn so besonders macht.
Doom 3 ist in mehrere Projekte modularisiert. Hier ist die Liste der Projekte mit einigen Statistiken zu ihren Typen:
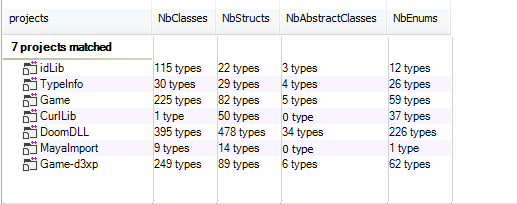
Und hier ist der Abhängigkeitsgraph, der die Beziehungen zwischen ihnen zeigt:
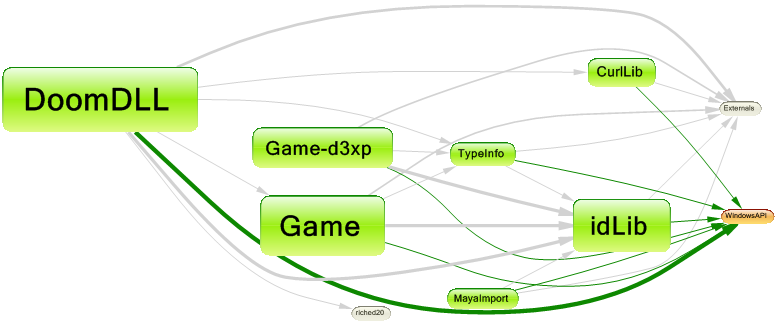
Doom 3 definiert viele globale Funktionen. Der Großteil der Verarbeitung ist jedoch in Klassen implementiert.
Das Datenmodell wird mithilfe von Structs definiert. Um konkret zu sehen, wie Structs im Quellcode eingesetzt werden, stellt die obige Metric View sie als blaue Rechtecke dar.
In der Metric View wird die Codebasis als Treemap dargestellt. Treemapping ist eine Methode zur Visualisierung baumartig strukturierter Daten mithilfe verschachtelter Rechtecke. Als Baumstruktur dient dabei die übliche Codehierarchie:
- Projekte enthalten Namespaces.
- Namespaces enthalten Typen.
- Typen enthalten Methoden und Felder.
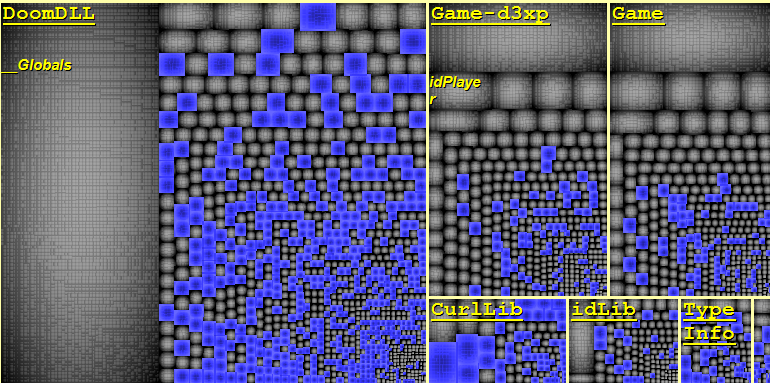
Wie zu erkennen ist, werden sehr viele Structs definiert – beispielsweise sind mehr als 40 % der DoomDLL-Typen Structs. Sie werden systematisch zur Definition des Datenmodells eingesetzt. Diese Praxis findet sich in vielen Projekten, hat bei Multithread-Anwendungen jedoch einen großen Nachteil: Structs mit öffentlichen Feldern sind nicht immutable.
Für immutable Objekte spricht ein wichtiges Argument: Sie vereinfachen nebenläufige Programmierung erheblich. Warum ist korrekter Multithread-Code so schwierig? Weil sich die Zugriffe verschiedener Threads auf Ressourcen – Objekte oder andere Betriebssystemressourcen – nur schwer synchronisieren lassen. Und warum ist diese Synchronisierung schwierig? Weil sich nur schwer garantieren lässt, dass bei den zahlreichen Lese- und Schreibzugriffen mehrerer Threads auf mehrere Objekte keine Race Conditions entstehen. Was aber, wenn es keine Schreibzugriffe mehr gibt? Anders gesagt: Was, wenn sich der Zustand der von Threads verwendeten Objekte nicht verändert? Dann ist auch keine Synchronisierung mehr erforderlich!
Suchen wir nach Klassen mit mindestens einer Basisklasse:
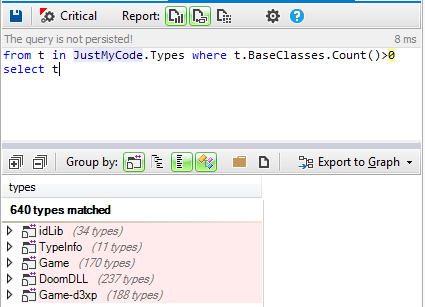
Fast 40 % der Structs und Klassen besitzen eine Basisklasse. Einer der wichtigsten Vorteile der Vererbung in der OOP ist die Polymorphie. Die im Quellcode definierten virtuellen Methoden sind blau dargestellt:
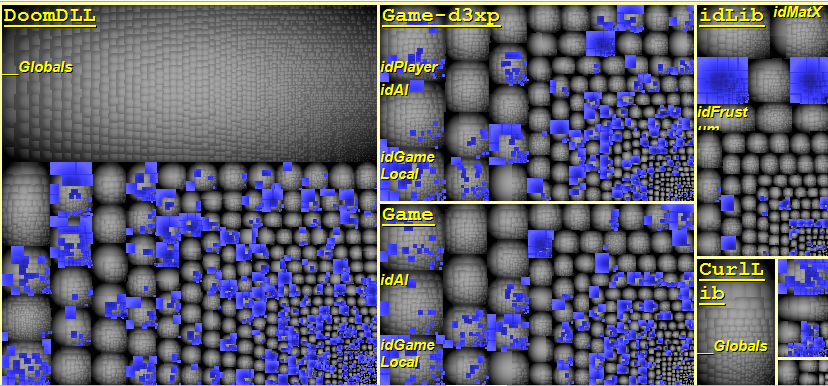
Mehr als 30 % der Methoden sind virtuell. Nur wenige davon sind rein virtuell; hier ist die Liste aller definierten abstrakten Klassen:
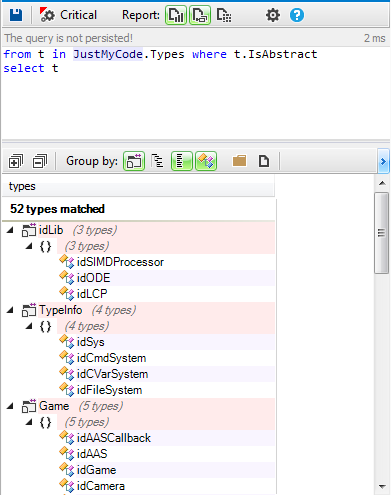
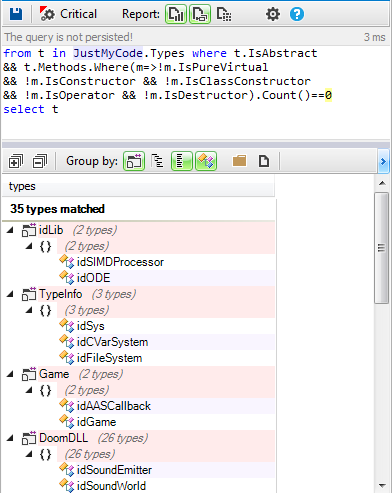
Es sind lediglich 52 abstrakte Klassen definiert, davon 35 reine Interfaces, das heißt, alle ihre virtuellen Methoden sind rein virtuell.
Suchen wir nach Methoden, die RTTI verwenden.
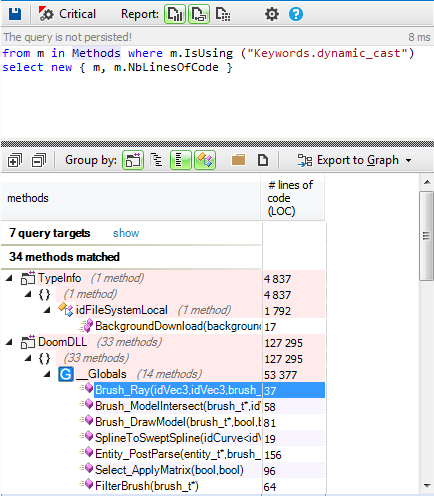
Nur sehr wenige Methoden verwenden RTTI.
Zusammenfassend werden nur grundlegende OOP-Konzepte eingesetzt: keine fortgeschrittenen Design Patterns, kein übermäßiger Einsatz von Interfaces oder abstrakten Klassen, RTTI nur in begrenztem Umfang und Structs zur Definition der Daten.
Bis hierhin unterscheidet diesen Code nichts Besonderes von vielen anderen Projekten, die „C with Classes“ verwenden – ein Ansatz, der von zahlreichen C++-Entwicklern kritisiert wird.
Einige interessante Entscheidungen der Entwickler helfen jedoch, seinen Erfolg zu erklären:
1. Eine gemeinsame Basisklasse mit nützlichen Diensten bereitstellen
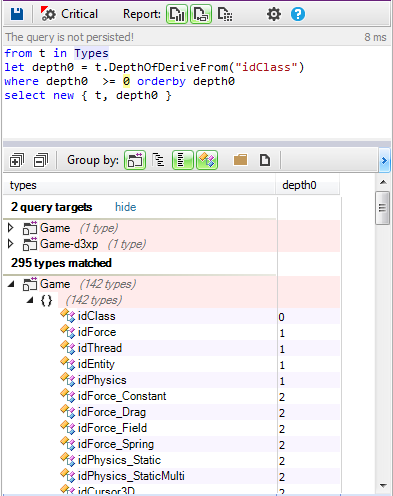
Viele Klassen erben von idClass:
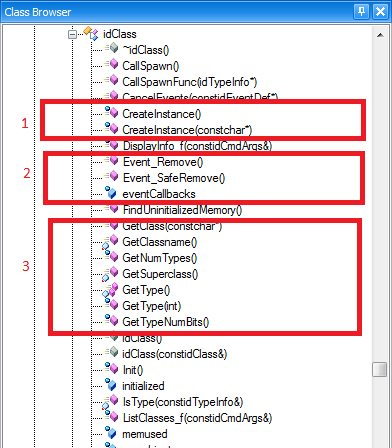
idClass stellt folgende Dienste bereit:
- Instanzerzeugung.
- Verwaltung von Typinformationen.
- Event-Verwaltung.
2. String-Verarbeitung vereinfachen
Strings gehören in einem Projekt normalerweise zu den am häufigsten verwendeten Typen. Viele Operationen arbeiten mit Strings, weshalb entsprechende Funktionen zu ihrer Verarbeitung benötigt werden.
Doom 3 definiert die Klasse idStr, die nahezu alle nützlichen Methoden zur String-Verarbeitung enthält. Eigene Methoden müssen daher nicht ständig ergänzt werden, wie es bei vielen String-Klassen anderer Frameworks der Fall ist.
3. Der Quellcode ist stark vom GUI-Framework MFC entkoppelt
In vielen Projekten, die MFC verwenden, ist der Code stark an dessen Typen gekoppelt, sodass MFC-Typen praktisch überall in der Codebasis auftauchen.
In Doom 3 ist der Code dagegen stark von MFC entkoppelt. Nur die GUI-Klassen besitzen eine direkte Abhängigkeit davon, wie diese CQLinq-Abfrage zeigt:
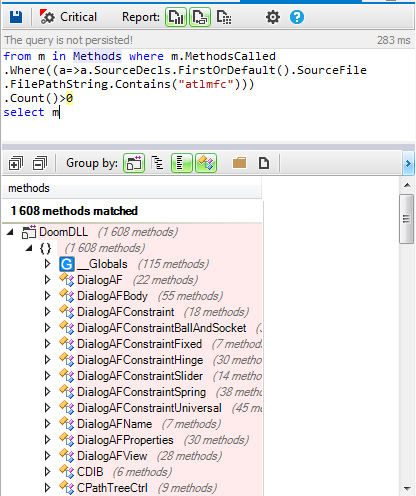
Diese Entscheidung wirkt sich deutlich auf die Produktivität aus. Nur die GUI-Entwickler müssen sich mit dem MFC-Framework befassen; alle anderen Entwickler müssen dafür keine Zeit aufwenden.
4. Eine sehr gute Utility-Bibliothek bereitstellen (idlib)
In fast allen Projekten gehören Utility-Klassen zu den meistverwendeten Typen, wie das Ergebnis dieser Abfrage zeigt:
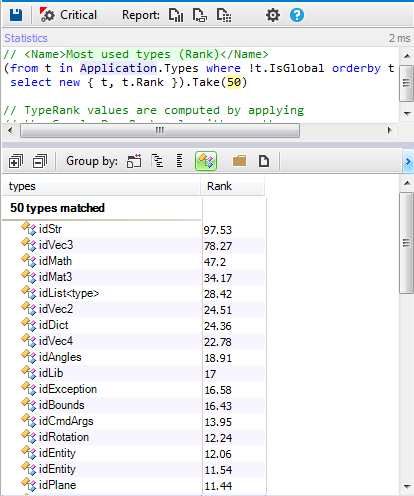
Wie zu erkennen ist, werden Utility-Typen besonders häufig verwendet. Ohne ein gutes Utility-Framework verbringen C++-Entwickler einen erheblichen Teil ihrer Entwicklungszeit damit, sich mit der technischen Schicht auseinanderzusetzen.
idlib stellt nützliche Klassen mit den erforderlichen Methoden für Strings, Container und Speicherverwaltung bereit. Das erleichtert die Arbeit der Entwickler und ermöglicht ihnen, sich stärker auf die Spiellogik zu konzentrieren.
5. Die Implementierung ist sehr leicht verständlich
Doom 3 implementiert einen fest codierten Compiler. Wie C++-Entwickler wissen, ist die Entwicklung von Parsern und Compilern keine einfache Aufgabe. Dennoch ist die Doom-3-Implementierung sehr leicht nachzuvollziehen und der Code ausgesprochen sauber.
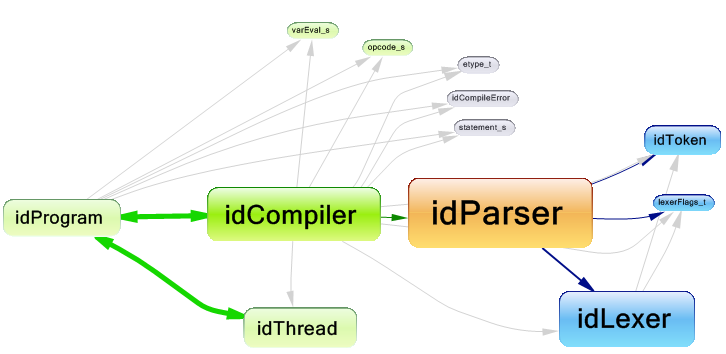
Hier ist der Abhängigkeitsgraph der vom Compiler verwendeten Klassen:
Und hier ein Codeausschnitt aus dem Compiler-Quellcode:
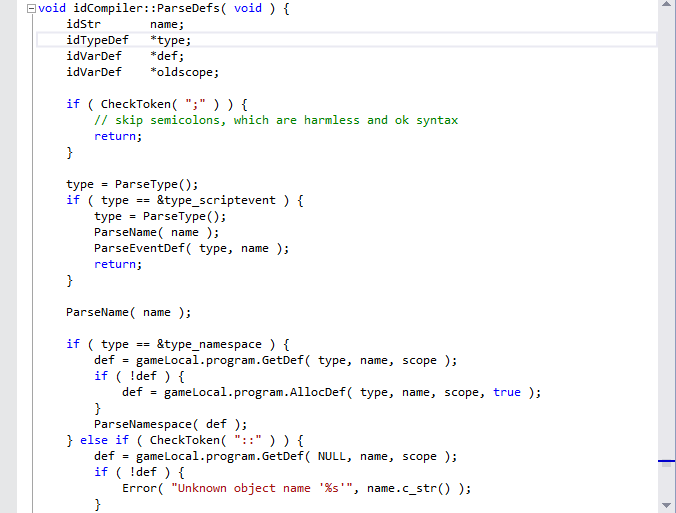
Wir haben bereits den Quellcode vieler Parser und Compiler untersucht. Doch dies ist das erste Mal, dass wir auf einen Compiler stoßen, dessen Quellcode so leicht verständlich ist – und dasselbe gilt für den gesamten Doom-3-Quellcode. Es wirkt fast wie Magie. Beim Erkunden des Doom-3-Quellcodes kann man kaum anders, als zu sagen: WOW, das ist wirklich schön!
Zusammenfassung
Auch wenn die Designentscheidungen von Doom 3 sehr grundlegend erscheinen, haben die Entwickler zahlreiche Entscheidungen getroffen, die es ermöglichen, sich stärker auf die Spiellogik zu konzentrieren und die technischen Schichten zu vereinfachen. Das steigert die Produktivität erheblich.
Wer jedoch „C with Classes“ verwendet, muss genau wissen, was er tut. Dafür ist ein hohes Maß an Erfahrung erforderlich, wie es die Doom-3-Entwickler besitzen. Anfängern ist nicht zu empfehlen, moderne C++-Empfehlungen zu ignorieren und damit unnötige Risiken einzugehen.