
Linux, PHP et Git sont des projets populaires développés en C. De l'autre côté, OpenOffice, Firefox, Clang et Photoshop sont développés en C++, ce qui montre que les deux langages conviennent bien au développement d'applications complexes. Essayer de prouver qu'un langage est meilleur que l'autre n'est peut-être pas le débat le plus utile. En revanche, nous pouvons discuter des motivations derrière le choix de l'un plutôt que de l'autre.
Quand j'ai lu pour la première fois l' opinion de Linus Torvalds sur le C++, j'étais en complet désaccord avec son point de vue en tant que développeur C++. Mais c'est le point de vue du développeur principal du noyau Linux et de Git, il mérite donc d'être examiné attentivement.
Après avoir relu son opinion, je me suis trouvé d'accord avec cette affirmation :
inefficient abstracted programming models where two years down the road you notice that some abstraction wasn't very efficient, but now all your code depends on all the nice object models around it, and you cannot fix it without rewriting your app.Il est vrai que le C++ offre plus de possibilités pour écrire du code élégant et bien structuré, mais cela a un prix : les changements et les refactorisations peuvent être difficiles. Cependant, cela ne signifie pas que je doive choisir un autre langage. Chaque langage ou bibliothèque implique des compromis, et nous devons savoir comment limiter l'impact des changements potentiels sur notre code C++ après des années de développement.
Analysons le code source de Git avec CppDepend, identifions quelques caractéristiques de conception, et comparons le C et le C++ dans deux domaines :
- La facilité de compréhension.
- La gestion des changements.
La modularité : physique vs logique
La modularité est une technique de conception logicielle qui consiste à composer un logiciel à partir de parties distinctes ; le code modulaire est plus facile à gérer et à maintenir.
Nous pouvons modulariser un projet selon deux approches :
- Physiquement : en utilisant des répertoires et des fichiers. Cette forme de modularité est fournie par le système d'exploitation et peut s'appliquer à n'importe quel langage.
- Logiquement : en utilisant des espaces de noms, des composants, des classes et des structs. Cette technique dépend des capacités du langage.
Lorsqu'on développe en C, on utilise principalement la modularité physique pour organiser le code. Les répertoires servent à isoler les modules. Voici le graphe de dépendances entre quelques répertoires de Git :
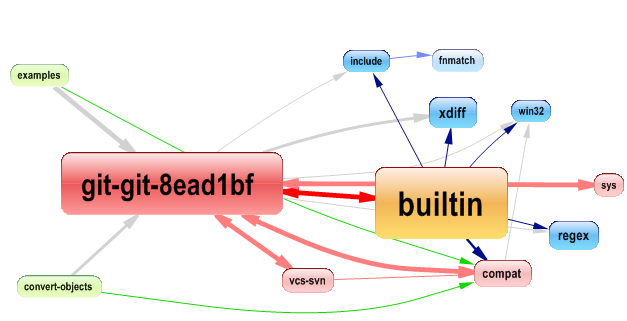
Cependant, avec le C++, nous pouvons utiliser des espaces de noms pour modulariser la base de code ; ces artefacts sont fournis par le langage lui-même. Dans le graphe précédent, les formes pourraient être des espaces de noms modularisant notre code au lieu de répertoires.
L'impact du choix de l'une de ces deux approches :Facilité de compréhension: l'approche logique est meilleure car la modularité est clairement définie par des constructions du langage, et simplement en lisant le code, on peut dire à quel module appartient un élément de code.
Gestion des changements: une bonne conception exige généralement de nombreuses itérations, et avec l'approche physique, l'impact des changements de conception peut être beaucoup plus limité qu'avec l'approche logique. Il suffit parfois de déplacer une fonction ou une variable d'un fichier à un autre, ou un fichier d'un répertoire à un autre.
En C++, en revanche, un tel changement peut affecter beaucoup de code car la modularité logique est implémentée par des constructions du langage et nécessite donc des modifications du code.
Encapsulation : classe vs fichier
En C++, l'encapsulation est définie comme le processus consistant à combiner des données et des fonctions en une seule unité appelée classe. Avec l'encapsulation, le programmeur ne peut pas accéder directement aux données ; celles-ci ne sont accessibles qu'à travers les fonctions présentes dans la classe.
En C, nous pouvons aussi réaliser l'encapsulation, mais par une approche physique comme celle décrite dans la section sur la modularité : un fichier peut contenir des fonctions et les données qu'elles utilisent, et nous pouvons restreindre la visibilité des fonctions et des variables avec le mot-clé « static ».
Git utilise cette technique pour masquer des fonctions et des variables. Pour le vérifier, recherchons les fonctions statiques :
from m in Methods where m.IsStatic select m
Le treemap est très utile pour avoir une vue d'ensemble des éléments de code correspondant à une requête CQLinq ; les rectangles bleus représentent les résultats.
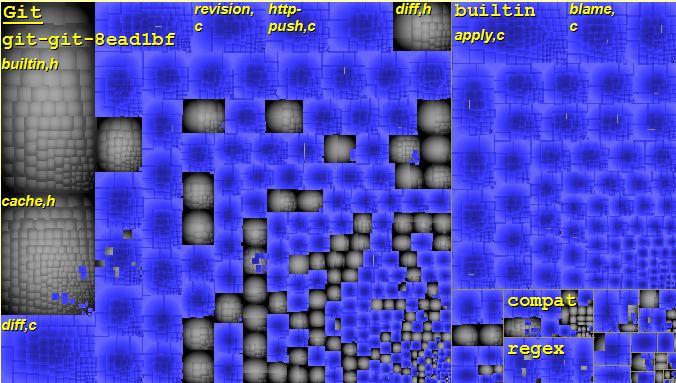
Presque toutes les fonctions sont déclarées static afin d'être visibles uniquement dans l'unité de traduction où elles sont déclarées ; il en va de même pour les variables.
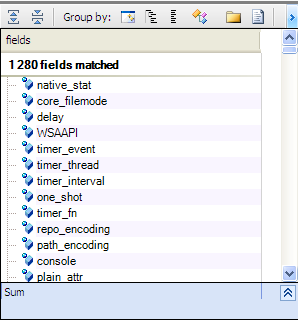
from f in Fields where f.IsStatic select f
 Facilité de compréhension :
L'utilisation des mécanismes d'encapsulation du C++ améliore la lisibilité et l'organisation du code ; le C est plus bas niveau et s'appuie davantage sur une approche physique que logique.
Gestion des changements: si nous devons changer l'endroit où une variable ou une fonction est encapsulée, cela peut être très facile en C, alors qu'en C++ cela peut affecter beaucoup de code.
Polymorphisme vs l'idiome de sélection
Le polymorphisme signifie que du code, des opérations ou des objets se comportent différemment selon les contextes.
Cette technique est largement utilisée dans les projets C++, mais qu'en est-il du C ?
Dans les langages procéduraux, la sélection est implémentée à travers des mots-clés comme « switch », « if » ou même « goto », mais cette technique tend à augmenter la complexité cyclomatique du code.
Recherchons les fonctions complexes dans le code source de Git.
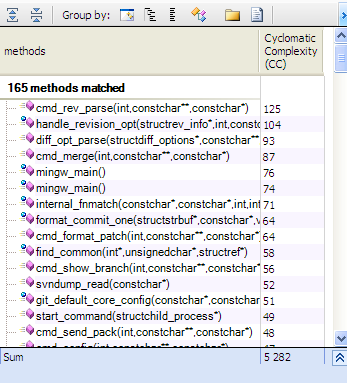
Même si Git est bien conçu, de nombreuses fonctions pourraient être considérées comme complexes. Cela tient en partie à l'utilisation extensive d'instructions de contrôle de flux comme « if », « switch » et « goto ». En C++, en revanche, nous pouvons utiliser le polymorphisme pour réduire la complexité du code.
Facilité de compréhension : utiliser le polymorphisme permet d'isoler un comportement spécifique dans une classe, améliorant la lisibilité et la cohésion du code.
Gestion des changements : ajouter un autre comportement avec le polymorphisme peut nécessiter l'ajout d'une autre classe ; avec l'idiome de sélection, en revanche, il suffit d'ajouter un autre case à l'instruction switch.
Héritage vs composition
Git utilise principalement des structs pour définir les données manipulées par les fonctions. Recherchons tous les structs qu'il utilise :
from t in Types where t.IsStructure select t
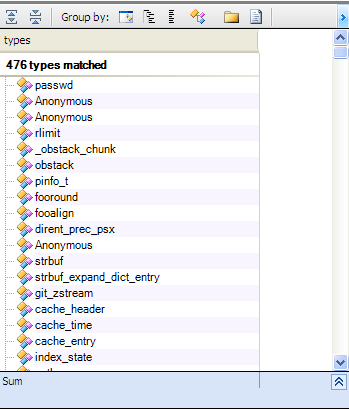
Fait intéressant, presque toutes les données sont contenues dans des structs. Pour le vérifier, nous pouvons rechercher toutes les variables primitives publiques non const qui ne sont pas dans un struct :
from f in Fields where f.IsPublic && f.IsPrimitiveType
&& !f.IsStatic && !f.IsConst
select f
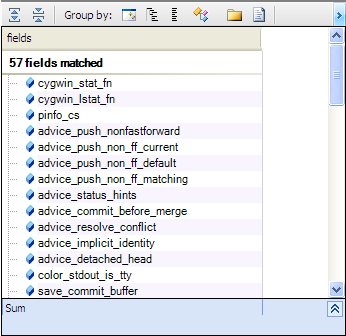
Seules quelques variables correspondent à cette requête, ce qui est un aspect positif de la conception de Git.
Alors, comment étendre un struct ? En C, nous pouvons utiliser la composition, comme avec le struct « remote », que de nombreux structs référencent.
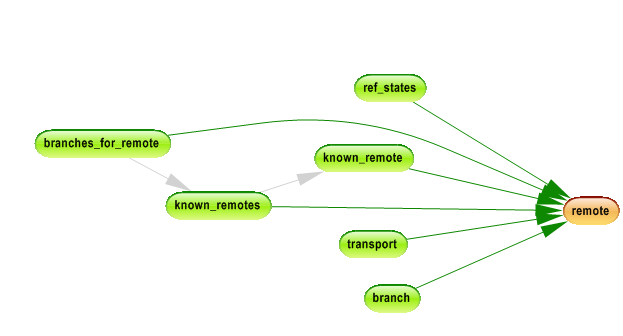
En C++, en revanche, nous pouvons aussi utiliser l'héritage pour étendre les structs ; par exemple, le struct known_remote pourrait hériter de remote.
Facilité de compréhension: utiliser l'héritage peut rendre les relations entre données plus faciles à comprendre, mais il doit être utilisé avec prudence ; il ne devrait servir que pour une relation « est-un ».
Gestion des changements: l'héritage introduit un couplage plus fort, donc un changement peut affecter beaucoup de code.
Conclusion :
Le C++ offre plus de possibilités pour écrire du code élégant et bien structuré, mais cela a un prix : les changements et les refactorisations peuvent être difficiles.
La refactorisation exige de comprendre le code existant avant d'apporter des changements. Les programmes C peuvent être plus difficiles à comprendre mais plus faciles à modifier, tandis qu'un projet C++ peut être plus structuré qu'un projet C mais exiger plus d'efforts lors des changements.
Comment limiter l'impact des changements en C++ ?
Une bonne façon de limiter l'impact des changements avec une approche POO est d'appliquer les design patterns, en particulier les principes de faible couplage et de forte cohésion, pour isoler les changements dans des zones spécifiques.
Une autre approche efficace consiste à adopter la programmation générique et les pratiques du C++ moderne. La programmation générique peut être plus flexible que la POO et peut aider à limiter l'impact des changements sur le code C++.