
En tant que développeurs de logiciels, nous pouvons écrire beaucoup de code chaque jour. Chaque morceau de code a sa propre histoire. Il peut être :
- Inspiré d'une ressource web (forum, tutoriel, billet de blog, etc.).
- Inspiré d'un projet open source de GitHub, SourceForge ou d'ailleurs.
- Copié-collé depuis le projet lui-même.
- Développé à partir de zéro.
Pour chaque morceau de code, le développeur analyse le problème à résoudre. Son parcours et les avis de son équipe peuvent grandement influencer ses choix et la manière dont le code est écrit.
Après avoir écrit et commité du code, gardez à l'esprit qu'il peut introduire de la dette technique que les mainteneurs et développeurs du projet devront traiter tôt ou tard. Pour minimiser cette dette et faciliter la tâche de tous ceux qui travaillent sur le projet, il est préférable d'adopter quelques bonnes habitudes qui gardent le code propre dès le départ.
1. Le nommage
Il nous arrive de passer beaucoup de temps juste à essayer de comprendre le rôle d'une variable ou d'une fonction parce qu'elle s'appelle a, b ou x. Si on lui avait donné un nom clair et significatif dès le début, sa signification serait évidente.
Des noms clairs et significatifs, suivant une convention de nommage cohérente, aident à :
- Réduire l'effort nécessaire pour lire et comprendre le code source ;
- Permettre aux revues de code de se concentrer sur des questions plus importantes plutôt que sur des débats de syntaxe et de conventions de nommage.
- Permettre aux outils de qualité de code de concentrer leurs rapports sur les problèmes significatifs plutôt que sur les préférences de syntaxe et de style.
2. La visibilité
Restreindre la visibilité est une bonne pratique car elle favorise l'encapsulation. Garder une portée minimale aide les utilisateurs de votre code à comprendre exactement quels membres sont destinés à être accessibles depuis l'extérieur d'une classe.
Rendre toutes les méthodes d'une classe publiques peut dérouter les utilisateurs et obscurcir le contrat de la classe ; dans ce cas, une documentation est nécessaire pour déterminer quelles méthodes sont destinées à être utilisées.
3. Les paramètres
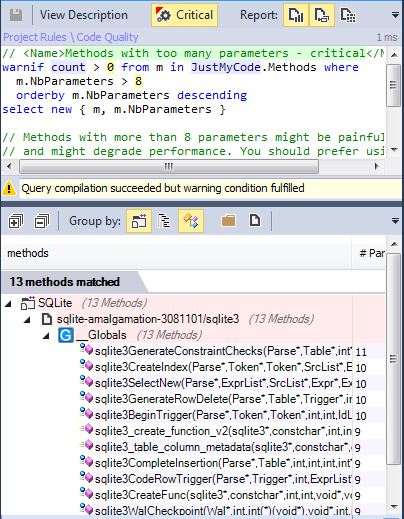
Une fonction qui prend plus de cinq paramètres révèle l'un de ces deux problèmes :
- La fonction en fait trop. Elle devrait être scindée en plusieurs fonctions plus petites, chacune avec un ensemble de paramètres réduit.
- Il y a un autre objet qui se cache là-dedans. Vous devrez peut-être créer un autre objet ou une autre structure de données regroupant ces paramètres.
Procéder ainsi offre plusieurs avantages :
- Cela rend votre code plus facile à lire.
- Cela facilite les tests unitaires.
4. La taille
Les méthodes trop longues ne sont pas faciles à maintenir ni à comprendre. Voici quelques conseils sur la longueur des fonctions, tirés de la page web du style de codage Linux:
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.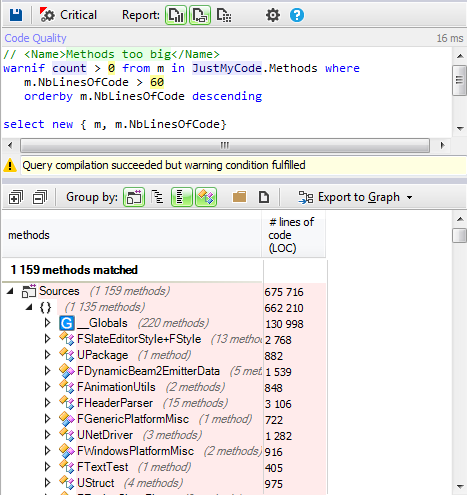
:
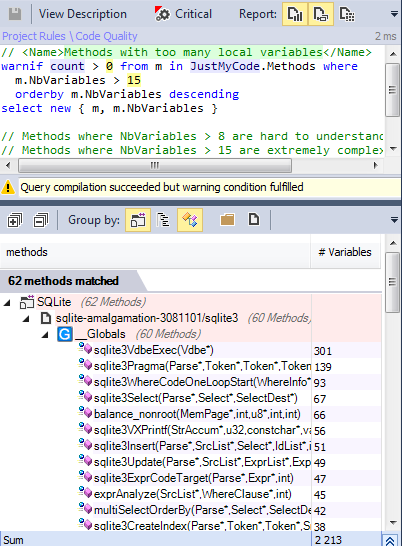
Les méthodes où NbVariables est supérieur à 8 sont difficiles à comprendre et à maintenir. Les méthodes où NbVariables est supérieur à 15 sont extrêmement complexes et devraient être scindées en méthodes plus petites (sauf si elles sont générées automatiquement par un outil).
6. Évitez de définir des fonctions complexes
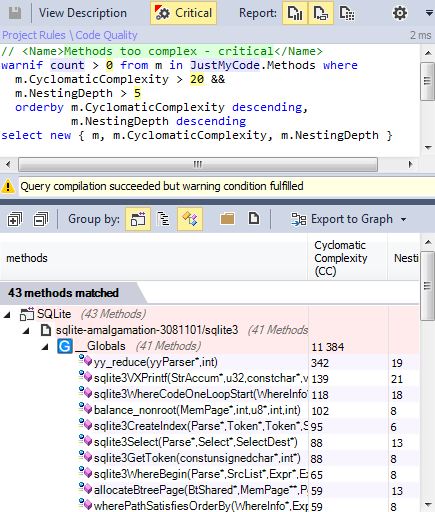
De nombreuses métriques peuvent être utilisées pour détecter les fonctions complexes ; NBLinesOfCode, le nombre de paramètres et le nombre de variables locales sont les plus basiques.
D'autres métriques utiles peuvent aider à identifier les fonctions complexes :
- La complexité cyclomatique est une métrique logicielle procédurale populaire dont le résultat est égal au nombre de décisions qui peuvent être prises dans une procédure.
- Nesting Depth est une métrique au niveau méthode qui représente la profondeur maximale des portées imbriquées dans le corps d’une méthode.
- Max Nested Loops est égal au niveau maximal d’imbrication des boucles dans une fonction.
Les valeurs maximales acceptables pour ces métriques dépendent largement des préférences de l'équipe, car il n'existe pas de seuils universels.
Recherchons les fonctions qui pourraient nécessiter une refactorisation :
7. Le formatage
Le style de programmation et l'indentation peuvent être définis comme la manière dont vous choisissez d'organiser et de documenter votre code source. L'indentation du code fait partie du style de programmation et relève largement de la lisibilité et de l'esthétique. Si nous suivons un guide de style et une indentation corrects, un programme peut être comme un POÈME, et le lecteur sera suffisamment à l'aise pour le PARCOURIR et en comprendre le sens. Comme nous le savons, une bonne indentation du code le rend :
- Plus facile à lire
- Plus facile à comprendre
- Plus facile à modifier
- Plus facile à maintenir
- Plus facile à améliorer
L'objectif de l'indentation et du style du code est de rendre un programme plus facile à lire et à comprendre. Cela fait gagner beaucoup de temps lorsque nous revisitons ou réutilisons le code. Un guide de style fournit une feuille de route que le développeur devrait suivre en codant, afin que, dans un groupe de développeurs, tout le code produit soit cohérent par nature et réutilisable par n'importe quel développeur.
8. Les commentaires
Parfois le code n'a aucun commentaire, tandis que dans d'autres cas il est sur-commenté. Vous avez peut-être déjà lu cette phrase : Le bon code se documente lui-même.
Oui, c'est une bonne pratique de garder le code propre et de le laisser parler de lui-même, en évitant les commentaires — mais dans le monde réel, ce n'est pas toujours facile. Dans certains cas, vous devez clarifier ce que fait le code.
9. Le couplage
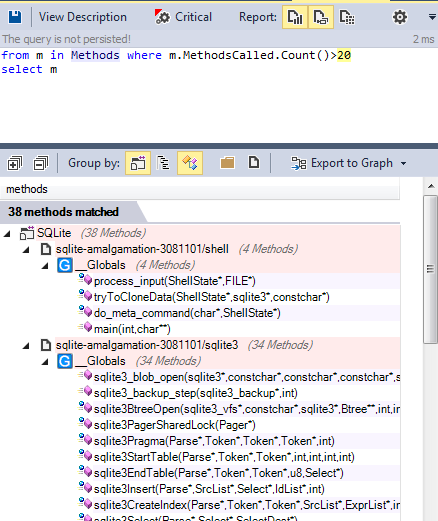
Un faible couplage est souhaitable, car une modification dans une partie d'une application nécessitera moins de changements ailleurs dans l'application. À long terme, cela peut réduire le temps, les efforts et le coût associés à la modification d'une application et à l'ajout de nouvelles fonctionnalités.
Les fonctions qui dépendent de nombreuses autres fonctions peuvent être difficiles à comprendre et à maintenir. Il est recommandé de minimiser le couplage efférent de vos fonctions.
10. La cohésion
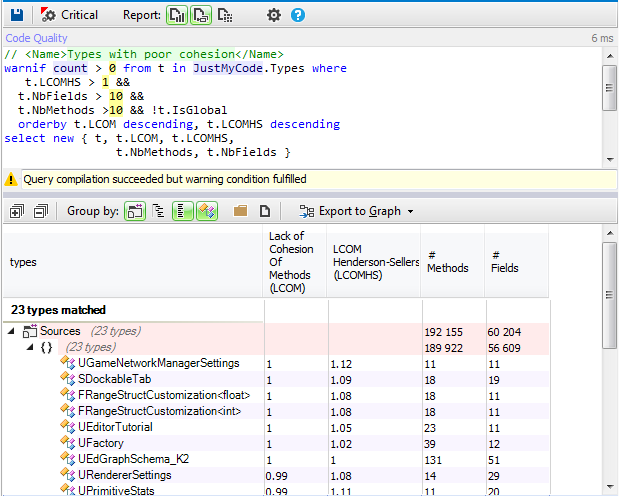
Le principe de responsabilité unique énonce qu'une classe ne devrait pas avoir plus d'une raison de changer. Une telle classe est dite cohésive. Une valeur LCOM élevée signale généralement une classe peu cohésive. Il existe plusieurs métriques LCOM. Le LCOM prend ses valeurs dans l'intervalle [0-1]. Le LCOM HS (HS pour Henderson-Sellers) prend ses valeurs dans l'intervalle [0-2]. Une valeur LCOM HS supérieure à 1 doit être considérée comme alarmante. Voici comment calculer les métriques LCOM :
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
Où :
- M est le nombre de méthodes de la classe (les méthodes statiques et d'instance sont comptées ; cela inclut aussi les constructeurs, les getters/setters de propriétés et les méthodes add/remove d'événements).
- F est le nombre de champs d’instance de la classe.
- MF est le nombre de méthodes de la classe accédant à un champ d’instance donné.
- Sum(MF) est la somme des MF sur tous les champs d’instance de la classe.
L'idée sous-jacente à ces formules peut s'énoncer ainsi : une classe est totalement cohésive si toutes ses méthodes utilisent tous ses champs d'instance, ce qui signifie que sum(MF)=M*F, et donc LCOM = 0 et LCOMHS = 0.
Une valeur LCOMHS supérieure à 1 doit être considérée comme alarmante.
Conclusion
Voilà quelques habitudes de base qui peuvent aider à garder votre code propre dès le début. N'attendez pas une refactorisation majeure pour le nettoyer — efforcez-vous de le garder propre dès le départ.