
In C++ gibt es zahlreiche Bibliotheken, die bei der Entwicklung einer IoT-Anwendung helfen können, doch die meisten arbeiten auf einer niedrigen Abstraktionsebene. Für ein High-Level-SDK ist Macchina.io eine ausgezeichnete Wahl – insbesondere, wenn Sie ein robustes Framework suchen, das die Entwicklung von IoT-Anwendungen vereinfacht.
Macchina ist nicht nur eine leistungsfähige Lösung für IoT-Anwendungen, sondern auch ein durchdacht entworfenes und sauber implementiertes Projekt. Dadurch können SDK-Anwender sein Verhalten leicht nachvollziehen und an ihre Anforderungen anpassen.
Werfen wir mit CppDepend einen Blick auf den Macchina-Quellcode und untersuchen einige Aspekte seines Designs und seiner Implementierung.
Sauberes Design
Beim Entwurf eines C++-Projekts mit einer gut strukturierten Ordnerhierarchie sollten insbesondere Modularität, Wartbarkeit, and Skalierbarkeit. berücksichtigt werden. Eine sinnvolle Ordnerstruktur ermöglicht die Trennung von Verantwortlichkeiten und erleichtert dadurch Navigation, Änderungen und Erweiterungen des Codes.
Wie die folgende DSM zeigt, verfügt das Macchina SDK über eine gut organisierte Ordnerstruktur:
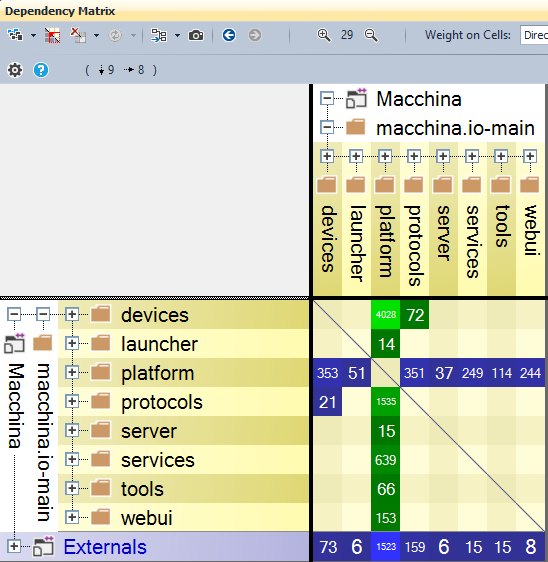
Die auf der POCO-Bibliothek basierende technische Schicht ist im Ordner „platform“ isoliert. Die POCO C++ Libraries sind leistungsfähige plattformübergreifende Open-Source-C++-Bibliotheken zur Entwicklung netzwerk- und internetbasierter Anwendungen für Desktop-, Server-, Mobil-, IoT- und Embedded-Systeme.
Hier ist der Abhängigkeitsgraph für einige der POCO-Bibliotheken.
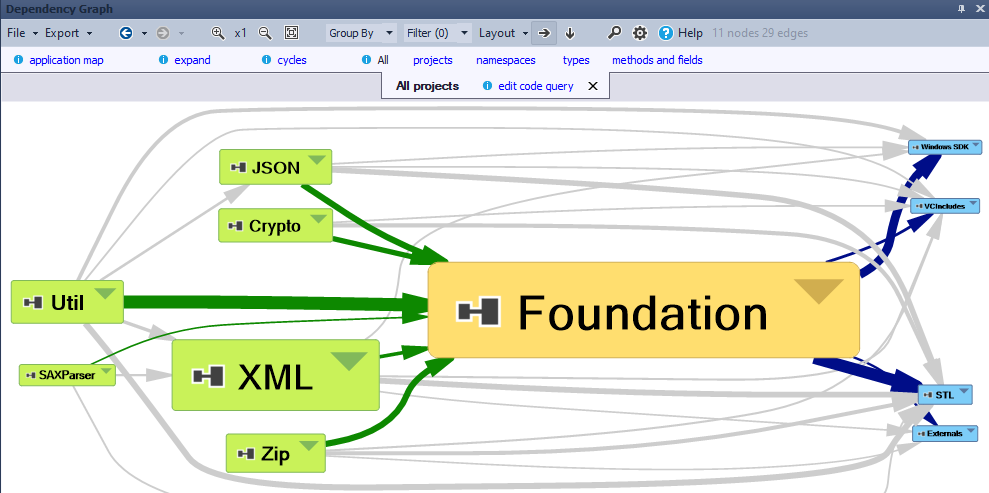
Werfen wir einen Blick in das Foundation-Projekt, um seine Struktur näher zu untersuchen:
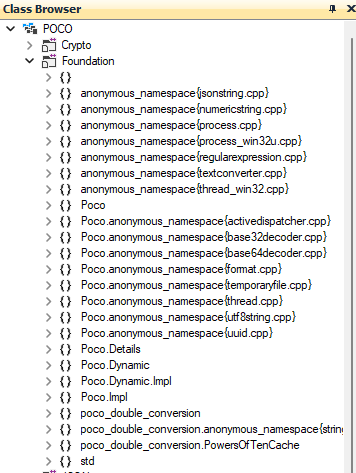
Die Namespaces im Quellcode erfüllen drei unterschiedliche Aufgaben:
1 – Modularisierung der Anwendung
Moderne C++-Bibliotheken setzen Namespaces intensiv ein, um ihre Codebasis zu modularisieren, und folgen häufig dem Ansatz „Namespace by Feature“. Dabei bilden Namespaces die funktionalen Bereiche ab: Alle Elemente, die zu einer bestimmten Funktion gehören – und nur diese – werden in einem gemeinsamen Namespace zusammengefasst. So entstehen Namespaces mit hoher Kohäsion und Modularität sowie möglichst geringer Kopplung untereinander. Eng zusammenarbeitende Elemente liegen dadurch auch strukturell nah beieinander.
2 – Anonymer Namespace
Ein unbenannter Namespace macht globale statische Variablen überflüssig. Ein solcher anonymer Namespace ist ausschließlich innerhalb der Datei zugänglich, in der er definiert wurde.
3 – Implementierungsdetails per Konvention verbergen
In C++ gibt es keine Möglichkeit, öffentliche Typen vor den Anwendern einer Bibliothek zu verbergen (in C# erfüllt das Schlüsselwort „internal“ diesen Zweck). Daher ist es sinnvoll kenntlich zu machen, dass bestimmte Typen nicht direkt verwendet werden sollten, weil sie lediglich Implementierungsdetails darstellen.
Eine in modernem C++ verbreitete Konvention, die von den Entwicklern der Boost-Bibliotheken geprägt wurde, besteht darin, Symbole, die zur Implementierung eines Moduls gehören – also nicht Teil der öffentlichen API sind –, aber dennoch öffentlich sichtbar sein müssen, in einen separaten Sub-Namespace auszulagern. Dieser wird üblicherweise „detail“ genannt.
Die Namespaces Poco.Details und Poco.Dynamic.Impl werden verwendet, um Implementierungsdetails per Konvention zu verbergen.
Lose Kopplung für mehr Flexibilität
Eine lose Kopplung ist wünschenswert, weil Änderungen in einem Bereich der Anwendung dadurch weniger Anpassungen in anderen Teilen des Systems nach sich ziehen. Langfristig lassen sich so erheblich Zeit, Aufwand und Kosten bei Änderungen und der Entwicklung neuer Funktionen einsparen.
Lose Kopplung lässt sich unter anderem durch abstrakte Klassen sowie generische Typen und Methoden erreichen.
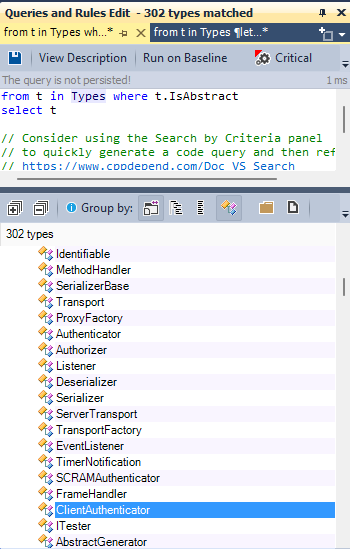
Der Macchina-Quellcode enthält mehr als 300 abstrakte Klassen:
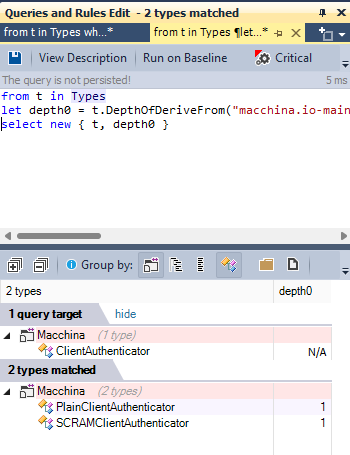
Die Klasse für die Client-Authentifizierung ist beispielsweise abstrakt und ermöglicht mehrere Implementierungen. Das schafft Flexibilität bei der Benutzer-Authentifizierung.
Hohe Kohäsion
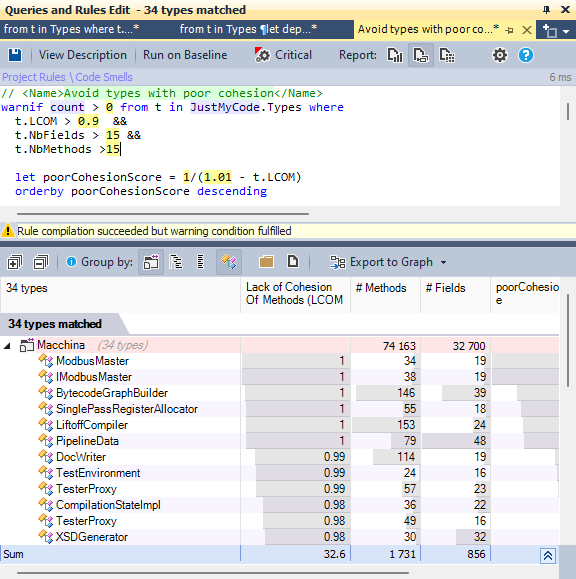
Das Single-Responsibility-Prinzip besagt, dass eine Klasse nicht mehr als einen Grund für Änderungen haben sollte. Eine solche Klasse gilt als kohäsiv. Ein hoher LCOM-Wert weist im Allgemeinen auf eine geringe Kohäsion hin. Es gibt mehrere LCOM-Metriken. LCOM-Werte liegen zwischen 0 und 1; LCOM HS (HS steht für Henderson-Sellers) reicht von 0 bis 2. Ein LCOM-HS-Wert größer als 1 sollte als Warnsignal betrachtet werden. Die LCOM-Metriken werden wie folgt berechnet:
LCOM = 1 — (sum(MF)/M*F)
LCOM HS = (M — sum(MF)/F)(M-1)
Dabei gilt:
- M ist die Anzahl der Methoden der Klasse. Gezählt werden sowohl statische als auch Instanzmethoden sowie Konstruktoren, Property-Getter/-Setter und Add-/Remove-Methoden von Events.
- F ist die Anzahl der Instanzfelder der Klasse.
- MF ist die Anzahl der Methoden der Klasse, die auf ein bestimmtes Instanzfeld zugreifen.
- Sum(MF) ist die Summe von MF über alle Instanzfelder der Klasse.
Die Grundidee hinter diesen Formeln lautet: Eine Klasse ist vollständig kohäsiv, wenn alle ihre Methoden sämtliche Instanzfelder verwenden. Dann gilt sum(MF)=M*F und folglich LCOM = 0 sowie LCOMHS = 0.
Ein LCOM-HS-Wert größer als 1 sollte als Warnsignal betrachtet werden.
Saubere Implementierung
Nur wenige große Typen in der Codebasis
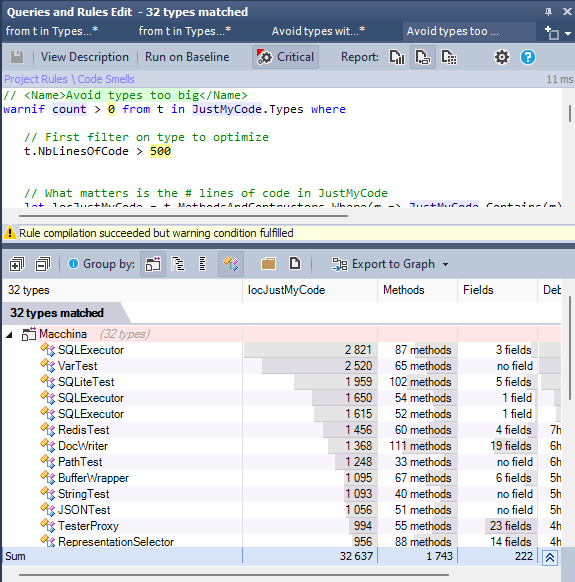
Große Typen können äußerst komplex in Entwicklung und Wartung sein. Eine solche Klasse kann zu viele andere Klassen im System kontrollieren und über ein vernünftiges Maß hinaus anwachsen – bis sie zur „Klasse, die alles macht“ wird.
Im Quellcode des Macchina SDK sind nur wenige Typen außergewöhnlich groß.
Methoden sind klein und leicht verständlich
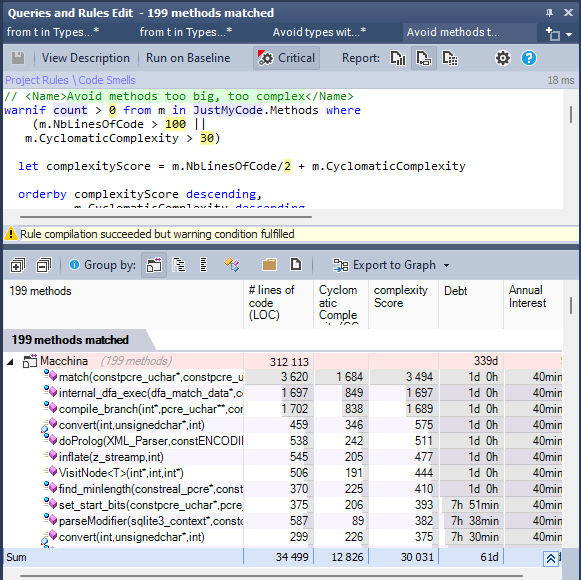
Zur Erkennung komplexer Funktionen können zahlreiche Metriken herangezogen werden. Zu den grundlegenden gehören NBLinesOfCode, die Anzahl der Parameter und die Anzahl lokaler Variablen.
Darüber hinaus gibt es weitere interessante Metriken zur Erkennung komplexer Funktionen:
- Die zyklomatische Komplexität ist eine verbreitete prozedurale Softwaremetrik, die die Anzahl der Entscheidungspfade innerhalb einer Prozedur widerspiegelt.
- Nesting Depth ist eine Metrik auf Methodenebene und beschreibt die maximale Tiefe verschachtelter Gültigkeitsbereiche innerhalb eines Methodenkörpers.
- Max Nested Loop gibt die maximale Verschachtelungstiefe von Schleifen innerhalb einer Funktion an.
Welche Maximalwerte für diese Metriken akzeptabel sind, hängt von den Entscheidungen des jeweiligen Teams ab; universell gültige Standardwerte gibt es nicht.
Im Quellcode des Macchina SDK können nur wenige Methoden als komplex eingestuft werden.
Der Code ist wartbar
Der Maintainability Index ist eine Softwaremetrik, mit der bewertet wird, wie gut sich eine Codebasis langfristig warten lässt. Sie liefert einen quantifizierbaren Wert auf Grundlage von Faktoren wie Codekomplexität, Größe und Lesbarkeit und hilft Entwicklern einzuschätzen, wie sich Änderungen auf die langfristige Wartbarkeit auswirken können.
Untersuchen wir die Wartbarkeit der Methoden des Macchina SDK mithilfe der CppDepend-Treemap:
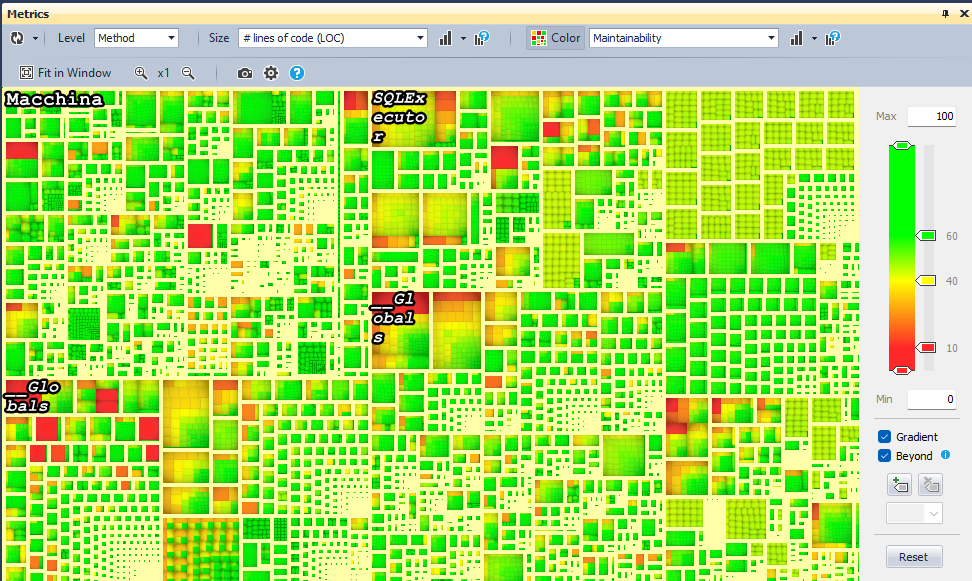
In der Metrikansichtwird die Codebasis mithilfe einer Treemap. Treemapping ist ein Verfahren zur Darstellung baumstrukturierter Daten mithilfe ineinander verschachtelter Rechtecke. Die in der CppDepend-Treemap verwendete Baumstruktur entspricht der üblichen Codehierarchie:
- C/C++-Projekte enthalten Namespaces,
- Namespaces enthalten Typen,
- Typen enthalten Methoden und Felder.
Die Option Size der Treemap bestimmt die Größe der Rechtecke, die standardmäßig proportional zur Anzahl der Codezeilen, und eine Code-Metrik kann durch die Einfärbung der Rechtecke der Codeelemente dargestellt werden; in unserem Fall steht die Farbe für die Wartbarkeit.
Wie zu sehen ist, werden nur wenige Methoden rot dargestellt, und bei den meisten davon handelt es sich um Testmethoden.
Fazit
Macchina ist dafür bekannt, die Entwicklung von IoT-Anwendungen zu vereinfachen. Die Implementierung ist sauber, gut verständlich und anpassbar – damit ist das SDK eine ausgezeichnete Wahl für IoT-Anwendungen.