
En C++, de nombreuses bibliothèques peuvent vous aider à implémenter une application IoT, mais la plupart sont bas niveau. Pour un SDK haut niveau, Macchina.io est un excellent choix, surtout si vous recherchez un framework robuste qui simplifie le développement d’applications IoT.
Macchina n’est pas seulement une solution puissante pour les applications IoT, c’est aussi un projet bien conçu et bien implémenté, qui permet aux utilisateurs du SDK de comprendre et personnaliser facilement son comportement.
Examinons le code source de Macchina avec CppDepend et explorons quelques aspects de sa conception et de son implémentation.
Une conception propre
Lorsqu’on conçoit un projet C++ avec une structure de dossiers bien organisée, il est important de prendre en compte la modularité, la maintenabilité, et l’évolutivité. Organiser son code par dossiers permet de séparer les préoccupations, facilitant la navigation, la modification et l’extension.
Comme le montre la DSM suivante, le SDK Macchina possède une structure de dossiers bien organisée :
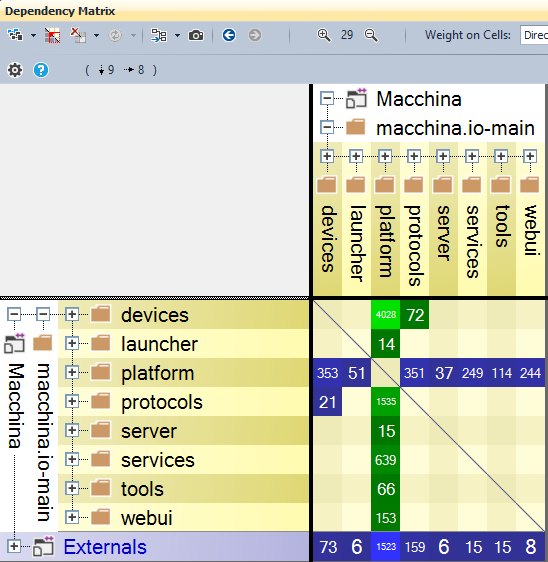
La couche technique basée sur la bibliothèque POCO est isolée dans le dossier platform. Les bibliothèques C++ POCO sont de puissantes bibliothèques C++ open source et multiplateformes pour construire des applications réseau et internet fonctionnant sur desktop, serveur, mobile, IoT et systèmes embarqués.
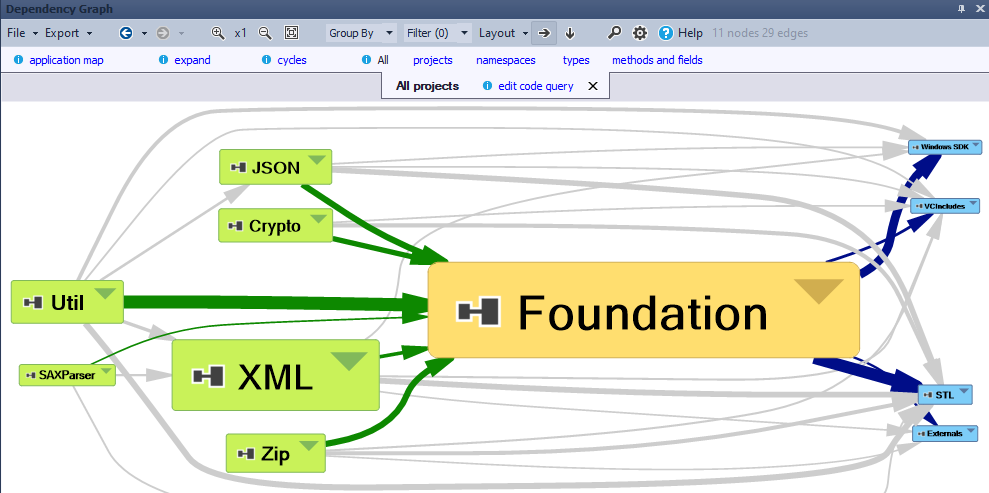
Voici le graphe de dépendances de quelques bibliothèques POCO.
Examinons l’intérieur du projet Foundation pour explorer sa structure :
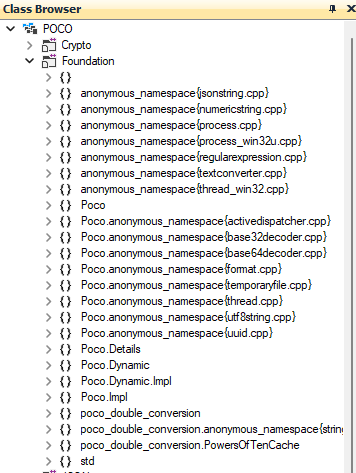
Les espaces de noms du code source remplissent trois objectifs différents :
1- Modulariser l’application
Les bibliothèques C++ modernes utilisent abondamment les espaces de noms pour modulariser leur base de code, selon l’approche « Namespace-by-feature ». Cette approche utilise les espaces de noms pour refléter l’ensemble des fonctionnalités. Elle place tous les éléments liés à une même fonctionnalité (et uniquement celle-ci) dans un même espace de noms. Il en résulte des espaces de noms à forte cohésion et forte modularité, avec un couplage minimal entre eux. Les éléments qui collaborent étroitement sont placés côte à côte.
2- L’espace de noms anonyme
Un espace de noms anonyme évite le recours aux variables globales statiques. L’espace de noms anonyme que vous créez n’est accessible qu’au sein du fichier où il est défini.
3- Masquer les détails par convention
En C++, il n’existe aucun moyen de masquer les types publics aux utilisateurs d’une bibliothèque (en C#, le mot-clé « internal » remplit ce rôle). Il est donc utile d’indiquer que certains types ne doivent pas être utilisés directement, car ce sont des détails d’implémentation.
Un idiome courant du C++ moderne, popularisé par les développeurs des bibliothèques Boost, consiste à isoler dans un sous-espace de noms dédié — par convention nommé detail — les symboles qui font partie de l’implémentation de votre module (c’est-à-dire qui ne font pas partie de l’API publique) mais doivent néanmoins être publiquement accessibles.
Les espaces de noms Poco.Details et Poco.Dynamic.Impl servent à masquer les détails d’implémentation par convention.
Un couplage faible pour plus de flexibilité
Un couplage faible est souhaitable, car les modifications dans une zone d’une application nécessitent moins de changements dans les autres parties du système. À long terme, cela peut faire gagner un temps, des efforts et des coûts considérables lors de la modification et de l’ajout de nouvelles fonctionnalités.
Le couplage faible peut être obtenu en utilisant des classes abstraites ou des types et méthodes génériques.
Le code source de Macchina contient plus de 300 classes abstraites :
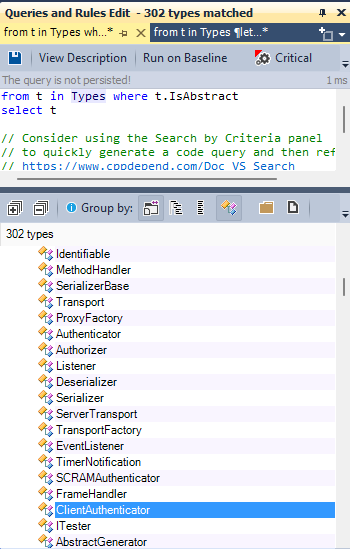
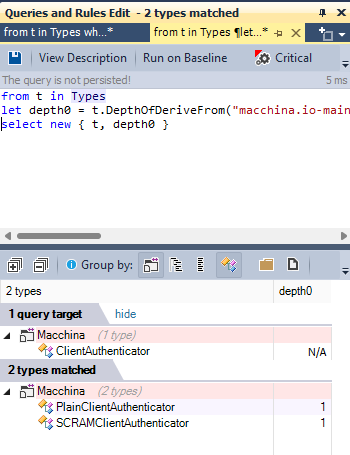
Par exemple, la classe d’authentification du client est une classe abstraite qui autorise plusieurs implémentations, offrant de la flexibilité à la fonctionnalité d’authentification des utilisateurs.
Une forte cohésion
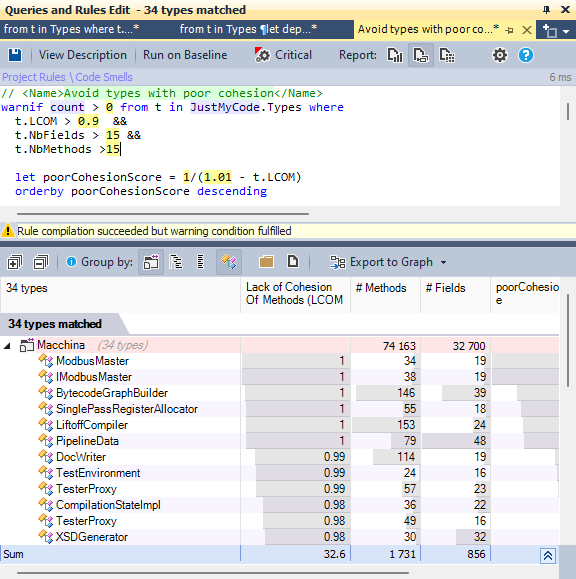
Le principe de responsabilité unique stipule qu’une classe ne devrait pas avoir plus d’une raison de changer. Une telle classe est dite cohésive. Une valeur LCOM élevée signale généralement une classe peu cohésive. Il existe plusieurs métriques LCOM. Les valeurs LCOM vont de 0 à 1. Les valeurs LCOM HS (où HS signifie Henderson-Sellers) vont de 0 à 2. Une valeur LCOM HS supérieure à 1 doit être considérée comme alarmante. Voici comment calculer les métriques LCOM :
LCOM = 1 — (sum(MF)/M*F)
LCOM HS = (M — sum(MF)/F)(M-1)
Où :
- M est le nombre de méthodes de la classe (les méthodes statiques et d’instance sont comptées, y compris les constructeurs, les accesseurs get/set des propriétés et les méthodes add/remove des événements).
- F est le nombre de champs d’instance de la classe.
- MF est le nombre de méthodes de la classe accédant à un champ d’instance donné.
- Sum(MF) est la somme des MF sur tous les champs d’instance de la classe.
L’idée sous-jacente à ces formules peut s’énoncer ainsi : une classe est totalement cohésive si toutes ses méthodes utilisent tous ses champs d’instance, ce qui signifie que sum(MF)=M*F, et donc LCOM = 0 et LCOMHS = 0.
Une valeur LCOM HS supérieure à 1 doit être considérée comme alarmante.
Une implémentation propre
Peu de gros types dans la base de code
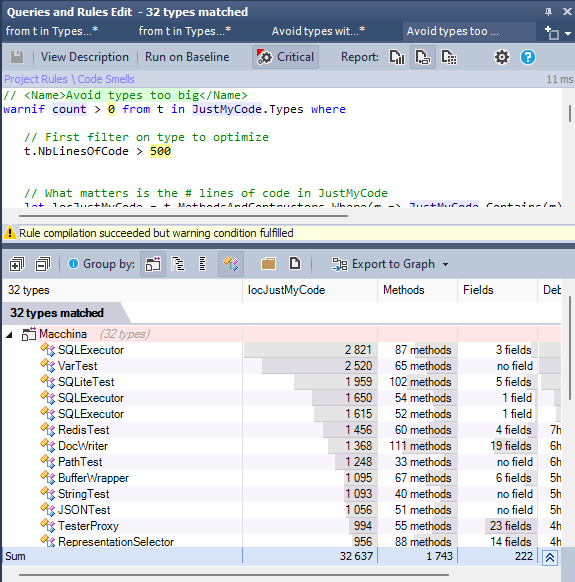
Les gros types peuvent être extrêmement complexes à développer et à maintenir. Une telle classe peut contrôler trop d’autres classes du système et croître au-delà de limites raisonnables, devenant « la classe qui fait tout ».
Dans le code source du SDK Macchina, seuls quelques types sont particulièrement gros.
Des méthodes petites et faciles à comprendre
De nombreuses métriques permettent d’identifier les fonctions complexes. NBLinesOfCode, le nombre de paramètres et le nombre de variables locales comptent parmi les plus basiques.
Il existe d’autres métriques intéressantes pour détecter les fonctions complexes :
- La complexité cyclomatique est une métrique logicielle procédurale populaire qui reflète le nombre de chemins de décision dans une procédure.
- Nesting Depth est une métrique au niveau méthode qui représente la profondeur maximale des portées imbriquées dans le corps d’une méthode.
- Max Nested Loop représente le niveau maximal d’imbrication des boucles dans une fonction.
Les valeurs maximales acceptables pour ces métriques dépendent des choix de l’équipe ; il n’existe pas de valeurs standard universelles.
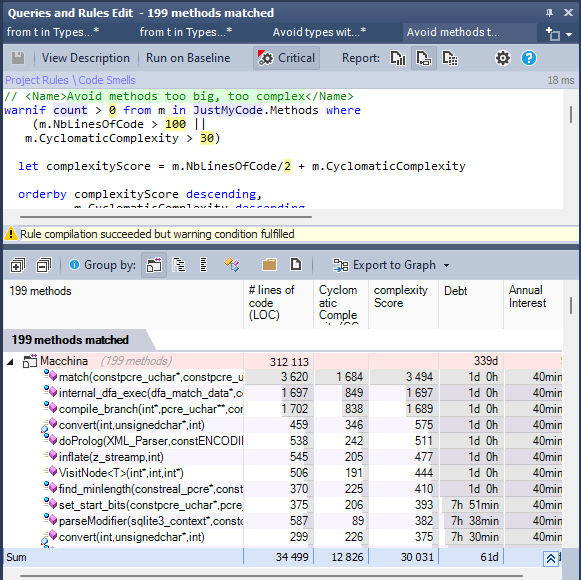
Dans le code source du SDK Macchina, seules quelques méthodes peuvent être considérées comme complexes.
Un code maintenable
L’ indice de maintenabilité est une métrique logicielle qui mesure la facilité avec laquelle une base de code peut être maintenue dans le temps. Elle fournit un score quantifiable basé sur des facteurs comme la complexité, la taille et la lisibilité du code, aidant les développeurs à comprendre comment les changements peuvent affecter la maintenabilité à long terme de la base de code.
Examinons la maintenabilité des méthodes du SDK Macchina à l’aide de la Treemap de CppDepend :
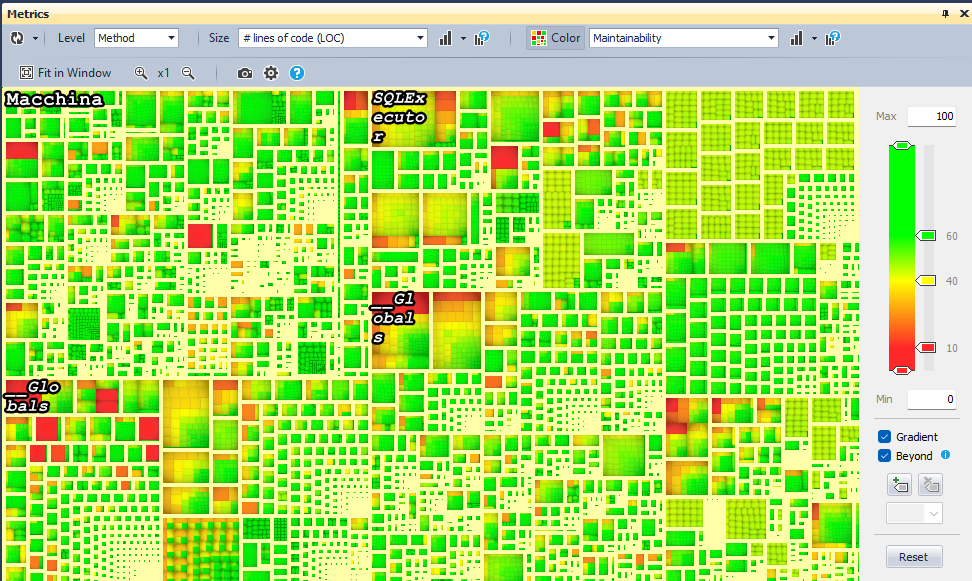
Dans la vue métrique, la base de code est représentée sous forme de Treemap. Le treemapping est une méthode d’affichage de données arborescentes à l’aide de rectangles imbriqués. L’arborescence utilisée dans la treemap de CppDepend est la hiérarchie de code habituelle :
- Les projets C/C++ contiennent des espaces de noms,
- Les espaces de noms contiennent des types,
- Les types contiennent des méthodes et des champs.
L’option Size de la treemap détermine la taille des rectangles, par défaut proportionnelle au nombre de lignes de code, et une métrique de code peut être représentée en colorant les rectangles des éléments de code ; dans notre cas, la couleur représente la maintenabilité.
Comme on peut le constater, seules quelques méthodes apparaissent en rouge, et la plupart sont des méthodes de test.
Conclusion
Macchina est réputé pour faciliter le développement d’applications IoT. Son implémentation est propre, facile à comprendre et personnalisable, ce qui en fait un excellent choix pour les applications IoT.