Die Unreal Engine is a game engine developed by Epic Games, first showcased in the 1998 first-person shooter game Unreal. Obwohl sie ursprünglich vor allem für Ego-Shooter entwickelt wurde, kam sie auch in zahlreichen anderen Genres erfolgreich zum Einsatz, darunter Stealth-Spiele, MMORPGs und andere Rollenspiele.
Der Code ist in C++ geschrieben, und die Engine wird heute von vielen Spieleentwicklern eingesetzt. Ihr Quellcode ist auf GitHub verfügbar, und für Studierende ist sie kostenlos erhältlich. Mit dieser Engine wurden zahlreiche beeindruckende Spiele entwickelt; sie ermöglicht äußerst realistische Darstellungen wie diese.
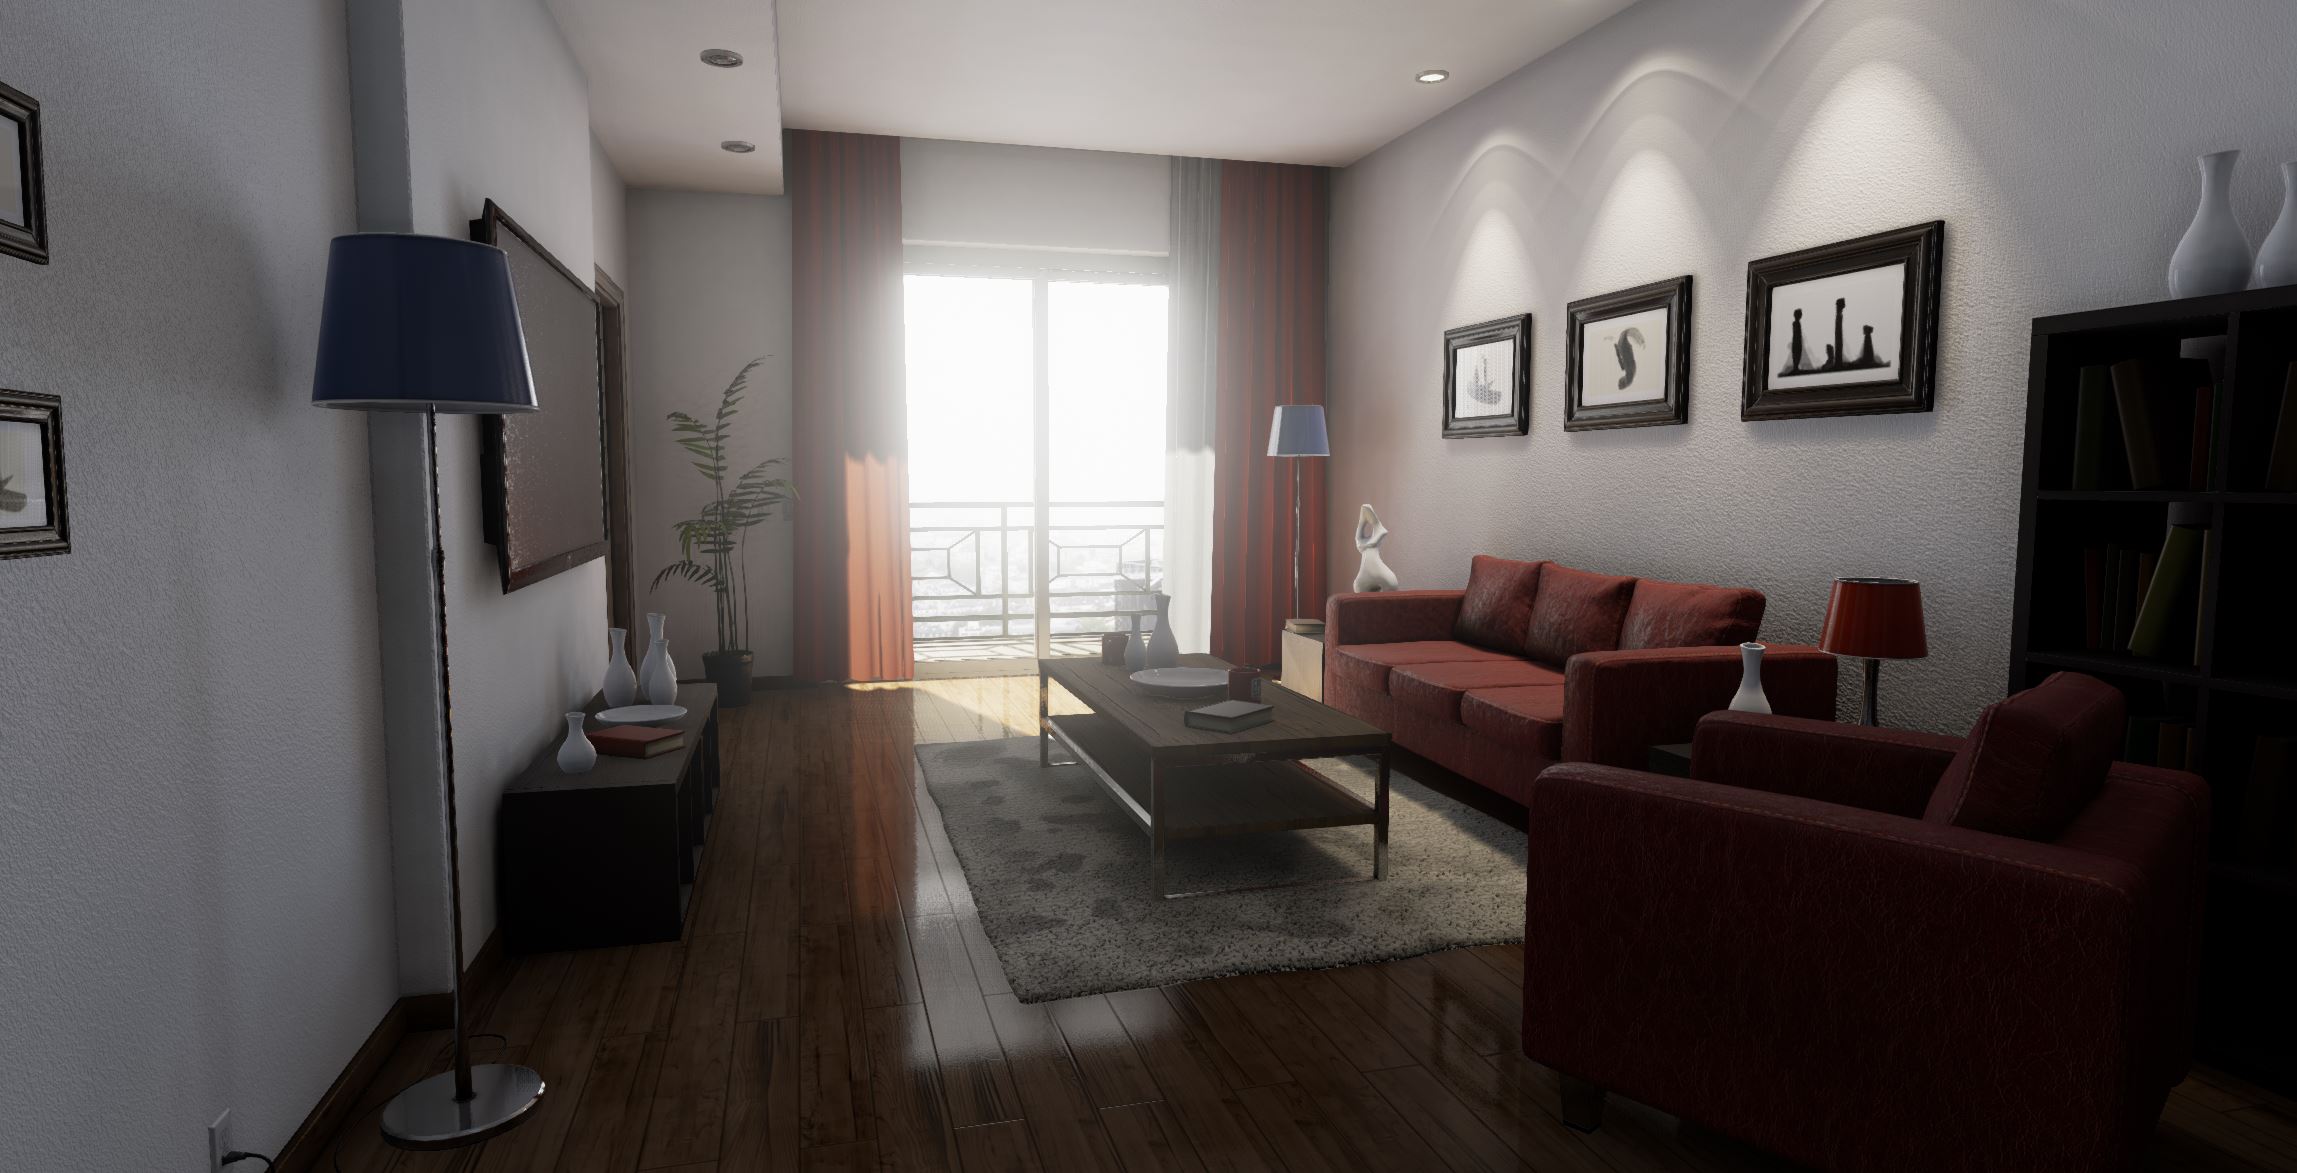
Welcher Quellcode wird im Hintergrund ausgeführt, um eine derart realistische Darstellung zu erzeugen?
Es ist äußerst interessant, einen Blick in diese leistungsfähige Spiele-Engine zu werfen und zu untersuchen, wie sie entworfen und implementiert wurde. C++-Entwickler können aus ihrer Codebasis zahlreiche bewährte Vorgehensweisen lernen.
Untersuchen wir den Quellcode mit CppDepend und CQLinq und analysieren wir einige Design- und Implementierungsentscheidungen des Entwicklerteams.
1 – Namespaces
Die Unreal Engine verwendet Namespaces aus drei Hauptgründen sehr intensiv:
- Viele Namespaces enthalten ausschließlich Enums. Die folgende CQLinq-Abfrage liefert genau diese Namespaces.
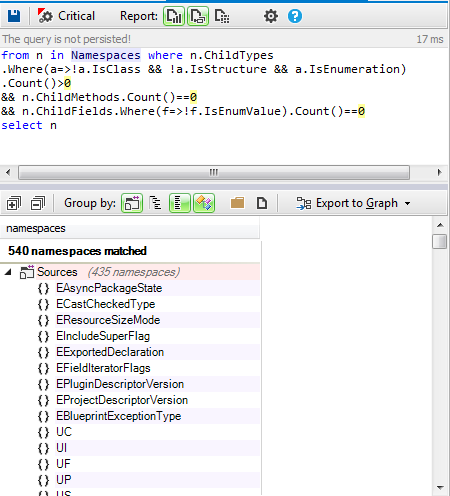
In einem großen Projekt lässt sich nicht ausschließen, dass zwei unterschiedliche Enums denselben Namen verwenden. Dieses Problem wurde in C++11 mit enum class gelöst, wodurch die Enum-Werte implizit in den Namensbereich des Enums eingeschlossen werden.
- Anonymer Namespace: Ein Namespace ohne Namen vermeidet globale statische Variablen. Der erzeugte „anonyme“ Namespace ist nur innerhalb der Datei zugänglich, in der er definiert wurde. Hier ist die Liste aller verwendeten anonymen Namespaces:
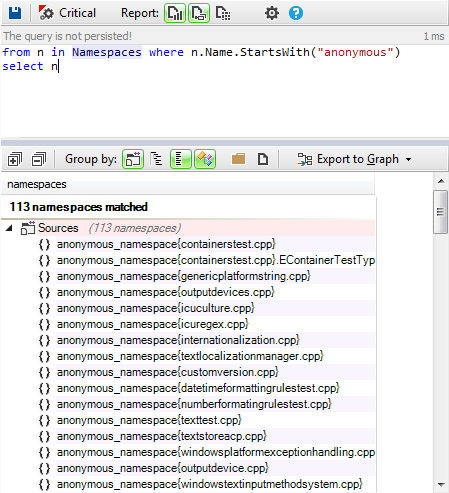
- Die Codebasis modularisieren: Suchen wir nach allen weiteren Namespaces, also weder nach anonymen Namespaces noch nach solchen, die ausschließlich Enums enthalten:
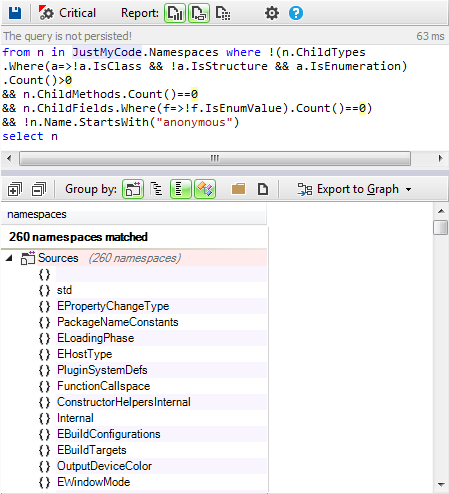
Namespaces eignen sich hervorragend zur Modularisierung einer Anwendung. Die Unreal Engine definiert mehr als 250 Namespaces, um ihre Modularität durchzusetzen und den Code lesbarer und wartbarer zu machen.
2 – Verwendete Programmierparadigmen
C++ ist nicht nur eine objektorientierte Sprache. Wie Bjarne Stroustrup betont, ist „C++ eine Multi-Paradigmen-Sprache“. Sie unterstützt unterschiedliche Programmierstile beziehungsweise Paradigmen; objektorientierte Programmierung ist nur eines davon. Weitere sind die prozedurale und die generische Programmierung.
2.1 – Prozedurales Paradigma
2.1.1 – Globale Funktionen
Let’s search for all global functions defined in the Unreal Engine source code:
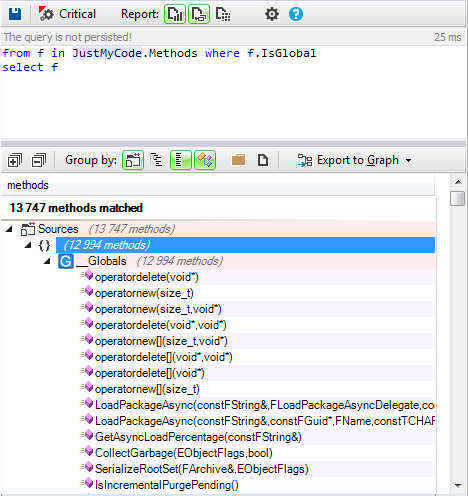
Diese Funktionen lassen sich in drei Kategorien einteilen:
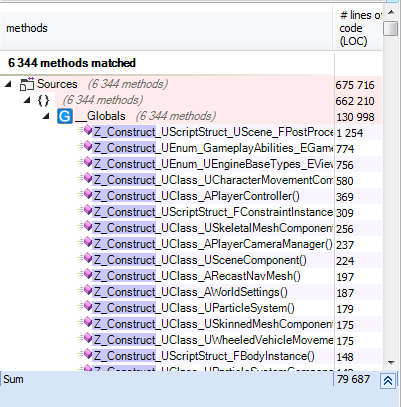
1 – Hilfsfunktionen: Beispielsweise sind 6.344 davon Z_Construct_UXXX-Funktionen, die zum Erzeugen von Instanzen verwendet werden, die von der Engine benötigt werden.
2 – Operatoren: Wie das Ergebnis der folgenden CQLinq-Abfrage zeigt, sind zahlreiche Operatoren definiert:
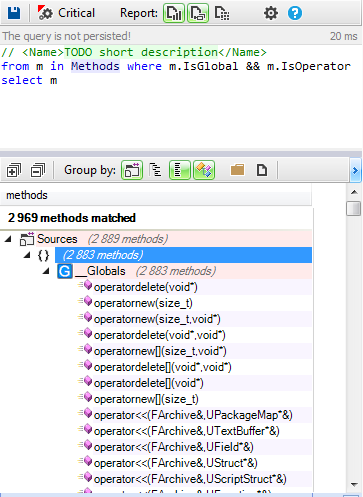
Im Quellcode der Unreal Engine sind nahezu alle Arten von Operatoren implementiert.
3 – Funktionen der Engine-Logik: Es sind viele globale Funktionen implementiert, die Engine-Logik enthalten. Solche Funktionen könnten möglicherweise nach Kategorien gruppiert werden – etwa als statische Methoden in Klassen oder innerhalb von Namespaces.
2.1.2 – Statische globale Funktionen
Es gilt als Best Practice, eine globale Funktion als static zu deklarieren, sofern sie nicht ausdrücklich aus einer anderen Quelldatei aufgerufen werden muss.
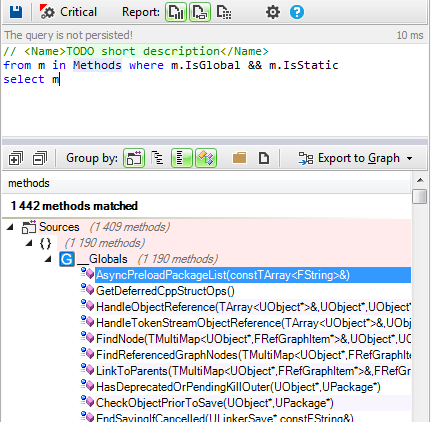
Viele globale Funktionen sind als static deklariert; andere sind, wie bereits erwähnt, innerhalb anonymer Namespaces definiert.
2.1.3 – Globale Funktionen, die statisch sein könnten
Nicht exportierte globale Funktionen, die weder in einem anonymen Namespace definiert noch von Methoden außerhalb ihrer Quelldatei verwendet werden, sind gute Kandidaten für ein Refactoring zu statischen Funktionen.
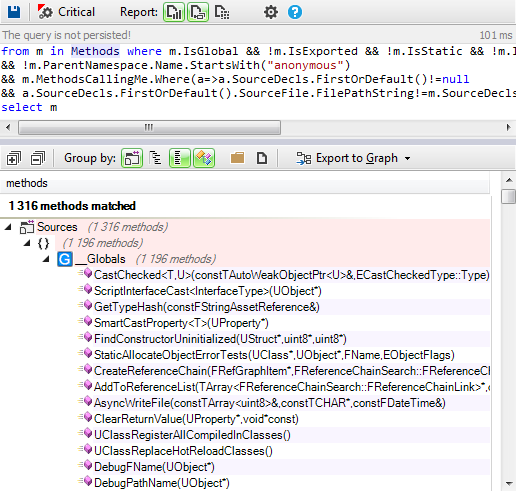
Wie zu sehen ist, kommen einige globale Funktionen dafür infrage, statisch gemacht zu werden.
2.2 – Objektorientiertes Paradigma
2.2.1 – Vererbung
In der objektorientierten Programmierung (OOP) dient Vererbung dazu, eine Ist-ein-Beziehung zwischen Objekten herzustellen. Häufig wird sie fälschlicherweise als Mittel zur Wiederverwendung bestehenden Codes betrachtet. Das ist keine gute Praxis, da Vererbung zur Wiederverwendung von Implementierungen zu starker Kopplung führt. Wiederverwendbarkeit wird besser durch Komposition erreicht („composition over inheritance“). Suchen wir nach allen Klassen mit mindestens einer Basisklasse:
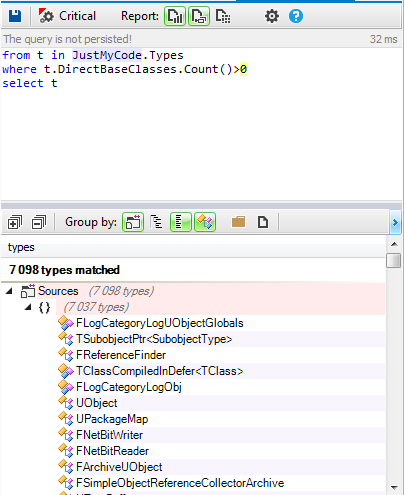
Um einen besseren Überblick über die von dieser Abfrage betroffenen Klassen zu erhalten, können wir die Metric View verwenden.
In der Metric View wird die Codebasis als Treemap dargestellt. Treemapping visualisiert hierarchisch strukturierte Daten mithilfe ineinander verschachtelter Rechtecke. Die in einer CppDepend-Treemap verwendete Baumstruktur entspricht der üblichen Codehierarchie:
- Projekte enthalten Namespaces.
- Namespaces enthalten Typen.
- Typen enthalten Methoden und Felder.
Die Treemap bietet eine anschauliche Möglichkeit, das Ergebnis einer CQLinq-Abfrage darzustellen. Die blauen Rechtecke markieren das Ergebnis, sodass die von der Abfrage betroffenen Typen unmittelbar sichtbar werden.
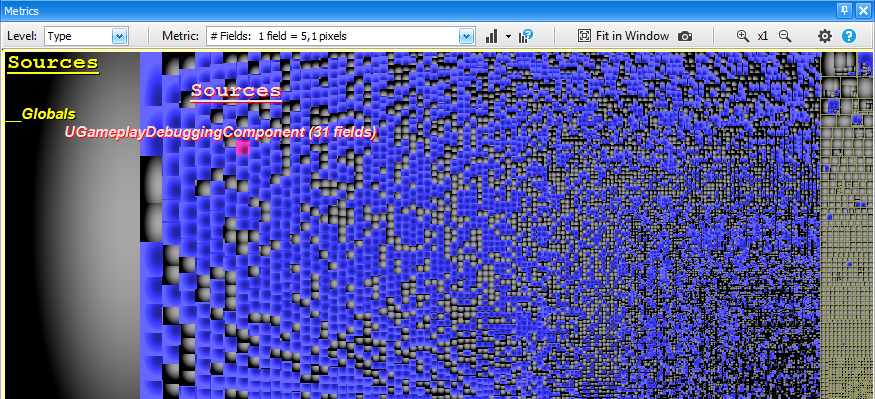
Wie zu erkennen ist, wird Vererbung im Quellcode der Unreal Engine intensiv eingesetzt.
Mehrfachvererbung: Suchen wir nach Klassen, die von mehr als einer konkreten Klasse erben.
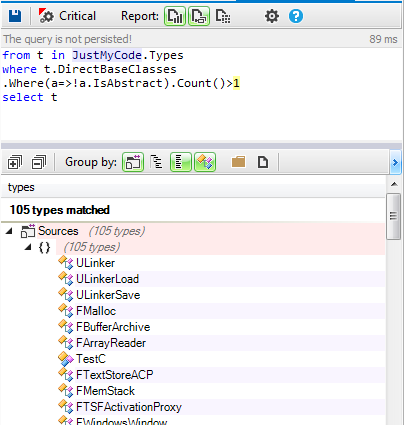
Mehrfachvererbung wird nur selten eingesetzt; lediglich wenige Klassen erben von mehr als einer Klasse.
2.2.2 – Virtuelle Methoden
Suchen wir nach allen virtuellen Methoden, die im Quellcode der Unreal Engine definiert sind:
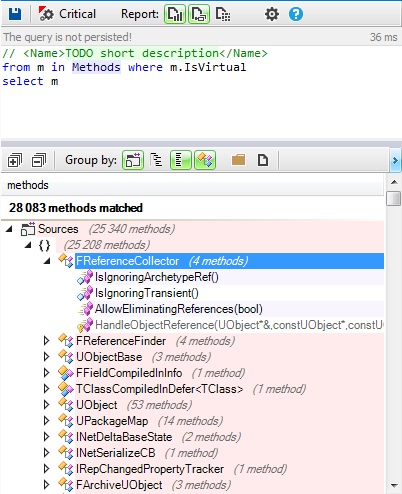
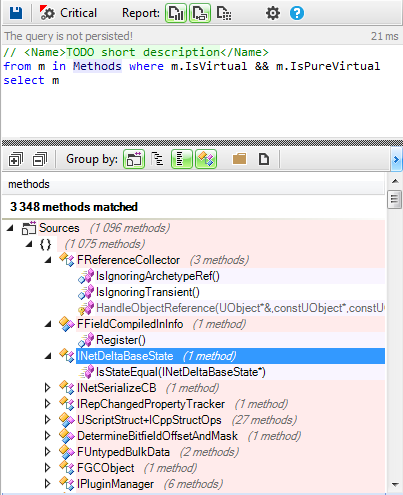
Viele Methoden sind virtuell, einige davon rein virtuell:
Wie das prozedurale Paradigma wird auch OOP im Quellcode der Unreal Engine intensiv genutzt. Wie sieht es mit generischer Programmierung aus?
2.3 – Generische Programmierung
C++ bietet mit Templates besondere Möglichkeiten, die Konzepte der generischen Programmierung auszudrücken. Templates stellen eine Form des parametrischen Polymorphismus bereit und ermöglichen generische Algorithmen und Datenstrukturen. Der Instanziierungsmechanismus von C++ sorgt dafür, dass bei ihrer Verwendung eine vollständig optimierte und spezialisierte Version für den jeweiligen Einsatzzweck erzeugt wird. Dadurch können generische Algorithmen ebenso effizient sein wie ihre nicht generischen Gegenstücke.
2.3.1 – Generische Typen
Suchen wir nach allen generischen Typen, die im Quellcode der Engine definiert sind:
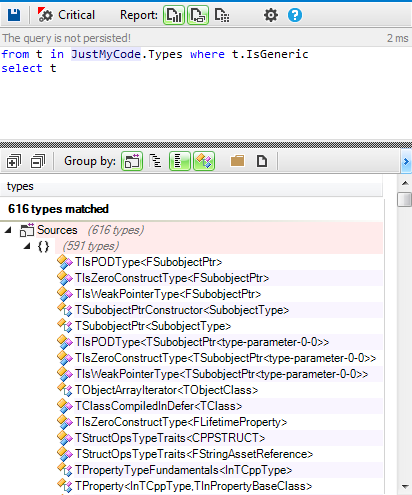
Nur wenige Typen sind generisch definiert. Suchen wir nun nach generischen Methoden:
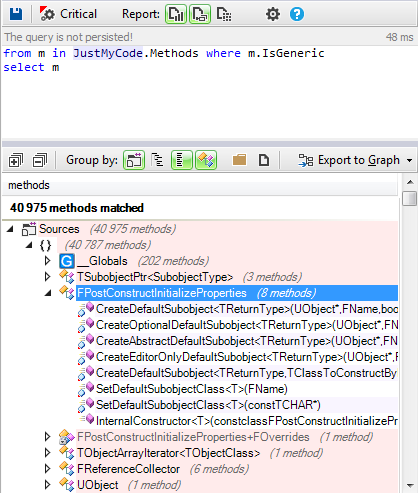
Mehr als 40.000 Methoden sind generisch; sie machen über 25 % der implementierten Methoden aus.
Zusammenfassend kombiniert der Quellcode der Unreal Engine alle drei Paradigmen.
3 – PODs zur Definition des Datenmodells
In der objektorientierten Programmierung bezeichnet Plain Old Data (POD) eine Datenstruktur, die lediglich als passive Sammlung von Feldwerten (Instanzvariablen) dargestellt wird, ohne objektorientierte Funktionen zu verwenden. In der Informatik wird dies als passive Datenstruktur bezeichnet.
Suchen wir nach den POD-Typen im Quellcode der Unreal Engine.
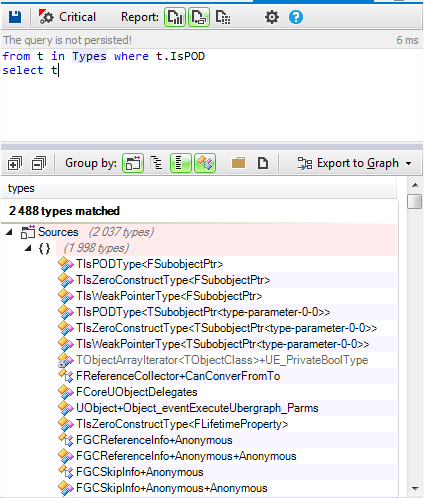
Mehr als 2.000 Typen sind als POD-Typen definiert; viele davon dienen zur Definition des Datenmodells der Engine.
4 – Entwurfsmuster der Gang of Four
Entwurfsmuster sind ein Konzept der Softwaretechnik für wiederkehrende Lösungen typischer Probleme beim Softwaredesign. Die Muster der „Gang of Four“ gehören zu den bekanntesten. Sehen wir uns einige davon im Quellcode der Unreal Engine an.
4.1 – Singleton
Das Singleton gehört zu den bekanntesten und am häufigsten eingesetzten Mustern. Hier sind einige im Quellcode definierte Singleton-Klassen:
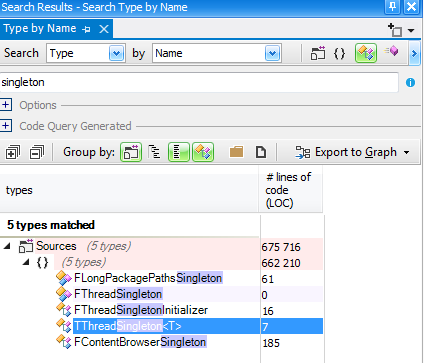
TThreadSingleton ist eine spezielle Variante des Singleton-Musters: Für jeden Thread wird nur eine Instanz erzeugt. Der Aufruf der Get()-Methode ist threadsicher.
4.2 – Factory
Factories sind nützlich, um die Instanziierungslogik zu isolieren und die Kohäsion zu stärken. Hier ist die Liste der im Quellcode definierten Factories:
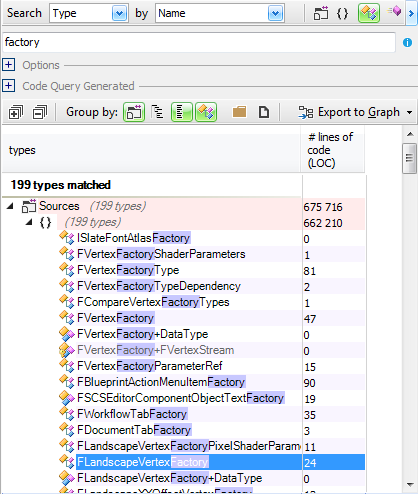
Und hier die Liste der abstrakten Factories:
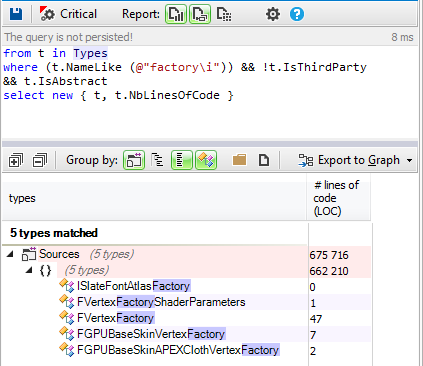
4.3 – Observer
Beim Observer-Muster verwaltet ein Objekt eine Liste abhängiger Objekte, der sogenannten Observer, und benachrichtigt diese automatisch über Zustandsänderungen, üblicherweise durch den Aufruf einer ihrer Methoden.
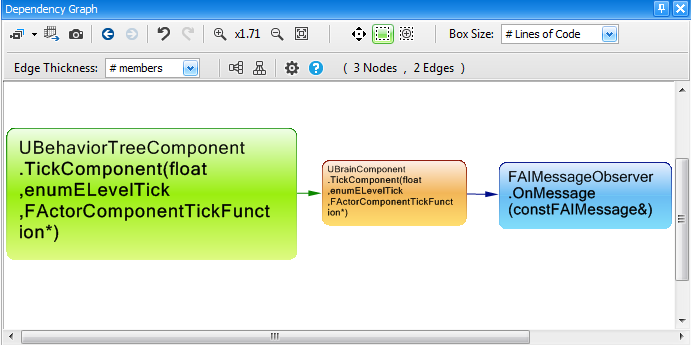
Im Quellcode sind mehrere Observer implementiert; FAIMessageObserver ist einer davon.
Der folgende Abhängigkeitsgraph zeigt den Aufruf der OnMessage-Methode dieses Observers:
4.4 – Command
Das Command-Muster ist ein Verhaltensmuster, bei dem ein Objekt sämtliche Informationen repräsentiert und kapselt, die benötigt werden, um eine Methode zu einem späteren Zeitpunkt aufzurufen.
Mit dem Command-Muster sind stets vier Begriffe verbunden: Command, Receiver, Invoker und Client. Ein Command-Objekt besitzt ein Receiver-Objekt und ruft eine Methode dieses Receivers auf eine für dessen Klasse spezifische Weise auf.
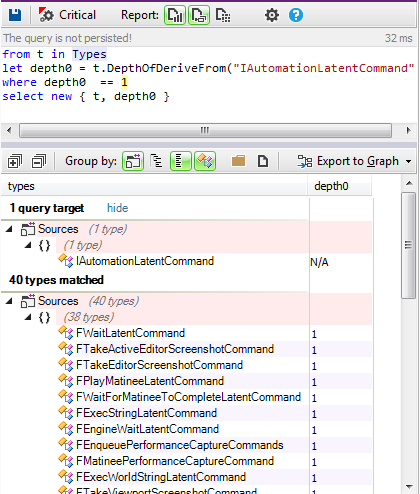
Hier sind beispielsweise alle Commands aufgeführt, die von IAutomationLatentCommand erben:
5 – Kopplung und Kohäsion
5.1 – Kopplung
Eine geringe Kopplung ist wünschenswert, weil Änderungen in einem Bereich der Anwendung dadurch weniger Folgeänderungen in anderen Bereichen erfordern. Langfristig lassen sich so viel Zeit, Aufwand und Kosten bei Änderungen und beim Hinzufügen neuer Funktionen sparen.
Eine geringe Kopplung kann durch abstrakte Klassen oder durch generische Typen und Methoden erreicht werden.
Suchen wir nach allen abstrakten Klassen, die im Quellcode der Unreal Engine definiert sind:
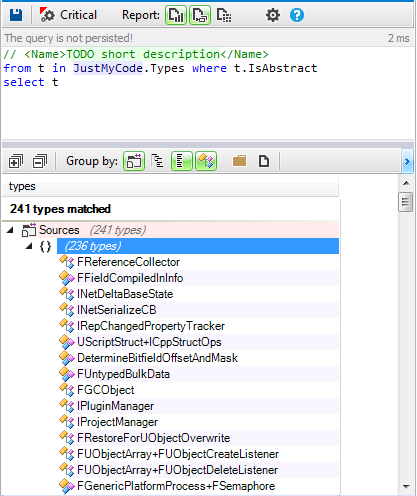
Nur wenige Typen sind als abstrakt deklariert. Eine geringe Kopplung wird stärker durch generische Typen und Methoden gefördert.
Hier sind beispielsweise die Methoden aufgeführt, die mindestens eine generische Methode verwenden:
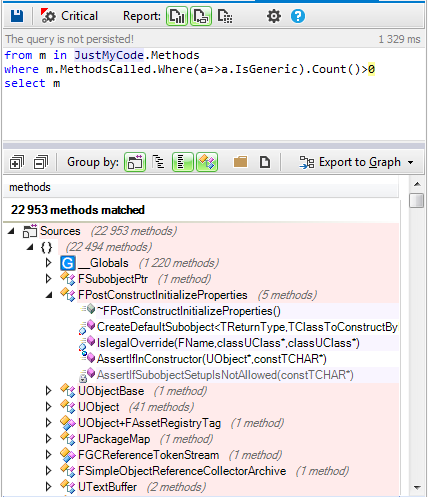
Wie zu sehen ist, verwenden viele Methoden generische Methoden. Die geringe Kopplung wird durch die Template-Parameter der Funktionen erreicht: Der tatsächliche Typ dieser Parameter kann sich ändern, ohne dass der Quellcode der aufgerufenen Methode angepasst werden muss.
Kohäsion
Das Single-Responsibility-Prinzip besagt, dass eine Klasse nicht mehr als einen Grund für Änderungen haben sollte. Eine solche Klasse gilt als kohäsiv. Ein hoher LCOM-Wert weist im Allgemeinen auf eine Klasse mit geringer Kohäsion hin. Es gibt mehrere LCOM-Metriken. LCOM nimmt Werte im Bereich [0–1] an. LCOM HS (HS steht für Henderson-Sellers) nimmt Werte im Bereich [0–2] an. Ein LCOM-HS-Wert über 1 sollte als Warnsignal betrachtet werden. So lassen sich die LCOM-Metriken berechnen:
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
Dabei gilt:
- M ist die Anzahl der Methoden einer Klasse (gezählt werden statische und Instanzmethoden sowie Konstruktoren, Property-Getter/-Setter und Add-/Remove-Methoden von Events).
- F ist die Anzahl der Instanzfelder der Klasse.
- MF ist die Anzahl der Methoden der Klasse, die auf ein bestimmtes Instanzfeld zugreifen.
- Sum(MF) ist die Summe von MF über alle Instanzfelder der Klasse.
Die Grundidee dieser Formeln lautet: Eine Klasse ist vollständig kohäsiv, wenn alle ihre Methoden alle Instanzfelder verwenden. Dann gilt sum(MF)=M*F und somit LCOM = 0 sowie LCOMHS = 0.
Ein LCOMHS-Wert über 1 sollte als Warnsignal betrachtet werden.
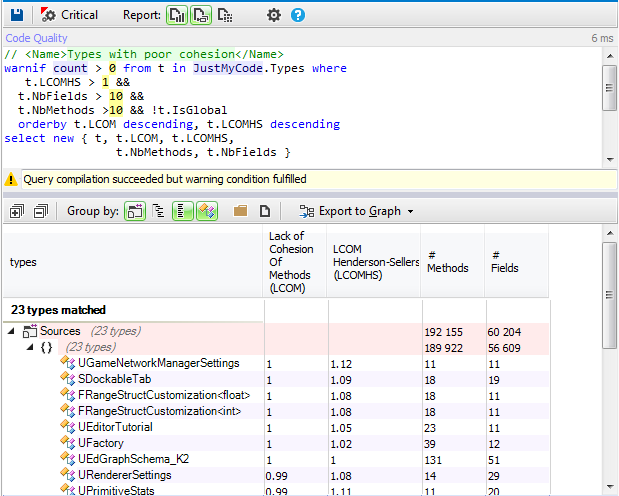
Nur wenige Typen gelten als nicht kohäsiv.
6 – Unveränderlichkeit, Reinheit und Seiteneffekte
6.1 – Unveränderliche Typen
Ein Objekt ist grundsätzlich unveränderlich, wenn sich sein Zustand nach der Erzeugung nicht mehr ändert. Entsprechend ist eine Klasse unveränderlich, wenn ihre Instanzen unveränderlich sind.
Ein wichtiges Argument für unveränderliche Objekte ist, dass sie nebenläufige Programmierung erheblich vereinfachen. Warum ist korrekter Multithreading-Code schwierig? Weil der Zugriff mehrerer Threads auf Ressourcen synchronisiert werden muss und Race Conditions zwischen zahlreichen Lese- und Schreibzugriffen schwer auszuschließen sind. Gibt es jedoch keine Schreibzugriffe mehr – ändert sich also der Zustand der von Threads verwendeten Objekte nicht –, entfällt die Notwendigkeit der Synchronisierung.
Ein weiterer Vorteil unveränderlicher Klassen besteht darin, dass sie das LSP (Liskovsches Substitutionsprinzip) nicht verletzen können. Hier eine Definition des LSP aus Wikipedia:
Liskovs Konzept eines Verhaltenssubtyps definiert die Austauschbarkeit veränderlicher Objekte: Ist S ein Subtyp von T, können Objekte vom Typ T in einem Programm durch Objekte vom Typ S ersetzt werden, ohne erwünschte Eigenschaften des Programms – etwa seine Korrektheit – zu verändern.
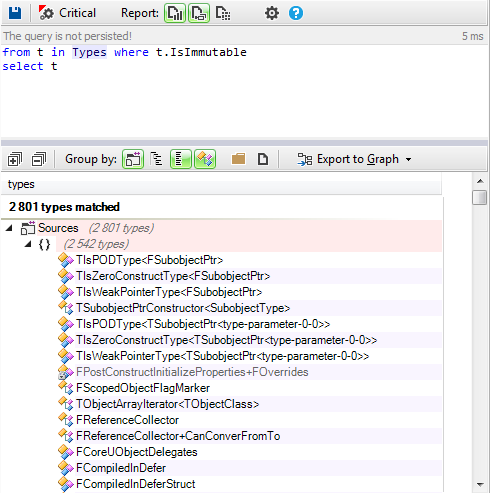
Hier ist die Liste der im Quellcode definierten unveränderlichen Typen:
6.2 – Reinheit und Seiteneffekte
Der wichtigste Vorteil unveränderlicher Typen besteht darin, dass sie Seiteneffekte vermeiden. Treffender als Wes Dyer kann man es kaum formulieren, daher zitiere ich ihn:
Wir alle wissen, dass globale Variablen im Allgemeinen keine gute Idee sind. Sie stellen im Grunde die extremste Form offenliegender Seiteneffekte dar – nämlich im globalen Gültigkeitsbereich. Viele Programmierer, die keine globalen Variablen verwenden, übersehen jedoch, dass dieselben Prinzipien in kleinerem Maßstab auch für Felder, Eigenschaften, Parameter und Variablen gelten: Verändern Sie sie nicht, sofern es keinen guten Grund dafür gibt. (…) Eine Möglichkeit, die Zuverlässigkeit einer Einheit zu erhöhen, besteht darin, Seiteneffekte zu eliminieren. Dadurch lassen sich Einheiten wesentlich einfacher und robuster zusammensetzen und integrieren. Da sie frei von Seiteneffekten sind, verhalten sie sich unabhängig von der Umgebung immer gleich. Dies wird als referenzielle Transparenz bezeichnet. Wenn Sie Funktionen beziehungsweise Methoden ohne Seiteneffekte schreiben – sodass sie reine Funktionen sind, das Objekt also nicht verändern –, lässt sich die Korrektheit des Programms leichter nachvollziehen.
Hier ist die Liste aller Methoden ohne Seiteneffekte.
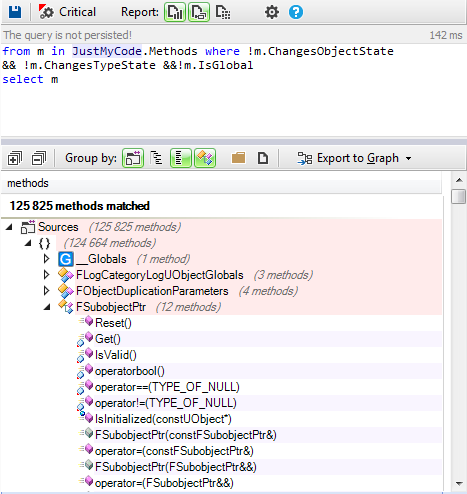
Mehr als 125.000 Methoden sind rein.
7 – Implementierungsqualität
7.1 – Zu große Methoden
Methoden mit sehr vielen Codezeilen sind schwer zu verstehen und zu warten. Suchen wir nach Methoden mit mehr als 60 Zeilen.
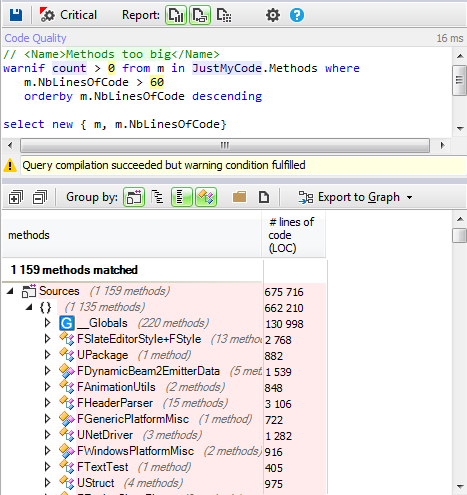
Der Quellcode der Unreal Engine enthält mehr als 150.000 Methoden; weniger als 1 % davon können daher als zu groß betrachtet werden.
7.2 – Methoden mit vielen Parametern
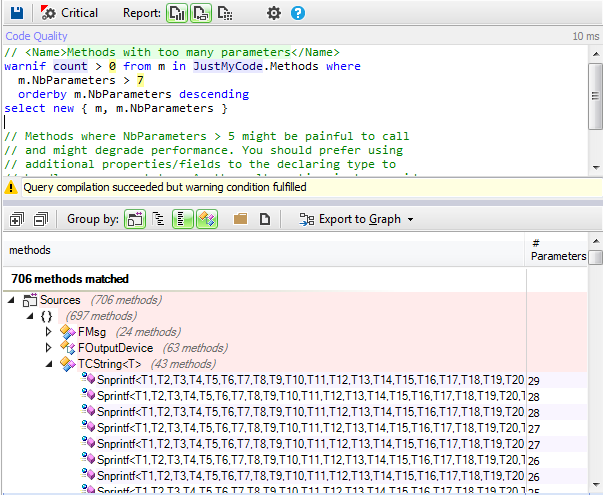
Nur wenige Methoden besitzen mehr als acht Parameter. Die meisten davon sind generisch, um die Definition variadischer Funktionen zu vermeiden, wie bei den TCString::Snprintf-Methoden.
7.3 – Methoden mit vielen lokalen Variablen
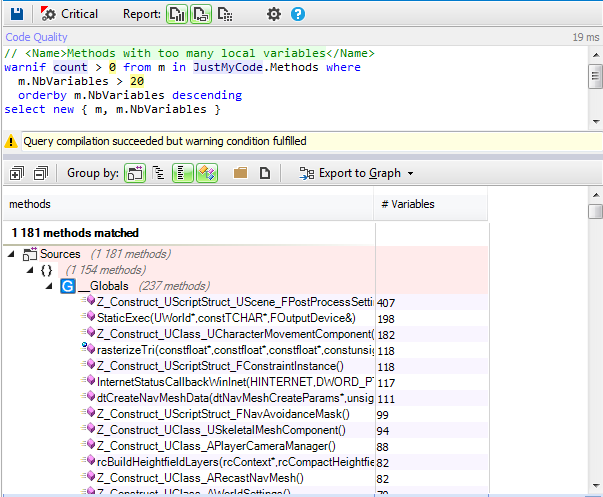
Weniger als 1 % besitzen viele lokale Variablen.
7.4 – Zu komplexe Methoden
Zur Erkennung komplexer Funktionen gibt es zahlreiche Metriken. NBLinesOfCode, die Anzahl der Parameter und die Anzahl lokaler Variablen gehören zu den grundlegenden.
Weitere interessante Metriken zur Erkennung komplexer Funktionen sind:
- Die zyklomatische Komplexität ist eine verbreitete prozedurale Softwaremetrik und entspricht der Anzahl möglicher Entscheidungen innerhalb einer Prozedur.
- Nesting Depth misst bei Methoden die maximale Tiefe des am stärksten verschachtelten Gültigkeitsbereichs im Methodenkörper.
- Max Nested Loop entspricht der maximalen Verschachtelungstiefe von Schleifen in einer Funktion.
Welche Maximalwerte für diese Metriken toleriert werden, hängt vor allem von den Entscheidungen des Teams ab; allgemeingültige Standardwerte gibt es nicht.
Suchen wir nach Methoden, die in der Codebasis der Unreal Engine als komplex gelten könnten.
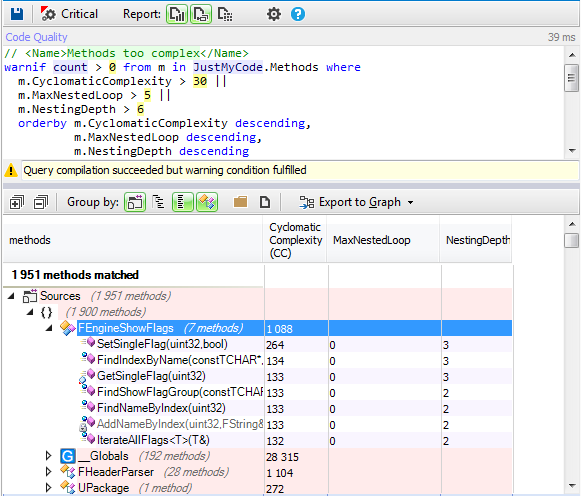
Nur 1,5 % kommen für ein Refactoring zur Verringerung ihrer Komplexität infrage.
7.5 – Halstead-Komplexität
Halstead-Komplexitätsmaße sind Softwaremetriken, die Maurice Howard Halstead 1977 einführte. Halstead stellte fest, dass Softwaremetriken die Implementierung beziehungsweise Darstellung von Algorithmen in unterschiedlichen Sprachen widerspiegeln, zugleich aber unabhängig von ihrer Ausführung auf einer bestimmten Plattform sein sollten. Daher werden diese Metriken statisch aus dem Code berechnet.
Halstead führte zahlreiche Metriken ein. Als Beispiel betrachten wir TimeToImplement, die den zum Programmieren einer Methode benötigten Zeitaufwand in Sekunden angibt.
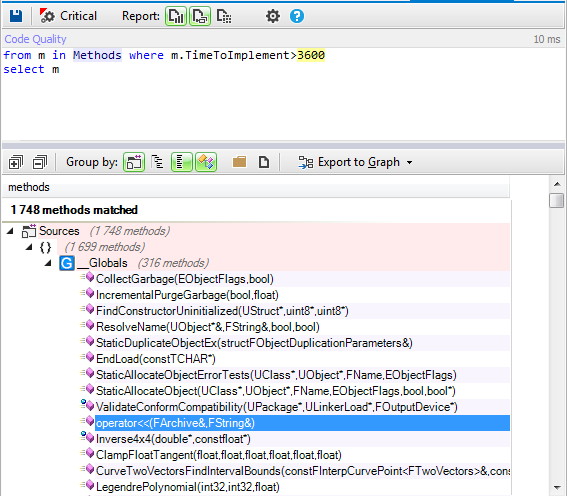
Für 1.748 Methoden wird eine Implementierungszeit von mehr als einer Stunde veranschlagt.
8 – RTTI
RTTI bezeichnet die Fähigkeit eines Systems, den dynamischen Typ eines Objekts zu bestimmen und zur Laufzeit – im Gegensatz zur Compile-Zeit – Informationen über diesen Typ bereitzustellen. RTTI ist in der C++-Community jedoch umstritten, und viele C++-Entwickler verzichten bewusst darauf.
Wie hält es das Entwicklerteam der Unreal Engine damit?
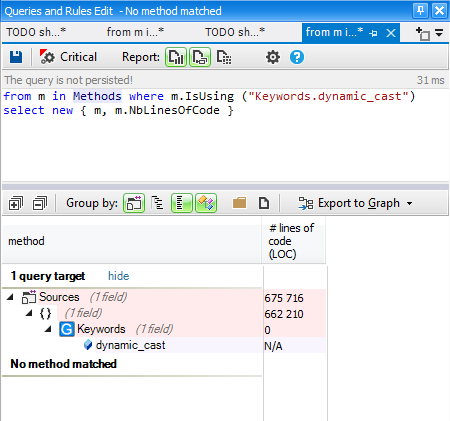
Keine Methode verwendet das Schlüsselwort dynamic_cast; das Unreal-Engine-Team hat sich gegen den RTTI-Mechanismus entschieden.
9- Exceptions
Auch Exception Handling ist eine umstrittene C++-Funktion. Viele bekannte Open-Source-C++-Projekte verzichten darauf.
Prüfen wir, ob im Quellcode der Unreal Engine irgendwo eine Exception ausgelöst wird.
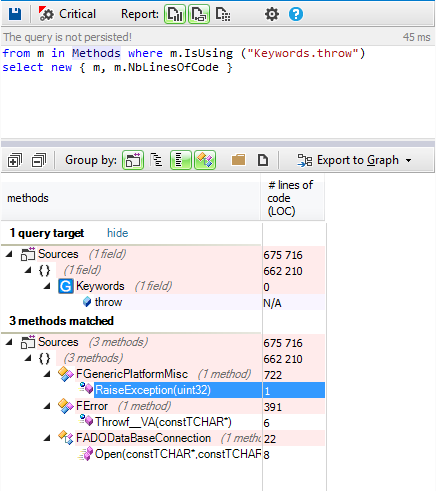
In einigen Methoden werden Exceptions ausgelöst. Betrachten wir als Beispiel RaiseException:
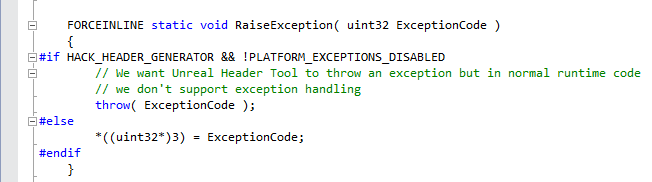
Wie in den Kommentaren angegeben, können für das Header Tool Exceptions erzeugt werden; im normalen Laufzeitcode wird Exception Handling jedoch nicht unterstützt.
10 – Einige Statistiken
10.1 – Am häufigsten verwendete Typen
Es ist interessant zu wissen, welche Typen in einem Projekt am häufigsten verwendet werden. Gerade diese Typen müssen sorgfältig entworfen, implementiert und getestet sein, denn Änderungen an ihnen können sich auf das gesamte Projekt auswirken.
Wir können sie mithilfe der Metrik TypesUsingMe ermitteln:
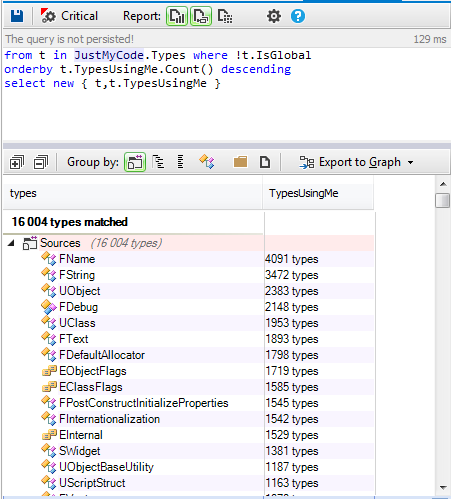
Es gibt jedoch noch eine weitere interessante Metrik zur Ermittlung wichtiger Typen: TypeRank.
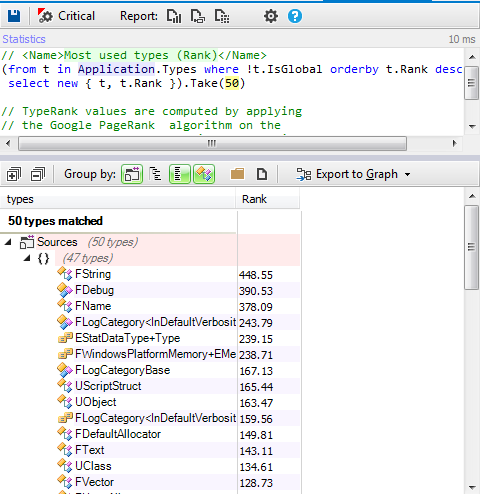
TypeRank-Werte werden berechnet, indem der Google-PageRank -Algorithmus auf den Abhängigkeitsgraphen der Typen angewendet wird. Eine Homothetie mit dem Zentrum 0,15 sorgt dafür, dass der durchschnittliche TypeRank den Wert 1 besitzt.
Typen mit hohem TypeRank sollten besonders sorgfältig getestet werden, da Fehler in solchen Typen wahrscheinlich schwerwiegendere Auswirkungen haben.
Hier ist das Ergebnis für alle wichtigen Typen gemäß der TypeRank-Metrik:
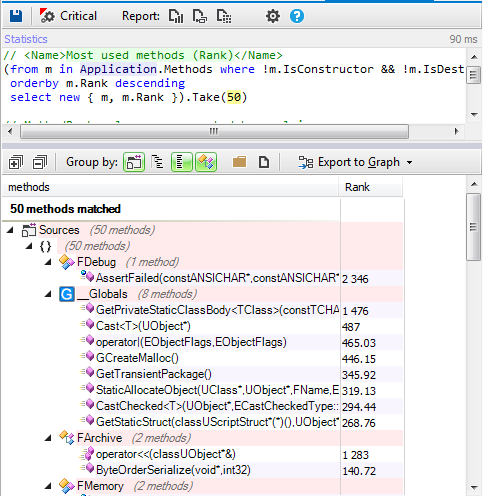
10.2 – Am häufigsten verwendete Methoden
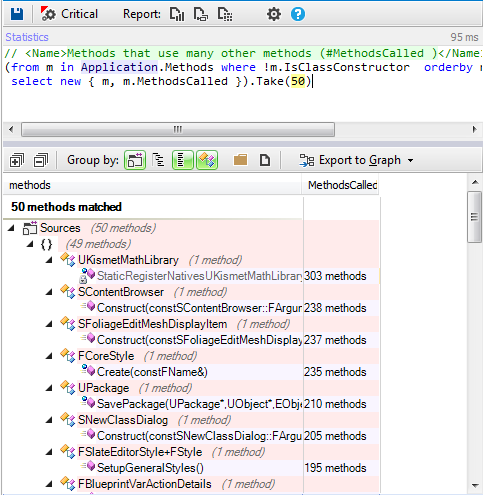
10.3 – Methoden, die viele andere Methoden aufrufen
Es ist aufschlussreich zu wissen, welche Methoden viele andere Methoden verwenden. Dies kann Designprobleme aufdecken; in manchen Fällen ist ein Refactoring erforderlich, um Lesbarkeit und Wartbarkeit zu verbessern.