The Unreal Engine は、 Epic Gamesが開発したゲームエンジンで、1998年の一人称シューティングゲーム Unrealで初めて披露されました。主に一人称シューティングゲーム向けに開発されましたが、ステルス、MMORPG、その他のRPGなど、さまざまなジャンルでも成功を収めてきました。
そのコードはC++で書かれており、現在多くのゲーム開発者に使用されています。ソースコードは GitHubで公開されており、学生には 無料 で提供されています。このエンジンを使って多くの素晴らしいゲームが開発されており、次のような非常にリアルなレンダリングを実現できます。
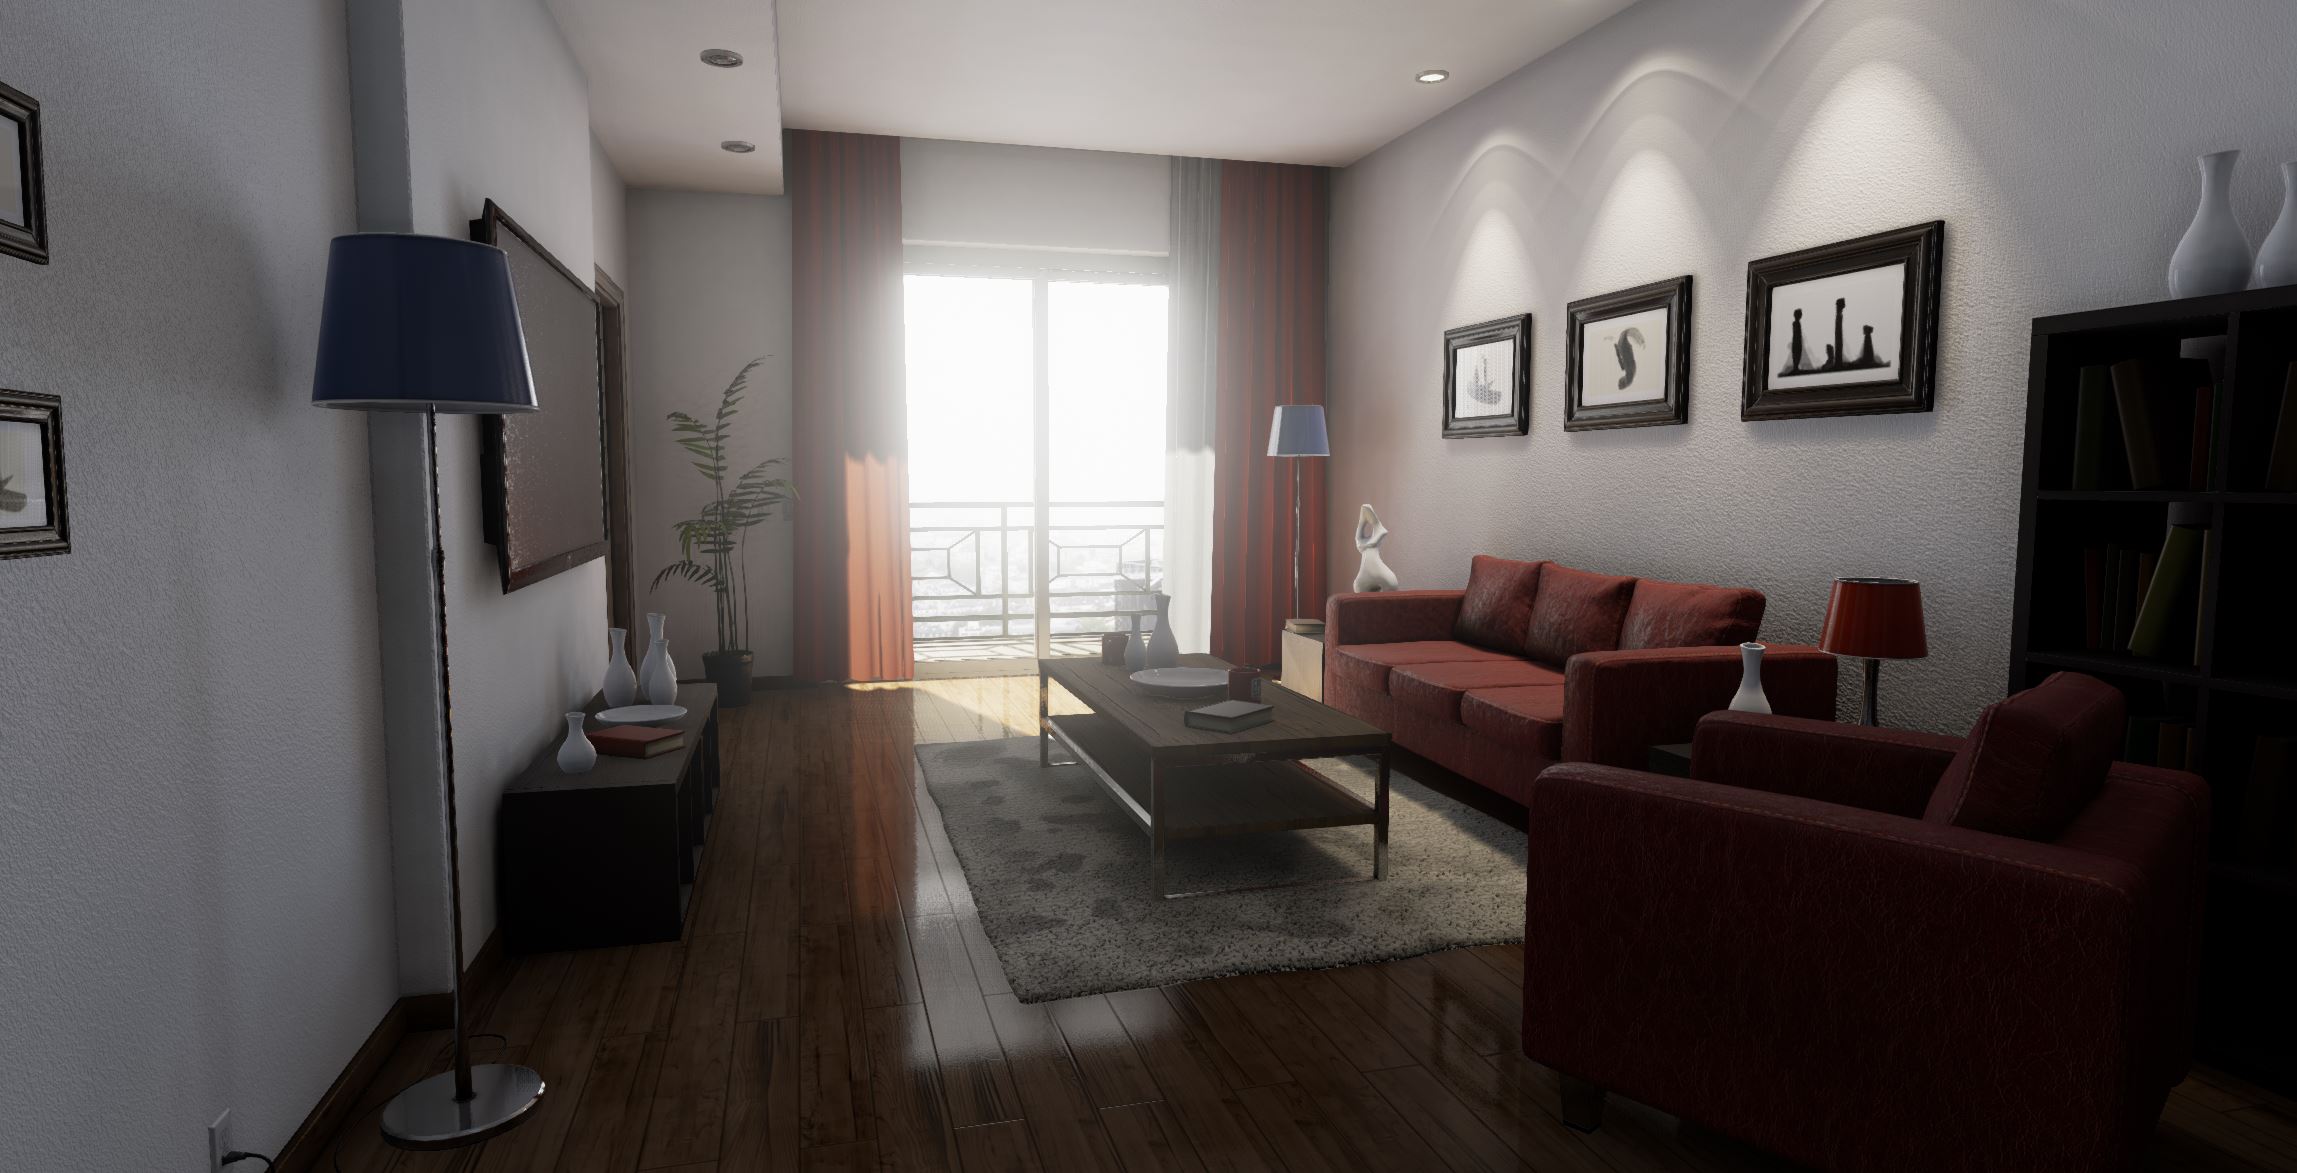
このリアルなレンダリングを生成するために、内部ではどのようなソースコードが実行されているのでしょうか?
この強力なゲームエンジンの内部を見て、その設計と実装を探るのは非常に興味深いことです。C++開発者は、そのコードベースから多くのベストプラクティスを学べます。
ここでは、 CppDepend と CQLinq を使ってソースコードを調べ、開発チームによる設計と実装の選択をいくつか検出してみましょう。
1. 名前空間
Unreal Engineでは、主に3つの理由で名前空間が広く使用されています:
- 多くの名前空間にはenumだけが含まれています。次のCQLinqクエリは、enumだけを含む名前空間を返します。
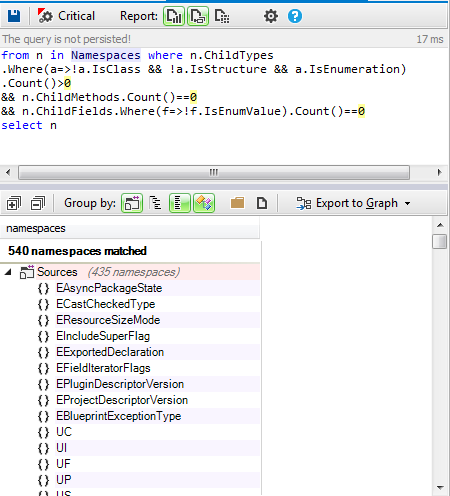
大規模プロジェクトでは、2つの異なるenumが同じ名前を使用しないという保証はありません。この問題はC++11で enum classによって解決されました。enum classは、enum値を暗黙的にenum名のスコープ内に配置します。
- 匿名名前空間:名前のない名前空間により、グローバルな静的変数が不要になります。作成した「匿名」名前空間は、それを作成したファイル内でのみアクセスできます。使用されているすべての匿名名前空間の一覧は次のとおりです:
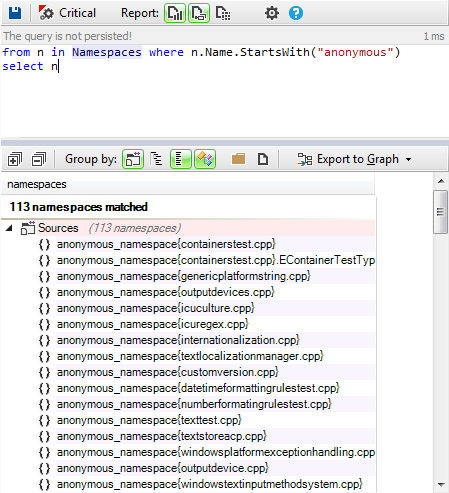
- コードベースのモジュール化:匿名名前空間でも、enumだけを含む名前空間でもない、その他のすべての名前空間を検索してみましょう:
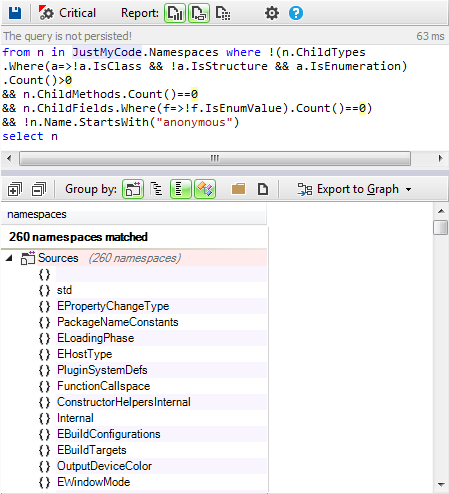
名前空間は、アプリケーションをモジュール化する優れた解決策です。Unreal Engineは、モジュール性を強制するために250を超える名前空間を定義しており、これによりコードの可読性と保守性が高まっています。
2. 使用されているパラダイム
C++は単なるオブジェクト指向言語ではありません。Bjarne Stroustrupが指摘しているように、「C++はマルチパラダイム言語」です。C++はさまざまなプログラムのスタイル、つまりパラダイムをサポートしており、オブジェクト指向プログラミングはその1つにすぎません。他には、手続き型プログラミングやジェネリックプログラミングなどがあります。
2.1 手続き型パラダイム
2.1.1 グローバル関数
Unreal Engineのソースコードで定義されているすべてのグローバル関数を検索してみましょう:
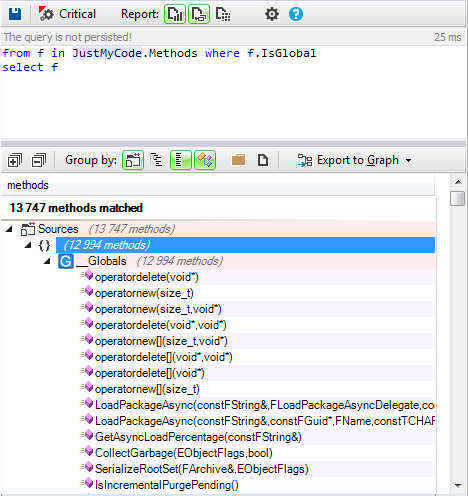
これらの関数は3つのカテゴリに分類できます:
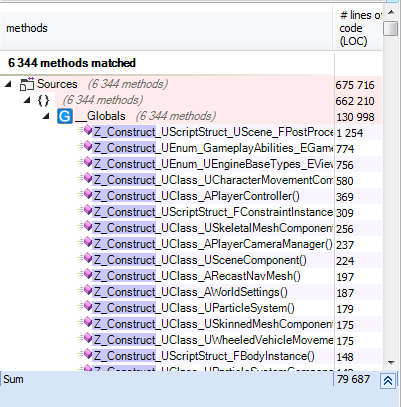
1. ユーティリティ関数:たとえば、6,344個はZ_Construct_UXXX関数で、エンジンが必要とするインスタンスを作成するために使用されます。
2. 演算子:次のCQLinqクエリの結果が示すように、多くの演算子が定義されています:
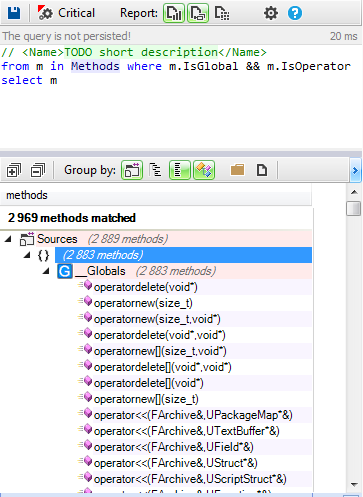
Unreal Engineのソースコードには、ほぼすべての種類の演算子が実装されています。
3. エンジンロジックに関連する関数:エンジンロジックを含む多くのグローバル関数が実装されています。これらの種類の関数は、クラスの静的メソッドとしてカテゴリごとにグループ化するか、名前空間にグループ化できるかもしれません。
2.1.2 静的グローバル関数
別のソースファイルから呼び出す特別な必要がない限り、グローバル関数はstaticとして宣言するのがベストプラクティスです。
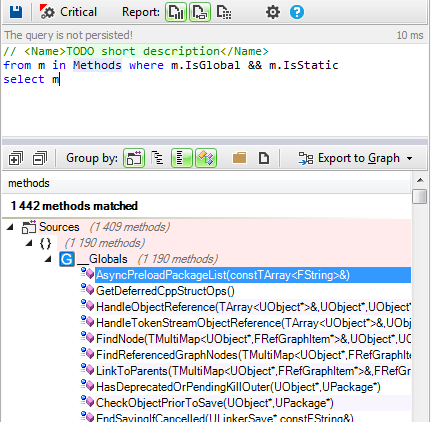
多くのグローバル関数がstaticとして宣言されており、前述のとおり、他のグローバル関数は匿名名前空間内で定義されています。
2.1.3 staticにできるグローバル関数
エクスポートされておらず、匿名名前空間内で定義されておらず、定義されているファイル外のどのメソッドからも使用されていないグローバル関数は、静的関数へリファクタリングする良い候補です。
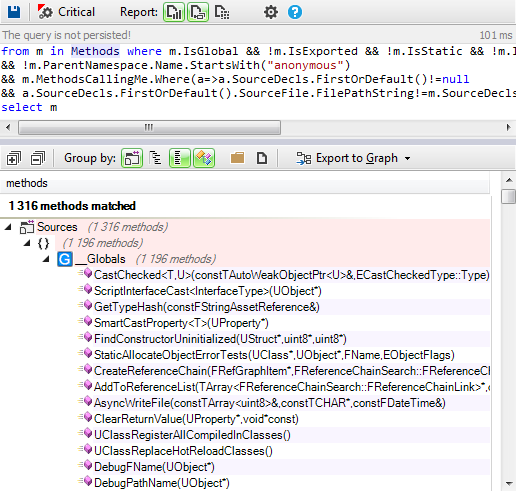
ご覧のとおり、一部のグローバル関数はstaticにする候補です。
2.2 オブジェクト指向パラダイム
2.2.1 継承
オブジェクト指向プログラミング(OOP)では、継承はオブジェクト間にIs-a関係を確立する方法です。これは既存コードを再利用する方法と混同されることがよくありますが、実装再利用のための継承は強い結合につながるため、良い慣行ではありません。コードの再利用性はコンポジションによって実現されます(継承よりもコンポジション)。少なくとも1つの基底クラスを持つすべてのクラスを検索してみましょう:
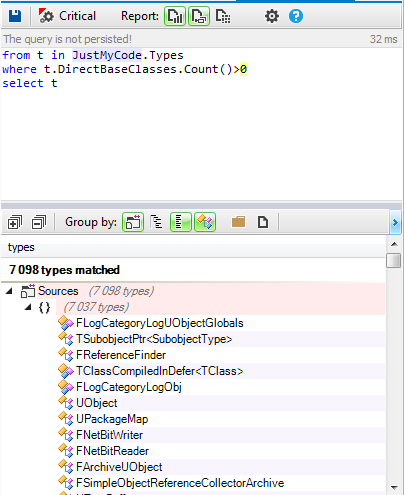
このクエリの対象となるクラスをよりよく把握するために、Metric Viewを使用できます。
Metric Viewでは、コードベースがツリーマップで表現されます。ツリーマッピングは、入れ子になった長方形を使ってツリー構造のデータを表示する方法です。CppDependのツリーマップで使用されるツリー構造は、通常のコード階層です:
- プロジェクトには名前空間が含まれる。
- 名前空間には型が含まれる。
- 型にはメソッドとフィールドが含まれる。
ツリーマップビューは、CQLinqクエリの結果を表現する便利な方法を提供します。青い長方形がこの結果を表すため、クエリ対象の型を視覚的に確認できます。
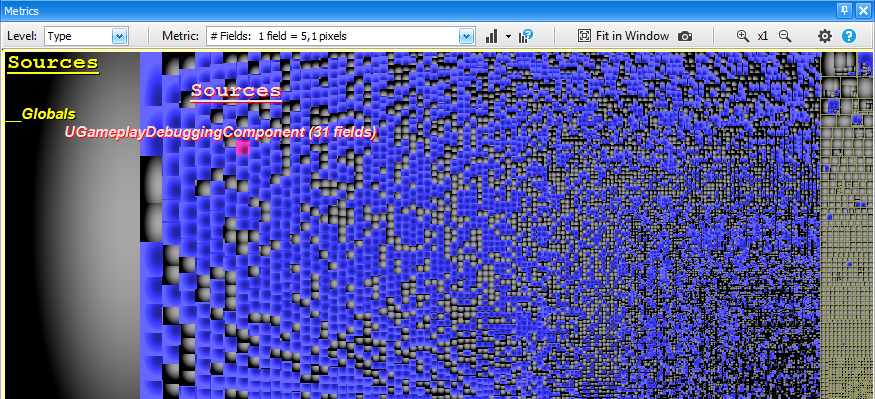
ご覧のとおり、Unreal Engineのソースコードでは継承が広く使用されています。
多重継承:複数の具象クラスを継承しているクラスを検索してみましょう。
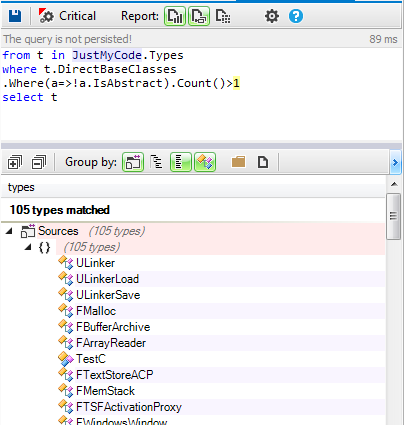
多重継承は広く使用されておらず、複数のクラスを継承しているクラスはごく少数です。
2.2.2 仮想メソッド
Unreal Engineのソースコードで定義されているすべての仮想メソッドを検索してみましょう:
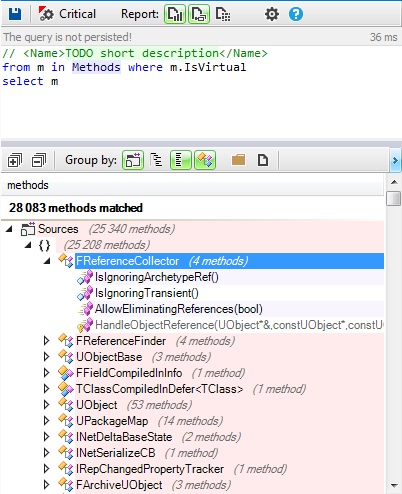
多くのメソッドが仮想メソッドであり、その一部は純粋仮想メソッドです:
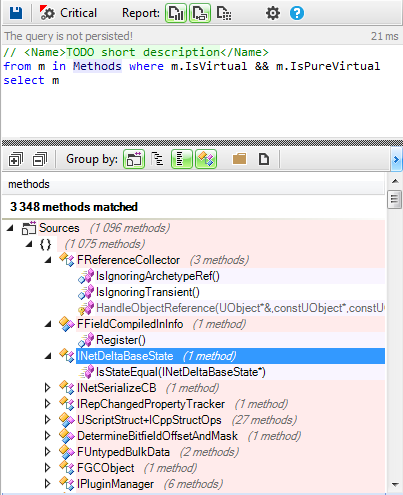
手続き型パラダイムと同様に、OOPパラダイムもUnreal Engineのソースコードで広く使用されています。では、ジェネリックプログラミングパラダイムはどうでしょうか?
2.3 ジェネリックプログラミング
C++は、テンプレートを通じてジェネリックプログラミングの考え方を表現するための独自の機能を提供します。テンプレートは、ジェネリックなアルゴリズムとデータ構造を表現できる、パラメトリックポリモーフィズムの一形態を提供します。C++テンプレートのインスタンス化機構により、ジェネリックなアルゴリズムやデータ構造が使用されるときには、その特定の用途向けに完全に最適化・特殊化されたバージョンが作成され、ジェネリックなアルゴリズムが非ジェネリックなアルゴリズムと同じくらい効率的になります。
2.3.1 ジェネリック型
エンジンのソースコードで定義されているすべてのジェネリック型を検索してみましょう:
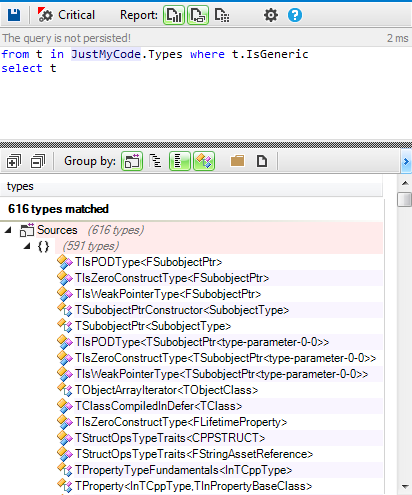
ジェネリックとして定義されている型はごく少数です。次に、ジェネリックメソッドを検索してみましょう:
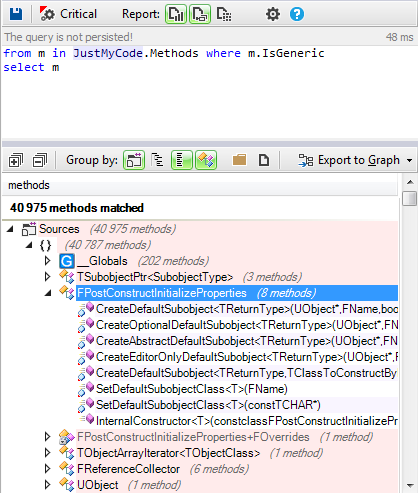
40,000を超えるメソッドがジェネリックであり、実装されているメソッドの25%以上を占めています。
要約すると、Unreal Engineのソースコードでは3つのパラダイムが混在しています。
3. データモデルを定義するPOD
オブジェクト指向プログラミングにおいて、plain old data(POD)は、オブジェクト指向機能を使用せず、フィールド値(インスタンス変数)の受動的な集合としてのみ表現されるデータ構造です。計算機科学では、これは受動的データ構造として知られています。
Unreal EngineのソースコードでPOD型を検索してみましょう。
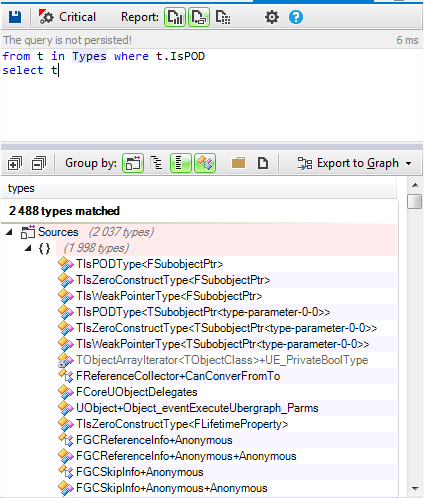
2,000を超える型がPOD型として定義されており、その多くがエンジンのデータモデルを定義するために使用されています。
4. Gang of Fourデザインパターン
デザインパターンは、ソフトウェア設計における共通の問題に対する反復的な解決策を説明するソフトウェアエンジニアリングの概念です。Gang of Fourパターンは最も有名です。Unreal Engineのソースコードで使用されているものをいくつか見ていきましょう。
4.1 Singleton
Singletonは最も有名で、最もよく使われるパターンです。ソースコードで定義されているSingletonクラスの一部は次のとおりです:
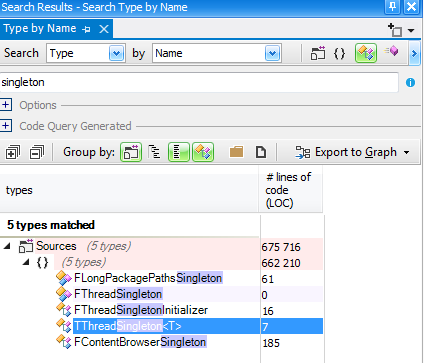
TThreadSingletonは特殊なバージョンのSingletonで、スレッドごとに1つのインスタンスだけが作成されます。そのGet()メソッドの呼び出しはスレッドセーフです。
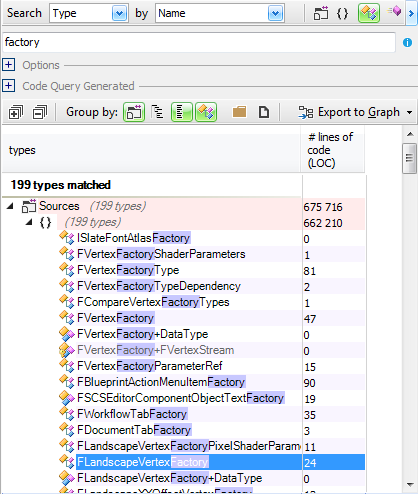
4.2 Factory
ファクトリを使用すると、インスタンス化ロジックを分離して凝集性を高められるため有用です。ソースコードで定義されているファクトリの一覧は次のとおりです:
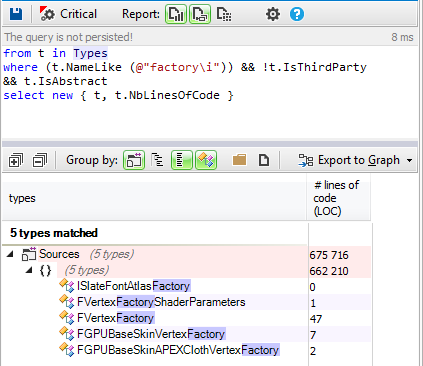
抽象ファクトリの一覧は次のとおりです:
4.3 Observer
Observerパターンは、オブジェクトがオブザーバーと呼ばれる依存オブジェクトのリストを保持し、通常はそれらのメソッドの1つを呼び出すことで、状態変化を自動的に通知するソフトウェアデザインパターンです。
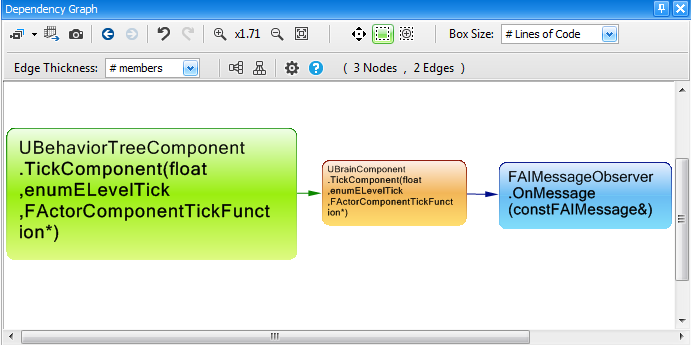
ソースコードにはいくつかのオブザーバーが実装されており、FAIMessageObserverはその1つです。
このオブザーバーのOnMessageメソッドの呼び出しを示す依存関係グラフは次のとおりです:
4.4 Command
Commandパターンは、後の時点でメソッドを呼び出すために必要なすべての情報を、オブジェクトを使って表現・カプセル化する振る舞いデザインパターンです。
Commandパターンに常に関連付けられる4つの用語は、コマンド、レシーバー、インボーカー、クライアントです。コマンドオブジェクトはレシーバーオブジェクトを持ち、そのレシーバーのクラスに固有の方法でレシーバーのメソッドを呼び出します。
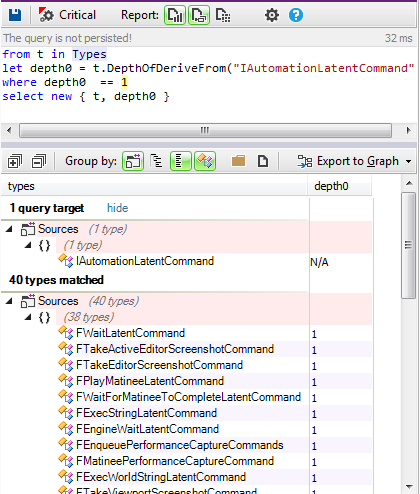
たとえば、IAutomationLatentCommandを継承しているすべてのコマンドは次のとおりです:
5. 結合と凝集
5.1 結合
アプリケーションのある領域での変更が、アプリケーション全体で必要となる変更を少なくするため、低結合は望ましい特性です。長期的には、アプリケーションの修正や新機能追加に伴う時間、労力、コストを大幅に節約できる可能性があります。
低結合は、抽象クラスを使用するか、ジェネリックな型とメソッドを使用することで実現できます。
Unreal Engineのソースコードで定義されているすべての抽象クラスを検索してみましょう:
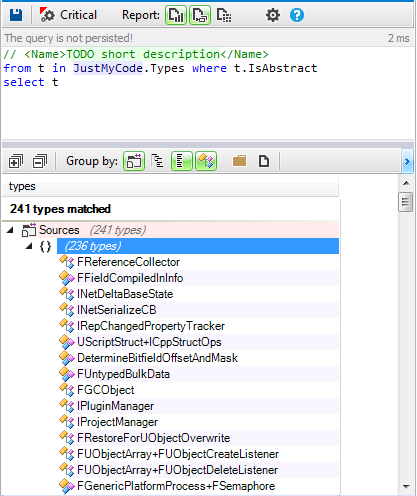
抽象として宣言されている型はごく少数です。低結合は、ジェネリックな型とジェネリックメソッドを使用することで、より効果的に強制されています。
たとえば、少なくとも1つのジェネリックメソッドを使用しているメソッドは次のとおりです:
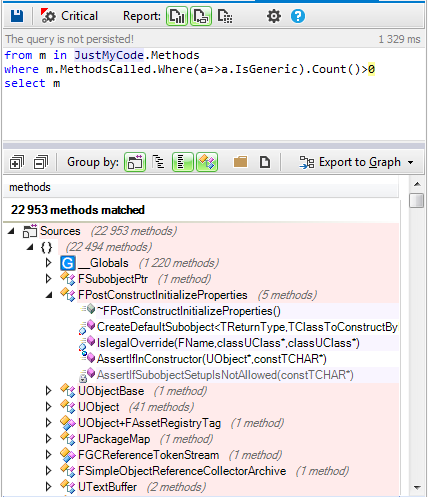
ご覧のとおり、多くのメソッドがジェネリックメソッドを使用しています。低結合は、関数テンプレートパラメータによって強制されています。実際、これらのパラメータの実際の型は、呼び出されるメソッドのソースコードを変更せずに変更できます。
凝集性
単一責任の原則は、クラスに変更する理由が複数あってはならないと述べています。そのようなクラスは凝集性が高いと言われます。一般に、LCOM値が高いことは凝集性の低いクラスを示します。LCOMには複数の指標があります。LCOMは[0-1]の範囲の値を取り、LCOM HS(HSはHenderson-Sellersの略)は[0-2]の範囲の値を取ります。LCOM HS値が1を超える場合は、注意すべき状態と考えるべきです。LCOM指標の計算方法は次のとおりです:
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
ここで:
- Mはクラス内のメソッド数です(静的メソッドとインスタンスメソッドの両方が数えられ、コンストラクタ、プロパティのゲッター/セッター、イベントのadd/removeメソッドも含まれます)。
- Fはクラス内のインスタンスフィールドの数です。
- MFは、特定のインスタンスフィールドへアクセスするクラスのメソッド数です。
- Sum(MF)は、クラスのすべてのインスタンスフィールドにわたるMFの合計です。
これらの式の背景にある基本的な考え方は、次のように述べられます。クラスのすべてのメソッドがすべてのインスタンスフィールドを使用する場合、そのクラスは完全に凝集しています。つまりsum(MF)=M*Fとなり、LCOM = 0、LCOMHS = 0になります。
LCOMHS値が1を超える場合は、注意すべき状態と考えるべきです。
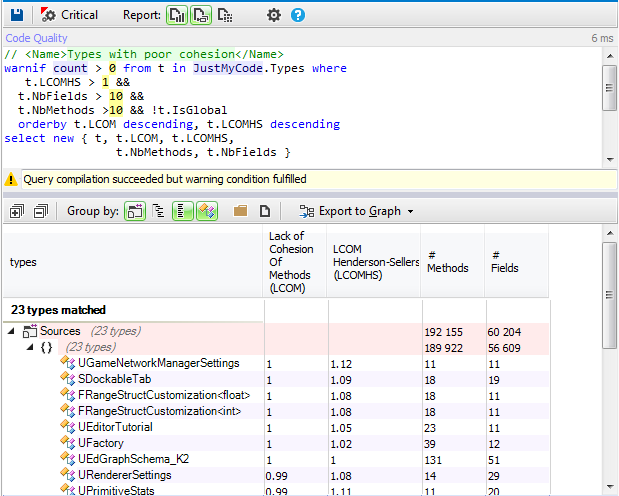
凝集性が低いと見なされる型はごく少数です。
6. 不変性、純粋性、副作用
6.1 不変型
基本的に、オブジェクトが作成された後に状態が変化しない場合、そのオブジェクトは不変です。したがって、クラスのインスタンスが不変である場合、そのクラスは不変です。
不変オブジェクトを使用することには、重要な利点が1つあります。並行プログラミングを劇的に単純化するのです。考えてみてください。適切なマルチスレッドコードを書くことがなぜ難しいのでしょうか。リソース(オブジェクトやその他のOSリソース)へのスレッドアクセスを同期するのが難しいからです。なぜこれらのアクセスを同期するのが難しいのでしょうか。複数のスレッドが複数のオブジェクトに対して行う複数の書き込み・読み取りアクセス間で競合状態が発生しないことを保証するのが難しいからです。書き込みアクセスがなくなったらどうなるでしょうか。言い換えると、スレッドがアクセスするオブジェクトの状態が変化しなければどうなるでしょうか。その場合、同期は不要になります。
不変クラスのもう1つの利点は、LSP(リスコフの置換原則)に違反することがないことです。そのWikiページから引用したLSPの定義は次のとおりです:
リスコフの振る舞い的サブタイプの概念は、可変オブジェクトの置換可能性の概念を定義します。つまり、SがTのサブタイプである場合、プログラム内の型Tのオブジェクトは、そのプログラムの望ましい性質(正しさなど)を変えることなく、型Sのオブジェクトで置き換えられなければなりません。
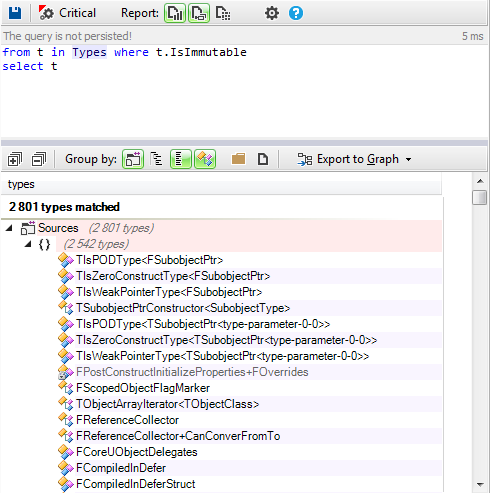
ソースコードで定義されている不変型の一覧は次のとおりです:
6.2 純粋性と副作用
不変型の主な利点は、副作用を排除することにあります。この点については、 Wes Dyer以上にうまく説明できないため、彼の言葉を引用します:
一般に、グローバル変数を使用するのは良い考えではないことを、私たちは皆知っています。これは基本的に、副作用を公開する極端な例(グローバルスコープ)です。グローバル変数を使わない多くのプログラマーは、同じ原則が、より限定的な範囲のフィールド、プロパティ、パラメータ、変数にも適用されることに気づいていません。十分な理由がない限り、それらを変更してはいけません。(…)ユニットの信頼性を高める1つの方法は、副作用を排除することです。これにより、ユニットを組み合わせて統合することがはるかに容易で堅牢になります。副作用がないため、環境に関係なく常に同じように機能します。これを参照透過性と呼びます。 関数/メソッドを副作用なしで書くこと、つまりそれらを 純粋関数(オブジェクトを変更しない関数) にすることで、プログラムの正しさについて考えやすくなります。
副作用のないすべてのメソッドの一覧は次のとおりです。
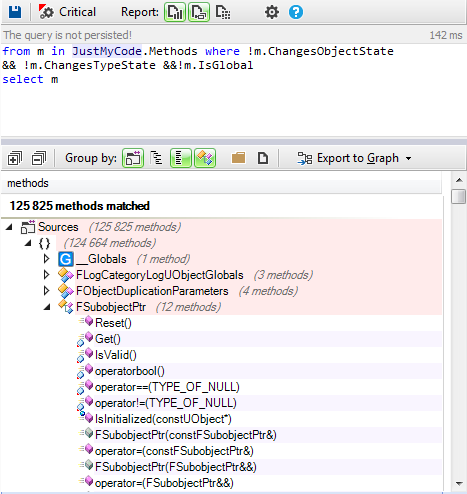
125,000を超えるメソッドが純粋です。
7. 実装品質
7.1 大きすぎるメソッド
コード行数が多いメソッドは、保守と理解が容易ではありません。60行を超えるメソッドを検索してみましょう。
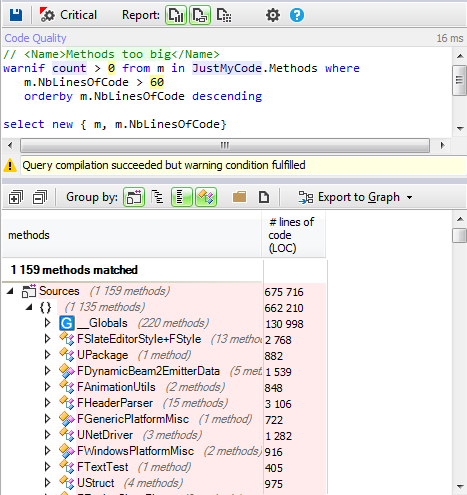
Unreal Engineのソースコードには150,000を超えるメソッドが含まれているため、大きすぎると見なせるのは1%未満です。
7.2 パラメータが多いメソッド
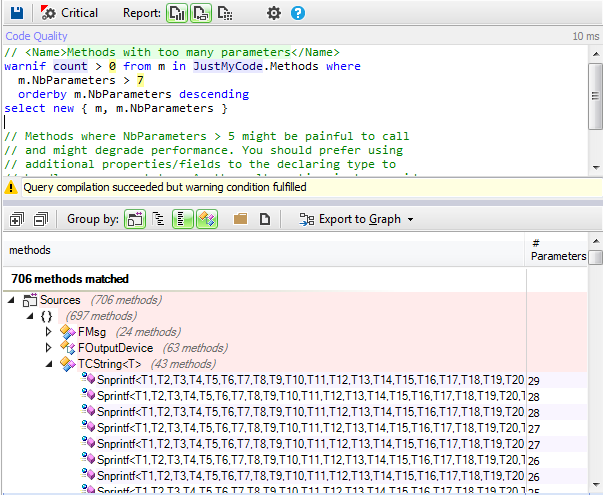
8個を超えるパラメータを持つメソッドは少数です。そのほとんどは、TCString::Snprintfメソッドの場合のように、可変長引数関数を定義しないようにするためのジェネリックメソッドです。
7.3 ローカル変数が多いメソッド
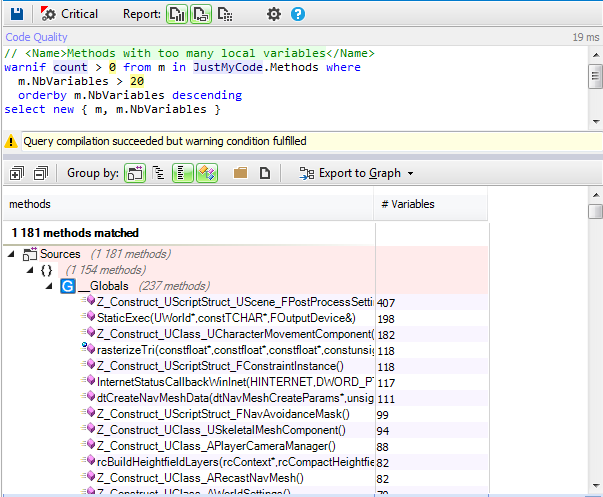
ローカル変数が多いメソッドは1%未満です。
7.4 複雑すぎるメソッド
複雑な関数を検出する指標は多数存在します。NBLinesOfCode、パラメータ数、ローカル変数の数は基本的なものです。
複雑な関数を検出するための、他の興味深い指標もあります:
- 循環的複雑度は、手続き内で行われ得る決定の数に等しい、一般的な手続き型ソフトウェア指標です。
- Nesting Depthは、メソッド本体内で最も深く入れ子になったスコープの最大深度に関する、メソッドに定義される指標です。
- Max Nested Loopは、関数内のループの最大入れ子レベルです。
これらの指標で許容される最大値は、主にチームの選択によって決まります。標準的な値はありません。
Unreal Engineコードベースで、複雑と見なせるメソッドを検索してみましょう。
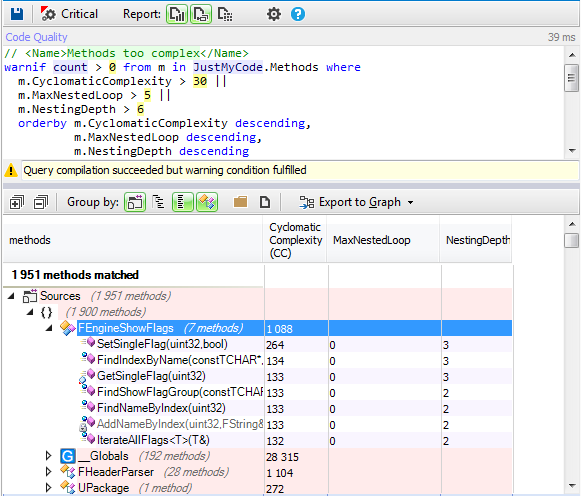
複雑さを減らすためにリファクタリングの候補となるのは1.5%だけです。
7.5 Halstead複雑度
Halstead複雑度 測定は、Maurice Howard Halsteadが1977年に導入したソフトウェア指標です。Halsteadは、ソフトウェアの指標は、特定のプラットフォームでの実行には依存せず、さまざまな言語におけるアルゴリズムの実装や表現を反映すべきだと指摘しました。したがって、これらの指標はコードから静的に計算されます。
Halsteadによって多くの指標が導入されました。例として、メソッドをプログラミングするのに必要な時間を秒で表すTimeToImplementを見てみましょう。
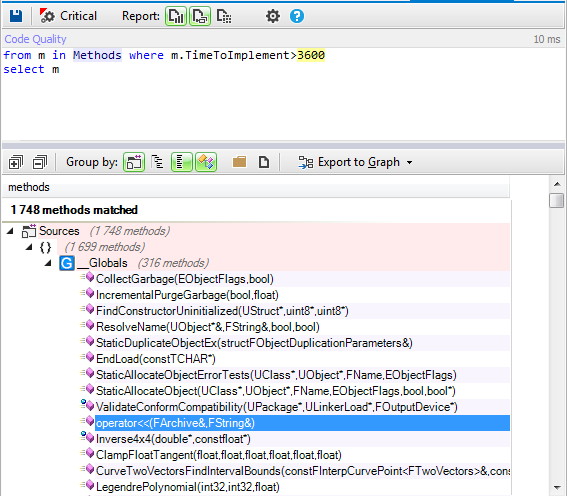
1,748個のメソッドは、実装に1時間以上を要します。
8. RTTI
RTTIは、システムがオブジェクトの動的型を報告し、(コンパイル時ではなく)実行時にその型に関する情報を提供する機能を指します。しかし、RTTIはC++コミュニティ内で議論の対象となっています。多くのC++開発者は、この機構を使用しないことを選んでいます。
Unreal Engineの開発チームはどうでしょうか?
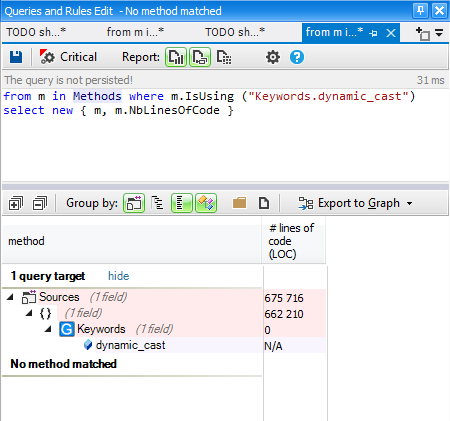
dynamic_castキーワードを使用しているメソッドはありません。Unreal Engineチームは、RTTI機構を使用しないことを選択しました。
9. 例外
例外処理も、議論の多いC++機能です。多くの有名なオープンソースC++プロジェクトでは使用されていません。
Unreal Engineのソースコード内のどこかで例外がスローされているかを検索してみましょう。
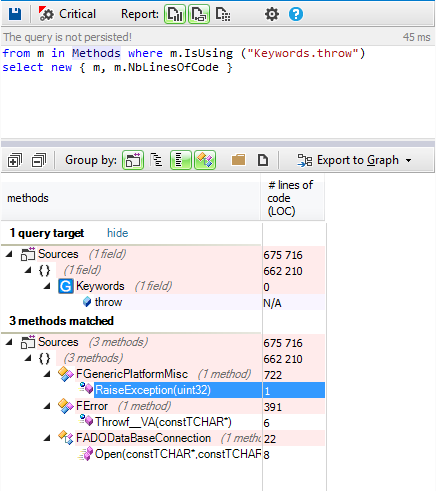
一部のメソッドで例外がスローされています。例としてRaiseExceptionを見てみましょう:
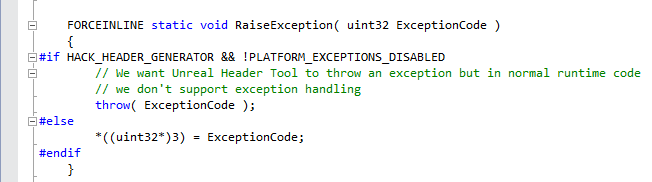
コメントに記載されているとおり、ヘッダーツールでは例外が生成される可能性がありますが、通常の実行時コードでは例外処理をサポートしていません。
10. いくつかの統計
10.1 最も人気のある型
プロジェクトで最も使用されている型を知ることは興味深いことです。これらの型は、適切に設計・実装・テストされている必要があります。また、それらへの変更はプロジェクト全体に影響する可能性があります。
これらは TypesUsingMe 指標を使って見つけられます:
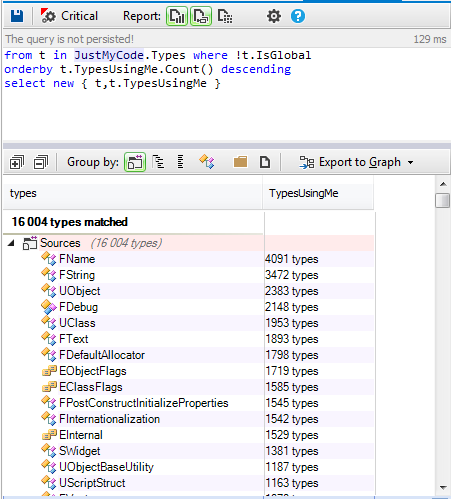
ただし、人気のある型を検索するためのもう1つの興味深い指標としてTypeRankがあります。
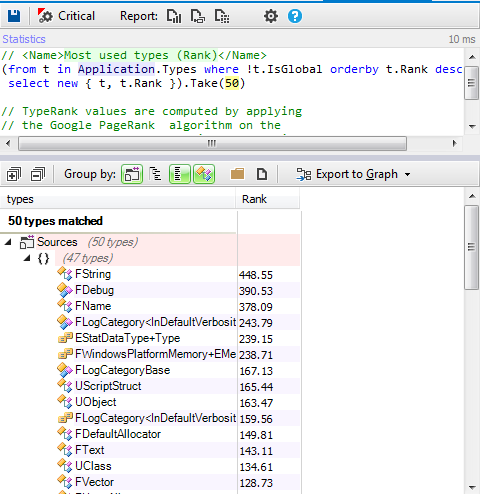
TypeRank値は、 Google PageRank アルゴリズムを型依存関係グラフへ適用して計算されます。TypeRankの平均が1になるよう、中心0.15の相似変換が適用されます。
TypeRankが高い型は、より慎重にテストすべきです。このような型のバグは、より深刻な影響を及ぼす可能性が高いからです。
TypeRank指標による、人気のあるすべての型の結果は次のとおりです:
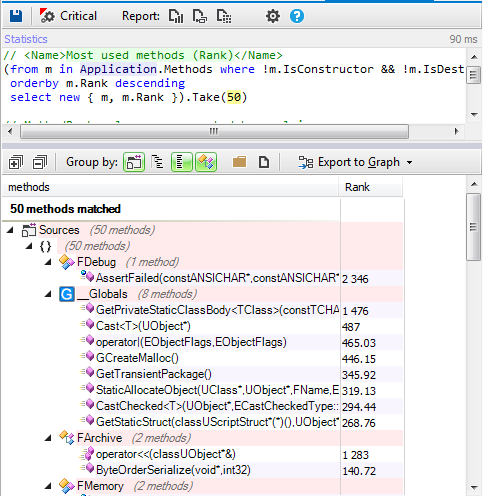
10.2 最も人気のあるメソッド
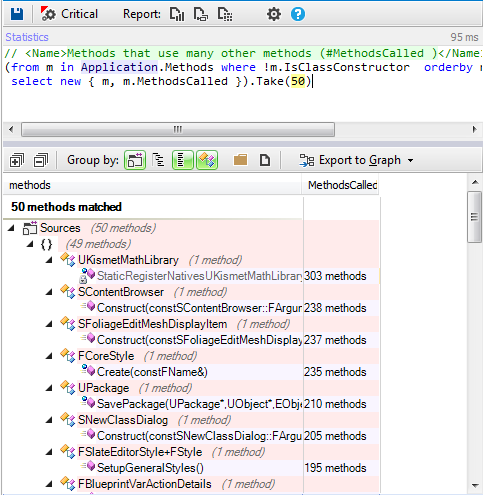
10.3 他の多くのメソッドを呼び出すメソッド
他の多くのメソッドを使用しているメソッドを知ることは興味深いことです。これは、それらのメソッドに設計上の問題があることを示している可能性があり、場合によっては、可読性と保守性を高めるためのリファクタリングが必要です。