
Vor seiner ersten Standardisierung im Jahr 1998 wurde C++ seit 1979 von Bjarne Stroustrup bei Bell Labs als Erweiterung der Sprache C entwickelt. Sein Ziel war eine effiziente und flexible Sprache mit den Stärken von C.
1983 wurde „C with Classes“ in „C++“ umbenannt. Hinzu kamen unter anderem virtuelle Funktionen, das Überladen von Funktionsnamen und Operatoren, Referenzen, Konstanten, typsichere dynamische Speicherverwaltung mit new/delete und eine verbesserte Typprüfung.
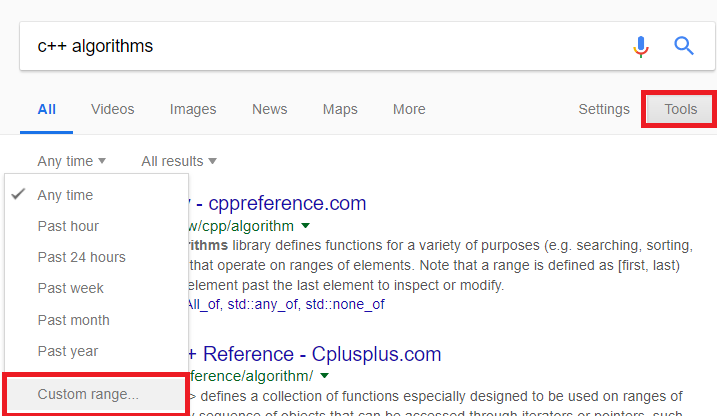
Zu verstehen, wie sich eine Sprache entwickelt hat, hilft uns, die Motivation hinter den im Laufe der Jahre getroffenen Entscheidungen nachzuvollziehen. Sehen wir uns daher an, wie C++-Algorithmen von den frühen 1980er-Jahren bis heute geschrieben wurden. Eine Möglichkeit für diese historische Reise ist eine Google-Suche nach relevanten Begriffen mit benutzerdefinierten Zeiträumen.
Zwischen 1985 und 1990
Sehen wir uns den C++-Code zwischen 1985 und 1990 an. Nach dem Festlegen eines benutzerdefinierten Zeitraums erhalten wir für den Suchbegriff „C++ algorithm“ einige Ergebnisse. Zum Beispiel diesen link aus Dr. Dobb’s Journal aus dem Jahr 1990. Dr. Dobb’s trug über viele Jahre wesentlich zur Verbreitung von C++ bei – besonderer Dank gilt allen Autoren, die so viele wertvolle Ressourcen zum Erlernen von C++ bereitstellten. Leider wurde die Publikation Ende 2014 eingestellt.
Hier ist ein Ausschnitt aus dem Code.
WriteFraction(n) long n;
{
   unsigned short i, low, digit; unsigned long k;
   putchar(n < 0 ? '-' : ' '); n = abs(n);
   putchar((n>>fractionBits) + '0'); putchar('.');
   low = k = n << (longBits-fractionBits); /* align octal point at left */
   k >>= 4; /* shift to make room for a decimal digit */
   for (i=1; i<=8; ++i)
   {
      digit = (k *= 10L) >> (longBits-4);
      low = (low & 0xf) * 10;
      k += ((unsigned long) (low>>4)) - ((unsigned long) digit <<   (longBits-4));
      putchar(digit+'0');
   }
}
Vergleichen wir diesen Codeausschnitt mit dem ungefähr zur gleichen Zeit veröffentlichten Quellcode von „Microsoft Word 1.1“. Microsoft hat den Quellcode von „Microsoft Word 1.1“ vor einiger Zeit dem Computer History Museum.
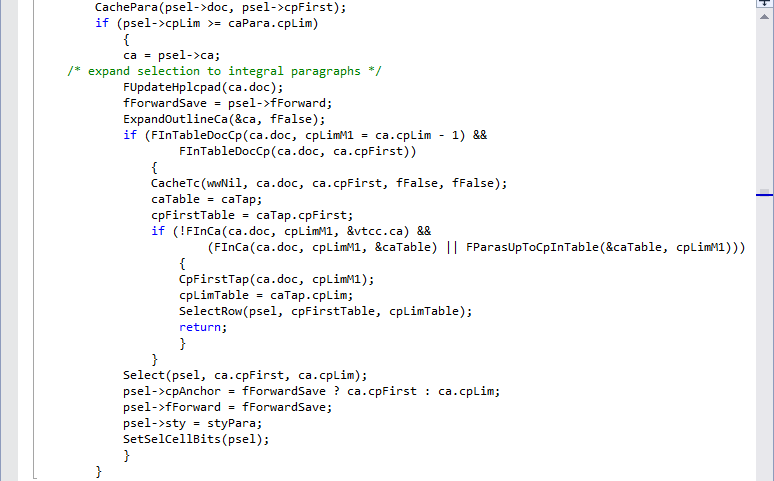
Diese Codeausschnitte ähneln sich stark, und viele C++-Projekte wurden damals ähnlich wie C-Projekte umgesetzt. Zu dieser Zeit gab es noch keine ausgereiften Bibliotheken, die die Implementierung von Algorithmen erleichterten; alle benötigten Hilfsfunktionen mussten intern von Grund auf entwickelt werden.
Zwischen 1990 und 1995
Bei der Suche nach Quellcode aus diesem Zeitraum zeigt sich, dass viele Implementierungen dem oben genannten Beispiel ähneln. C dominierte weiterhin die Implementierung von Algorithmen, obwohl wichtige Änderungen an C++ neue Möglichkeiten eröffnet hatten. 1989 erschien C++ 2.0, gefolgt von der überarbeiteten zweiten Auflage von The C++ Programming Language im Jahr 1991. Zu den neuen Funktionen von 2.0 gehörten Mehrfachvererbung, abstrakte Klassen, statische Memberfunktionen, const-Memberfunktionen und geschützte Member. 1990 wurde The Annotated C++ Reference Manual veröffentlicht. Dieses Werk bildete die Grundlage für den späteren Standard. Später kamen unter anderem templates, Exceptions, Namespaces, neue Casts und ein boolescher Typ hinzu.
Obwohl Templates 1991 eingeführt wurden, interessierte sich zunächst nur eine kleine Zahl von C++-Experten für das Paradigma der generischen Programmierung, und nur wenige Publikationen beschäftigten sich damit.
Alexander Stepanov war ein wegweisender C++-Experte, der die Möglichkeiten generischer Programmierung erforschte, um einen modernen Ansatz für die Entwicklung von C++-Projekten zu schaffen.
Hier ist ein interessantes document Dokument mit dem Titel „Algorithm-Oriented Generic Libraries“, das 1993 von Alexander A. Stepanov und David R. Summer veröffentlicht wurde.
Hier ist die von den Autoren beschriebene Motivation:
We outline an approach to construction of software libraries in which generic algorithms (algorithmic abstractions) play a more central role than in conventional software library technology or in the object-oriented programming paradigm. Our approach is to consider algorithms first, decide what types and access operations they need for efficient execution, and regard the types and operations as formal parameters that can be instantiated in many different ways, as long as the actual parameters satisfy the assumptions on which the correctness and efficiency of the algorithms are based. The means by which instantiation is carried out is language dependent; in the C + + examples in this paper, we instantiate generic algorithms by constructing classes that define the needed types and access operations. By use of such compile-time techniques and careful attention to algorithmic issues, it is possible to construct software components of broad utility with no sacrifice of efficiency.Von 1991 bis 1994 war bereits eine von einigen C++-Pionieren getragene Bewegung im Gange, aus der schließlich eine effiziente C++-Bibliothek für die Implementierung von Algorithmen hervorging: die Standard Template Library.
Zwischen 1995 und 2000
Dank der Anstrengungen und bemerkenswerten Arbeit von Alexander Stepanov, David Musser, Meng Lee und dem C++-Standardisierungskomitee erschien 1994 die erste Version der STL.
The Standard Template Library (STL) ist eine Softwarebibliothek für die Programmiersprache C++, die viele Teile der C++-Standardbibliothek beeinflusst hat. Sie stellt vier Komponenten bereit, die alsalgorithms, containers, functions, and iterators.
Die STL stellt eine Reihe gängiger Klassen für C++ bereit, darunter Container und assoziative Arrays. Sie können mit jedem eingebauten Typ sowie mit benutzerdefinierten Typen verwendet werden, die einige grundlegende Operationen wie Kopieren und Zuweisen unterstützen. STL-Algorithmen sind unabhängig von den Containern, was die Komplexität der Bibliothek deutlich reduziert.
Ab 1995 nutzten viele Algorithmusimplementierungen die Funktionen der STL-Bibliothek. Viele sahen ähnlich aus wie dieses 1997 veröffentlichte Beispiel.
template <class RandomAccessIterator, class T, class Distance>
void __introsort_loop(RandomAccessIterator first,
RandomAccessIterator last, T*,
Distance depth_limit) {
     while (last - first > __stl_threshold) {
        if (depth_limit == 0) {
            partial_sort(first, last, last);
            return;
         }
     --depth_limit;
     RandomAccessIterator cut = __unguarded_partition
     (first, last, T(__median(*first, *(first + (last - first)/2),
     *(last - 1))));
     __introsort_loop(cut, last, value_type(first), depth_limit);
     last = cut;
    }
}
Die STL war für C++-Entwickler ein echter Befreiungsschlag. Sie bot viele nützliche Möglichkeiten zur Modernisierung von C++-Code und sorgte dafür, dass sich Implementierungen von C++-Algorithmen zunehmend von ihren C-Pendants unterschieden.
Zwischen 2000 und 2010
1998 wurde ein Vorschlag für eine Website als Repository für C++-Bibliotheken von Beman G. Dawes veröffentlicht. Die ursprüngliche Vision verfolgte zwei Hauptziele:
- Eine weltweit zugängliche Website mit einem Repository kostenloser C++-Klassenbibliotheken wäre für die C++-Community von großem Nutzen. Zwar bieten andere Websites bestimmte Bibliotheken oder Links zu Bibliotheken an, doch gibt es derzeit keine weithin bekannte Website, die als allgemeines Repository für C++-Bibliotheken dient. Die Vision lautet: eine Website, auf der Programmierer benötigte Bibliotheken finden, eigene Bibliotheken zum Teilen veröffentlichen und die zugleich als zentraler Anlaufpunkt dient, um die innovative Entwicklung von C++-Bibliotheken zu fördern. Ein online peer review process is envisioned to ensure library quality with a minimum of bureaucracy.
- Zu den weiteren Zielen gehören die Förderung effektiver Programmiertechniken und die Schaffung eines zentralen Anlaufpunkts, über den C++-Programmierer an einer größeren Community teilnehmen können. Darüber hinaus könnte eine solche Website die C++-Standardisierung unterstützen, indem sie dabei hilft, etablierte Praxis sichtbar zu machen.
Boost ist eine Sammlung von Bibliotheken für die Programmiersprache C++, die Aufgaben und Datenstrukturen wie lineare Algebra, Pseudozufallszahlengenerierung, Multithreading, Bildverarbeitung, reguläre Ausdrücke und Unit-Tests unterstützt. Sie umfasst mehr als achtzig einzelne Bibliotheken.
Boost stellte beispielsweise die Foreach -Funktionalität bereit, die von vielen Algorithmen zum Iterieren über Container verwendet wurde.
std::deque<int> deque_int( /*...*/ );
int i = 0;
BOOST_FOREACH( i, deque_int )
{
    if( i == 0 ) return;
    if( i == 1 ) continue;
    if( i == 2 ) break;
}
Boost stellte außerdem verbreitete Hilfsfunktionen bereit, die die Implementierung von Algorithmen vereinfachten, etwa die join-Funktion:
#include <boost/algorithm/string/join.hpp>
#include <vector>
#include <iostream>

int main()
{
    std::vector<std::string> list;
    list.push_back("Hello");
    list.push_back("World!");

    std::string joined = boost::algorithm::join(list, ", ");
    std::cout << joined << std::endl;
}
2010 bis heute
Viele Jahre lang kamen die Werkzeuge für die Entwicklung effizienter Algorithmen vor allem aus Bibliotheken wie STL und Boost. Nach dem Update auf 2.0 entwickelte sich C++ bis 2011 vergleichsweise langsam; die Sprache stagnierte lange, und viele Entwickler waren überzeugt, sie werde dasselbe Schicksal wie Cobol, Fortran oder VB6 erleiden. Doch entgegen diesen Erwartungen erhob sich C++ wieder aus der Asche, und die neuen Standards verändern die Nutzung der Sprache grundlegend.
Der Algorithms librarywurden viele interessante Hilfsfunktionen hinzugefügt, und Algorithmusimplementierungen sehen heute beispielsweise so aus:
template<class FwdIt, class Compare = std::less<>>
void quick_sort(FwdIt first, FwdIt last, Compare cmp = Compare{})
{
    auto const N = std::distance(first, last);
    if (N <= 1) return;
    auto const pivot = *std::next(first, N / 2);
    auto const middle1 = std::partition(first, last, [=](auto const& elem){
        return cmp(elem, pivot);
    });
    auto const middle2 = std::partition(middle1, last, [=](auto const& elem){
        return !cmp(pivot, elem);
    });
    quick_sort(first, middle1, cmp); // assert(std::is_sorted(first, middle1, cmp));
    quick_sort(middle2, last, cmp);  // assert(std::is_sorted(middle2, last, cmp));
}
Wie geht es weiter?
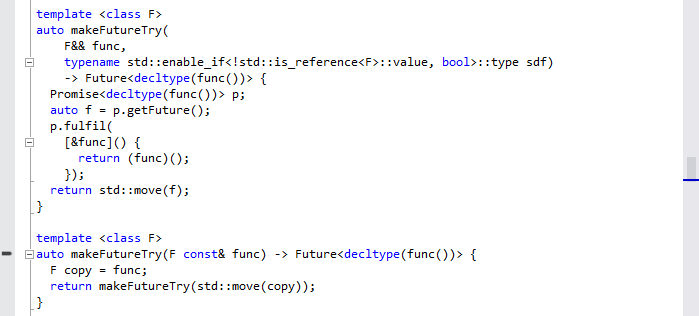
Von 1991 bis 2011 entwickelte sich die Sprache nur langsam; viele Fortschritte kamen aus Bibliotheken wie STL und Boost. Seit 2011 wurden dem Standard zahlreiche Funktionen hinzugefügt: C++11, C++14, C++17 und das damals bevorstehende C++20. Nun sind die Bibliotheken an der Reihe, effiziente Implementierungen auf Grundlage der neuen Standards bereitzustellen. Folly ist ein gutes Beispiel für eine moderne C++-Bibliothek. Hier ist die Motivation hinter ihrer Entstehung:
Folly (acronymed loosely after Facebook Open Source Library) is a library of C++11 components designed with practicality and efficiency in mind. It complements (as opposed to competing against) offerings such as Boost and of course std. In fact, we embark on defining our own component only when something we need is either not available, or does not meet the needed performance profile.Hier ist ein Codeausschnitt aus der Folly-Bibliothek.
Fazit
C++ ist eine bemerkenswerte Sprache, mit der sich viele Arten von Anwendungen entwickeln lassen. Glücklicherweise wurde sie von zahlreichen großen Unternehmen unterstützt und gefördert. Viele C++-Experten haben zur Weiterentwicklung und Pflege ihrer Bibliotheken beigetragen, und die neuen Standards eröffnen neue Möglichkeiten, C++-Codebasen mit effizienten Implementierungen zu modernisieren.
C++ wurde schon oft für tot erklärt, doch in Wirklichkeit erfindet sich die Sprache immer wieder neu. Lang lebe C++!