
Avant sa normalisation initiale en 1998, le C++ était développé par Bjarne Stroustrup aux Bell Labs depuis 1979, comme une extension du langage C, car il voulait un langage efficace et flexible similaire au C.
En 1983, « C with Classes » a été renommé « C++ », en ajoutant de nouvelles fonctionnalités dont les fonctions virtuelles, la surcharge des noms de fonctions et des opérateurs, les références, les constantes, l'allocation mémoire typée sur le tas (new/delete) et une vérification des types améliorée.
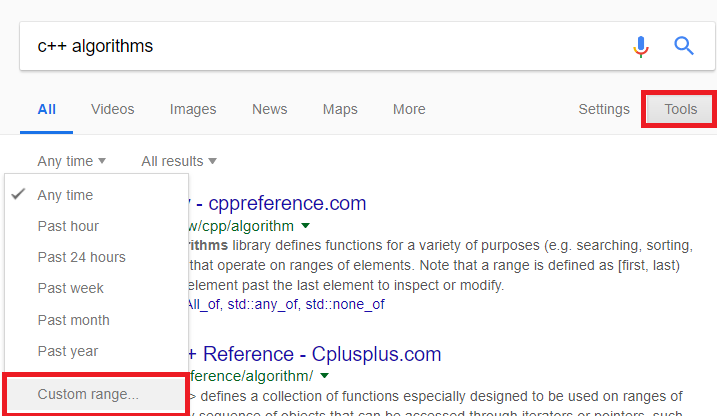
Comprendre comment un langage a évolué nous aide à comprendre les motivations derrière les choix faits au fil des ans. Dans cette optique, explorons comment les algorithmes C++ ont été écrits depuis les débuts du langage dans les années 1980 jusqu'à aujourd'hui. Une façon de faire ce voyage historique est de rechercher sur Google des mots-clés pertinents avec des plages de dates personnalisées.
Entre 1985 et 1990
Explorons le code C++ entre 1985 et 1990. Après avoir défini une plage de dates personnalisée, nous obtenons quelques résultats pour le mot-clé « C++ algorithm ». Par exemple, ce lien du Dr. Dobb's Journal, publié en 1990. Dr. Dobb's a été une force majeure de promotion du langage C++ pendant de nombreuses années — un merci spécial à tous les contributeurs qui ont fourni tant de ressources précieuses pour maîtriser le C++. Malheureusement, la publication a cessé fin 2014.
Voici un extrait du code.
WriteFraction(n) long n;
{
   unsigned short i, low, digit; unsigned long k;
   putchar(n < 0 ? '-' : ' '); n = abs(n);
   putchar((n>>fractionBits) + '0'); putchar('.');
   low = k = n << (longBits-fractionBits); /* align octal point at left */
   k >>= 4; /* shift to make room for a decimal digit */
   for (i=1; i<=8; ++i)
   {
      digit = (k *= 10L) >> (longBits-4);
      low = (low & 0xf) * 10;
      k += ((unsigned long) (low>>4)) - ((unsigned long) digit <<   (longBits-4));
      putchar(digit+'0');
   }
}
Comparons cet extrait de code avec le code source de « Microsoft Word 1.1 » publié à peu près à la même époque. Microsoft a récemment confié le code source de « Microsoft Word 1.1 » au Computer History Museum.
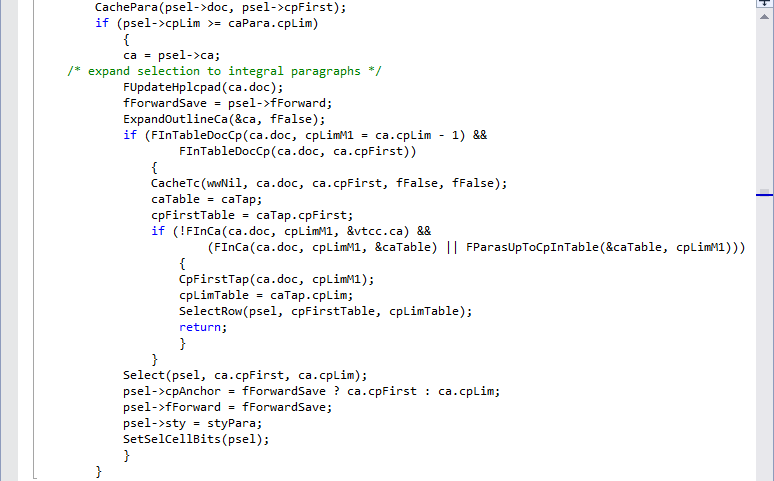
Ces extraits de code sont très similaires, et de nombreux projets C++ étaient implémentés à peu près de la même manière que les projets C. À l'époque, aucune bibliothèque mature n'existait pour faciliter l'implémentation des algorithmes, et tous les utilitaires nécessaires devaient être développés en interne, à partir de rien.
Entre 1990 et 1995
En recherchant du code source entre ces dates, on constate que de nombreuses implémentations ressemblent à l'exemple cité ci-dessus. Le C dominait encore les implémentations d'algorithmes, même si des changements majeurs du C++ avaient ouvert de nouvelles façons d'écrire des algorithmes. En effet, en 1989, C++ 2.0 est sorti, suivi de la deuxième édition mise à jour de The C++ Programming Language en 1991. Les nouvelles fonctionnalités de la 2.0 incluaient l'héritage multiple, les classes abstraites, les fonctions membres statiques, les fonctions membres const et les membres protégés. En 1990, The Annotated C++ Reference Manual a été publié. Cet ouvrage est devenu la base de la future norme. Les ajouts de fonctionnalités ultérieurs ont inclus les templates, les exceptions, les espaces de noms, les nouveaux casts et un type booléen.
Même si les templates ont été introduits en 1991, seul un petit nombre d'experts C++ s'intéressait au paradigme de la programmation générique, et peu de publications en parlaient.
Alexander Stepanov était un expert C++ pionnier qui a exploré les possibilités de la programmation générique pour offrir une approche moderne du développement de projets C++.
Voici un intéressant document intitulé « Algorithm-Oriented Generic Libraries » publié en 1993 par Alexander A. Stepanov et David R. Summer.
Voici la motivation décrite par les auteurs :
We outline an approach to construction of software libraries in which generic algorithms (algorithmic abstractions) play a more central role than in conventional software library technology or in the object-oriented programming paradigm. Our approach is to consider algorithms first, decide what types and access operations they need for efficient execution, and regard the types and operations as formal parameters that can be instantiated in many different ways, as long as the actual parameters satisfy the assumptions on which the correctness and efficiency of the algorithms are based. The means by which instantiation is carried out is language dependent; in the C + + examples in this paper, we instantiate generic algorithms by constructing classes that define the needed types and access operations. By use of such compile-time techniques and careful attention to algorithmic issues, it is possible to construct software components of broad utility with no sacrifice of efficiency.De 1991 à 1994, un mouvement mené par quelques pionniers du C++ était déjà en marche, aboutissant finalement à une bibliothèque C++ efficace pour coder des algorithmes : la Standard Template Library.
Entre 1995 et 2000
Grâce aux efforts et au travail remarquable d'Alexander Stepanov, David Musser, Meng Lee et du comité de normalisation C++, la première version de la STL est sortie en 1994.
La Standard Template Library (STL) est une bibliothèque logicielle pour le langage de programmation C++ qui a influencé de nombreuses parties de la bibliothèque standard C++. Elle fournit quatre composants appelés algorithmes, conteneurs, fonctions, et itérateurs.
La STL fournit un ensemble de classes communes pour C++, comme les conteneurs et les tableaux associatifs, utilisables avec n'importe quel type intégré et avec n'importe quel type défini par l'utilisateur prenant en charge certaines opérations élémentaires (comme la copie et l'affectation). Les algorithmes de la STL sont indépendants des conteneurs, ce qui réduit considérablement la complexité de la bibliothèque.
À partir de 1995, de nombreuses implémentations d'algorithmes ont commencé à utiliser les fonctionnalités de la bibliothèque STL, et beaucoup d'entre elles ressemblent à celle-ci, publiée en 1997.
template <class RandomAccessIterator, class T, class Distance>
void __introsort_loop(RandomAccessIterator first,
RandomAccessIterator last, T*,
Distance depth_limit) {
     while (last - first > __stl_threshold) {
        if (depth_limit == 0) {
            partial_sort(first, last, last);
            return;
         }
     --depth_limit;
     RandomAccessIterator cut = __unguarded_partition
     (first, last, T(__median(*first, *(first + (last - first)/2),
     *(last - 1))));
     __introsort_loop(cut, last, value_type(first), depth_limit);
     last = cut;
    }
}
La STL a été une bouffée d'air frais pour les développeurs C++. Elle a fourni de nombreuses fonctionnalités utiles pour moderniser le code C++ et a rendu les implémentations d'algorithmes C++ de plus en plus distinctes de leurs homologues C.
Entre 2000 et 2010
En 1998, une proposition d’un site web de dépôt de bibliothèques C++ a été publiée par Beman G. Dawes. La vision originale visait deux objectifs majeurs :
- Un site web mondial contenant un répertoire de bibliothèques de classes C++ gratuites serait d'un grand bénéfice pour la communauté C++. Bien que d'autres sites fournissent des bibliothèques spécifiques ou des liens vers des bibliothèques, il n'existe actuellement aucun site web bien connu faisant office de répertoire général de bibliothèques C++. La vision est la suivante : un site où les programmeurs peuvent trouver les bibliothèques dont ils ont besoin, publier celles qu'ils souhaitent partager, et qui peut servir de point focal pour encourager le développement innovant de bibliothèques C++. Un processus de revue par les pairs en ligne est envisagé pour garantir la qualité des bibliothèques avec un minimum de bureaucratie.
- Les objectifs secondaires incluent l'encouragement de techniques de programmation efficaces et la fourniture d'un point focal permettant aux programmeurs C++ de participer à une communauté plus large. De plus, un tel site pourrait favoriser l'activité de normalisation du C++ en aidant à établir les pratiques existantes.
Boost est un ensemble de bibliothèques pour le langage de programmation C++ qui prennent en charge des tâches et des structures de données telles que l'algèbre linéaire, la génération de nombres pseudo-aléatoires, le multithreading, le traitement d'images, les expressions régulières et les tests unitaires. Il contient plus de quatre-vingts bibliothèques individuelles.
Par exemple, Boost a fourni la fonctionnalité Foreach , largement utilisée par de nombreux algorithmes pour itérer sur les conteneurs.
std::deque<int> deque_int( /*...*/ );
int i = 0;
BOOST_FOREACH( i, deque_int )
{
    if( i == 0 ) return;
    if( i == 1 ) continue;
    if( i == 2 ) break;
}
Boost a aussi fourni des utilitaires courants qui simplifiaient les implémentations d'algorithmes, comme la fonction join :
#include <boost/algorithm/string/join.hpp>
#include <vector>
#include <iostream>

int main()
{
    std::vector<std::string> list;
    list.push_back("Hello");
    list.push_back("World!");

    std::string joined = boost::algorithm::join(list, ", ");
    std::cout << joined << std::endl;
}
De 2010 à aujourd'hui
Pendant de nombreuses années, les facilités pour développer des algorithmes efficaces venaient de bibliothèques comme la STL et Boost. En effet, après la mise à jour 2.0, le C++ a évolué relativement lentement jusqu'en 2011 ; le langage a stagné pendant de nombreuses années, et de nombreux développeurs étaient convaincus qu'il connaîtrait le même sort que Cobol, Fortran et VB6. Au contraire, et contre toute attente, le C++ est revenu de ses cendres, et les nouvelles normes changent considérablement la façon dont le langage est utilisé.
De nombreux utilitaires intéressants ont été ajoutés à la bibliothèque d'algorithmes, et les implémentations d'algorithmes ressemblent désormais à celle-ci :
template<class FwdIt, class Compare = std::less<>>
void quick_sort(FwdIt first, FwdIt last, Compare cmp = Compare{})
{
    auto const N = std::distance(first, last);
    if (N <= 1) return;
    auto const pivot = *std::next(first, N / 2);
    auto const middle1 = std::partition(first, last, [=](auto const& elem){
        return cmp(elem, pivot);
    });
    auto const middle2 = std::partition(middle1, last, [=](auto const& elem){
        return !cmp(pivot, elem);
    });
    quick_sort(first, middle1, cmp); // assert(std::is_sorted(first, middle1, cmp));
    quick_sort(middle2, last, cmp);  // assert(std::is_sorted(middle2, last, cmp));
}
Et maintenant ?
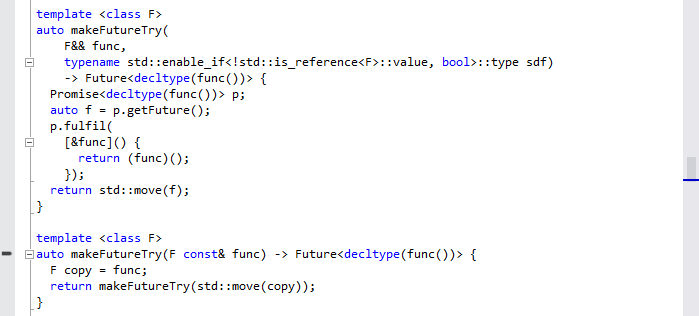
De 1991 à 2011, le langage a évolué lentement, et l'évolution venait de bibliothèques comme la STL et Boost. À partir de 2011, de nombreuses fonctionnalités ont été ajoutées à la norme : C++11, C++14, C++17 et le futur C++20. C'est maintenant au tour des bibliothèques de fournir des implémentations efficaces basées sur les nouvelles normes ; Folly est un bon exemple de bibliothèque C++ moderne. Voici la motivation derrière sa création :
Folly (acronymed loosely after Facebook Open Source Library) is a library of C++11 components designed with practicality and efficiency in mind. It complements (as opposed to competing against) offerings such as Boost and of course std. In fact, we embark on defining our own component only when something we need is either not available, or does not meet the needed performance profile.Voici un extrait de code de la bibliothèque folly.
Conclusion
Le C++ est un langage extraordinaire avec lequel on peut développer de nombreux types d'applications ; heureusement, il a été soutenu et promu par de nombreuses grandes entreprises. De nombreux experts C++ ont contribué à faire évoluer et à maintenir ses bibliothèques, et les nouvelles normes nous offrent de nouvelles façons et possibilités de moderniser les bases de code C++ avec des implémentations efficaces.
Le C++ a été déclaré mort de nombreuses fois, mais en réalité il renaît encore et encore. Longue vie au C++ !