
Jedes Projekt besitzt seinen eigenen Style Guide, also eine Sammlung von Konventionen dafür, wie Code in diesem Projekt geschrieben werden soll. Manche Verantwortliche setzen auf grundlegende Coding-Regeln, andere auf sehr weitreichende Vorgaben. In vielen Projekten existieren überhaupt keine Regeln – jeder Entwickler verwendet seinen eigenen Stil.
Eine große Codebasis lässt sich wesentlich leichter verstehen, wenn der gesamte Quellcode einem einheitlichen Stil folgt.
Viele Quellen beschäftigen sich mit der Frage, welche Coding-Regeln sinnvoll sind. Gute Programmierpraktiken können wir beispielsweise lernen durch:
- Das Lesen eines Buchs oder einer Fachzeitschrift.
- Websites.
- Von Kollegen.
- Die Teilnahme an einer Schulung.
Ein weiterer und besonders interessanter Ansatz besteht darin, ein bekanntes, ausgereiftes Open-Source-Projekt zu untersuchen und zu sehen, wie dessen Entwickler Code schreiben. In der C-Welt ist der Linux-Kernel ein guter Kandidat.
Für Einsteiger und selbst für fortgeschrittene C-Entwickler ist der Einstieg in den Linux-Kernel nicht unbedingt einfach. Das Ziel muss jedoch nicht sein, aktiv zum Quellcode beizutragen, sondern zunächst zu untersuchen, wie er implementiert ist.
Nehmen wir als Beispiel die Implementierung einer Funktion aus dem Linux-Quellcode.
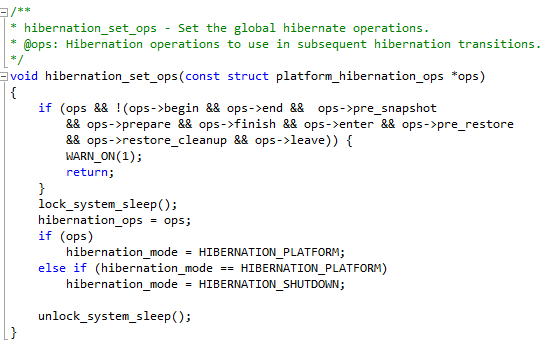
Der Code wirkt sehr sauber. Die Funktion:
- besteht nur aus wenigen Codezeilen.
- besitzt eine klar definierte Signatur.
- ist gut kommentiert.
- ist sauber eingerückt.
- verwendet sehr verständliche Variablennamen.
Ein anderer Entwickler könnte dieselbe Funktion beispielsweise so implementieren:
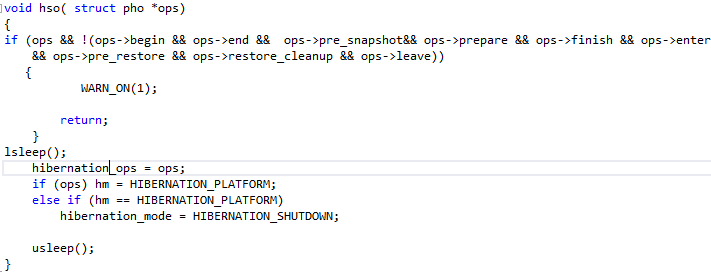
Der Coding-Stil hat großen Einfluss auf die Lesbarkeit des Quellcodes. Einige Stunden Schulung für Entwickler und regelmäßige Code Reviews können die Wartbarkeit und Weiterentwicklung des Codes deutlich verbessern.
Untersuchen wir nun den Quellcode des Linux-Kernels mit CppDepend und entdecken wir einige grundlegende Coding-Regeln, die seine Entwickler anwenden.
Modularität
Modularität ist eine Entwurfstechnik, bei der Software stärker in voneinander getrennte Teile gegliedert wird. Modularer Code lässt sich dadurch leichter verwalten und warten.
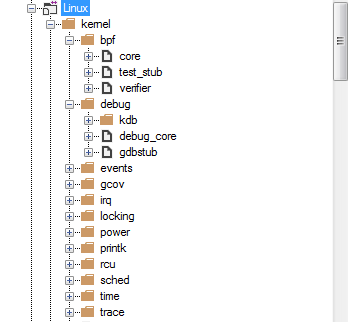
In einer prozeduralen Sprache wie C, die keine logischen Konstrukte wie Namespaces, Komponenten oder Klassen besitzt, lässt sich Modularität mithilfe von Verzeichnissen und Dateien erreichen.
Mögliche Ansätze sind:
- Alle Quelldateien in einem einzigen Verzeichnis ablegen.
- Dateien eines Moduls oder Untermoduls in einem eigenen Verzeichnis zusammenfassen.
Beim Linux-Kernel werden Verzeichnisse und Unterverzeichnisse verwendet, um den Kernel-Quellcode zu modularisieren.
Kapselung
Kapselung bedeutet, Funktionen und Daten zu verbergen, die nur intern für eine Implementierung benötigt werden. In C erfolgt dies mithilfe des Schlüsselworts static. Solche Elemente werden als Funktionen und Variablen mit Datei-Sichtbarkeit bezeichnet.
Suchen wir mit der folgenden CQLinq-Abfrage nach allen statischen Funktionen.

Mit der Metric View erhalten wir einen guten Überblick darüber, wie viele Funktionen betroffen sind. Dort wird die Codebasis als Treemap dargestellt. Treemapping visualisiert hierarchische Daten mithilfe verschachtelter Rechtecke. Die von CppDepend verwendete Baumstruktur entspricht der üblichen Codehierarchie:
- Projekte enthalten Verzeichnisse.
- Verzeichnisse enthalten Dateien.
- Dateien enthalten Structs, Funktionen und Variablen.
Die Treemap eignet sich sehr gut zur Darstellung der Ergebnisse einer CQLinq-Abfrage, da die betroffenen Codeelemente unmittelbar visuell erkennbar werden.
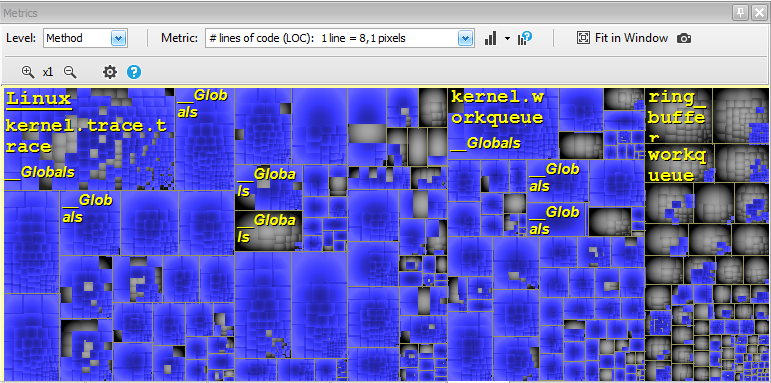
Wie zu erkennen ist, sind viele Funktionen als static deklariert.
Suchen wir nun nach statischen Feldern:
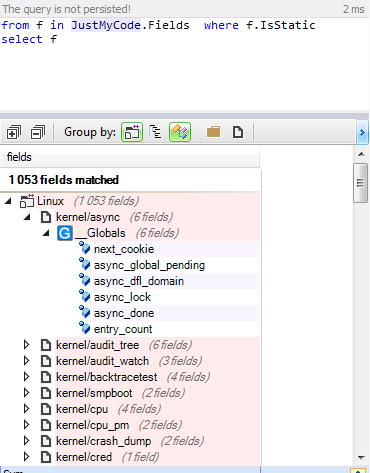
Dasselbe gilt für Variablen: Viele sind als static deklariert.
Im Quellcode des Linux-Kernels wird Kapselung immer dann eingesetzt, wenn Funktionen und Variablen auf die jeweilige Datei beschränkt bleiben sollen.
Structs für das Datenmodell verwenden
In C verwenden Funktionen Variablen für ihre Verarbeitung. Dabei kann es sich handeln um:
- Statische Variablen.
- Globale Variablen.
- Lokale Variablen
- Variablen aus Structs.
Jedes Projekt besitzt ein Datenmodell, das von vielen Quelldateien genutzt werden kann. Globale Variablen wären zwar eine mögliche Lösung, sind aber keine gute Wahl. Daten in Structs zu gruppieren ist vorzuziehen.
Suchen wir nach globalen Variablen mit einem primitiven Typ:
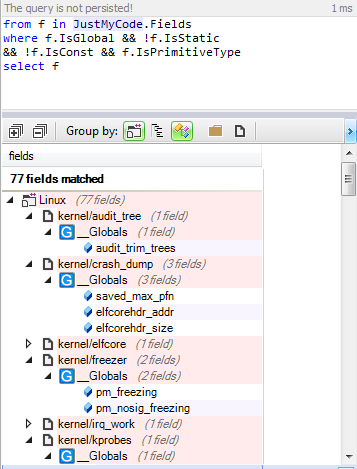
Es sind nur wenige Variablen betroffen. Einige davon könnten möglicherweise in Structs zusammengefasst werden, etwa (elfcorehdr_addr und elfcorehdr_size) oder (pm_freezing und pm_nosig_freezing).
Funktionen kurz und übersichtlich halten
Hier ein Hinweis von der Webseite zum Linux-Coding-Style, zur empfohlenen Länge von Funktionen:
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.
Suchen wir nach Funktionen mit mehr als 30 Codezeilen.
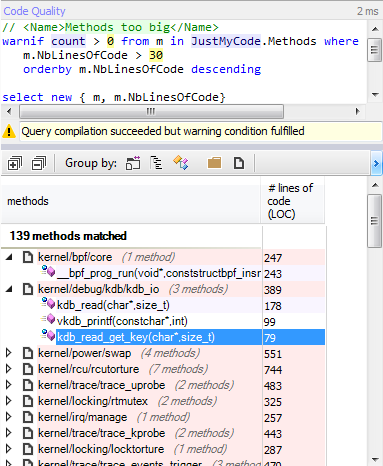
Nur wenige Funktionen umfassen mehr als 30 Codezeilen.
Anzahl der Funktionsparameter
Funktionen mit NbParameters > 8 können umständlich aufzurufen sein und möglicherweise die Performance beeinträchtigen. Eine Alternative besteht darin, eine eigene Struktur für die Übergabe der Argumente zu verwenden.
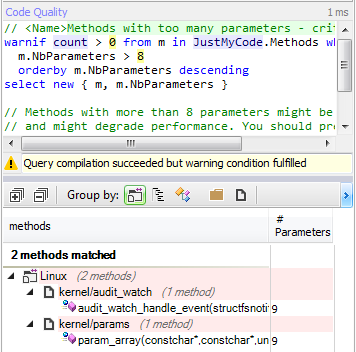
Nur zwei Funktionen besitzen mehr als acht Parameter.
Number of local variables
Funktionen mit NbVariables > 8 sind schwerer zu verstehen und zu warten. Bei NbVariables > 15 sind sie extrem komplex und sollten in kleinere Funktionen zerlegt werden – außer wenn der Code automatisch von einem Tool generiert wurde.
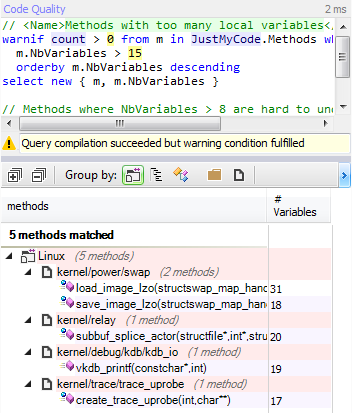
Nur fünf Funktionen besitzen mehr als 15 lokale Variablen.
Komplexe Funktionen vermeiden
Zur Erkennung komplexer Funktionen existieren zahlreiche Metriken. NBLinesOfCode, die Anzahl der Parameter und die Anzahl lokaler Variablen gehören zu den grundlegenden Kennzahlen.
Weitere interessante Metriken zur Erkennung komplexer Funktionen sind:
- Die zyklomatische Komplexität ist eine verbreitete prozedurale Softwaremetrik, die die Anzahl der Entscheidungspfade innerhalb einer Prozedur misst.
- Nesting Depth gibt bei Funktionen die maximale Tiefe verschachtelter Gültigkeitsbereiche innerhalb des Funktionskörpers an.
- Max Nested Loops entspricht der maximalen Verschachtelungstiefe von Schleifen innerhalb einer Funktion.
Welche Maximalwerte für diese Metriken akzeptabel sind, hängt von den Entscheidungen des Teams ab; universelle Grenzwerte gibt es nicht.
Suchen wir nach Funktionen, die Kandidaten für ein Refactoring sind:
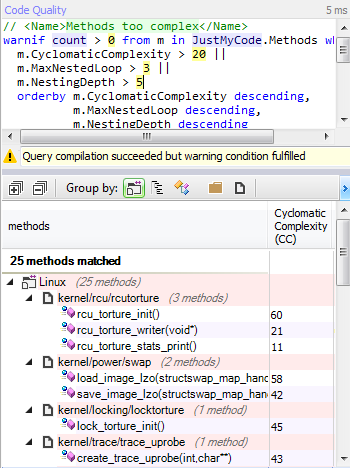
Nur sehr wenige Funktionen können als komplex eingestuft werden.
Namenskonventionen
Für Namenskonventionen gibt es keinen universellen Standard; jedes Projekt kann die für sich passende Variante wählen. Entscheidend ist jedoch, die gewählte Konvention konsequent einzuhalten.
Beim Linux-Kernel müssen Struct-Namen beispielsweise mit einem Kleinbuchstaben beginnen. Wir können überprüfen, ob dies im gesamten Kernel-Quellcode eingehalten wird. Führen wir dazu die folgende Abfrage aus:
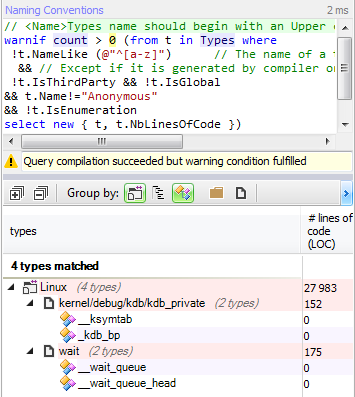
Nur vier Structs beginnen mit „_“ statt mit einem Kleinbuchstaben.
Einrückung
Einrückungen sind sehr hilfreich, um Code besser lesbar zu machen. Hier die Begründung von der Webseite zum Linux-Coding-Style, warum Einrückungen wichtig sind:
Rationale: The whole idea behind indentation is to clearly define where
a block of control starts and ends.  Especially when you've been looking
at your screen for 20 straight hours, you'll find it a lot easier to see
how the indentation works if you have large indentations.

Now, some people will claim that having 8-character indentations makes
the code move too far to the right, and makes it hard to read on a
80-character terminal screen.  The answer to that is that if you need
more than 3 levels of indentation, you're screwed anyway, and should fix
your program.
Fazit
Bekannte Open-Source-Projekte zu untersuchen ist immer eine gute Möglichkeit, die eigenen Programmierkenntnisse zu verbessern. Dafür muss man das Projekt nicht einmal herunterladen und bauen – der Code lässt sich beispielsweise direkt auf GitHub erkunden.