
Chaque projet a son propre guide de style : un ensemble de conventions sur la façon d'écrire le code pour ce projet. Certains responsables choisissent des règles de codage basiques, d'autres préfèrent des règles très avancées. Dans de nombreux projets, il n'y a aucune règle de codage — chaque développeur utilise son propre style.
Il est beaucoup plus facile de comprendre une grande base de code lorsque tout le code source suit un style cohérent.
De nombreuses ressources abordent les meilleures règles de codage à adopter. On peut apprendre les bonnes pratiques de codage en :
- Lisant un livre ou un magazine.
- Consultant des sites web.
- Échangeant avec un collègue.
- Suivant une formation.
Une autre approche, plus intéressante, consiste à étudier un projet open source connu et mature pour voir comment ses développeurs écrivent le code. Dans le monde du « C », le noyau Linux pourrait être un bon candidat.
Pour les développeurs C débutants, voire intermédiaires, le noyau Linux n'est pas forcément facile à aborder. Cependant, l'objectif n'est pas nécessairement de contribuer à son code source, mais plutôt d'explorer la façon dont il est implémenté.
Prenons l'implémentation d'une fonction du code source de Linux comme exemple.
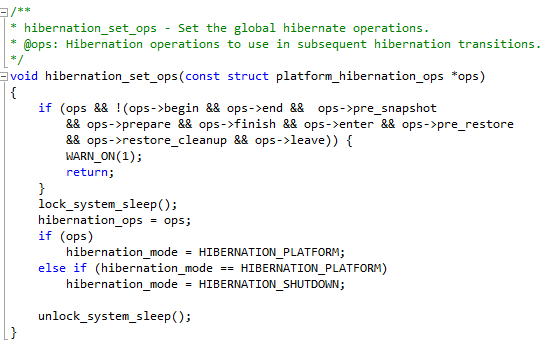
Le code semble très propre ; en effet, la fonction :
- Ne compte que quelques lignes de code.
- Sa signature est bien définie.
- Elle est bien commentée.
- Elle est bien indentée.
- Les noms des variables sont très clairs.
La même fonction pourrait être implémentée par un autre développeur comme ceci :
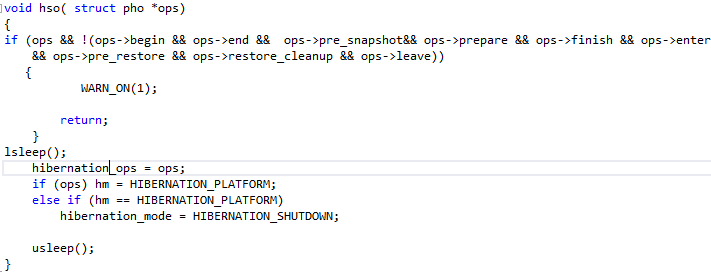
Le style de codage a un impact majeur sur la lisibilité du code source. Investir quelques heures dans la formation des développeurs et mener des revues de code périodiques aide à rendre le code plus facile à maintenir et à faire évoluer.
Entrons dans le code source du noyau Linux à l'aide de CppDepend et découvrons quelques règles de codage de base adoptées par ses développeurs.
Modularité
La modularité est une technique de conception logicielle qui augmente la mesure dans laquelle un logiciel est composé de parties distinctes, ce qui rend le code modulaire plus facile à gérer et à maintenir.
Pour un langage procédural comme le C, où les constructions logiques telles que les espaces de noms, les composants ou les classes n'existent pas, nous pouvons obtenir la modularité en utilisant des répertoires et des fichiers.
Voici quelques scénarios possibles :
- Placez tous les fichiers sources dans un seul répertoire.
- Isoler les fichiers liés à un module ou à un sous-module dans un répertoire spécifique.
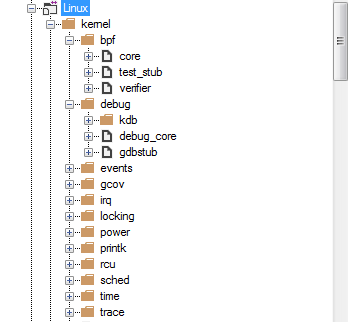
Dans le cas du noyau Linux, les répertoires et sous-répertoires sont utilisés pour modulariser le code source du noyau.
Encapsulation
L'encapsulation consiste à masquer les fonctions et les données internes à une implémentation. En C, l'encapsulation s'effectue à l'aide du mot-clé static. Ces entités sont appelées fonctions et variables à portée de fichier.
Cherchons toutes les fonctions statiques en exécutant la requête CQLinq suivante.

Nous pouvons utiliser la vue métriques pour avoir une bonne idée du nombre de fonctions concernées. Dans la vue métriques, la base de code est représentée à l'aide d'une treemap. Le treemapping est une méthode d'affichage de données structurées en arbre au moyen de rectangles imbriqués. La structure arborescente utilisée dans une treemap CppDepend est la hiérarchie habituelle du code :
- Les projets contiennent des répertoires.
- Les répertoires contiennent des fichiers.
- Les fichiers contiennent des structs, des fonctions et des variables.
La vue treemap offre un moyen pratique de représenter les résultats d'une requête CQLinq, en nous permettant de voir visuellement les éléments de code concernés.
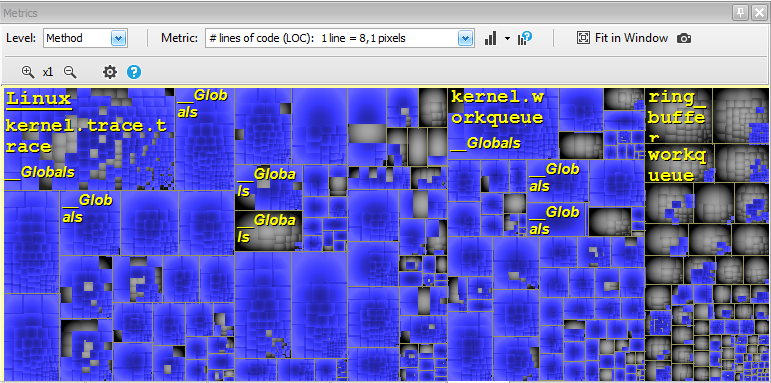
Comme on peut le constater, de nombreuses fonctions sont déclarées static.
Cherchons maintenant les champs statiques :
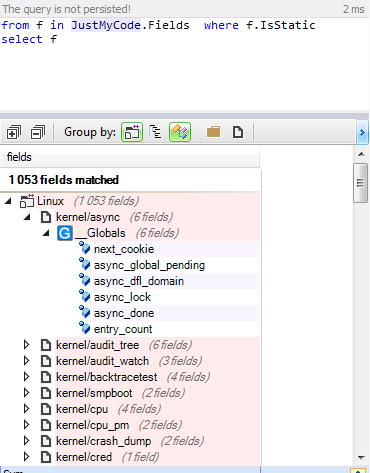
La même observation vaut pour les variables : beaucoup sont déclarées static.
Dans le code source du noyau Linux, l'encapsulation est utilisée chaque fois que des fonctions et des variables doivent rester privées à la portée du fichier.
Utilisez des structs pour stocker votre modèle de données
En programmation C, les fonctions utilisent des variables pour effectuer leurs traitements ; ces variables peuvent être :
- Des variables statiques.
- Des variables globales.
- Des variables locales.
- Des variables issues de structs.
Chaque projet possède son modèle de données, qui peut être utilisé par de nombreux fichiers sources. Utiliser des variables globales est une solution, mais pas une bonne ; regrouper les données dans des structs est préférable.
Cherchons les variables globales de type primitif :
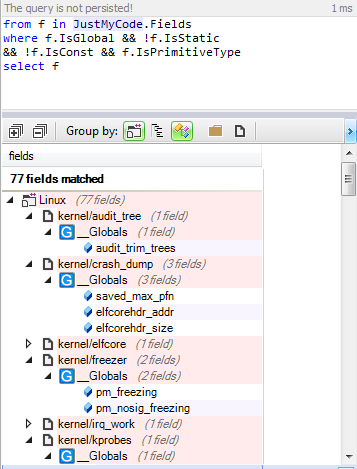
Seules quelques variables sont concernées, et certaines pourraient peut-être être regroupées dans des structs, comme (elfcorehdr_addr et elfcorehdr_size) ou (pm_freezing et pm_nosig_freezing).
Gardez des fonctions courtes et efficaces
Voici, tiré de la page sur le style de codage du noyau Linux, un conseil sur la longueur des fonctions :
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.
Cherchons les fonctions dont le nombre de lignes de code dépasse 30.
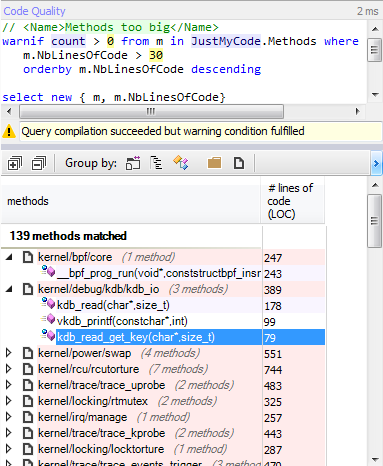
Seules quelques fonctions comptent plus de 30 lignes de code.
Le nombre de paramètres des fonctions
Les fonctions où NbParameters > 8 peuvent être pénibles à appeler et dégrader les performances. Une alternative consiste à fournir une structure dédiée au passage des arguments.
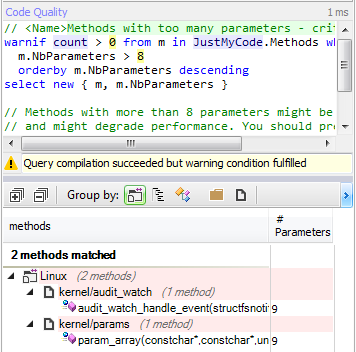
Seules deux fonctions ont plus de huit paramètres.
Le nombre de variables locales
Les fonctions où NbVariables est supérieur à 8 sont difficiles à comprendre et à maintenir. Les fonctions où NbVariables dépasse 15 sont extrêmement complexes et devraient être scindées en fonctions plus petites (sauf si elles sont générées automatiquement par un outil).
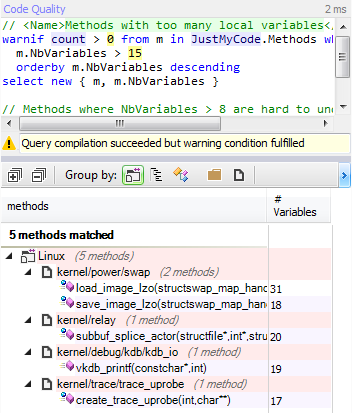
Seules 5 fonctions ont plus de 15 variables locales.
Évitez de définir des fonctions complexes
De nombreuses métriques permettent de détecter les fonctions complexes ; NBLinesOfCode, le nombre de paramètres et le nombre de variables locales sont les plus basiques.
Il existe d’autres métriques intéressantes pour détecter les fonctions complexes :
- La complexité cyclomatique est une métrique logicielle procédurale populaire qui mesure le nombre de chemins de décision dans une procédure.
- La profondeur d'imbrication (Nesting Depth) est une métrique définie pour les fonctions qui représente la profondeur maximale des portées imbriquées dans le corps d'une fonction.
- Max Nested Loops est égal au niveau maximal d’imbrication des boucles dans une fonction.
Les valeurs maximales acceptables pour ces métriques dépendent des choix de l'équipe ; il n'existe pas de normes universelles.
Cherchons les fonctions candidates à la refactorisation :
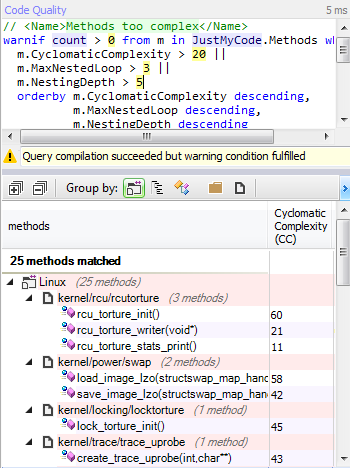
Très peu de fonctions peuvent être considérées comme complexes.
Les conventions de nommage
Il n'existe pas de norme universelle pour les conventions de nommage ; chaque projet peut choisir ce qui lui convient le mieux. Cependant, il est très important de suivre la convention choisie de manière cohérente.
Par exemple, dans le cas de Linux, les structs doivent commencer par une lettre minuscule, et nous pouvons vérifier si c'est vrai pour l'ensemble du code source du noyau. Exécutons la requête suivante :
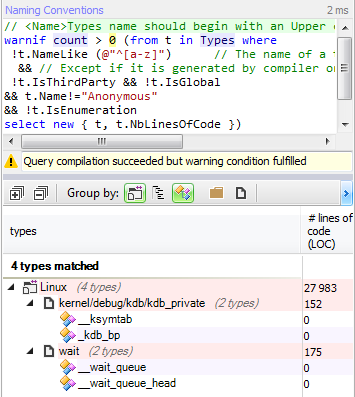
Seules 4 structs commencent par « _ » au lieu d'une lettre minuscule.
L'indentation
L'indentation est très utile pour rendre le code facile à lire. Voici, tirée de la page sur le style de codage du noyau Linux, la motivation derrière l'indentation :
Rationale: The whole idea behind indentation is to clearly define where
a block of control starts and ends.  Especially when you've been looking
at your screen for 20 straight hours, you'll find it a lot easier to see
how the indentation works if you have large indentations.

Now, some people will claim that having 8-character indentations makes
the code move too far to the right, and makes it hard to read on a
80-character terminal screen.  The answer to that is that if you need
more than 3 levels of indentation, you're screwed anyway, and should fix
your program.
Conclusion
Explorer des projets open source bien connus est toujours un bon moyen d'améliorer ses compétences en programmation. Pas besoin de télécharger et de compiler le projet — vous pouvez simplement découvrir le code sur GitHub, par exemple.