Der Task Scheduler plant und koordiniert Aufgaben zur Laufzeit. Eine Aufgabe ist eine Arbeitseinheit, die eine bestimmte Tätigkeit ausführt. Der Task Scheduler kümmert sich um die Details, die für eine effiziente Planung von Aufgaben auf Computern mit mehreren Rechenressourcen erforderlich sind.
Windows stellt einen präemptiven Kernel-Mode-Scheduler bereit: einen prioritätsbasierten Round-Robin-Mechanismus, der jeder Aufgabe für einen bestimmten Zeitraum exklusiven Zugriff auf eine Rechenressource gewährt und anschließend zu einer anderen Aufgabe wechselt. Dieser Mechanismus sorgt zwar für Fairness – jeder Thread macht Fortschritte –, verursacht jedoch Effizienzkosten. Viele rechenintensive Algorithmen benötigen beispielsweise keine Fairness; wichtiger ist vielmehr, dass zusammengehörige Aufgaben in möglichst kurzer Gesamtzeit abgeschlossen werden. Kooperatives Scheduling ermöglicht es einer Anwendung, Arbeit effizienter einzuplanen.
Kooperatives Scheduling ist ein Mechanismus, der jeder Aufgabe exklusiven Zugriff auf eine Rechenressource gewährt, bis die Aufgabe beendet ist oder den Zugriff auf die Ressource freiwillig abgibt.
Der kooperative User-Mode-Scheduler ermöglicht es dem Anwendungscode, eigene Scheduling-Entscheidungen zu treffen. Da viele dieser Entscheidungen direkt von der Anwendung getroffen werden können, reduziert kooperatives Scheduling einen großen Teil des mit der Kernel-Mode-Synchronisierung verbundenen Overheads.
Die Concurrency Runtime kombiniert kooperatives Scheduling mit dem präemptiven Scheduler des Betriebssystems, um die verfügbaren Rechenressourcen bestmöglich auszulasten.
Aufbau des Schedulers
Die Concurrency Runtime stellt die Schnittstelle Scheduler bereit, über die sich ein spezifischer, an die Anforderungen einer Anwendung angepasster Scheduler implementieren lässt.
Sehen wir uns die Klassen an, die diese Schnittstelle implementieren. Dazu können wir die folgende CQL-Abfrage ausführen:
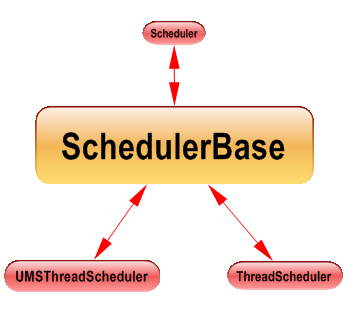
Die Concurrency Runtime stellt zwei Scheduler-Implementierungen bereit: ThreadScheduler und UMSThreadScheduler.
Wie der folgende Abhängigkeitsgraph zeigt, greift der Scheduler auf zahlreiche abstrakte Klassen zurück, um seine Aufgabe zu erfüllen:
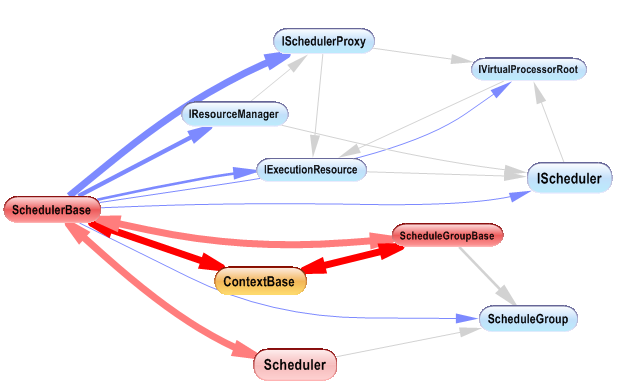
Betrachten wir die Rolle der einzelnen abstrakten Klassen, die vom Scheduler verwendet werden, und ihre jeweiligen Verantwortlichkeiten.
Dem Task Scheduler sind drei wesentliche Verantwortlichkeiten zugeordnet:
1. Ressourcen beschaffen (Prozessoren, Kerne, Speicher):
Beim Erstellen fordert der Scheduler Ressourcen vom Resource Manager der Runtime an, wie in diesem Artikel.
Der Scheduler kommuniziert mit dem Ressourcenmanager über die Schnittstellen IResourceManager, ISchedulerProxy und IScheduler. Beim Erstellen des Schedulers können wir dessen Richtlinie festlegen.
Die Enumeration Concurrency::PolicyElementKey definiert die Richtlinienschlüssel, die dem Task Scheduler zugeordnet sind.
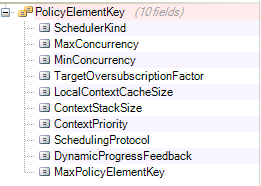
Hier ist ein Artikel der den Zweck jedes Richtlinienschlüssels sowie dessen jeweiligen Standardwert erläutert.
Der folgende Abhängigkeitsgraph zeigt, was beim Erstellen eines Schedulers geschieht:
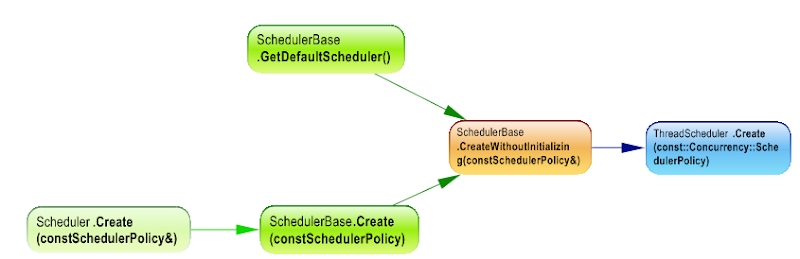
Die Concurrency Runtime erstellt einen Standard-Scheduler, wenn noch keiner vorhanden ist, indem sie die Methode GetDefaultScheduler aufruft; dabei wird eine Standardrichtlinie verwendet. Der Task Scheduler ermöglicht Anwendungen, eine oder mehrere Scheduler-Instanzen zum Planen von Aufgaben zu verwenden. Eine Anwendung kann Scheduler::Create aufrufen, um einen weiteren Scheduler mit einer bestimmten Richtlinie hinzuzufügen.
Die folgenden Interaktionen zwischen Scheduler und Resource Manager veranschaulichen die Rolle der einzelnen an der Ressourcenzuweisung beteiligten Schnittstellen.
- Ressourcenzuweisung anfordern:
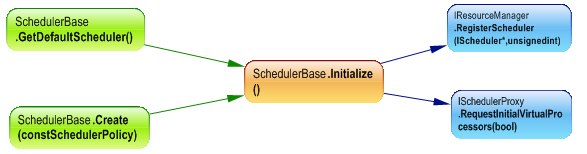
- Ressourcen vom Resource Manager erhalten:
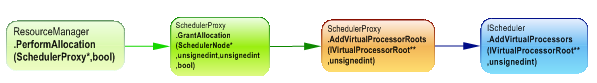
2. Aufgabenwarteschlangen verwalten:
Sobald der Scheduler erstellt wurde, können ihm Aufgaben zur Ausführung zugewiesen werden; er speichert diese Aufgaben in Warteschlangen. Um eine hohe Kohäsion der Klassen zu gewährleisten, werden die Warteschlangen nicht direkt von ThreadScheduler, sondern von der Klasse ScheduleGroupBase verwaltet.
Eine Schedule Group fasst zusammengehörige Aufgaben zusammen. Jeder Scheduler besitzt eine oder mehrere Schedule Groups. Sie sind sinnvoll, wenn zwischen Aufgaben ein hoher Grad an Lokalität erforderlich ist, beispielsweise wenn eine Gruppe zusammengehöriger Aufgaben davon profitiert, auf demselben Prozessorknoten ausgeführt zu werden.
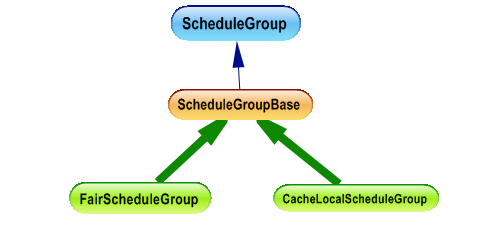
Wie der folgende Graph zeigt, stellt die Runtime zwei Arten von ScheduleGroup bereit: FairScheduleGroup und CacheLocalScheduleGroup. Die Wahl zwischen diesen beiden Gruppen beeinflusst – wie später erläutert – den Algorithmus, mit dem der Scheduler die nächste auszuführende Aufgabe auswählt.
Jeder Scheduler besitzt für jeden Scheduling-Knoten eine Standard-Schedule-Group. Die Runtime erstellt für jedes Prozessorpaket beziehungsweise jeden NUMA-Knoten (Non-Uniform Memory Architecture) einen Scheduling-Knoten. Wird eine Aufgabe nicht ausdrücklich einer Schedule Group zugeordnet, entscheidet der Scheduler, welcher Gruppe sie hinzugefügt wird.
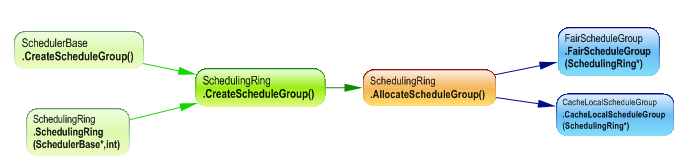
Wie der folgende Abhängigkeitsgraph zeigt, ist SchedulingRing für die Verwaltung der Schedule Groups verantwortlich: Er enthält eine Liste der Gruppen und erstellt sie.
Die Schedule Group enthält drei Arten von Warteschlangen:
1. FIFO-Warteschlange
Diese Warteschlange enthält leichtgewichtige Tasks. Ein leichtgewichtiger Task ähnelt der Funktion, die Sie der Windows-API-Funktion CreateThread übergeben. Solche Tasks sind daher nützlich, wenn vorhandener Code angepasst werden soll, um die Scheduling-Funktionen der Concurrency Runtime zu nutzen.
Ein Lightweight Task wird durch die Klasse RealizedChore repräsentiert; die FIFO-Warteschlange der Schedule Group wird durch das Feld m_realizedChores dargestellt.
Suchen wir nach Methoden, die direkt auf diese Warteschlange zugreifen:
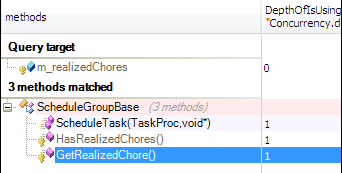
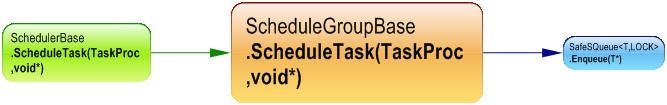
Ein Lightweight Task kann der Gruppe also durch Aufruf von ScheduleGroupBase::ScheduleTask oder Scheduler::ScheduleTask hinzugefügt werden.
Hier ist ein interessanter Artikel über Lightweight Tasks.
2. Work-Stealing-Warteschlange:
Einer Schedule Group ist nur eine FIFO-Warteschlange zugeordnet, sie referenziert jedoch eine Liste von Work-Stealing-Warteschlangen: Jeder Worker-Thread besitzt seine eigene lokale Warteschlange.
Ein an einen Scheduler gebundener Thread wird als Execution Context oder kurz Context bezeichnet. Diese lokale Warteschlange ist daher der Klasse Context zugeordnet.
Die Klasse Context stellt eine Programmierabstraktion für einen Ausführungskontext bereit und ermöglicht es, den aktuellen Kontext kooperativ zu blockieren, zu entsperren oder die Ausführung freiwillig abzugeben.
Um zu überprüfen, dass nur Context diese Art von Warteschlange erstellt, suchen wir nach den Methoden, die direkt auf das Feld m_workQueues zugreifen.
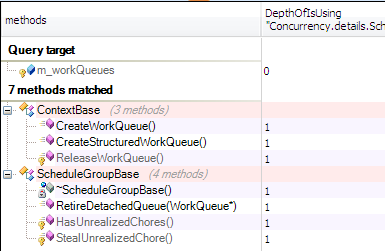
Der Context ist für das Erstellen dieser Warteschlange verantwortlich, und jedem Context ist eine lokale Work-Stealing-Warteschlange zugeordnet.
Um das Verhalten des Work-Stealing-Algorithmus zu veranschaulichen, nehmen wir an, dem Scheduler seien zwei Worker-Threads zugewiesen.
Wie oben erläutert, besitzt jeder Worker-Thread seine eigene lokale Warteschlange.
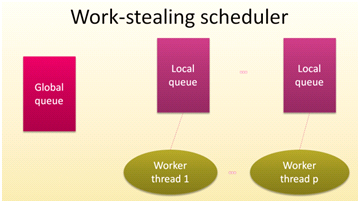
In der Warteschlange von Worker-Thread 1 befinden sich drei Aufgaben: Die Aufgaben 3 und 4 warten auf ihre Ausführung, während Aufgabe 5 ausgeführt wird.
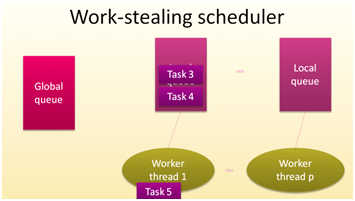
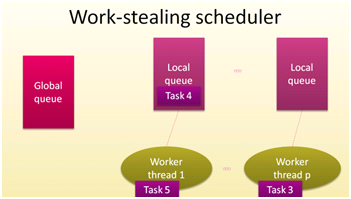
Die Dispatch-Methode stellt fest, dass die Warteschlange leer ist. Daher wird Aufgabe 3 aus ihrer ursprünglichen Warteschlange verschoben beziehungsweise „gestohlen“ und dem verfügbaren Worker-Thread zugewiesen.
Wie lässt sich eine Aufgabe erstellen, die von einer Work-Stealing-Warteschlange verwaltet wird? Dazu suchen wir nach Methoden, die CreateWorkQueue indirekt aufrufen.
Wie dieser Abhängigkeitsgraph zeigt, lässt sich eine solche Aufgabe mithilfe der Klasse task_group erstellen.
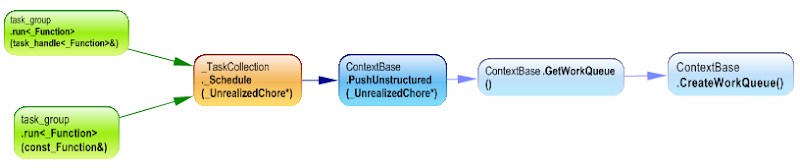
Das Hinzufügen einer neuen Aufgabe über task_group ist dem Erstellen eines Lightweight Tasks mit Scheduler::ScheduleTask vorzuziehen, da der Work-Stealing-Algorithmus die dem Scheduler zugewiesenen virtuellen Prozessoren besser ausnutzt.
Für die einfache Migration bestehenden Codes, der die CreateThread-API verwendet, kann ScheduleTask jedoch die bessere Wahl sein.
3. Warteschlange entsperrter Kontexte
The ContextDie Klasse ermöglicht es, den aktuellen Ausführungskontext zu blockieren oder die Ausführung freiwillig abzugeben. Das Blockieren oder Abgeben ist sinnvoll, wenn der aktuelle Kontext nicht fortfahren kann, weil eine Ressource nicht verfügbar ist. Die Methode Context::Block blockiert den aktuellen Kontext. Ein blockierter Kontext gibt seine Verarbeitungsressourcen frei, sodass die Runtime andere Aufgaben ausführen kann. Context::Unblock hebt die Blockierung eines Kontexts wieder auf.
Wenn ein Kontext entsperrt und wieder ausführbar ist, wird er der Warteschlange ausführbarer Kontexte hinzugefügt; diese Warteschlange wird durch das Feld m_runnableContexts repräsentiert.
Der folgende Abhängigkeitsgraph zeigt einige Fälle, in denen ein Kontext der Runnable-Warteschlange hinzugefügt wird:
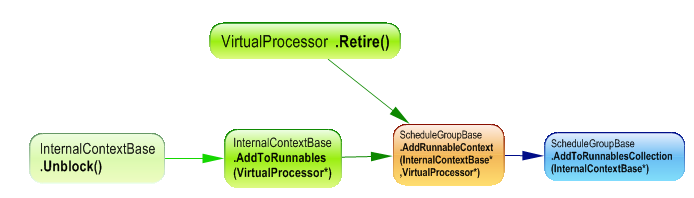
Der Kontext wird der Warteschlange also hinzugefügt, wenn er entsperrt wird oder wenn ein virtueller Prozessor aus dem Scheduler entfernt wird.
3. Aufgaben dispatchen:
Der Scheduler sucht nach auszuführender Arbeit. Dabei kann es sich handeln um:
- Einen entsperrten Kontext.
- Einen Lightweight Task.
- Eine Aufgabe in einer Work-Stealing-Warteschlange.
Wie oben erläutert, wird diese Arbeit in Warteschlangen gespeichert, die von Schedule Groups verwaltet werden; jede Gruppe wiederum wird von einem Scheduling Ring verwaltet.
Wenn dem Scheduler ein virtueller Prozessor zugewiesen wird, wird eine ThreadProxy-Klasse erstellt und diesem Prozessor zugeordnet. Nach der Erstellung wird die Dispatch-Methode des ThreadProxy aufgerufen. Wie im folgenden Abhängigkeitsgraphen dargestellt und bereits erläutert, verwendet die Concurrency Runtime abstrakte Klassen, um eine geringe Kopplung sicherzustellen. Welche konkrete Dispatch-Implementierung aufgerufen wird, hängt von der von der Runtime gewählten Implementierung ab; diese Auswahl wird durch die Scheduler-Richtlinie bestimmt.
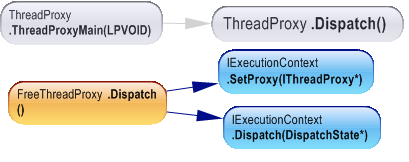
Die konkrete Implementierung von Dispatch ruft die Dispatch-Methode des Ausführungskontexts auf.
Der folgende Abhängigkeitsgraph zeigt die Methoden, die von einer konkreten Implementierung von Context::Dispatch aufgerufen werden:
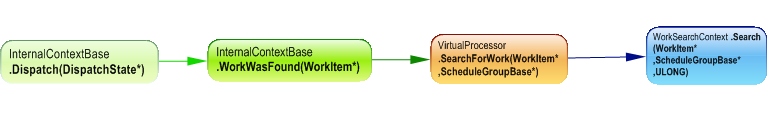
Der Algorithmus zum Ermitteln der nächsten auszuführenden Arbeit ist somit in der Klasse WorkSearchContext implementiert.
Sehen wir uns alle Klassen an, die WorkSearchContext direkt verwendet, um seine Aufgabe zu erfüllen:
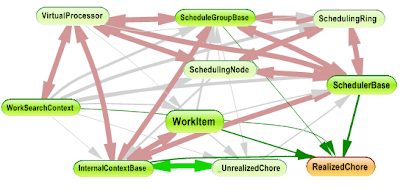
WorkSearchContext ist dafür verantwortlich, ein auszuführendes WorkItem bereitzustellen. Dabei kann es sich um InternalContextBase, RealizedChore oder _UnrealizedChore handeln.
Um das Zusammenspiel dieser Klassen besser zu verstehen, suchen wir nach den Methoden, die WorkSearchContext direkt verwendet:
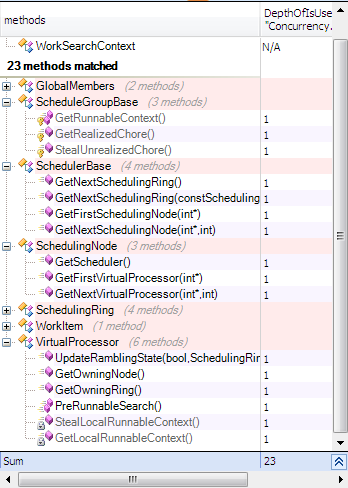
WorkSearchContext durchläuft also mithilfe von SchedulerBase-Methoden die Klassen SchedulingRing und ScheduleGroup.
Für jede ScheduleBase wird nach einem RunnableContext, RealizedChore oder UnrealizedChore gesucht.
Die Klasse WorkSearchContext wird von VirtualProcessor erstellt. Wie der folgende Abhängigkeitsgraph zeigt, wird der verwendete Algorithmus bei der Initialisierung von VirtualProcessor festgelegt. Dazu fragt VirtualProcessor beim Scheduler das SchedulingProtocol ab, das den vom Scheduler zu verwendenden Scheduling-Algorithmus beschreibt.
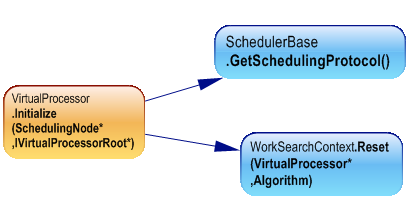
WorkSearchContext erhält den zu verwendenden Algorithmus über einen Wert aus der Enumeration Algorithm.
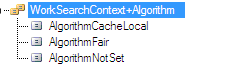
Diese Klasse implementiert daher zwei Algorithmen zum Auffinden von Arbeit:
- Cache-Local-Algorithmus:
Dieser Algorithmus sucht innerhalb der aktuellen Schedule Group zunächst nach ausführbaren Kontexten, anschließend nach Realized Chores und danach nach Unrealized Chores. Gibt es in der aktuellen Schedule Group keine weitere Arbeit, wird die nächste Gruppe im selben Scheduling Ring durchsucht. Sobald die Arbeit im aktuellen Scheduling Ring ausgeschöpft ist, wechselt der Algorithmus zum nächsten Ring.
Der Scheduler bevorzugt es somit, Aufgaben innerhalb der aktuellen Schedule Group weiter abzuarbeiten, bevor er zu einer anderen Schedule Group wechselt.
Dieser Algorithmus ist in WorkSearchContext::SearchCacheLocal implementiert. Wie der Abhängigkeitsgraph zeigt, ruft diese Methode weitere Methoden auf, um nach ausführbaren Kontexten, RealizedChore oder _UnrealizedChore zu suchen.
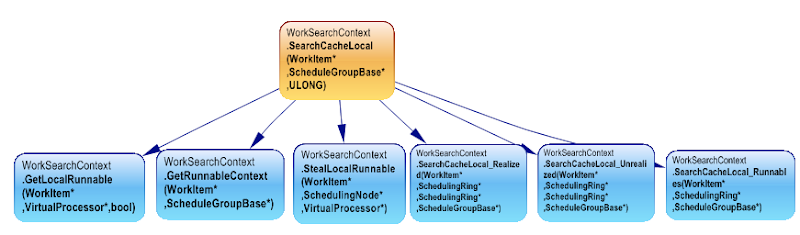
Ein weiteres Merkmal dieses Algorithmus besteht darin, dass entsperrte Kontexte pro virtuellem Prozessor zwischengespeichert und typischerweise nach dem LIFO-Prinzip (Last In, First Out) von dem virtuellen Prozessor eingeplant werden, der sie entsperrt hat.
Zur Überprüfung dieses Verhaltens zeigt der folgende Abhängigkeitsgraph die Methoden, die bei der Suche nach einem ausführbaren Kontext aufgerufen werden:
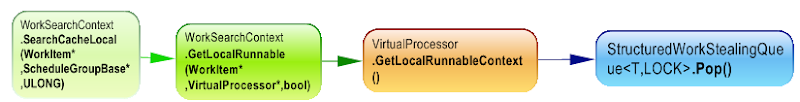
Dies ist der Standardalgorithmus, den der Scheduler verwendet, wenn kein anderer angegeben wurde.
- Fair-Algorithmus:
In diesem Fall durchläuft der Scheduler die Schedule Groups nach der Ausführung jeder Aufgabe bevorzugt im Round-Robin-Verfahren. Entsperrte Kontexte werden typischerweise nach dem FIFO-Prinzip (First In, First Out) eingeplant. Virtuelle Prozessoren speichern entsperrte Kontexte nicht zwischen.
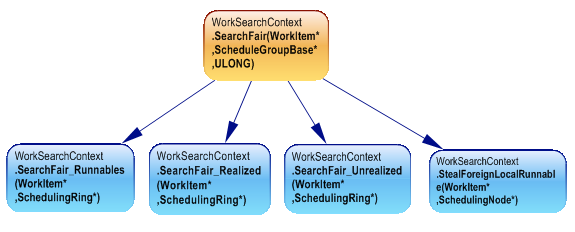
Dieser Algorithmus ist in WorkSearchContext::SearchFair implementiert. Wie der Abhängigkeitsgraph zeigt, ruft diese Methode weitere Methoden auf, um nach ausführbaren Kontexten, RealizedChore oder _UnrealizedChore zu suchen.