Le Task Scheduler planifie et coordonne les tâches à l'exécution. Une tâche est une unité de travail qui accomplit un travail précis. Le Task Scheduler prend en charge les détails nécessaires pour planifier efficacement les tâches sur des ordinateurs dotés de multiples ressources de calcul.
Le système d'exploitation Windows fournit un ordonnanceur préemptif en mode noyau : c'est un mécanisme round-robin basé sur les priorités qui donne à chaque tâche un accès exclusif à une ressource de calcul pendant une période donnée, puis bascule vers une autre tâche. Bien que ce mécanisme assure l'équité (chaque thread progresse), il a un coût en efficacité. Par exemple, de nombreux algorithmes intensifs en calcul ne requièrent pas d'équité ; il est plus important que les tâches liées se terminent dans le temps global le plus court possible. L'ordonnancement coopératif permet à une application de planifier le travail plus efficacement.
L'ordonnancement coopératif est un mécanisme qui donne à chaque tâche un accès exclusif à une ressource de calcul jusqu'à ce que la tâche se termine ou jusqu'à ce qu'elle cède son accès à la ressource.
L'ordonnanceur coopératif en mode utilisateur permet au code de l'application de prendre ses propres décisions d'ordonnancement. Comme l'ordonnancement coopératif permet à l'application de prendre de nombreuses décisions d'ordonnancement, il réduit une grande partie de la surcharge associée à la synchronisation en mode noyau.
Le Concurrency Runtime utilise l'ordonnancement coopératif conjointement avec l'ordonnanceur préemptif du système d'exploitation pour atteindre une utilisation maximale des ressources de traitement.
Conception de l'ordonnanceur
Le Concurrency Runtime fournit l'interface Scheduler pour implémenter un ordonnanceur spécifique adapté aux besoins de l'application.
Découvrons les classes implémentant cette interface ; pour cela, exécutons la requête CQL suivante :
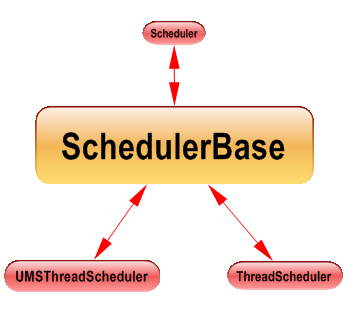
Le Concurrency Runtime fournit deux implémentations de l'ordonnanceur : ThreadScheduler et UMSThreadScheduler.
Comme le montre le graphe de dépendances suivant, l'ordonnanceur référence de nombreuses classes abstraites pour atteindre son objectif :
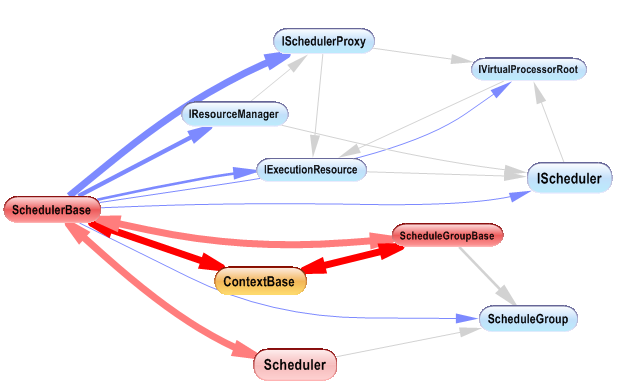
Découvrons le rôle de chaque classe abstraite utilisée par l'ordonnanceur ; pour cela, nous allons discuter de ses responsabilités.
Trois responsabilités majeures sont assignées au Task Scheduler :
1. Obtenir des ressources (processeurs, cœurs, mémoire) :
Lorsque l'ordonnanceur est créé, il demande des ressources au gestionnaire de ressources du runtime, comme expliqué dans cet article.
. L'ordonnanceur communique avec le gestionnaire de ressources à l'aide des interfaces IResourceManager, ISchedulerProxy et IScheduler. Lors de la création de l'ordonnanceur, nous pouvons spécifier sa politique.
L'énumération Concurrency::PolicyElementKey définit les clés de politique associées au Task Scheduler.
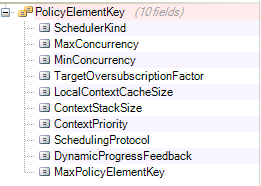
Voici un article expliquant l'objet de chaque clé de politique et sa valeur par défaut.
Voici un graphe de dépendances montrant ce qui se passe lorsqu'on crée un ordonnanceur :
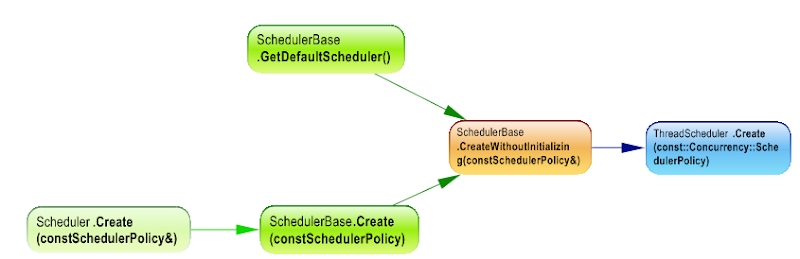
Le Concurrency Runtime crée un ordonnanceur par défaut si aucun ordonnanceur n'existe, en invoquant la méthode GetDefaultScheduler, et une politique par défaut est utilisée. Le Task Scheduler permet aux applications d'utiliser une ou plusieurs instances d'ordonnanceur pour planifier le travail, et une application peut invoquer Scheduler::Create pour ajouter un autre ordonnanceur utilisant une politique spécifique.
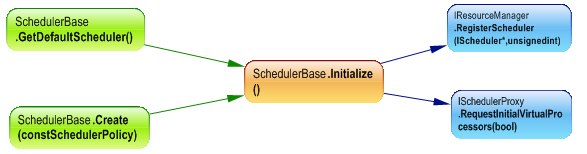
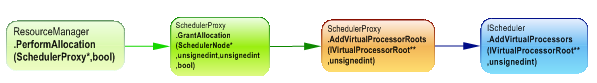
Les interactions suivantes entre l'ordonnanceur et le gestionnaire de ressources illustrent le rôle de chaque interface impliquée dans l'allocation des ressources.
- Demande d'allocation de ressources :
- Obtention des ressources auprès du gestionnaire de ressources :
2. Gérer les files de tâches :
Une fois l'ordonnanceur créé, des tâches peuvent lui être assignées pour exécution ; l'ordonnanceur stocke ces tâches dans des files. Pour garantir la cohésion des classes, les files ne sont pas gérées directement par la classe ThreadScheduler mais par la classe ScheduleGroupBase.
Un groupe de planification associe, ou regroupe, des tâches liées. Chaque ordonnanceur possède un ou plusieurs groupes de planification. Utilisez les groupes de planification lorsque vous avez besoin d'un haut degré de localité entre les tâches, par exemple lorsqu'un groupe de tâches liées bénéficie d'une exécution sur le même nœud de processeur.
Comme le montre le graphe suivant, le runtime fournit deux sortes de ScheduleGroup : FairScheduleGroup et CacheLocalScheduleGroup. Le choix entre ces deux groupes, comme nous l'expliquerons plus loin, a un impact sur l'algorithme utilisé par l'ordonnanceur pour choisir la prochaine tâche à exécuter.
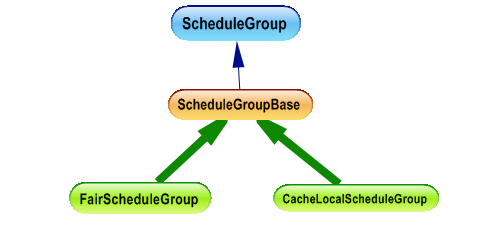
Chaque ordonnanceur possède un groupe de planification par défaut pour chaque nœud de planification. Le runtime crée un nœud de planification pour chaque package de processeur ou nœud NUMA (Non-Uniform Memory Architecture). Si vous n'associez pas explicitement une tâche à un groupe de planification, l'ordonnanceur choisit à quel groupe ajouter la tâche.
Comme le montre le graphe de dépendances suivant, le SchedulingRing est responsable de la gestion des groupes de planification : il contient une liste de groupes et les crée.
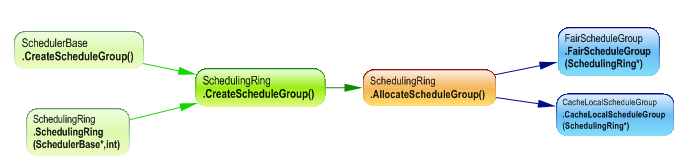
Le groupe de planification contient trois sortes de files :
1. La file FIFO
Cette file contient des tâches légères. Une tâche légère ressemble à la fonction que vous fournissez à la fonction CreateThread de l'API Windows. Par conséquent, les tâches légères sont utiles lorsque vous adaptez du code existant pour utiliser les fonctionnalités d'ordonnancement du Concurrency Runtime.
Une tâche légère est représentée par la classe RealizedChore, et la file FIFO du groupe de planification est représentée par le champ m_realizedChores.
Recherchons les méthodes qui utilisent directement cette file :
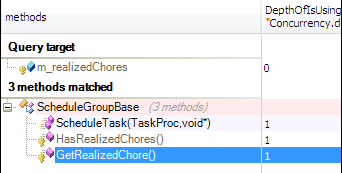
On peut donc ajouter une tâche légère au groupe en invoquant ScheduleGroupBase::ScheduleTask ou Scheduler::ScheduleTask.
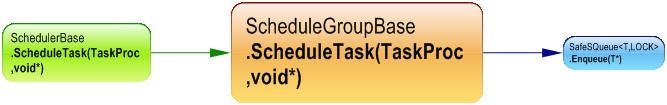
Voici un article intéressant sur les tâches légères.
2. La file de vol de travail (work stealing) :
Il n'y a qu'une seule file FIFO associée au groupe de planification, mais le groupe de planification référence une liste de files de vol de travail : chaque thread de travail possède sa propre file locale.
Un thread attaché à un ordonnanceur est appelé un contexte d'exécution, ou simplement un contexte, si bien que cette file locale est en réalité associée à la classe Context.
La classe Context fournit une abstraction de programmation pour un contexte d'exécution et offre la possibilité de bloquer, débloquer et céder le contexte courant de manière coopérative.
Pour vérifier que seul Context crée ce type de file, recherchons les méthodes qui accèdent directement au champ m_workQueues.
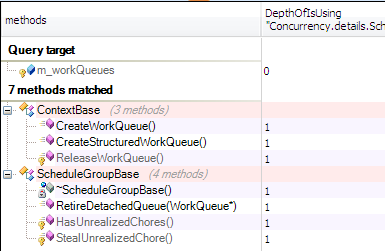
Le contexte est responsable de la création de cette file, et chaque contexte possède une file locale de vol de travail qui lui est associée.
Pour illustrer le comportement de l'algorithme de vol de travail, supposons que nous ayons deux threads de travail alloués à l'ordonnanceur.
Comme expliqué ci-dessus, chaque thread de travail possède sa propre file locale.
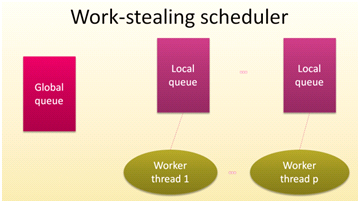
Trois tâches se trouvent dans la file du thread de travail 1 : les tâches 3 et 4 attendent d'être exécutées tandis que la tâche 5 est en cours d'exécution.
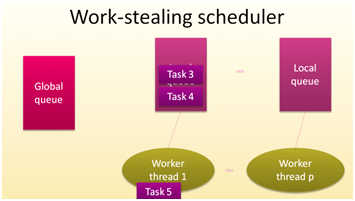
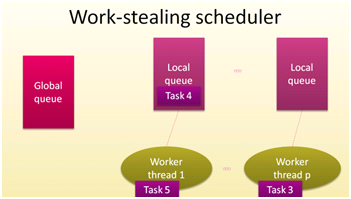
La méthode Dispatch constate que la file est vide, si bien que la tâche 3 est déplacée, ou « volée », de sa file d'origine et assignée au thread de travail disponible.
Comment créer une tâche gérée par une file de vol de travail ? Pour le savoir, recherchons les méthodes qui invoquent indirectement la méthode CreateWorkQueue.
Comme le montre ce graphe de dépendances, ce type de tâche peut être créé en utilisant la classe task_group.
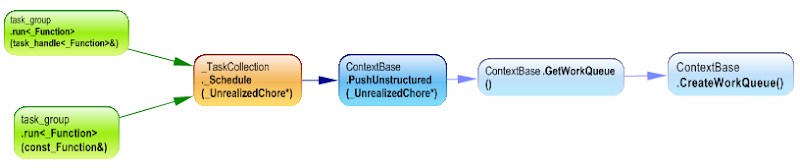
Utiliser task_group pour ajouter une nouvelle tâche est préférable à l'utilisation de Scheduler::ScheduleTask pour créer une tâche légère, car l'algorithme de vol de travail fait un meilleur usage des processeurs virtuels alloués à l'ordonnanceur.
Cependant, ScheduleTask peut être préférable pour migrer facilement du code existant qui utilise l'API CreateThread.
3. La file des contextes débloqués
La classe Context permet de bloquer ou de céder le contexte d'exécution courant. Bloquer ou céder est utile lorsque le contexte courant ne peut pas continuer parce qu'une ressource n'est pas disponible. La méthode Context::Block bloque le contexte courant. Un contexte bloqué cède ses ressources de traitement afin que le runtime puisse exécuter d'autres tâches. La méthode Context::Unblock débloque un contexte bloqué.
Lorsqu'un contexte est débloqué et disponible pour être exécuté, il est ajouté à la file des contextes exécutables ; cette file est représentée par le champ m_runnableContexts.
Voici un graphe de dépendances montrant quelques cas où le contexte est ajouté à la file des exécutables :
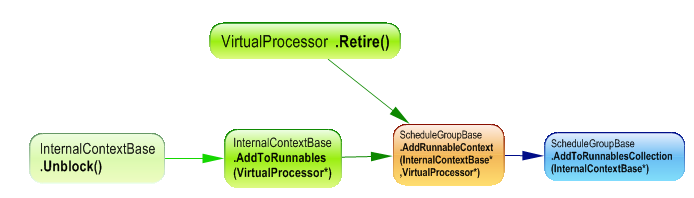
Le contexte est donc ajouté à la file lorsqu'il est débloqué ou lorsqu'un processeur virtuel est retiré de l'ordonnanceur.
3. Distribuer les tâches :
L'ordonnanceur tente de trouver du travail à exécuter ; le travail peut être :
- Un contexte débloqué.
- Une tâche légère.
- Une tâche dans les files de vol de travail.
Comme expliqué ci-dessus, tout ce travail est stocké dans des files gérées par les groupes de planification, et chaque groupe est géré par un anneau de planification (scheduling ring).
Lorsqu'un processeur virtuel est alloué à l'ordonnanceur, une classe ThreadProxy est créée et associée à ce processeur, et après sa création, la méthode Dispatch du ThreadProxy est invoquée. Comme le montre le graphe de dépendances suivant, et comme expliqué précédemment, le Concurrency Runtime utilise des classes abstraites pour garantir un faible couplage, et le dispatch réellement invoqué dépend de l'implémentation choisie par le runtime ; ce choix est donné par la politique de l'ordonnanceur.
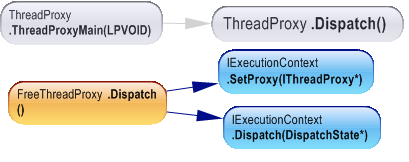
L'implémentation concrète de Dispatch invoque la méthode Dispatch du contexte d'exécution.
Voici un graphe de dépendances montrant les méthodes invoquées par une implémentation concrète de la méthode Context::Dispatch :
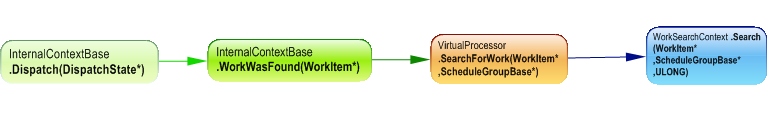
L'algorithme de recherche du prochain travail à exécuter est donc implémenté par la classe WorkSearchContext.
Découvrons toutes les classes utilisées directement par WorkSearchContext pour remplir sa responsabilité :
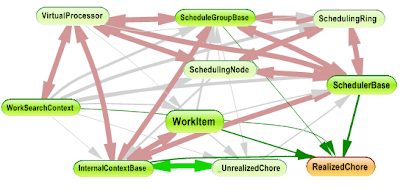
La responsabilité de WorkSearchContext est de fournir un WorkItem à exécuter ; il peut s'agir d'un InternalContextBase, d'un RealizedChore ou d'un _UnrealizedChore.
Pour mieux comprendre la collaboration entre ces classes, recherchons les méthodes utilisées directement par WorkSearchContext :
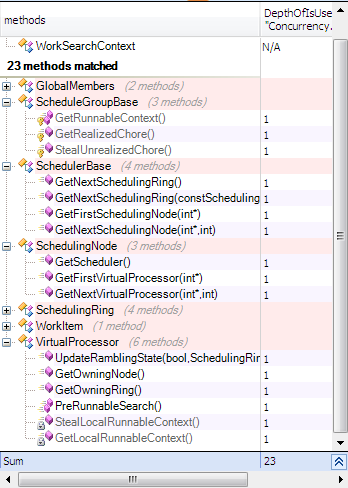
WorkSearchContext itère donc sur les classes SchedulingRing et ScheduleGroup en utilisant les méthodes de SchedulerBase.
Pour chaque ScheduleBase, nous recherchons un RunnableContext, un RealizedChore ou un UnrealizedChore.
La classe WorkSearchContext est créée par la classe VirtualProcessor, et comme le montre le graphe de dépendances suivant, l'algorithme utilisé est spécifié lors de l'initialisation du VirtualProcessor ; pour cela, il demande à l'ordonnanceur le SchedulingProtocol, qui décrit l'algorithme d'ordonnancement qui sera utilisé par l'ordonnanceur.
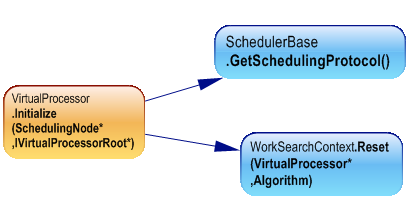
WorkSearchContext est informé de l'algorithme à utiliser par la réception d'une valeur de l'énumération Algorithm.
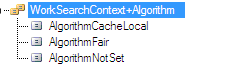
Cette classe implémente donc deux algorithmes de recherche de travail :
- L'algorithme Cache Local :
Cet algorithme recherche des contextes exécutables dans le groupe de planification courant, puis des realized chores, puis des unrealized chores ; s'il n'y a plus de travail dans le groupe de planification courant, il recherche dans le groupe suivant du même anneau de planification. Une fois le travail de l'anneau de planification courant épuisé, il passe à l'anneau suivant.
L'ordonnanceur préfère donc continuer à travailler sur les tâches du groupe de planification courant avant de passer à un autre groupe de planification.
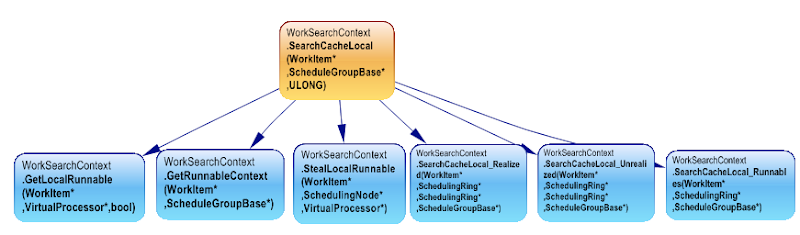
Cet algorithme est implémenté par la méthode WorkSearchContext::SearchCacheLocal, et comme le montre ce graphe de dépendances, cette méthode en invoque d'autres pour rechercher des contextes exécutables, des RealizedChore ou des _UnrealizedChore.
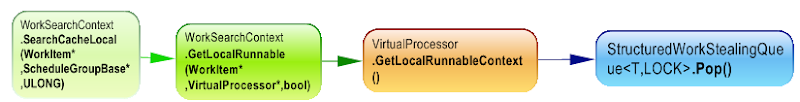
Une autre caractéristique de cet algorithme est que les contextes débloqués sont mis en cache par processeur virtuel et sont typiquement planifiés dans l'ordre dernier entré, premier sorti (LIFO) par le processeur virtuel qui les a débloqués.
Pour vérifier ce comportement, voici un graphe de dépendances des méthodes invoquées lors de la recherche d'un contexte exécutable :
C'est l'algorithme par défaut choisi par l'ordonnanceur lorsqu'aucun n'est spécifié.
- L'algorithme Fair :
Dans ce cas, l'ordonnanceur préfère passer en revue les groupes de planification en round-robin après l'exécution de chaque tâche. Les contextes débloqués sont typiquement planifiés selon un ordre premier entré, premier sorti (FIFO). Les processeurs virtuels ne mettent pas en cache les contextes débloqués.
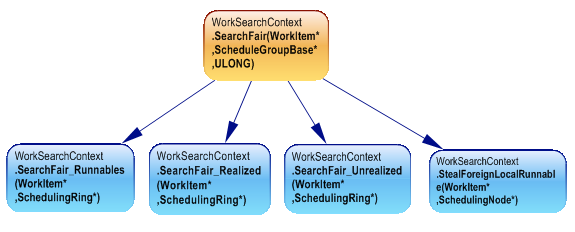
Cet algorithme est implémenté par la méthode WorkSearchContext::SearchFair, et comme le montre ce graphe de dépendances, cette méthode en invoque d'autres pour rechercher des contextes exécutables, des RealizedChore ou des _UnrealizedChore.