
MemCache++ ist ein leichtgewichtiger, typsicherer, einfach zu verwendender und funktionsreicher Memcache-Client. Er wurde von Dean Michael Berris entwickelt, einem begeisterten C++-Entwickler, der derzeit bei Google Australia arbeitet. Außerdem gehört er zur Google-Delegation im ISO-C++-Komitee.
Das Studium gut konzipierter Bibliotheken ist eine hervorragende Möglichkeit, die eigenen Fähigkeiten beim Entwurf und bei der Implementierung von C++-Software zu verbessern. Dieser Artikel untersucht einige Designentscheidungen, durch die memcache++ leicht verständlich und einfach zu verwenden ist.
Modularität durch Namespaces
Namespaces eignen sich hervorragend, um eine Anwendung zu modularisieren. Leider wird diese Möglichkeit in C++-Projekten zu selten genutzt – ein kurzer Blick auf beliebige Open-Source-C++-Projekte macht das deutlich. Sucht man zudem nach einer Definition von C++-Namespaces, findet man häufig sinngemäß Folgendes:
A namespace defines a new scope. They provide a way to avoid name collisions.
Häufig wird die Vermeidung von Namenskollisionen als wichtigste Motivation genannt und nicht die Modularität – anders als bei C# und Java, wo Namespaces üblicherweise zur Strukturierung von Anwendungen eingesetzt werden. Einige moderne C++-Bibliotheken wie Boost nutzen Namespaces jedoch gezielt, um die Bibliothek sauber zu strukturieren, und fördern deren Verwendung durch Entwickler.
Wie sieht es mit der Namespace-Modularität in memcache++ aus?
Hier ist der Abhängigkeitsgraph zwischen den Namespaces von memcache++:
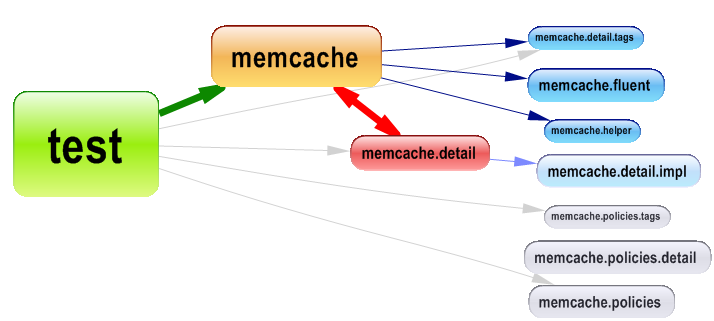
Namespaces werden aus zwei Hauptgründen verwendet:
- Die Bibliothek modularisieren.
- Implementierungsdetails verbergen, etwa über den Namespace „memcache::detail“. Dieser Ansatz ist besonders nützlich, um dem Benutzer der Bibliothek zu signalisieren, dass die darin enthaltenen Typen nicht direkt verwendet werden sollen. In C# übernimmt das Schlüsselwort „internal“ diese Aufgabe; in C++ gibt es dagegen keine Möglichkeit, öffentliche Typen vor dem Benutzer einer Bibliothek zu verbergen.
memcache++ nutzt Namespaces wirkungsvoll. Allerdings besteht zwischen memcache und memcache::detail ein Abhängigkeitszyklus. Diesen können wir beseitigen, indem wir nach Typen aus memcache suchen, die von memcache::detail verwendet werden.
Dazu können wir die folgende CQLinq-Abfrage ausführen:
from t in Types where t.IsUsedBy("memcache.detail")
&& t.ParentNamespace.Name=="memcache"
select new { t,t.TypesUsingMe }
Das ist das Ergebnis der Abfrage:

Um den Abhängigkeitszyklus zu beseitigen, können wir pool_directive und server_pool_test in den Namespace memcache verschieben.
Welches Paradigma wird in modernem C++ häufiger verwendet: generische Programmierung oder OOP?
In der C++-Welt sind zwei Denkrichtungen besonders verbreitet: objektorientierte und generische Programmierung. Beide Ansätze haben ihre Befürworter. Dieser Artikel erläutert das Spannungsfeld zwischen beiden.
Welches Paradigma verwendet memcache++ überwiegend?
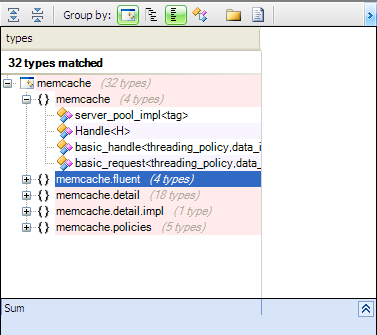
Um diese Frage zu beantworten, suchen wir zunächst nach generischen Typen:
from t in Types where t.IsGeneric && !t.IsThirdParty select t
Und wie sieht es mit den nicht generischen Typen aus?
from t in Types where !t.IsGeneric && !t.IsGlobal && !t.IsNested
&& !t.IsEnumeration  && t.ParentProject.Name=="memcache"
select t
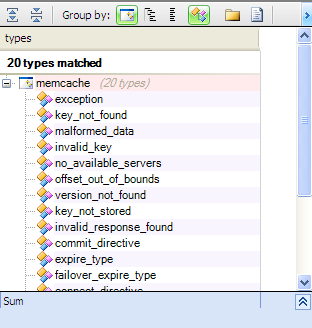
Fast alle nicht generischen Typen sind Exception-Klassen. Um ihren Anteil besser einschätzen zu können, ist die Treemap-Ansicht besonders hilfreich.

Die blauen Rechtecke stellen das Ergebnis der CQLinq-Abfrage dar. Wie zu erkennen ist, entfällt nur ein sehr kleiner Teil der Bibliothek auf nicht generische Typen.
Abschließend können wir nach generischen Methoden suchen:
from m in Methods where m.IsGeneric && !m.IsThirdParty select m
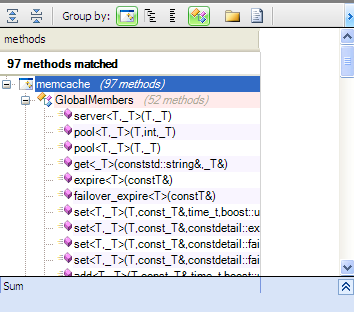
Wie wir sehen, setzt memcache++ überwiegend Generics ein. Das allein reicht jedoch nicht aus, um zu bestätigen, dass die Bibliothek dem Ansatz der generischen Programmierung in C++ folgt. Ein guter Indikator dafür ist die Verwendung von Vererbung und dynamischem Polymorphismus, die in der OOP eine zentrale Rolle spielen. Bei generischer Programmierung wird Vererbung dagegen nur sehr begrenzt eingesetzt und dynamischer Polymorphismus vermieden.
Suchen wir nach Typen mit Basisklassen.
from t in Types where t.BaseClasses.Count()>0 && !t.IsThirdParty
&& t.ParentProject.Name=="memcache"
select t
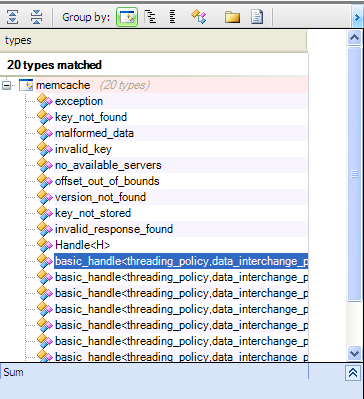
Dass Exception-Klassen Vererbung verwenden, ist normal. Doch wie sieht es mit den übrigen Klassen aus? Nutzen sie Vererbung für dynamischen Polymorphismus? Um das herauszufinden, suchen wir nach allen virtuellen Methoden.
from m in Methods where m.IsVirtual select m
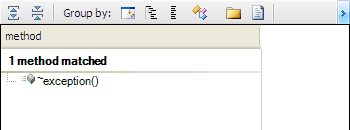
Nur die Exception-Klasse besitzt eine virtuelle Methode.
Wenn kein dynamischer Polymorphismus verwendet wird, welchen Ansatz können wir dann wählen, wenn bestimmte Klassen unterschiedliches Verhalten benötigen?
Eine gängige Lösung im modernen C++ ist der Einsatz von Policies. Hier eine kurze Definition aus Wikipedia:
"The central idiom in policy-based design is a class template(called the host class),taking several type parameters as input, which are instantiated with types selected by the user (called policy classes), each implementing a particular implicit interface (called a policy)."memcache++ enthält zahlreiche Policies im Namespace memcache.policies.
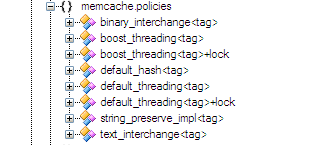
Sehen wir uns ein Beispiel aus memcache++ an, um Policy-basiertes Design besser zu verstehen.
memcache++ verwendet den Typ basic_handle, um sämtliche Befehle wie add, set, get und delete für den Cache zu implementieren. Die Klasse ist folgendermaßen definiert:
    template <
        class threading_policy = policies::default_threading,
        class data_interchange_policy = policies::binary_interchange,
        class hash_policy = policies::default_hash
    >
    struct basic_handle
memcache++ ist threadsicher und muss in einem Multithreading-Kontext die Synchronisierung verwalten. Standardmäßig lautet die threading_policy „default_threading“, bei der keine besondere Verarbeitung erforderlich ist. Für Multithreading wird dagegen die Policy „boost_threading“ verwendet.
Sehen wir uns die Implementierung der Methode connect an.
    void connect(boost::uint64_t timeout = MEMCACHE_TIMEOUT) {
       typename threading_policy::lock scoped_lock(*this);
       for_each(servers.begin(), servers.end(), connect_impl(service_, timeout));
    };
Wenn threading_policy auf „default_threading“ gesetzt ist, hat die erste Zeile keine Wirkung, da der lock-Konstruktor nichts ausführt. Bei „boost_threading“ verwendet der Lock dagegen Boost zur Synchronisierung zwischen Threads.
Policies bieten größere Flexibilität bei der Implementierung unterschiedlicher Verhaltensweisen und bleiben dabei vergleichsweise leicht verständlich und verwendbar.
Generische Funktoren
memcache++ implementiert zahlreiche Befehle für die Interaktion mit dem Cache, darunter add, get, set und delete. Für einen solchen Fall eignet sich das Command Pattern sehr gut. memcache++ implementiert dieses Muster mithilfe generischer Funktoren. Mit der folgenden CQLinq-Abfrage lassen sich alle Funktoren ermitteln:
from t in Types where t.Methods.Where(a=>a.IsOperator
&& a.Name.Contains("()")).Count()>0
select t
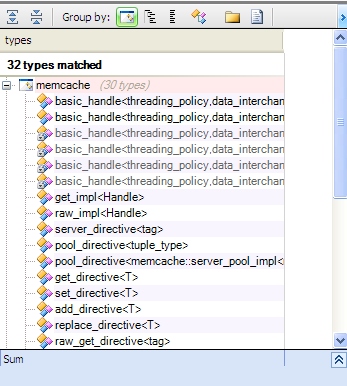
Ein Funktor kapselt einen Funktionsaufruf zusammen mit seinem Zustand. Dadurch kann der Aufruf auf einen späteren Zeitpunkt verschoben und als Callback verwendet werden. Generische Funktoren bieten dabei mehr Flexibilität als gewöhnliche Funktoren.
Öffentliche Schnittstelle
Wie eine Bibliothek ihre Funktionen nach außen bereitstellt, ist sehr wichtig, da dies sowohl die Flexibilität als auch die Benutzerfreundlichkeit beeinflusst. Um dies zu untersuchen, betrachten wir die Kommunikation zwischen dem Testprojekt und der memcache++-Bibliothek.
from m in Methods where m.IsUsedBy ("test")
select m
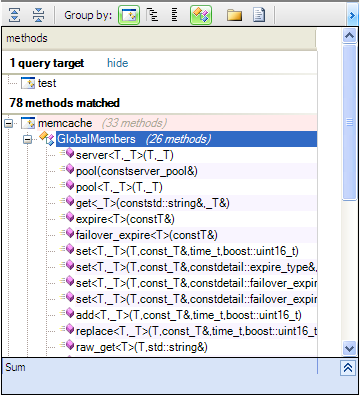
Das Testprojekt verwendet hauptsächlich generische Methoden, um Funktionen von memcache++ aufzurufen. Welche Vorteile bieten Template-Methoden? Warum nicht Klassen oder Funktionen verwenden?
Beim OOP-Ansatz besteht die Schnittstelle einer Bibliothek aus Klassen und Funktionen. In gut konzipierten Bibliotheken dienen abstrakte Klassen als Verträge, um eine geringe Kopplung sicherzustellen. Dieser Ansatz ist sehr interessant, bringt jedoch einige Nachteile mit sich:
- Die Schnittstelle wird komplexer und muss möglicherweise häufig geändert werden. Betrachten wir dazu die von memcache++ bereitgestellte Methode add. Ohne den generischen Ansatz müssten zahlreiche Methoden hinzugefügt werden – jeweils eine für jeden konkreten Typ wie int, double, string usw.
Die generische Methode add wird als add<T> deklariert, wobei T den Typ bezeichnet. Dadurch benötigen wir nur eine einzige Methode, und selbst wenn ein weiterer Typ unterstützt werden soll, muss die Schnittstelle nicht geändert werden.
- Die Schnittstelle ist weniger flexibel. Stellen wir beispielsweise eine Methode wie diese bereit:
calculate(IAlgo* algo).
Der Benutzer muss eine von IAlgo abgeleitete Klasse bereitstellen. Verwenden wir dagegen Generics und definieren die Methode als calculate<T>, muss lediglich eine Klasse mit den benötigten Methoden bereitgestellt werden; eine Vererbung von IAlgo ist nicht erforderlich. Selbst wenn IAlgo aufgrund neuer Methoden zu IAlgo2 geändert wird, bleibt der Benutzer der Bibliothek davon unberührt.
Idealerweise sollte die öffentliche Schnittstelle einer Bibliothek keine Breaking Changes enthalten, und Änderungen innerhalb der Bibliothek sollten ihre Benutzer nicht beeinträchtigen. Der generische Ansatz eignet sich für diese Anforderungen besonders gut, da er Änderungen sehr flexibel verkraftet.
Verwendete externe APIs
Hier sind die von memcache++ verwendeten externen Typen:
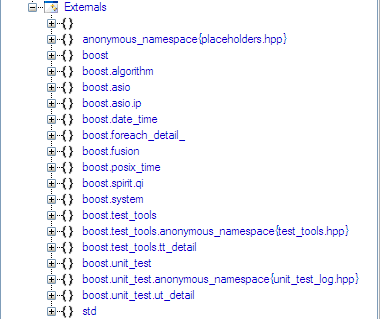
memcache++ greift zur Umsetzung seiner Funktionen hauptsächlich auf Boost und die STL zurück. Unter anderem werden folgende Boost-Komponenten verwendet:
- Multithreading.
- Algorithmen.
- Spirit.
- Asio.
- Unit-Tests.
Aus der STL werden vor allem Container verwendet.
Welche Vorteile bietet der generische Ansatz also letztlich?
- Ein erster Hinweis auf die Effizienz der Designentscheidungen von memcache++ ist die geringe Anzahl an Codezeilen (LOC): Die Bibliothek umfasst nur etwa 600 Zeilen. Dafür gibt es zwei Hauptgründe:
- Der generische Ansatz reduziert Boilerplate-Code.
- Die umfangreichen Möglichkeiten von Boost und STL werden konsequent genutzt.
- Die zweite große Stärke ist die Flexibilität: Änderungen wirken sich jeweils nur auf einen sehr kleinen Teil des Codes aus.