
MemCache++ est un client Memcache léger, à typage sûr, simple d'utilisation et complet. Il a été développé par Dean Michael Berris, un passionné de C++ qui travaille actuellement chez Google Australie. Il fait également partie de la délégation de Google au comité ISO C++.
Étudier des bibliothèques bien conçues est un excellent moyen d'améliorer vos compétences en conception et en implémentation C++. L'objectif de cet article est d'explorer quelques-uns des choix de conception qui rendent memcache++ facile à comprendre et à utiliser.
La modularité par les espaces de noms
Les espaces de noms sont un bon moyen de modulariser une application. Malheureusement, cette fonctionnalité est sous-utilisée dans les projets C++ — un rapide coup d'œil sur des projets C++ open source pris au hasard le montre clairement. De plus, lorsqu'on recherche la définition d'un espace de noms C++, la définition courante ressemble à ceci :
A namespace defines a new scope. They provide a way to avoid name collisions.
Souvent, l'évitement des collisions est présenté comme la motivation principale plutôt que la modularité — contrairement au C# et au Java, où les espaces de noms sont plus couramment utilisés pour structurer les applications. Cependant, certaines bibliothèques C++ modernes comme Boost utilisent les espaces de noms pour bien structurer la bibliothèque et encourager les développeurs à les utiliser.
Qu'en est-il de la modularité par espaces de noms dans memcache++ ?
Voici le graphe de dépendances entre les espaces de noms de memcache++ :
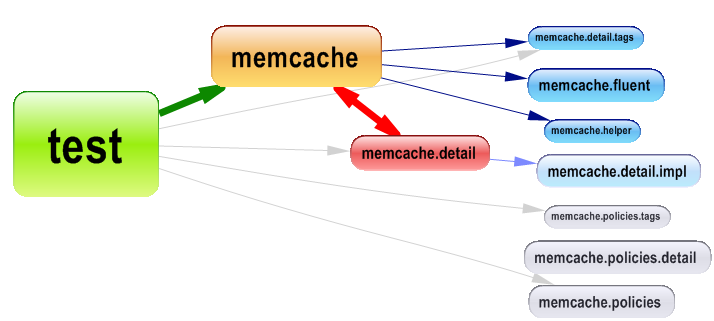
Les espaces de noms sont utilisés pour deux raisons principales :
- Modulariser la bibliothèque.
- Masquer les détails, comme l'espace de noms « memcache::detail » ; cette approche est très intéressante si l'on veut indiquer à l'utilisateur de la bibliothèque qu'il n'a pas besoin d'utiliser directement les types de cet espace de noms. En C#, le mot-clé « internal » fait le travail, mais en C++ il n'y a aucun moyen de masquer les types publics à l'utilisateur de la bibliothèque.
memcache++ fait un usage efficace des espaces de noms. Cependant, un cycle de dépendances existe entre memcache et memcache::detail. Nous pouvons supprimer ce cycle en recherchant les types utilisés par memcache::detail depuis memcache.
Pour cela, nous pouvons exécuter la requête CQLinq suivante :
from t in Types where t.IsUsedBy("memcache.detail")
&& t.ParentNamespace.Name=="memcache"
select new { t,t.TypesUsingMe }
Voici le résultat après exécution de la requête :

Pour supprimer le cycle de dépendances, nous pouvons déplacer pool_directive et server_pool_test dans l'espace de noms memcache.
Quel paradigme est le plus utilisé dans le code C++ moderne : la programmation générique ou la POO ?
Dans le monde du C++, deux écoles de pensée sont très populaires : la programmation orientée objet et la programmation générique ; chaque approche a ses partisans. Cet article explique la tension entre elles.
Quel paradigme est le plus utilisé par memcache++ ?
Pour répondre à cette question, recherchons d'abord les types génériques :
from t in Types where t.IsGeneric && !t.IsThirdParty select t
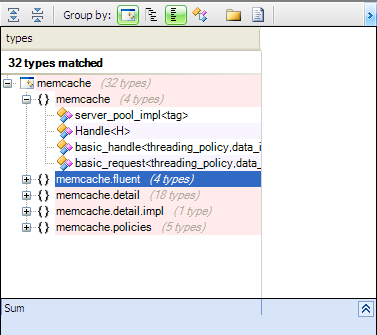
Et les types non génériques ?
from t in Types where !t.IsGeneric && !t.IsGlobal && !t.IsNested
&& !t.IsEnumeration  && t.ParentProject.Name=="memcache"
select t
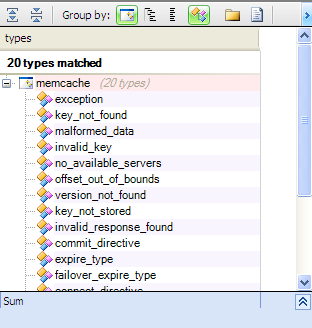
Presque tous les types non génériques sont des classes d'exceptions, et pour avoir une meilleure idée de leur proportion, la vue treemap est très utile.

Les rectangles bleus représentent le résultat de la requête CQLinq, et comme on peut le constater, seule une part minime de la bibliothèque concerne des types non génériques.
Enfin, nous pouvons rechercher les méthodes génériques :
from m in Methods where m.IsGeneric && !m.IsThirdParty select m
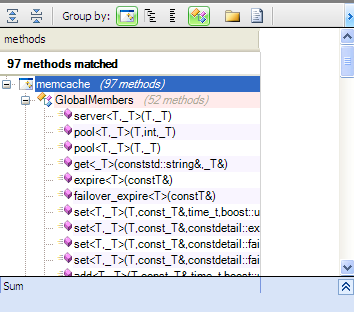
Comme on peut le voir, memcache++ utilise surtout la généricité, mais cela ne suffit pas pour confirmer qu'il suit l'approche de la programmation générique en C++. Pour le vérifier, un bon indicateur est l'utilisation de l'héritage et du polymorphisme dynamique, que la POO utilise massivement. En revanche, dans l'approche générique, l'héritage est très limité et le polymorphisme dynamique est évité.
Recherchons les types qui ont des classes de base.
from t in Types where t.BaseClasses.Count()>0 && !t.IsThirdParty
&& t.ParentProject.Name=="memcache"
select t
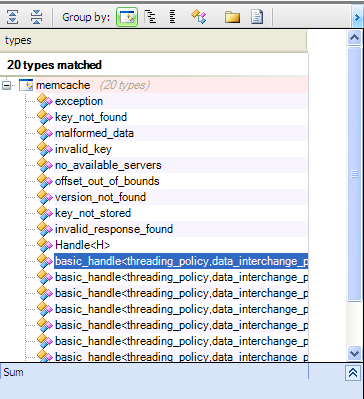
Il est normal que les classes d'exceptions utilisent l'héritage, mais qu'en est-il des autres classes ? Utilisent-elles l'héritage à des fins de polymorphisme dynamique ? Pour répondre à cette question, recherchons toutes les méthodes virtuelles.
from m in Methods where m.IsVirtual select m
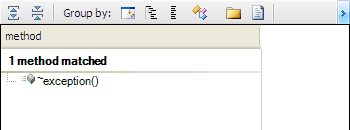
Seule la classe d'exception possède une méthode virtuelle.
Si le polymorphisme dynamique n'est pas utilisé, quelle approche peut-on adopter lorsqu'on a besoin d'un comportement différent pour des classes spécifiques ?
La solution courante dans l'approche C++ moderne est d'utiliser des policies. En voici une courte définition tirée de Wikipédia :
"The central idiom in policy-based design is a class template(called the host class),taking several type parameters as input, which are instantiated with types selected by the user (called policy classes), each implementing a particular implicit interface (called a policy)."memcache++ possède de nombreuses policies dans l'espace de noms memcache.policies.
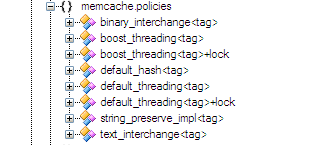
Regardons un exemple de memcache++ pour mieux comprendre la conception par policies.
memcache++ utilise le type basic_handle pour implémenter toutes les commandes comme add, set, get et delete du cache. Cette classe est définie comme ceci :
    template <
        class threading_policy = policies::default_threading,
        class data_interchange_policy = policies::binary_interchange,
        class hash_policy = policies::default_hash
    >
    struct basic_handle
memcache++ est thread-safe, et dans un contexte multithread il doit gérer la synchronisation ; par défaut, la threading_policy est « default_threading », où aucun traitement particulier n'est requis. En revanche, pour le multithreading, la policy utilisée est « boost_threading ».
Jetons un œil à l'implémentation de la méthode connect.
    void connect(boost::uint64_t timeout = MEMCACHE_TIMEOUT) {
       typename threading_policy::lock scoped_lock(*this);
       for_each(servers.begin(), servers.end(), connect_impl(service_, timeout));
    };
Si threading_policy est « default_threading », la première ligne n'a aucun effet car le constructeur du verrou ne fait rien. En revanche, s'il s'agit de boost_threading, le verrou utilise Boost pour synchroniser les threads.
L'utilisation des policies nous donne une plus grande flexibilité pour implémenter différents comportements, tout en restant relativement facile à comprendre et à utiliser.
Les foncteurs génériques
memcache++ implémente de nombreuses commandes pour interagir avec le cache, comme add, get, set et delete. Le pattern commande est un bon candidat pour un tel cas. memcache++ implémente ce pattern en utilisant des foncteurs génériques ; voici une requête CQLinq pour obtenir tous les foncteurs :
from t in Types where t.Methods.Where(a=>a.IsOperator
&& a.Name.Contains("()")).Count()>0
select t
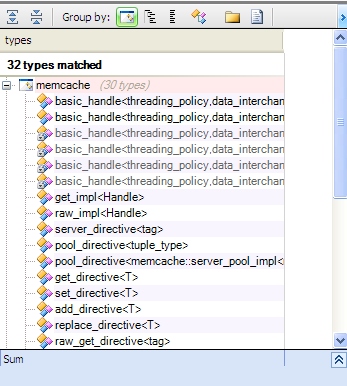
Un foncteur encapsule un appel de fonction avec son état, et il peut servir à différer l'appel à un moment ultérieur et à agir comme un callback. Les foncteurs génériques offrent plus de flexibilité que les foncteurs classiques.
L'interface publique exposée
La façon dont une bibliothèque expose ses capacités est très importante car elle affecte à la fois la flexibilité et la facilité d'utilisation. Pour le découvrir, recherchons la communication entre le projet de test et la bibliothèque memcache++.
from m in Methods where m.IsUsedBy ("test")
select m
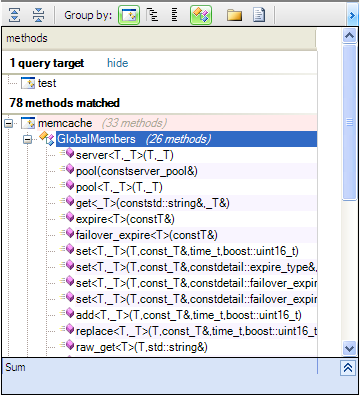
Le projet de test utilise principalement des méthodes génériques pour invoquer les fonctionnalités de memcache++. Quels sont les avantages de l'utilisation des méthodes templates ? Pourquoi ne pas utiliser des classes ou des fonctions ?
Avec l'approche POO, l'interface de la bibliothèque est composée de classes et de fonctions, et pour les bibliothèques bien conçues, des classes abstraites sont utilisées comme contrats pour garantir un faible couplage. Cette solution est très intéressante mais présente quelques inconvénients :
- L'interface devient plus compliquée et peut changer fréquemment. Pour l'illustrer, prenons la méthode add exposée par memcache++. Si l'on n'utilise pas l'approche générique, de nombreuses méthodes doivent être ajoutées, une pour chaque type spécifique : int, double, string…
La méthode générique add est déclarée add<T>, où T est le type ; dans ce cas, une seule méthode suffit, et même si l'on veut ajouter un autre type, aucune modification de l'interface n'est nécessaire.
- L'interface est moins flexible. Par exemple, si l'on expose une méthode comme celle-ci :
calculate(IAlgo* algo).
L'utilisateur doit fournir une classe héritant de IAlgo. En revanche, si l'on utilise la généricité et qu'on la définit comme calculate<T>, l'utilisateur n'a qu'à fournir une classe dotée des méthodes nécessaires et n'est pas obligé d'hériter de IAlgo. Et si IAlgo devient IAlgo2 parce que de nouvelles méthodes sont ajoutées, l'utilisateur de la bibliothèque ne sera pas affecté.
Idéalement, l'interface exposée par une bibliothèque ne doit subir aucun changement cassant, et l'utilisateur ne doit pas être impacté lorsque des modifications sont introduites dans la bibliothèque. L'approche générique est la plus adaptée à de telles contraintes car elle est très tolérante lorsque des changements sont nécessaires.
Les API externes utilisées
Voici les types externes utilisés par memcache++ :
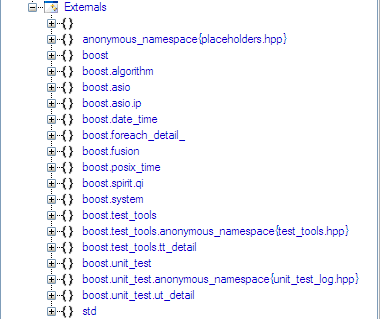
memcache++ utilise surtout Boost et la STL pour atteindre ses objectifs ; voici quelques fonctionnalités de Boost utilisées :
- le multithreading.
- les algorithmes.
- spirit.
- asio.
- les tests unitaires.
De la STL, ce sont les conteneurs qui sont le plus souvent utilisés.
Alors finalement, quels sont les avantages de l'approche générique ?
- Le premier indicateur de l'efficacité des choix de conception de memcache++ est le nombre de lignes de code (LOC), qui n'est que d'environ 600 lignes ; ce résultat s'explique par deux raisons principales :
- L'approche générique supprime le code boilerplate.
- L'exploitation de la richesse de Boost et de la STL.
- Le second atout est sa flexibilité : tout changement n'impacte qu'une portion minimale du code.