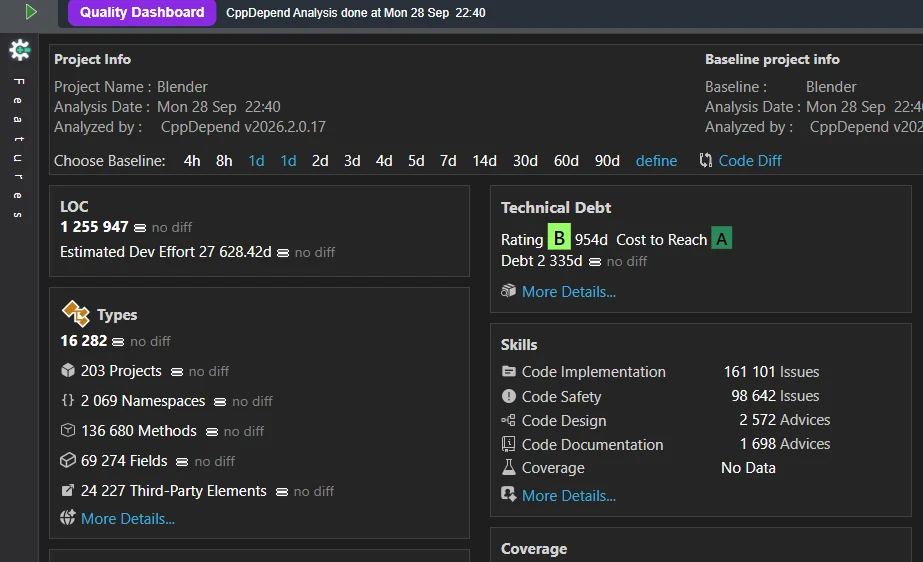
Blender ist eine der erfolgreichsten leistungsstarken Open-Source-3D-Suiten der Welt. Eine CppDepend-Analyse seiner Kernmodule offenbart eine überraschend starke Gesamtbewertung der Wartbarkeit — eine bemerkenswerte Leistung für eine gewaltige Codebasis mit über 16.000 Typen und 136.000 Methoden.
Betrachtet man jedoch die strukturellen Beziehungen zwischen seinen Kernmodulen, zeichnet die Dependency Structure Matrix (DSM) ein weitaus komplexeres Bild und deckt weit verbreitete Abhängigkeitszyklen auf:
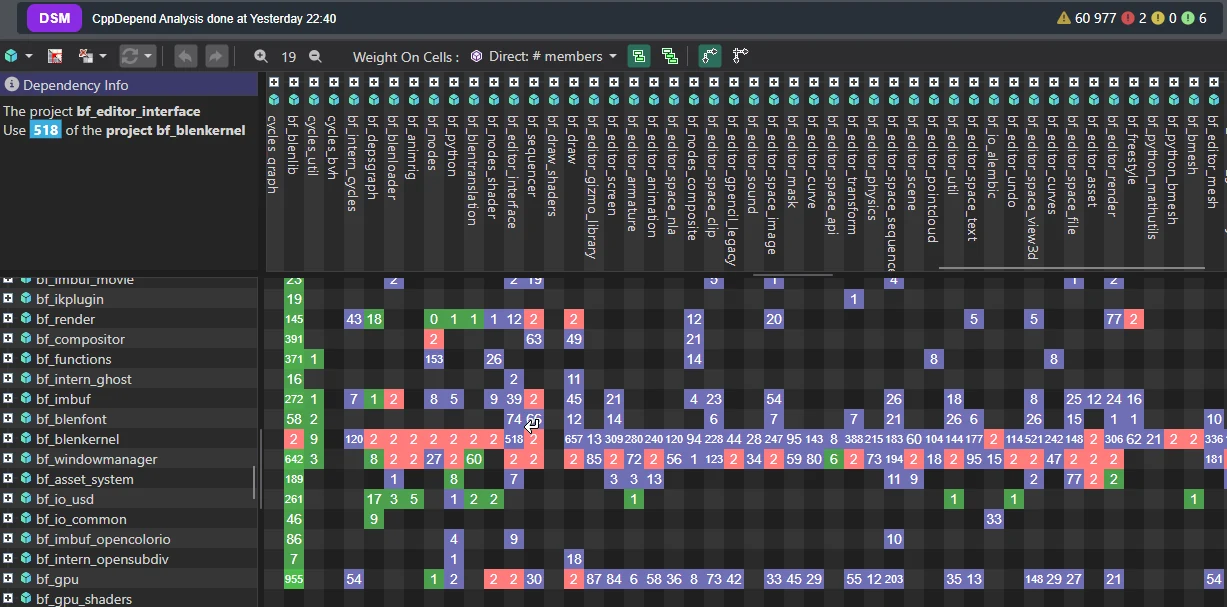
Bei der Bewertung von C++-Softwarearchitektur mit CppDepend liefert eine Dependency Structure Matrix (DSM) unbestreitbare Belege für die Gesundheit der Abhängigkeiten. In einem gut strukturierten, geschichteten System fließen Abhängigkeiten in eine Richtung — das Ergebnis ist eine saubere Dreiecksmatrix, deren Zellen nur auf einer Seite der Hauptdiagonale gefüllt sind.
Die Inspektion der Kern-Engine-Matrix von Blender offenbart jedoch ein auffälliges visuelles Muster rund um bf_blenkernel.
Wie kann ein Projekt von Weltklasse-Ingenieuren so viele Architekturzyklen aufweisen?
Die Ursache ist keine Nachlässigkeit der Entwickler. Der Übeltäter ist das veraltete Präprozessormodell von C und C++: die #include-Direktive.
Seit Jahrzehnten nutzen moderne Programmiersprachen explizite Modulsysteme, Namensräume und explizite Exportkontrollen, um Abhängigkeitsgraphen zu verwalten. C und C++ hingegen erbten ein textuelles Substitutionsmodell aus dem Präprozessor der 1970er-Jahre: die #include-Direktive.
Die größte Stärke der #include-Direktive ist zugleich ihr gefährlichster Makel: extreme Einfachheit und Flexibilität. Während die textuelle Substitution es Entwicklern erlaubt, Abhängigkeiten ohne starre Compile-Zeit-Kontrolle überall in einer Codebasis einzuziehen, wird diese uneingeschränkte Freiheit mit wachsendem Projekt schnell zur Falle. Ohne strenge architektonische Überwachung macht es #include mühelos möglich, subtile Abhängigkeitszyklen einzuführen, die Module lautlos zu einem einzigen, eng gekoppelten Monolithen verweben. In großen C++-Projekten summieren sich diese zirkulären Header-Verknüpfungen im Laufe der Zeit zu massiver technischer Schuld — sie erhöhen die Build-Zeiten exponentiell, lähmen die Unit-Test-Fähigkeit und machen Refactoring zu einem Minenfeld. Folglich ist die Pflege und Weiterentwicklung einer solchen Codebasis keine routinemäßige Ingenieursaufgabe mehr; sie erfordert ständiges, wachsames Eingreifen erfahrener Entwickler, die strukturelle Grenzen manuell durchsetzen müssen, wo der Compiler dies nicht tut.
Die strukturellen Schwächen der textuellen Inclusion
Um zu verstehen, warum #include die Architektur beschädigt, betrachten wir, wie es mit Klassendefinitionen und Modularität interagiert.
1. Inclusion ist transitiv und undicht
Wenn FileA.h die Datei FileB.h einbindet und FileB.h wiederum FileC.h, hängt FileA.h indirekt von FileC.h ab. Die internen Details von FileB sickern in FileA durch. Mit der Zeit verlieren Entwickler den Überblick darüber, wovon ein Modul tatsächlich abhängt — es entsteht ein Netz impliziter, versteckter Abhängigkeiten.
2. Physische Struktur diktiert die logische Architektur
In einem sauberen Design bestimmen Schnittstellengrenzen die Abhängigkeiten. Mit #include erzwingt die physische Dateiorganisation strukturelle Entscheidungen. Benötigt Klasse A ein einzelnes Enum aus B.h, muss A die Datei B.h einbinden — und zieht damit jeden anderen Typ, Zeiger und Template-Header mit, auf den B.h angewiesen ist.
3. Zirkuläre Abhängigkeiten werden durch physische Notwendigkeit erzwungen
Da C++ vollständige Typdefinitionen benötigt, um Speicherlayout-Größen zu bestimmen, setzen Entwickler häufig #include-Direktiven in Header-Dateien, wo Vorwärtsdeklarationen (class X;) genügt hätten. Sobald zwei Header die vollständigen Definitionen des jeweils anderen benötigen, erzeugt der Präprozessor eine zirkuläre Inclusion-Schleife — mit fehlenden Typfehlern, Include-Guard-Tricks oder fragiler Header-Reihenfolge als Folge.
Deep Dive: Der bf_blenkernel ↔ bf_bmesh Zyklus
Ein Beispiel dafür, wie #include-Mechaniken strukturelle Abhängigkeitsschleifen in Blender erzeugen, existiert zwischen dem Kernmodul (bf_blenkernel) und dem Mesh-Editing-System (bf_bmesh).
In einer sauberen, geschichteten Architektur sollte bf_bmesh (das höher angesiedelte, interaktive Editing-System) von bf_blenkernel (den tieferen Datenstrukturen und dem Mathe-Kernel) abhängen. Da #include-Direktiven es jedoch leicht machen, Grenzen ohne strukturelle Kontrolle zu überschreiten, referenziert bf_blenkernel direkt BMesh-Datenstrukturen.
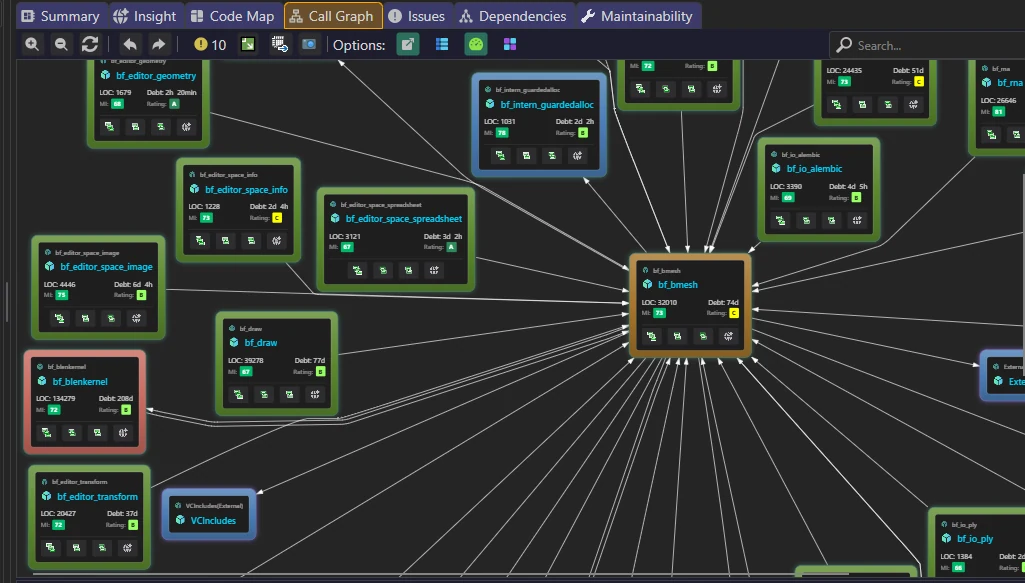
Der Call Graph für bf_bmesh zeigt eine bemerkenswert saubere, geschichtete Architektur — farbcodiert mit Abhängigkeiten (genutzte Module) in Blau und Dependents (nutzende Module) in Grün — mit der nennenswerten Ausnahme eines bidirektionalen Zyklus mit bf_blenkernel.
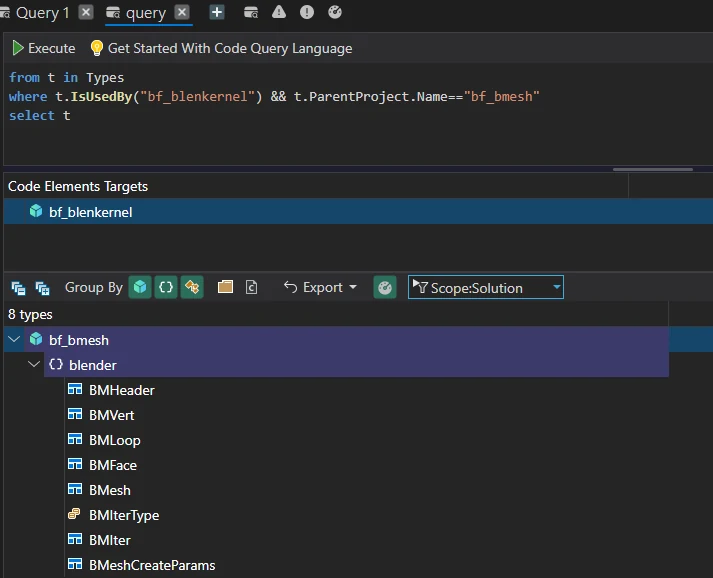
Um die exakten Typen und Methoden zu isolieren, die der Kernel aus dem Mesh-Editing-Modul nutzt, führen wir folgende CQLinq-Abfrage aus:
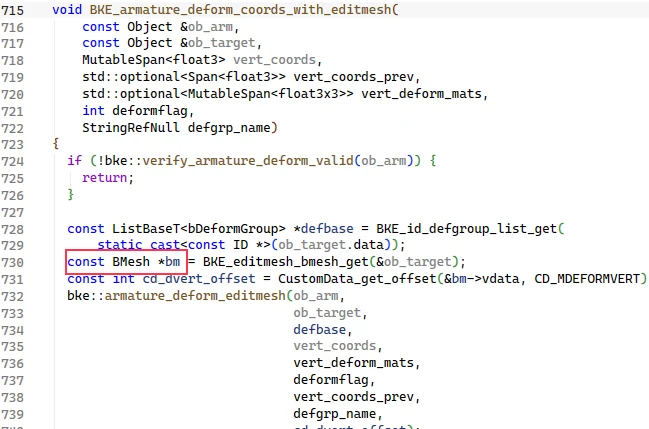
Sehen wir uns beispielsweise das BMesh-Struct an, das von dieser Funktion innerhalb von bf_blenkernel (armature.cc) verwendet wird:
Warum dies einen Architekturzyklus erzeugt
- Direkte Nutzung konkreter Typen: Die Kernel-Funktion ruft
BKE_editmesh_bmesh_get(...)auf, um einen Zeiger aufconst BMesh *bmzu erhalten, und greift direkt aufbm->vdatazu. - Erzwungene Header-Inclusion: Um auf das interne Mitglied
bm->vdatazuzugreifen, MUSS die Kernel-Datei"bmesh.h"(oder"bmesh_class.h") einbinden. - Die inverse Abhängigkeit: Gleichzeitig binden
bf_bmesh-Header und -Quelldateien Kernel-Header (BKE_*.h) ein — für grundlegende Datentypen (Object,ID,CustomData), Speicherverwaltung und Mathe-Helfer.
Das bildet einen harten bidirektionalen Abhängigkeitszyklus. bf_blenkernel kann nicht unabhängig von bf_bmesh kompiliert, im Unit-Test geprüft oder wiederverwendet werden.
Wie man refactort und den Zyklus aufbricht
Um diesen Zyklus aufzubrechen und eine saubere unidirektionale Hierarchie durchzusetzen (bf_bmesh → bf_blenkernel), muss die Abhängigkeit von BMesh innerhalb des Kernels invertiert oder abstrahiert werden.
Lösung 1: Opake Abstraktion / CustomData-Offset-Extraktion
Beachten Sie, dass BKE_armature_deform_coords_with_editmesh nur auf bm->vdata zugreift, um einen einzelnen int-Offset zu extrahieren: cd_dvert_offset. Innerhalb dieses Wrappers finden keine echten Mesh-Topologie-Manipulationen statt.
Anstatt ein BMesh* im blenkernel zu übergeben oder abzurufen, übergibt man den cd_dvert_offset direkt an die Kernel-Funktion — oder nutzt eine Funktionszeiger-/Callback-Abstraktion:
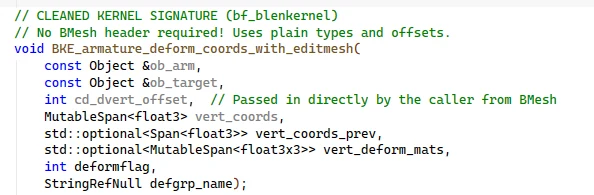
Der Aufrufer innerhalb von bf_bmesh (wo das Einbinden von bmesh.h und BKE_armature.h architektonisch zulässig ist) extrahiert den cd_dvert_offset und ruft den Kernel auf. bf_blenkernel muss nicht mehr wissen, dass BMesh existiert.
Lösung 2: Dependency Inversion per Callback oder Delegate
Benötigt bf_blenkernel dynamischen Zugriff auf BMesh-Daten bei komplexen Operationen, definiert man eine abstrakte Schnittstelle oder einen Funktions-Delegate im blenkernel:
// In BKE_armature.h (bf_blenkernel)
using BMeshOffsetGetter = std::function<int(const Object &ob)>;

// Die BMesh-Logik wird aus höheren Schichten injiziert,
// ohne dass blenkernel das konkrete BMesh-Layout kennt
Architektonische Strenge auf hoher Ebene: GRASP-Muster und hohe Kohäsion
Trotz der durch den C++-Präprozessormechanismus eingeführten Abhängigkeitsschleifen auf Header-Ebene ist Blenders zugrunde liegendes Code-Design außergewöhnlich gut durchdacht. Ein tieferer Blick auf die Klassenhierarchie und Modulorganisation zeigt strikte Anwendung der GRASP-Muster (General Responsibility Assignment Software Patterns) und moderner Domain-Driven-Design-Prinzipien:
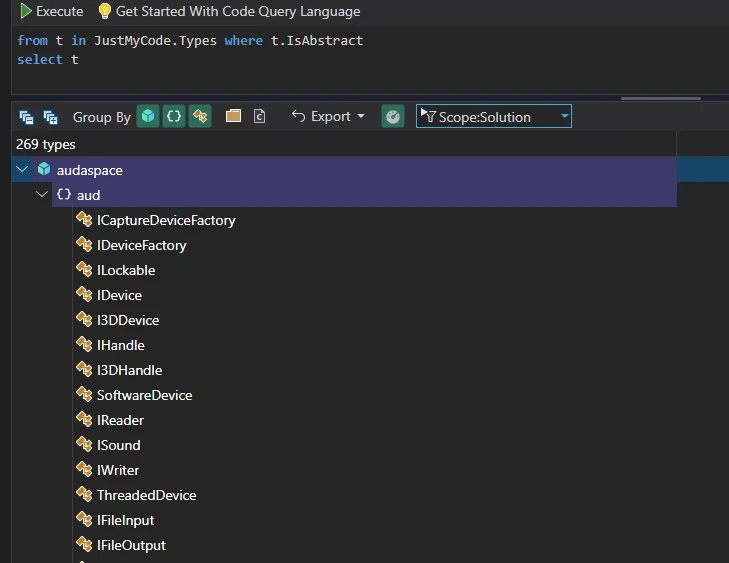
Polymorphie und Abstraktion: Blender nutzt intensiv abstrakte Schnittstellenklassen (bContext, Space-Type-Definitionen und Operator-Abstraktionen), um hochrangige Workflows von Implementierungsdetails zu entkoppeln.
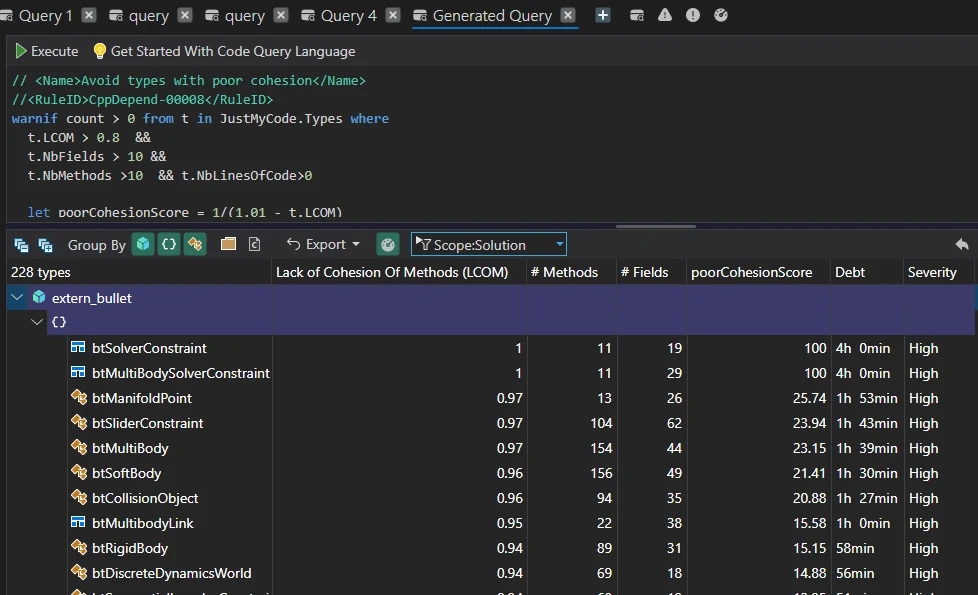
Hohe Kohäsion: Einzelne Module behalten einen scharfen Domänenfokus — bf_bmesh behandelt Low-Level-Mesh-Topologie, bf_nodes verwaltet Ausführungsgraphen und bf_gpu isoliert die Hardware-Abstraktion. Interne Datenstrukturen dieser Module zeigen hohe funktionale Kohäsion. Tatsächlich gelten weniger als 3 % der Typen als nicht kohäsiv:
Protected Variation: Kernsubsysteme isolieren sich durch wohldefinierte interne APIs gegen Plattform- und Hardware-Schwankungen und halten die untergeordnete Grafik- und OS-Abstraktion sauber.
Die Existenz zyklischer Abhängigkeiten zwischen Modulen ist kein Symptom schlampigen Designs, sondern eine unvermeidliche Nebenwirkung der Skalierung einer mehrere Millionen Zeilen umfassenden C/C++-Codebasis mit textuellen #include-Direktiven. Ohne Modulgrenzen auf Sprachebene erliegen selbst hochkohäsive, schnittstellengetriebene Architekturen irgendwann dem transitiven Header-Leakage.
Architektonische Lehren für C++-Entwickler
Der #include-Mechanismus lehrt uns eine bleibende Lektion: Wenn der Compiler keine architektonischen Grenzen durchsetzt, siegt die Entropie.
Um den architektonischen Schaden von #include in Ihren eigenen Projekten zu mindern:
- Bevorzugen Sie Vorwärtsdeklarationen: Nutzen Sie in Header-Dateien stets
class MyClass;statt#include "MyClass.h"— es sei denn, Sie erben von der Klasse oder speichern eine direkte Wertinstanz. - Setzen Sie Schichtungsregeln durch: Nutzen Sie statische Analysewerkzeuge (wie CppDepend mit CQLinq), um Quality Gates einzurichten, die Builds scheitern lassen, wenn untergeordnete Module übergeordnete Header einbinden.
- Steigen Sie auf C++20-Module um: Ersetzen Sie wo möglich
#includedurchimport— das erzwingt explizite Exporte, vermeidet Makro-Leakage und beseitigt textuelle Inclusion-Zyklen vollständig.