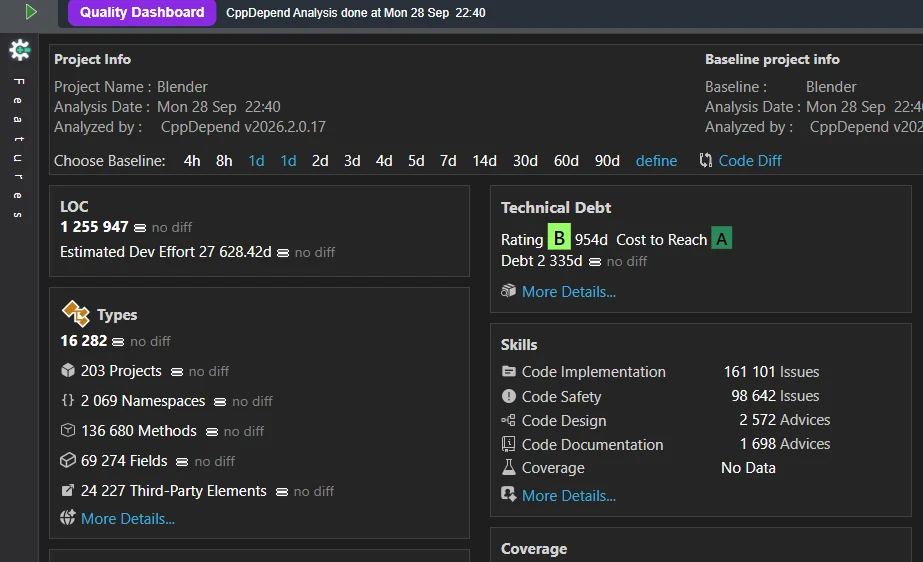
Blender est l’une des suites 3D open source haute performance les plus abouties au monde. Une analyse CppDepend de ses modules cœur révèle une note globale de maintenabilité étonnamment forte — un exploit remarquable pour une codebase massive de plus de 16 000 types et 136 000 méthodes.
Cependant, lorsqu’on inspecte les relations structurelles entre ses modules cœur, la Dependency Structure Matrix (DSM) brosse un tableau bien plus complexe, révélant des cycles de dépendances généralisés :
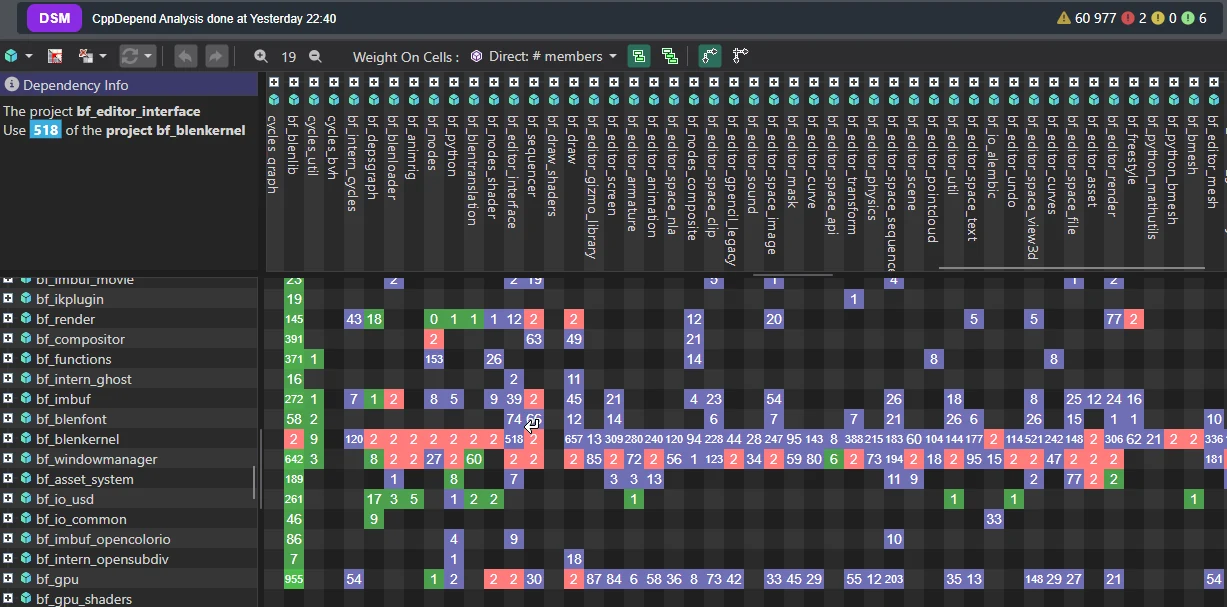
Lorsqu’on évalue l’architecture d’un logiciel C++ avec CppDepend, une Dependency Structure Matrix (DSM) fournit une preuve irréfutable de la santé des dépendances. Dans un système bien structuré et en couches, les dépendances circulent dans un seul sens — ce qui produit une matrice triangulaire propre, avec des cellules remplies d’un seul côté de la diagonale principale.
Or, l’inspection de la matrice du moteur cœur de Blender révèle un motif visuel frappant autour de bf_blenkernel.
Comment un projet construit par des ingénieurs de classe mondiale peut-il accumuler autant de cycles architecturaux ?
La cause n’est pas la négligence des développeurs. Le coupable, c’est le modèle de préprocesseur hérité de C et C++ : la directive #include.
Depuis des décennies, les langages modernes utilisent des systèmes de modules explicites, des espaces de noms et des contrôles d’export pour gérer les graphes de dépendances. C et C++, eux, ont hérité un modèle de substitution textuelle venu du préprocesseur des années 1970 : la directive #include.
La plus grande force de #include est aussi son défaut le plus dangereux : une simplicité et une flexibilité extrêmes. Si la substitution textuelle permet d’importer des dépendances n’importe où dans une codebase sans contrôle strict à la compilation, cette liberté sans limites devient vite un piège à mesure que le projet grandit. Sans supervision architecturale rigoureuse, #include rend trivial l’introduction de cycles de dépendances subtils qui tissent silencieusement les modules en un monolithe unique et fortement couplé. Dans les grands projets C++, ces liens circulaires entre headers s’accumulent en une dette technique massive — faisant exploser les temps de build, paralysant les tests unitaires et transformant le refactoring en champ de mines. Dès lors, maintenir et faire évoluer une telle codebase n’est plus une tâche d’ingénierie routinière : cela exige l’intervention constante et vigilante de développeurs seniors qui doivent faire respecter manuellement les frontières structurelles là où le compilateur échoue à le faire.
Les défauts structurels de l’inclusion textuelle
Pour comprendre pourquoi #include endommage l’architecture, regardons comment il interagit avec les définitions de classes et la modularité.
1. L’inclusion est transitive et fuit
Quand FileA.h inclut FileB.h, et que FileB.h inclut FileC.h, FileA.h dépend indirectement de FileC.h. Les détails internes de FileB fuient dans FileA. Avec le temps, les développeurs perdent la trace de ce dont un module dépend réellement, créant un réseau de dépendances implicites et cachées.
2. La structure physique dicte l’architecture logique
Dans une conception propre, les frontières d’interfaces dictent les dépendances. Avec #include, c’est l’organisation physique des fichiers qui force les décisions structurelles. Si la classe A a besoin d’une seule enum définie dans B.h, A doit inclure B.h — et embarque avec elle tous les autres types, pointeurs et headers de templates dont B.h dépend.
3. Les dépendances circulaires sont imposées par un besoin physique
Comme C++ exige les définitions complètes des types pour déterminer les tailles de layout, les développeurs placent fréquemment des directives #include dans les headers là où des déclarations anticipées (class X;) auraient suffi. Dès que deux headers ont besoin des définitions complètes l’un de l’autre, le préprocesseur crée une boucle d’inclusion circulaire — synonyme d’erreurs de types manquants, d’astuces de guards ou d’ordonnancement fragile des headers.
Plongée : le cycle bf_blenkernel ↔ bf_bmesh
Blender illustre parfaitement comment la mécanique de #include crée des boucles de dépendances structurelles, entre le module kernel cœur (bf_blenkernel) et le système d’édition de maillage (bf_bmesh).
Dans une architecture propre et en couches, bf_bmesh (le système d’édition interactif de haut niveau) devrait dépendre de bf_blenkernel (les structures de données et le noyau mathématique de bas niveau). Mais comme les directives #include facilitent le franchissement des frontières sans contrôle structurel, bf_blenkernel référence directement les structures de données BMesh.
Le graphe d’appel de bf_bmesh montre une architecture en couches remarquablement propre — avec un code couleur distinct : dépendances (modules utilisés) en bleu et dépendants (modules utilisateurs) en vert — à l’exception notable d’un cycle bidirectionnel avec bf_blenkernel.
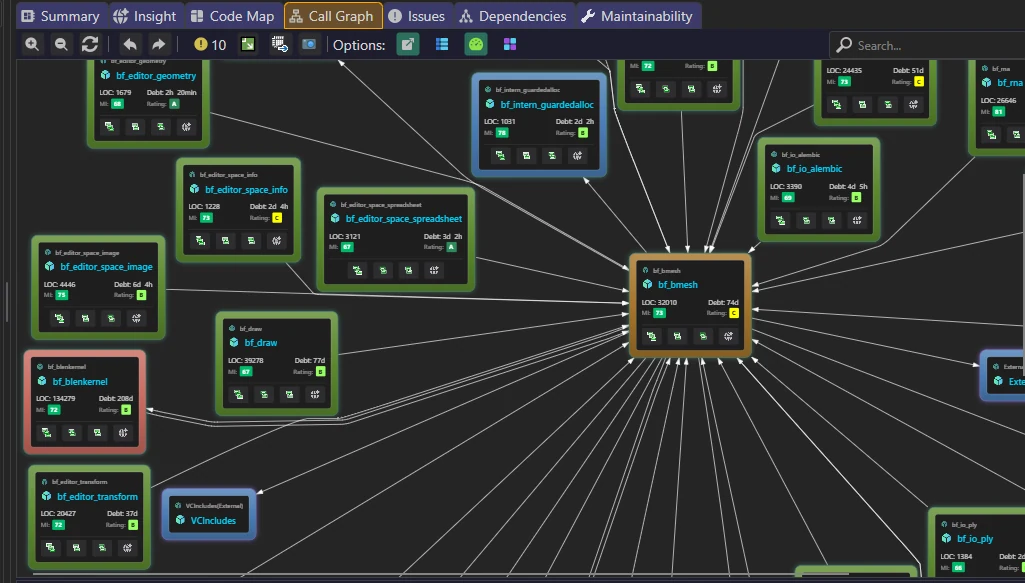
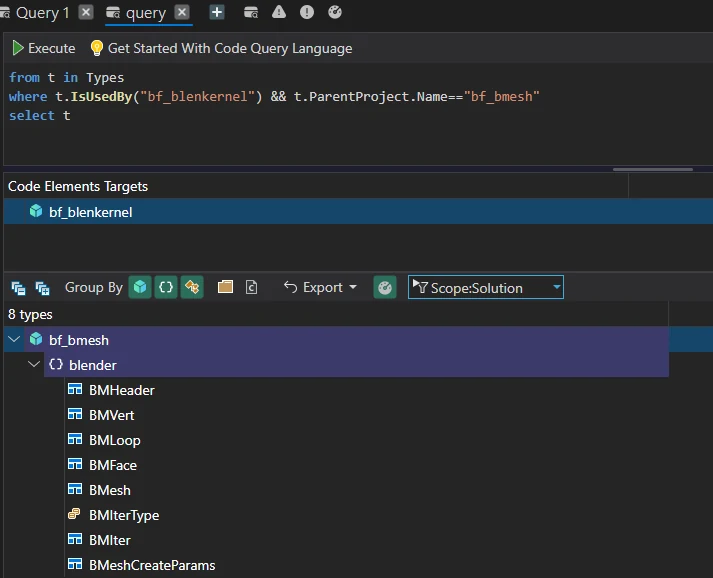
Pour isoler les types et méthodes exacts que le kernel consomme depuis le module d’édition de maillage, exécutons la requête CQLinq suivante :
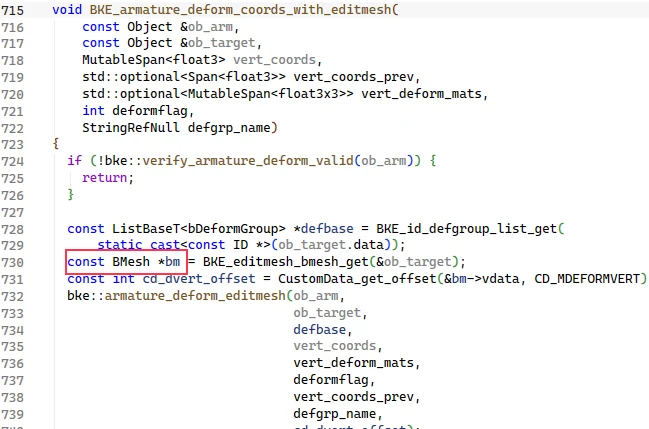
Regardons par exemple la struct BMesh utilisée par cette fonction dans bf_blenkernel (armature.cc) :
Pourquoi cela crée un cycle architectural
- Utilisation directe d’un type concret : la fonction kernel appelle
BKE_editmesh_bmesh_get(...)pour obtenir un pointeur versconst BMesh *bmet accède directement àbm->vdata. - Inclusion de header forcée : pour accéder au membre interne
bm->vdata, le fichier kernel DOIT inclure"bmesh.h"(ou"bmesh_class.h"). - La dépendance inverse : simultanément, les headers et sources de
bf_bmeshincluent les headers du kernel (BKE_*.h) pour les types de base (Object,ID,CustomData), la gestion mémoire et les helpers mathématiques.
Cela forme un cycle de dépendances bidirectionnel dur. bf_blenkernel ne peut être ni compilé, ni testé unitairement, ni réutilisé indépendamment de bf_bmesh.
Comment refactorer et briser le cycle
Pour briser ce cycle et imposer une hiérarchie unidirectionnelle propre (bf_bmesh → bf_blenkernel), la dépendance à BMesh à l’intérieur du kernel doit être inversée ou abstraite.
Solution 1 : abstraction opaque / extraction de l’offset CustomData
Remarquez que BKE_armature_deform_coords_with_editmesh n’accède à bm->vdata que pour extraire un seul offset int : cd_dvert_offset. Ce wrapper n’effectue aucune manipulation réelle de la topologie du maillage.
Au lieu de passer ou récupérer un BMesh* dans blenkernel, passez directement le cd_dvert_offset à la fonction kernel, ou utilisez une abstraction par pointeur de fonction / callback :
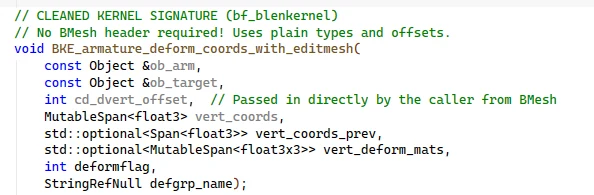
L’appelant dans bf_bmesh (où inclure à la fois bmesh.h et BKE_armature.h est architecturalement valide) extrait le cd_dvert_offset et appelle le kernel. bf_blenkernel n’a plus besoin de savoir que BMesh existe.
Solution 2 : inversion de dépendance via callback ou délégué
Si bf_blenkernel a besoin d’un accès dynamique aux données BMesh lors d’opérations complexes, définissez une interface abstraite ou un délégué de fonction dans blenkernel :
// Dans BKE_armature.h (bf_blenkernel)
using BMeshOffsetGetter = std::function<int(const Object &ob)>;

// La logique BMesh est injectée depuis les couches supérieures
// sans que blenkernel connaisse le layout concret de BMesh
Rigueur architecturale de haut niveau : patterns GRASP et forte cohésion
Malgré les boucles de dépendances de headers introduites par le mécanisme de préprocesseur du C++, la conception du code de Blender est exceptionnellement bien ingénierée. Un regard approfondi sur sa hiérarchie de classes et son organisation en modules montre une adhésion stricte aux patterns GRASP (General Responsibility Assignment Software Patterns) et aux principes modernes de domain-driven design :
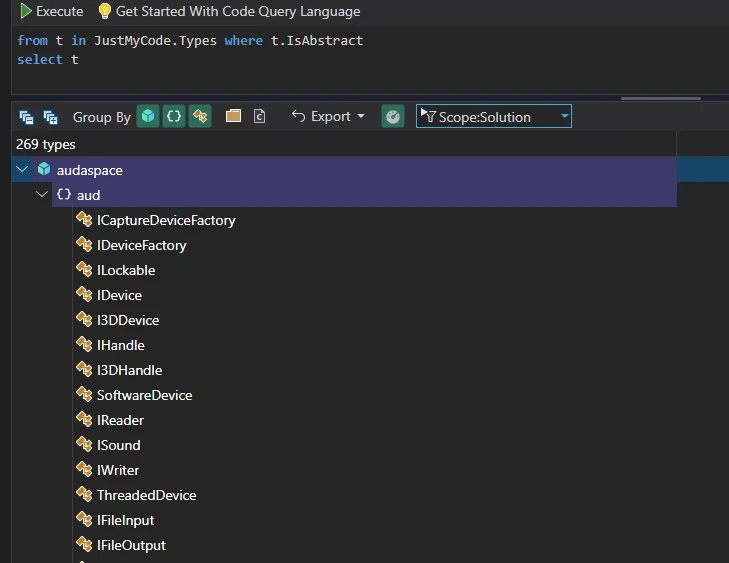
Polymorphisme et abstraction : Blender fait un usage intensif de classes d’interfaces abstraites (bContext, définitions de space types et abstractions d’opérateurs) pour découpler les workflows de haut niveau des détails d’implémentation.
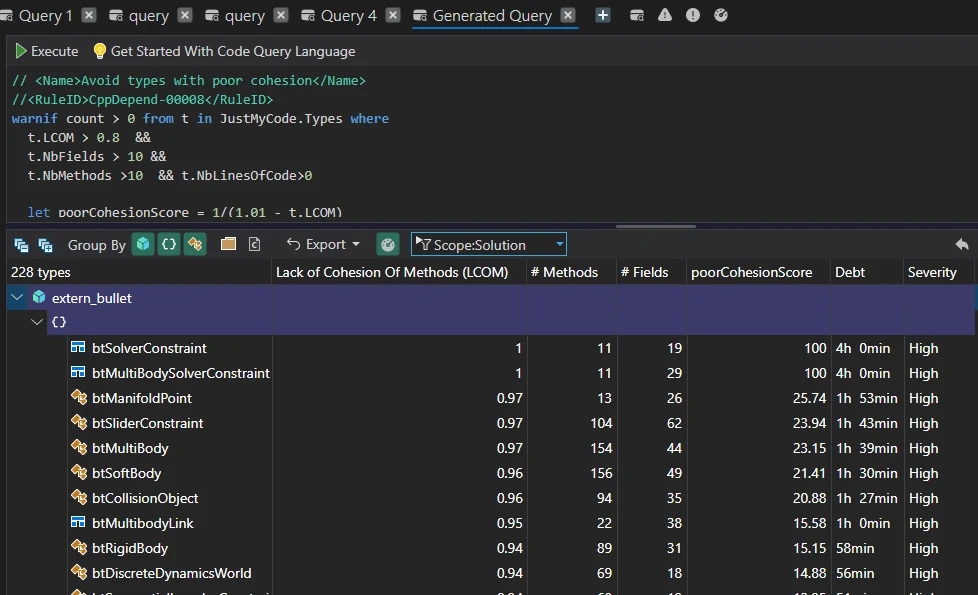
Forte cohésion : chaque module garde un focus métier net — bf_bmesh gère la topologie de maillage bas niveau, bf_nodes pilote les graphes d’exécution et bf_gpu isole l’abstraction matérielle. Les structures de données internes de ces modules démontrent une forte cohésion fonctionnelle. En fait, moins de 3 % des types sont considérés comme non cohésifs :
Protected Variation : les sous-systèmes cœur s’isolent des variations de plateforme et de matériel via des APIs internes bien définies, gardant l’abstraction graphique et OS de bas niveau propre.
La présence de dépendances cycliques entre modules n’est pas le symptôme d’une conception bâclée, mais un effet secondaire inévitable de la mise à l’échelle d’une codebase C/C++ de plusieurs millions de lignes avec des directives #include textuelles. Sans frontières de modules au niveau du langage, même les architectures très cohésives et pilotées par interfaces finissent par succomber aux fuites transitives de headers.
Leçons architecturales pour les développeurs C++
Le mécanisme de #include nous enseigne une leçon durable : quand le compilateur ne fait pas respecter les frontières architecturales, l’entropie gagne.
Pour limiter les dégâts architecturaux de #include dans vos propres projets :
- Préférez les déclarations anticipées : dans les headers, utilisez toujours
class MyClass;plutôt que#include "MyClass.h", sauf en cas d’héritage ou de stockage d’une instance par valeur. - Faites respecter les règles de couches : utilisez des outils d’analyse statique (comme CppDepend avec CQLinq) pour mettre en place des quality gates qui font échouer le build si des modules de bas niveau incluent des headers de haut niveau.
- Migrez vers les modules C++20 : remplacez
#includeparimportdès que possible — cela impose des exports explicites, évite les fuites de macros et élimine entièrement les cycles d’inclusion textuelle.