
DiePOCO C++Bibliotheken sind eine Sammlung von Open-Source-Klassenbibliotheken zur Entwicklung netzwerkzentrierter, portabler Anwendungen in C++.
POCO steht für POrtable COmponents. Die Bibliotheken decken Funktionen wie Threads, Thread-Synchronisierung, Dateisystemzugriff, Streams, Shared Libraries und das Laden von Klassen, Sockets und Netzwerkprotokolle (HTTP, FTP, SMTP usw.) ab. Außerdem enthalten sie einen HTTP-Server, einen XML-Parser mit SAX2- und DOM-Schnittstellen sowie den Zugriff auf SQL-Datenbanken.
Dank ihres modularen und effizienten Designs und ihrer Implementierung eignen sich die POCO-C++-Bibliotheken sehr gut für die Embedded-Entwicklung.
Sehen wir uns einen Codeausschnitt aus dem POCO-Quellcode an:
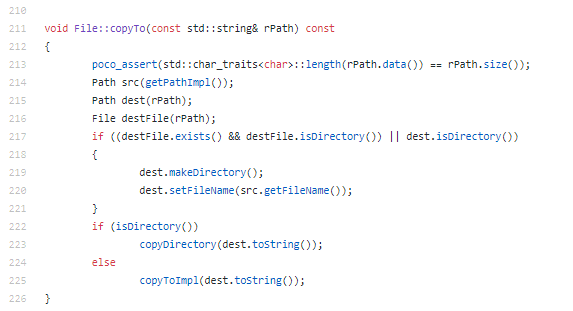
Diese Implementierung zeichnet sich durch Folgendes aus:
- Die Funktion hat nur wenige Parameter.
- Assertions werden verwendet, um die Gültigkeit der Eingaben zu überprüfen.
- Die Benennung der Variablen ist leicht verständlich.
- Die Methode ist kurz.
- Im Funktionskörper gibt es keine unnötigen Kommentare: Der Code spricht für sich selbst.
- Der Funktionskörper ist sauber eingerückt.
- Wo es sinnvoll ist, wird die bewährte STL verwendet.
Beim Durchgehen des POCO-Quellcodes fällt die Konsistenz der Implementierung auf: Für jede Funktion werden dieselben Best-Practice-Regeln angewendet.
Werfen wir mitCppDepend einen Blick in POCO und untersuchen einige Aspekte seines Designs und seiner Implementierung.
DESIGN
ABSTRAKTHEIT VS. INSTABILITÄT
Robert C. Martin schrieb einen interessantenArtikelüber eine Reihe von Metriken, mit denen sich die Qualität eines objektorientierten Designs anhand der Abhängigkeiten zwischen seinen Subsystemen messen lässt.
Dort schreibt er über die Abhängigkeiten zwischen Modulen:
Was macht ein Design starr, fragil und schwer wiederverwendbar? Es sind die gegenseitigen Abhängigkeiten der Subsysteme innerhalb dieses Designs. Ein Design ist starr, wenn es sich nicht leicht ändern lässt. Diese Starrheit entsteht dadurch, dass eine einzelne Änderung an stark voneinander abhängiger Software eine Kaskade von Änderungen in abhängigen Modulen auslöst. Wenn Designer oder Wartungsverantwortliche das Ausmaß dieser Änderungskaskade nicht vorhersagen können, lässt sich auch die Auswirkung der Änderung nicht abschätzen. Damit werden auch ihre Kosten unvorhersehbar. Angesichts dieser Unsicherheit zögern Verantwortliche, Änderungen zu genehmigen. So wird das Design starr.
Um Starrheit entgegenzuwirken, führt er Metriken wie afferente Kopplung, efferente Kopplung, Abstraktheit, Instabilität, die „Distanz zur Hauptsequenz“ sowie das Diagramm „Abstraktheit vs. Instabilität“ ein.
Das Diagramm „Abstraktheit vs. Instabilität“ kann dabei helfen, Projekte zu erkennen, die schwer zu warten und weiterzuentwickeln sind. Hier ist dieses Diagramm für die POCO-Bibliothek:

Die Idee hinter diesem Diagramm lautet: Je häufiger ein Codeelement eines Programms verwendet wird, desto abstrakter sollte es sein. Anders gesagt: Vermeiden Sie zu direkte Abhängigkeiten von Implementierungen und setzen Sie stattdessen auf Abstraktionen. Mit einem häufig verwendeten Codeelement ist hier ein Projekt gemeint (das Prinzip gilt ebenso für Pakete und Typen), das von vielen anderen Projekten im Programm genutzt wird. Weit verbreitete konkrete Typen in einer Codebasis sind problematisch. Dadurch entstehen sogenannte „Zones of Pain“, in denen Änderungen an Implementierungen potenziell große Teile des Programms beeinflussen. Zudem ändern sich Implementierungen erfahrungsgemäß häufiger als Abstraktionen.
Die gestrichelte Hauptsequenz im obigen Diagramm zeigt, wie Abstraktheit und Instabilität ausbalanciert sein sollten. Eine stabile Komponente befindet sich auf der linken Seite. An der Hauptsequenz lässt sich erkennen, dass eine solche Komponente sehr abstrakt sein sollte, um nahe an der gewünschten Linie zu liegen. Ist ihr Abstraktionsgrad dagegen niedrig, befindet sie sich in einem Bereich, der als „Zone of Pain“ bezeichnet wird.
Nur das Foundation-Projekt befindet sich in der „Zone of Pain“, was normal ist, da es von vielen anderen Projekten verwendet wird.
VERERBUNG
Mehrfachvererbung erhöht die Komplexität und sollte daher mit Bedacht eingesetzt werden.
Suchen wir nach allen Klassen mit vielen Basisklassen.

Die blauen Rechtecke stellen das Ergebnis dar.

Nur wenige Klassen erben von mehr als einer Klasse.
KOHÄSION VON TYPEN
Das Single-Responsibility-Prinzip besagt, dass eine Klasse nicht mehr als einen Grund für Änderungen haben sollte. Eine solche Klasse gilt als kohäsiv. Ein hoher LCOM-Wert weist im Allgemeinen auf eine geringe Kohäsion hin. Es gibt mehrere LCOM-Metriken. LCOM liegt im Bereich [0–1], LCOMHS (HS steht für Henderson-Sellers) im Bereich [0–2]. LCOMHS gilt häufig als effizienter bei der Erkennung nicht kohäsiver Typen. Ein LCOMHS-Wert über 1 sollte als Warnsignal betrachtet werden.


Nur 1 % der Typen gelten als nicht kohäsiv.
EFFERENTE KOPPLUNG
Die efferente Kopplung eines Typs entspricht der Anzahl der Typen, von denen er direkt abhängt. Typen mit TypeCe > 50 hängen von zu vielen anderen Typen ab. Sie sind komplex, übernehmen mehr als eine Verantwortung und sind gute Kandidaten für ein Refactoring.
Führen wir die folgende CQLinq-Abfrage aus.

Das Ergebnis ist leer; somit hat keine Klasse zu viele Verantwortlichkeiten.
AM HÄUFIGSTEN VERWENDETE TYPEN
Es ist hilfreich zu wissen, welche Typen am häufigsten verwendet werden. Dafür können wir die TypeRank-Metrik nutzen.
TypeRank-Werte werden berechnet, indem der Google-PageRank-Algorithmus auf den Graphen der Typabhängigkeiten angewendet wird. Anschließend wird eine Homothetie mit dem Zentrum 0,15 angewendet, sodass der durchschnittliche TypeRank 1 beträgt.
Typen mit hohem TypeRank sollten besonders sorgfältig getestet werden, da Fehler in solchen Typen wahrscheinlich schwerwiegendere Folgen haben.

Suchen wir nach den am häufigsten verwendeten und zugleich komplexen Typen.

Das Ergebnis ist leer; keine Klasse ist zugleich weit verbreitet und komplex.
SCHICHTEN UND LEVEL-METRIK
DieserBeitragerläutert die Level-Metrik und zeigt, wie sie zur Verbesserung des Designs genutzt werden kann.
Suchen wir nach Abhängigkeitszyklen. Dazu können wir die folgende CQLinq-Abfrage ausführen:


Nur wenige Methoden weisen Abhängigkeitszyklen auf. Nehmen wir das Zip-Projekt als Beispiel und betrachten seinen Abhängigkeitsgraphen.

In diesem Projekt gibt es nur einen Abhängigkeitszyklus.
POCO-Implementierung
ANZAHL DER CODEZEILEN
Methoden mit sehr vielen Codezeilen sind schwer zu verstehen und zu warten. Suchen wir nach Methoden mit mehr als 60 Zeilen.


Weniger als 1 % der Methoden haben mehr als 60 Zeilen.
ZYKLOMATISCHE KOMPLEXITÄT
Die zyklomatische Komplexität ist eine verbreitete prozedurale Softwaremetrik, die die Anzahl unabhängiger Pfade durch eine Prozedur misst.
Führen wir die folgende CQLinq-Abfrage aus, um Methoden zu erkennen, die refaktoriert werden sollten.


Somit können nur 1 % der Methoden als komplex angesehen werden.
Welche Methoden sind komplex und nicht ausreichend kommentiert?


METHODEN MIT VIELEN VARIABLEN
Methoden mit NbVariables > 8 sind schwer zu verstehen und zu warten. Methoden mit NbVariables > 15 sind extrem komplex und sollten in kleinere Methoden aufgeteilt werden, sofern sie nicht automatisch von einem Tool erzeugt wurden.


Nur 8 Methoden haben zu viele Variablen.
TYPEN MIT VIELEN METHODEN UND FELDERN


Nur 3 % der Typen haben viele Methoden.
Dieselbe Suche können wir auch für Felder durchführen.


Weniger als 1 % der Typen haben viele Felder.
Wir können daraus schließen, dass POCO gut implementiert ist: Nur wenige Methoden gelten als komplex, die Typen sind einfach und besitzen vergleichsweise wenige Methoden und Felder, und der Code ist gut kommentiert.