
Les bibliothèques POCO C++ sont une collection de bibliothèques de classes open source pour développer des applications portables, centrées sur le réseau, en C++.
POCO signifie POrtable COmponents. Les bibliothèques couvrent des fonctionnalités telles que les threads, la synchronisation des threads, l'accès au système de fichiers, les flux, les bibliothèques partagées et le chargement de classes, les sockets et les protocoles réseau (HTTP, FTP, SMTP, etc.), et incluent un serveur HTTP, ainsi qu'un parseur XML avec interfaces SAX2 et DOM et un accès aux bases de données SQL.
La conception et l'implémentation modulaires et efficaces rendent les bibliothèques POCO C++ bien adaptées au développement embarqué.
Explorons un extrait de code du code source de POCO :
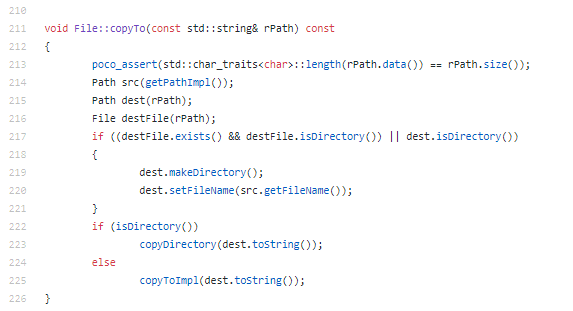
Cette implémentation se caractérise par :
- La fonction n'a que quelques paramètres.
- Des assertions sont utilisées pour vérifier que les entrées sont valides.
- Le nommage des variables est facile à comprendre.
- La méthode est courte.
- Il n'y a pas de commentaires superflus dans le corps : le code parle de lui-même.
- Le corps de la fonction est bien indenté.
- La STL, bien établie, est utilisée là où c'est approprié.
En naviguant dans le code source de POCO, on constate la cohérence de l'implémentation : les mêmes règles de bonnes pratiques sont appliquées à chaque fonction.
Regardons à l'intérieur de POCO avec CppDepend et découvrons quelques faits sur sa conception et son implémentation.
CONCEPTION
ABSTRAIT VS INSTABLE
Robert C. Martin a écrit un intéressant article sur un ensemble de métriques permettant de mesurer la qualité d'une conception orientée objet en termes d'interdépendance entre les sous-systèmes de cette conception.
Voici ce qu'il dit dans l'article à propos de l'interdépendance entre modules :
Qu'est-ce qui rend une conception rigide, fragile et difficile à réutiliser ? C'est l'interdépendance des sous-systèmes au sein de cette conception. Une conception est rigide si elle ne peut pas être facilement modifiée. Cette rigidité tient au fait qu'un seul changement dans un logiciel fortement interdépendant déclenche une cascade de changements dans les modules dépendants. Lorsque l'ampleur de cette cascade de changements ne peut pas être prédite par les concepteurs ou les mainteneurs, l'impact du changement ne peut pas être estimé. Cela rend le coût du changement impossible à estimer. Les managers, face à une telle imprévisibilité, deviennent réticents à autoriser les changements. La conception devient ainsi rigide.
Et pour lutter contre la rigidité, il introduit des métriques comme le couplage afférent, le couplage efférent, le caractère abstrait, l'instabilité, la « distance à la séquence principale » et le graphe « Abstrait vs Instable ».
Le graphe « Abstrait vs Instable » peut être utile pour identifier les projets difficiles à maintenir et à faire évoluer. Voici le graphe « Abstrait vs Instable » de la bibliothèque POCO :

L'idée derrière ce graphe est que plus un élément de code d'un programme est populaire, plus il devrait être abstrait. Autrement dit, évitez de dépendre trop directement des implémentations ; dépendez plutôt d'abstractions. Par élément de code populaire, j'entends un projet (mais l'idée fonctionne aussi pour les packages et les types) massivement utilisé par d'autres projets du programme. Ce n'est pas une bonne idée d'avoir des types concrets largement utilisés dans votre base de code. Cela crée des zones de douleur dans votre programme, où modifier les implémentations peut potentiellement affecter une grande partie du programme. Et les implémentations sont connues pour évoluer plus souvent que les abstractions.
La ligne de la séquence principale (en pointillés) dans le diagramme ci-dessus montre comment le caractère abstrait et l'instabilité devraient être équilibrés. Un composant stable serait positionné à gauche. Si vous regardez la séquence principale, vous pouvez voir qu'un tel composant devrait être très abstrait pour être proche de la ligne souhaitable — en revanche, si son niveau d'abstraction est faible, il est positionné dans une zone appelée la « zone de douleur ».
Seul le projet Foundation se trouve dans la zone de douleur, ce qui est normal car il est largement utilisé par les autres projets.
HÉRITAGE
L'héritage multiple augmente la complexité, il doit donc être utilisé avec prudence.
Recherchons toutes les classes ayant de nombreuses classes de base.

Les rectangles bleus représentent le résultat.

Seules quelques classes dérivent de plus d’une classe.
COHÉSION DES TYPES
Le principe de responsabilité unique stipule qu'une classe ne devrait pas avoir plus d'une raison de changer. Une telle classe est dite cohésive. Une valeur LCOM élevée signale généralement une classe peu cohésive. Il existe plusieurs métriques LCOM. LCOM prend ses valeurs dans l'intervalle [0-1]. LCOMHS (HS pour Henderson-Sellers) prend ses valeurs dans l'intervalle [0-2]. Notez que la métrique LCOMHS est souvent considérée comme plus efficace pour détecter les types non cohésifs. Une valeur LCOMHS supérieure à 1 devrait être considérée comme alarmante.


Seulement 1 % des types sont considérés comme non cohésifs.
COUPLAGE EFFÉRENT
Le couplage efférent d'un type particulier est le nombre de types dont il dépend directement. Les types pour lesquels TypeCe > 50 dépendent de trop d'autres types. Ils sont complexes et ont plus d'une responsabilité. Ce sont de bons candidats pour une refactorisation.
Exécutons la requête CQLinq suivante.

Et le résultat est vide, donc aucune classe n'a trop de responsabilités.
LES TYPES LES PLUS UTILISÉS
Il est utile de savoir quels types sont les plus fréquemment utilisés ; pour cela, nous pouvons utiliser la métrique TypeRank.
Les valeurs TypeRank sont calculées en appliquant l'algorithme Google PageRank au graphe des dépendances entre types. Une homothétie de centre 0,15 est appliquée pour que la moyenne des TypeRank soit de 1.
Les types avec un TypeRank élevé devraient être testés avec plus de soin, car les bugs y sont susceptibles d’être plus catastrophiques.

Recherchons les types les plus utilisés et les plus complexes.

Le résultat est vide, donc aucune classe n'est à la fois largement utilisée et complexe.
STRATIFICATION ET MÉTRIQUE LEVEL
Cet article explique la métrique Level et comment l'exploiter pour améliorer la conception.
Recherchons les cycles de dépendances ; pour cela, nous pouvons exécuter la requête CQLinq suivante :


Seules quelques méthodes ont des cycles de dépendances ; prenons le projet Zip comme exemple et regardons son graphe de dépendances.

Un seul cycle de dépendances existe dans ce projet.
Implémentation de POCO
NOMBRE DE LIGNES DE CODE
Les méthodes avec un grand nombre de lignes de code sont difficiles à comprendre et à maintenir ; recherchons les méthodes de plus de 60 lignes.


Moins de 1 % des méthodes ont plus de 60 lignes.
COMPLEXITÉ CYCLOMATIQUE
La complexité cyclomatique est une métrique logicielle procédurale populaire qui mesure le nombre de chemins indépendants à travers une procédure.
Exécutons la requête CQLinq suivante pour détecter les méthodes à refactoriser.


Donc seulement 1 % des méthodes peuvent être considérées comme complexes.
Quelles méthodes sont complexes et pas assez commentées ?


MÉTHODES AVEC BEAUCOUP DE VARIABLES
Les méthodes où NbVariables est supérieur à 8 sont difficiles à comprendre et à maintenir. Les méthodes où NbVariables est supérieur à 15 sont extrêmement complexes et devraient être scindées en méthodes plus petites (sauf si elles sont générées automatiquement par un outil).


Seules 8 méthodes ont trop de variables.
TYPES AVEC BEAUCOUP DE MÉTHODES ET DE CHAMPS


Seulement 3 % des types ont beaucoup de méthodes.
Et nous pouvons faire la même recherche pour les champs.


Moins de 1 % des types ont beaucoup de champs.
Nous pouvons conclure que POCO est bien implémenté : peu de méthodes sont considérées comme complexes, ses types sont simples et ont relativement peu de méthodes et de champs, et le code est bien commenté.