
Kopplung wird üblicherweise der Kohäsion gegenübergestellt. Eine geringe Kopplung geht häufig mit einer hohen Kohäsion einher – und umgekehrt. Geringe Kopplung ist oft ein Zeichen für ein gut strukturiertes Computersystem und ein gutes Design. In Verbindung mit hoher Kohäsion unterstützt sie die allgemeinen Ziele einer hohen Lesbarkeit und Wartbarkeit. Diese Fallstudie zeigt die Vorteile loser Kopplung und hoher Kohäsion und wie sich beides in C++ erreichen lässt. Dazu entwerfen wir eine Anwendung, die Daten aus einer Datei liest, verarbeitet und das Ergebnis in eine Ausgabedatei schreibt.
Eine schlecht entworfene Lösung
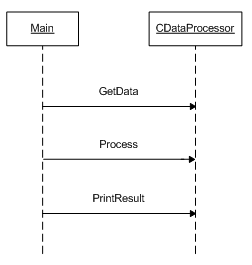
In diesem ersten Entwurf wird nur eine Klasse namens CDataProcessor verwendet, um:
- Daten aus einer Datei einzulesen.
- Die Daten zu verarbeiten.
- Das Ergebnis auszugeben.
Die main-Methode ruft anschließend die Methoden dieser Klasse auf.
Nachteile dieser Lösung
- Geringe Kohäsion: Die
CDataProcessorKlasse hat viele Verantwortlichkeiten, sodass sich der Algorithmus nicht ohne Weiteres in anderen Anwendungen wiederverwenden lässt. - Hohe Kopplung: Die Verarbeitungslogik ist eng an die Konsole und den Datenprovider gekoppelt.
Refactoring des Designs
Hohe Kohäsion
Um die Kohäsion zu erhöhen, sollte jede Verantwortlichkeit einer eigenen Klasse zugewiesen werden. Wir benötigen daher drei Klassen:
CFileProvider: Liest Daten aus einer Datei.CDataProcessing: Verarbeitet die Daten. Diese Klasse könnte für die Verarbeitung weitere Klassen verwenden; für unser Beispiel halten wir den Entwurf jedoch bewusst einfach.CResultReporting: Schreibt das Ergebnis in eine Datei.
Jede Klasse hat nun genau eine Verantwortlichkeit. Dieser Entwurf bietet folgende Vorteile:
- Die Klassen sind leichter zu verstehen.
- Der Code ist leichter zu warten.
- Die Klassen lassen sich leichter in anderen Anwendungen wiederverwenden.
Geringe Kopplung
Was passiert, wenn die Daten statt in einer Datei in einer Datenbank gespeichert sind? In unserem bisherigen Entwurf ist die Anwendung eng an einen Dateiprovider gekoppelt.
Um dieses Problem zu lösen, benötigen wir eine Schnittstelle mit Methoden zum Abrufen von Daten aus beliebigen Quellen. Für dateibasierte Daten brauchen wir anschließend eine Klasse, die diese Schnittstelle implementiert.
Für diesen Zweck kann die Verwendung von NVI eine gute Lösung sein. Dieses Muster bietet gegenüber der alleinigen Verwendung abstrakter Klassen den Vorteil, dass Vor- und Nachbedingungen definiert werden können. Besonders während der Entwicklung ist dies eine nützliche Technik der objektorientierten Programmierung. Vor- und Nachbedingungen stellen sicher, dass die Invarianten einer Klassenhierarchie – und allgemein einer Abstraktion – an festgelegten Punkten der Programmausführung nicht verletzt werden.
In unserem Fall können wir die IDataProvider Schnittstelle hinzufügen.
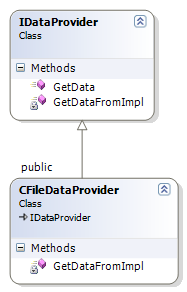
And CFileProvider erbt von IDataProvider zur Implementierung von GetDataFromImpl, and the same design can be used for CDataProcessing and CReportResult.
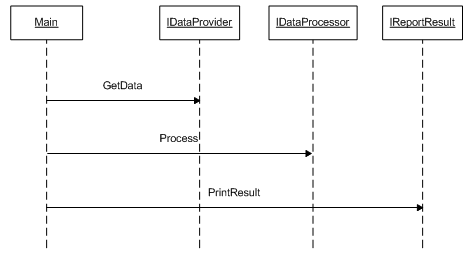
So sieht die Zusammenarbeit der Klassen nach dem Refactoring aus:
Klassen-Factory
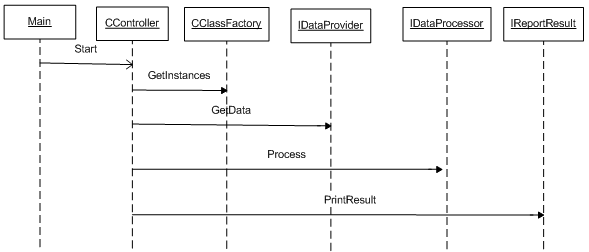
Im überarbeiteten Entwurf werden die konkreten Instanzen von IDataProvider, IDataProcessingund IReportResult von der main-Methode erzeugt. Besser ist es, diese Verantwortlichkeit einer Factory-Klasse zuzuweisen und damit die Logik zur Instanziierung der benötigten Objektfamilie zu kapseln.
Controller
Die Orchestrierung aller Klassen ist in der main-Methode implementiert. Sinnvoller ist es, diese Verantwortlichkeit einer Controller-Klasse zuzuweisen, damit sie auch in anderen Anwendungen wiederverwendet werden kann.
Der Controller muss mit drei Klassen interagieren. Damit stellt sich die Frage: Wie binden wir diese Instanzen an den Controller?
Dafür gibt es zwei mögliche Ansätze:
- Eine Methode namens
BindInstances(IDataProviderPtr,IDataProcesingPtr,IReportResultPtr). - Den Controller als Template definieren; er wird dann wie folgt instanziiert:
CController<CFileProvider,CDataProcessor,CConsoleReport>Der Unterschied zwischen den beiden Lösungen besteht darin, dass beim ersten Ansatz jeder Datenprovider von IDataProvider, and for the second one, CFileProvider lediglich die Methode GetData(Data&) benötigt, selbst wenn die Klasse von einer anderen Klasse als IDataProvider.
Unter C++-Experten wird viel darüber diskutiert, ob OOP oder Templates verwendet werden sollten. Hier ist ein guter Artikel über das Spannungsfeld zwischen diesen beiden Ansätzen.
So sieht die neue Zusammenarbeit der Klassen nach dem Refactoring aus:
Vorteile des Refactorings
Nach dem Refactoring ist die Anwendung flexibler und kann in unterschiedlichen Szenarien eingesetzt werden:
- Sie kann Daten aus einer Datei, einer Datenbank, einer XML-Datei, einer CSV-Datei usw. beziehen.
- Sie kann Daten mit unterschiedlichen Klassen verarbeiten, nicht nur mit einer einzigen.
- Sie kann Ergebnisse auf der Konsole, in einer Datei usw. ausgeben.