
Le couplage s'oppose généralement à la cohésion. Un faible couplage va souvent de pair avec une forte cohésion, et inversement. Un faible couplage est souvent le signe d'un système bien structuré et d'une bonne conception, et lorsqu'il est combiné à une forte cohésion, il sert les objectifs généraux de lisibilité et de maintenabilité. L'objectif de cette étude de cas est de démontrer les avantages d'un couplage faible et d'une cohésion forte, et la manière de les atteindre en C++. L'étude de cas porte sur la conception d'une application qui lit des données depuis un fichier, les traite et écrit le résultat dans un fichier de sortie.
Une solution mal conçue
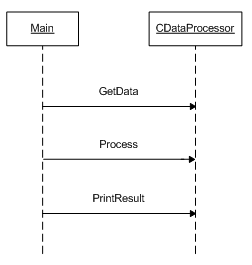
Dans cette première conception, une seule classe, nommée CDataProcessor est utilisée pour :
- Obtenir les données depuis un fichier.
- Traiter les données.
- Afficher le résultat.
Et la méthode principale invoque les méthodes de cette classe.
Les inconvénients de cette solution
- Faible cohésion : la classe
CDataProcessora de nombreuses responsabilités, si bien que l'on ne peut pas réutiliser facilement l'algorithme dans d'autres applications. - Couplage fort : la logique de traitement est étroitement couplée à la console et au fournisseur de données.
Refonte de la conception
Forte cohésion
Pour améliorer la cohésion, chaque responsabilité doit être confiée à une classe différente ; il nous faut donc trois classes :
CFileProvider: obtient les données depuis un fichier.CDataProcessing: traite les données. Cette classe peut utiliser d'autres classes pour effectuer le traitement, mais pour garder une conception simple, nous la considérons comme suffisante pour notre exemple.CResultReporting: écrit le résultat dans un fichier.
Chaque classe a désormais une seule responsabilité. Les avantages de cette conception sont :
- Les classes sont plus faciles à comprendre.
- Le code est plus facile à maintenir.
- Les classes sont plus faciles à réutiliser dans d'autres applications.
Faible couplage
Que se passe-t-il si les données sont stockées dans une base de données plutôt que dans un fichier ? Dans notre conception précédente, l'application est étroitement couplée à un fournisseur de type fichier.
Pour résoudre ce problème, il nous faut une interface fournissant des méthodes pour récupérer les données depuis n'importe quelle source. Pour des données issues d'un fichier, il faut ensuite une classe qui implémente cette interface.
À cette fin, utiliser NVI peut être une bonne solution. Ce pattern est plus utile que le simple recours à des classes abstraites, car il permet de définir des préconditions et des postconditions. C'est une technique de programmation orientée objet utile, en particulier pendant le développement. Les préconditions et postconditions garantissent que les invariants d'une hiérarchie de classes (et plus généralement d'une abstraction) ne sont pas violés à des points déterminés de l'exécution d'un programme.
Dans notre cas, nous pouvons ajouter l'interface IDataProvider.
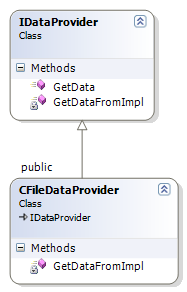
Et CFileProvider hérite de IDataProvider pour implémenter GetDataFromImpl, et la même conception peut être utilisée pour CDataProcessing et CReportResult.
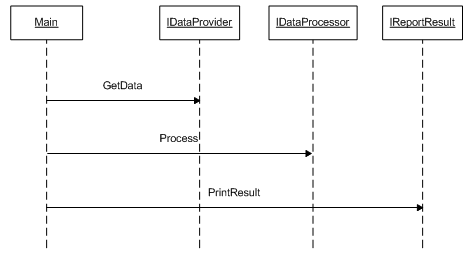
Voici la nouvelle collaboration entre les classes après la refonte :
La fabrique de classes
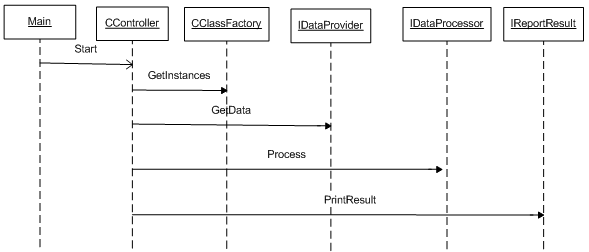
Dans la conception revue, les instances concrètes de IDataProvider, IDataProcessing, et IReportResult sont créées par la méthode principale. Une meilleure approche consiste à confier cette responsabilité à une classe fabrique, ce qui permet d'isoler la logique nécessaire à l'instanciation de la famille d'objets requise.
Le contrôleur
L'orchestration entre toutes les classes est implémentée dans la méthode principale. Il est préférable de confier cette responsabilité à une classe Controller, afin qu'elle puisse être réutilisée dans d'autres applications.
Le contrôleur doit interagir avec trois classes ; la question est donc : comment lier ces instances au contrôleur ?
Nous pouvons lier les instances selon ces deux approches :
- Ajouter une méthode nommée
BindInstances(IDataProviderPtr,IDataProcesingPtr,IReportResultPtr). - Définir le contrôleur comme un template, qui sera alors instancié comme ceci :
CController<CFileProvider,CDataProcessor,CConsoleReport>La différence entre les deux solutions est que, pour la première, chaque fournisseur de données doit hériter de IDataProvider, tandis que pour la seconde, CFileProvider n'a besoin que de la méthode GetData(Data&) même s'il hérite d'une classe autre que IDataProvider.
Les experts C++ débattent abondamment de l'opportunité d'utiliser la POO ou les templates. Voici un bon article sur cette tension entre les deux approches.
Voici la nouvelle collaboration entre les classes après la refonte :
Les bénéfices de la refonte
Après la refonte, l'application devient plus flexible et peut être utilisée dans différents scénarios :
- Elle peut obtenir des données depuis un fichier, une base de données, un fichier XML, un fichier CSV, …
- Elle peut traiter les données à l'aide de nombreuses classes différentes, et non d'une seule.
- Elle peut produire les résultats vers la console, un fichier, …