
Aujourd'hui, de nombreuses bibliothèques et frameworks matures existent pour chaque langage de programmation, et de nombreuses fonctionnalités avancées ont été ajoutées aux langages. Mais qu'en est-il des anciens projets, à une époque où les fonctionnalités des langages n'étaient pas aussi avancées qu'aujourd'hui et où peu de bibliothèques matures existaient ?
Explorons quelques anciens projets bien implémentés et découvrons comment ils l'ont été.
Prince of Persia
Prince of Persia est un jeu de plateforme fantastique, développé à l'origine par Jordan Mechner et sorti en 1989 sur Apple II, qui a représenté un grand bond en avant dans la qualité de l'animation dans les jeux vidéo. Le 17 avril 2012, Jordan Mechner a publié le code source de Prince of Persia.
De nombreux joueurs se souviennent de ce jeu extraordinaire, et peut-être que certains d'entre vous y ont joué pendant des mois.
Les développeurs de cette époque se souviennent d'un temps où un ordinateur personnel typique pouvait avoir un processeur à 8 MHz, 1 mégaoctet de mémoire, un disque dur de 20 mégaoctets et un lecteur de disquettes. Développer un jeu comme Prince of Persia était un grand défi.
De plus, à cette époque, Google n'était pas disponible pour aider les développeurs à résoudre rapidement les problèmes techniques ; certains problèmes techniques pouvaient prendre plusieurs jours à corriger. Et pour couronner le tout, le jeu a été développé en assembleur 6502.
Malgré toutes ces contraintes, le code source est bien implémenté :
- Il est modularisé à l'aide de répertoires et de fichiers :
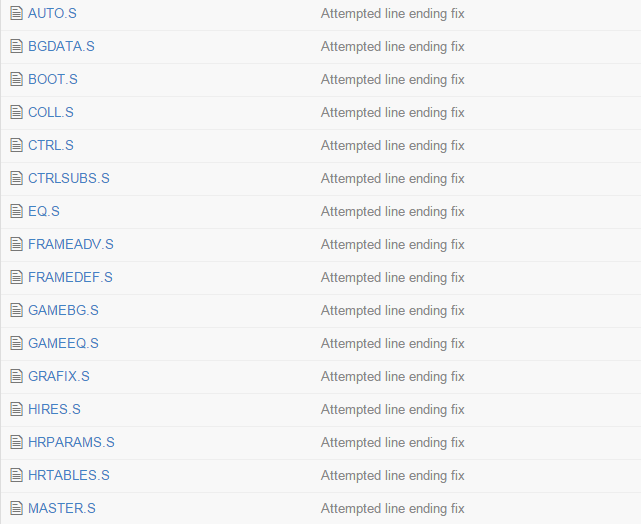
La modularité est une technique de conception logicielle qui consiste à composer un logiciel à partir de parties distinctes ; le code modulaire est plus facile à gérer et à maintenir. Prince of Persia a été modularisé à l'aide de répertoires et de fichiers — cette modularité est fournie par le système d'exploitation et peut s'appliquer à n'importe quel langage.
Le code est découpé en de nombreux fichiers ; en voici une liste de quelques-uns :
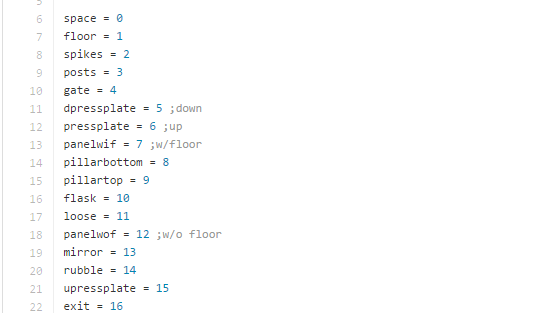
- Le nommage est facile à comprendre
En explorant le code source, vous ne trouverez pas de noms de variables comme a, b ou x, contrairement à de nombreux projets développés récemment. Les noms sont bien choisis, et aucun commentaire n'est nécessaire pour expliquer pourquoi on en a besoin.
- Le code est découpé en de nombreuses petites sous-routines
Le langage assembleur 6502 est très bas niveau, et pour rendre le code plus facile à comprendre et à maintenir, le principe « diviser pour régner » est appliqué. En effet, le code est découpé en de nombreuses petites sous-routines, ce qui les rend faciles à lire et à maintenir. Voici un exemple de petite sous-routine de son code source :
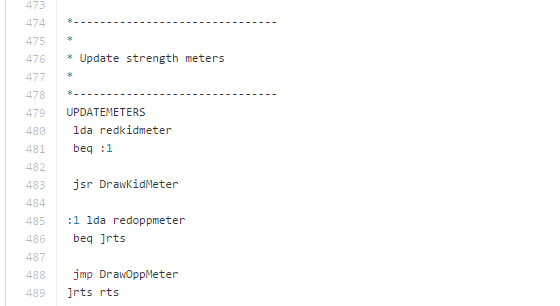
Même si en 1989 de nombreuses contraintes compliquaient la tâche des développeurs, le code est très bien implémenté. Alors pourquoi, en 2014, avec des ordinateurs puissants, des langages puissants, des milliers de bibliothèques et Google, certains projets sont-ils mal implémentés ?
Les langages et les frameworks ne sont que des outils pour construire des applications, mais l'acteur principal reste le développeur. On peut utiliser le meilleur langage et les meilleurs frameworks et produire quand même du mauvais code.
De nombreuses pratiques qui rendent le code propre ne dépendent pas du langage. Un bon développeur doit avoir du bon sens et rendre son code propre et facile à comprendre, quel que soit le langage utilisé.
Doom 3
Doom 3 est un jeu vidéo développé par id Software et publié par Activision. Le jeu a été un succès commercial pour id Software, avec plus de 3,5 millions d'exemplaires vendus.
Le 23 novembre 2011, id Software a perpétué la tradition et publié le code source de son moteur précédent. Ce code source a été passé en revue par de nombreux développeurs ; voici, à titre d'exemple, le retour de Fabien (source originale) :
Doom 3 BFG est écrit en C++, un langage si vaste qu'il peut servir à produire du code excellent mais aussi des abominations qui vous feront saigner les yeux. Heureusement, id Software s'est contenté d'un sous-ensemble du C++ proche du « C with Classes », qui s'écoule dans le cerveau sans résistance :
- Pas d'exceptions.
- Pas de références (utiliser des pointeurs).
- Usage minimal des templates.
- Const partout.
- Des classes.
- Du polymorphisme.
- De l'héritage.
De nombreux experts C++ ne recommandent plus l'approche « C with classes ». Cependant, Doom3 a été développé entre 2000 et 2004, ce qui pourrait expliquer pourquoi les mécanismes du C++ moderne n'ont pas été utilisés.
Explorons son code source en utilisant CppDepend et découvrons ce qui le rend si spécial.
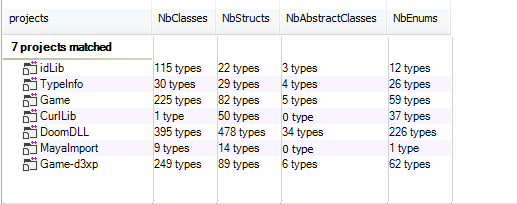
Doom3 est modularisé en quelques projets ; voici la liste de ses projets et quelques statistiques sur leurs types :
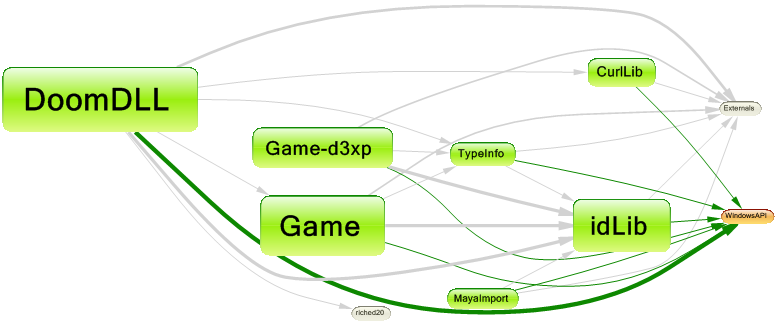
Voici le graphe de dépendances montrant les relations entre eux :
Doom3 définit de nombreuses fonctions globales. Cependant, la plupart des traitements sont implémentés dans des classes.
Le modèle de données est défini à l'aide de structs. Pour avoir une idée concrète de l'utilisation des structs dans le code source, la vue métrique ci-dessus les montre sous forme de rectangles bleus.
Dans la vue Metric, la base de code est représentée par un treemap. Le treemapping est une méthode d'affichage de données arborescentes à l'aide de rectangles imbriqués. L'arborescence utilisée est la hiérarchie de code habituelle :
- Le projet contient des espaces de noms.
- L'espace de noms contient des types.
- Le type contient des méthodes et des champs.
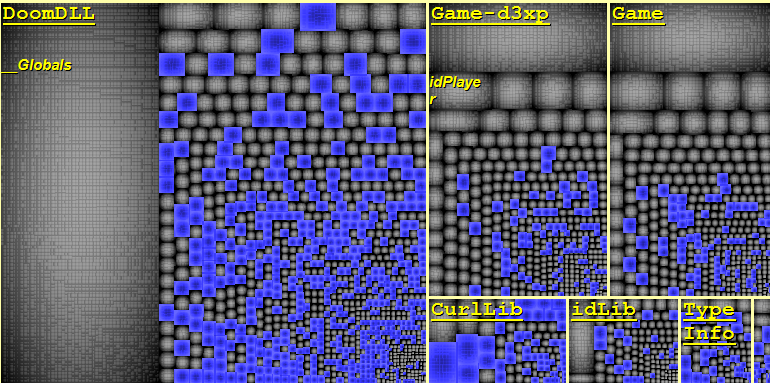
Comme on peut le constater, de nombreux structs sont définis ; par exemple, plus de 40 % des types de DoomDLL sont des structs. Ils sont systématiquement utilisés pour définir le modèle de données. Cette pratique est adoptée par de nombreux projets, mais cette approche a un gros inconvénient dans le cas des applications multithread : en effet, les structs avec des champs publics ne sont pas immuables.
Il y a un argument important en faveur de l'utilisation des objets immuables : cela simplifie radicalement la programmation concurrente. Réfléchissez-y — pourquoi écrire du code multithread correct est-il une tâche difficile ? Parce qu'il est difficile de synchroniser l'accès des threads aux ressources (objets ou autres ressources de l'OS). Pourquoi est-il difficile de synchroniser ces accès ? Parce qu'il est difficile de garantir qu'il n'y aura pas de situations de compétition entre les multiples accès en écriture et en lecture effectués par plusieurs threads sur plusieurs objets. Et s'il n'y avait plus d'accès en écriture ? Autrement dit, si l'état des objets accédés par les threads ne changeait pas ? Alors il n'y aurait plus besoin de synchronisation !
Recherchons les classes ayant au moins une classe de base :
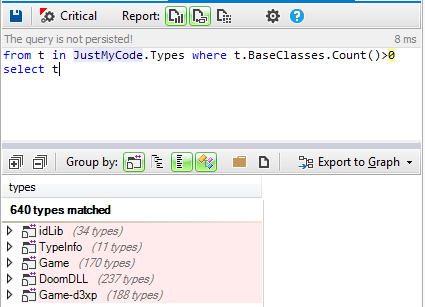
Près de 40 % des structs et classes ont une classe de base. Et généralement en POO, l'un des avantages de l'héritage est le polymorphisme ; voici, en bleu, les méthodes virtuelles définies dans le code source :
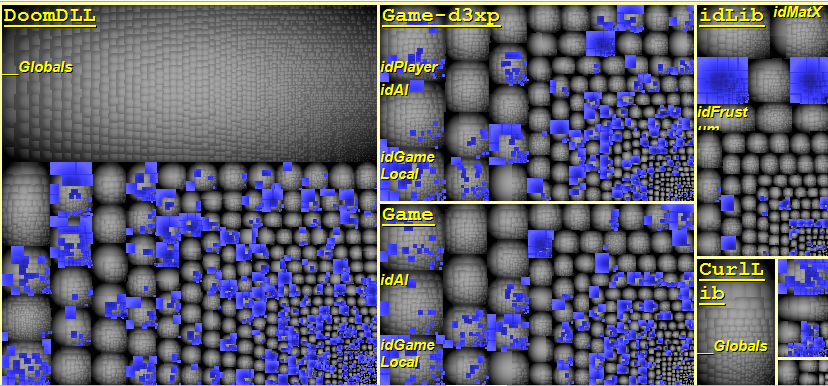
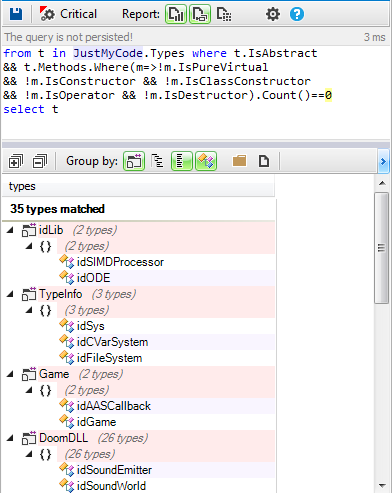
Plus de 30 % des méthodes sont virtuelles. Peu d'entre elles sont virtuelles pures, et voici la liste de toutes les classes abstraites définies :
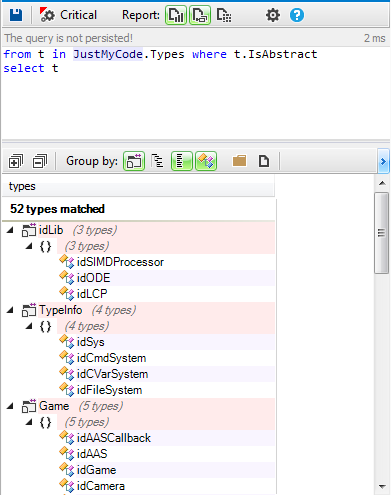
Seules 52 classes abstraites sont définies ; 35 d'entre elles sont définies comme des interfaces pures, c'est-à-dire que toutes leurs méthodes virtuelles sont pures.
Recherchons les méthodes utilisant le RTTI.
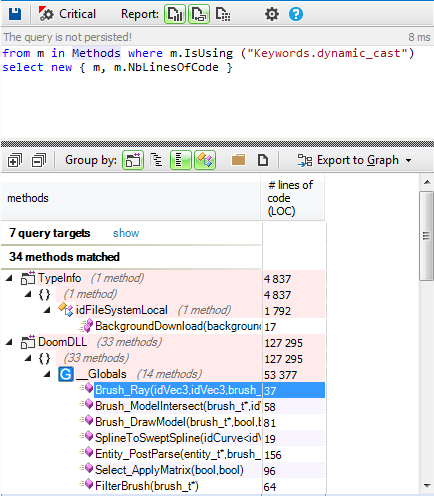
Très peu de méthodes utilisent le RTTI.
Pour résumer : seuls des concepts POO basiques sont utilisés — pas de design patterns avancés, pas d'usage excessif des interfaces et des classes abstraites, un usage limité du RTTI, et des données définies comme des structs.
Jusqu'ici, rien de spécial ne différencie ce code de beaucoup d'autres utilisant le « C with Classes », une approche critiquée par de nombreux développeurs C++.
Voici quelques choix intéressants faits par ses développeurs pour nous aider à comprendre son secret :
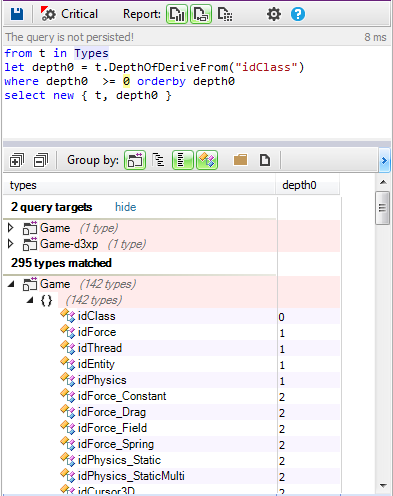
1. Fournir une classe de base commune avec des services utiles.
De nombreuses classes héritent de idClass :
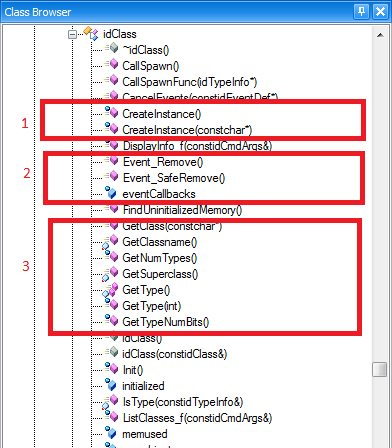
idClass fournit les services suivants :
- Création d'instances.
- Gestion des informations de type.
- Gestion des événements.
2. Rendre la manipulation des chaînes facile
En général, la chaîne est le type le plus utilisé dans un projet ; de nombreuses opérations sont effectuées avec des chaînes, et nous avons besoin de fonctions pour les manipuler.
Doom3 définit la classe idStr, qui contient presque toutes les méthodes utiles pour manipuler les chaînes — pas besoin de définir vos propres méthodes, comme c'est le cas avec de nombreuses classes de chaînes fournies par d'autres frameworks.
3. Le code source est fortement découplé du framework GUI (MFC)
Dans de nombreux projets utilisant MFC, le code est fortement couplé à ses types, et l’on trouve des types MFC partout dans le code.
Dans Doom3, le code est fortement découplé de MFC ; seules les classes de l'IHM en dépendent directement, comme le montre la requête CQLinq suivante :
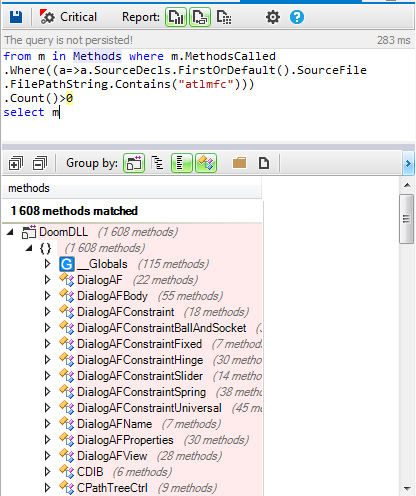
Ce choix a un impact important sur la productivité. En effet, seuls les développeurs de l'IHM doivent se soucier du framework MFC ; les autres développeurs n'ont pas à perdre de temps avec MFC.
4. Il fournit une très bonne bibliothèque utilitaire (idlib)
Dans presque tous les projets, les types les plus utilisés sont les classes utilitaires, comme le montre le résultat de la requête suivante :
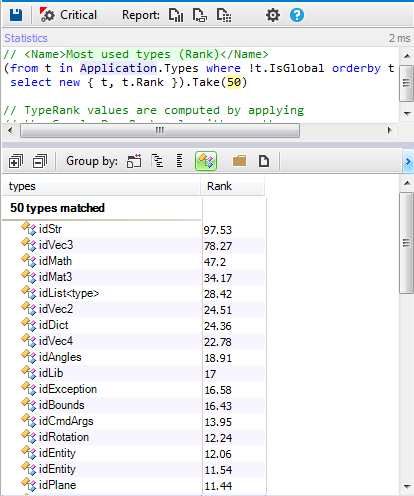
Comme on peut le constater, les plus utilisées sont les classes utilitaires. Si les développeurs C++ n'utilisent pas un bon framework pour les utilitaires, ils passent la majeure partie de leur temps de développement à se battre avec la couche technique.
idlib fournit des classes utiles avec toutes les méthodes nécessaires pour gérer les chaînes, les conteneurs et la mémoire, ce qui facilite le travail des développeurs et leur permet de se concentrer davantage sur la logique du jeu.
5. L’implémentation est très facile à comprendre
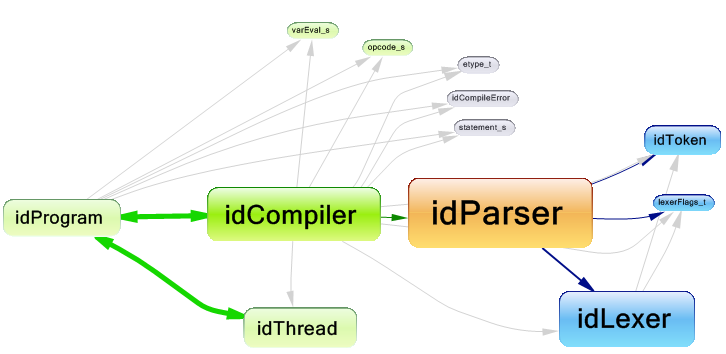
Doom3 implémente un compilateur maison, et comme les développeurs C++ le savent, développer des parseurs et des compilateurs n'est pas une tâche facile. Cependant, l'implémentation de Doom3 est très facile à comprendre, et son code est très propre.
Voici le graphe de dépendances des classes utilisées par le compilateur :
Et voici un extrait du code source du compilateur :
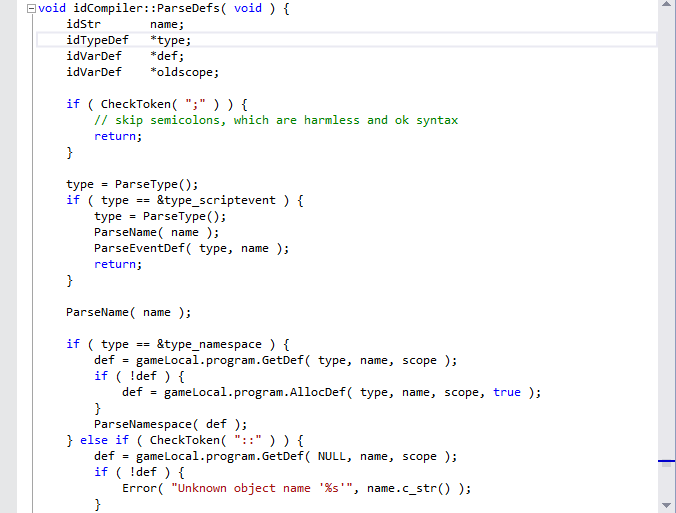
Nous avons déjà étudié le code source de nombreux parseurs et compilateurs. Mais c'est la première fois que nous rencontrons un compilateur dont le code source est si facile à comprendre, et c'est pareil pour l'ensemble du code source de Doom3. C'est magique. Quand on explore le code source de Doom3, on ne peut que dire : WOW, c'est magnifique !
Même si les choix de conception de Doom3 sont très basiques, ses concepteurs ont pris de nombreuses décisions pour permettre aux développeurs de se concentrer davantage sur la logique du jeu et simplifier tout le travail de la couche technique, ce qui augmente considérablement la productivité.
Cependant, lorsqu'on utilise le « C with Classes », il faut savoir exactement ce que l'on fait. Il faut être un expert comme les développeurs de Doom3. Les débutants ne devraient pas prendre le risque d'ignorer les recommandations du C++ moderne.