
今日では、各プログラミング言語に多くの成熟したライブラリやフレームワークが存在し、言語にも多くの高度な機能が追加されています。しかし、言語機能が現在ほど高度ではなく、成熟したライブラリもほとんど存在しなかった時代の古いプロジェクトはどうだったのでしょうか?
適切に実装された古いプロジェクトをいくつか調べ、それらがどのように実装されていたのかを見ていきましょう。
Prince of Persia
Prince of Persiaは、もともとJordan Mechnerによって開発され、1989年にApple II向けに発売されたファンタジープラットフォームゲームで、ビデオゲームにおけるアニメーションの品質を大きく前進させました。2012年4月17日、Jordan MechnerはPrince of Persiaの ソースコードを公開 しました。
多くのゲーマーがこの素晴らしいゲームを覚えており、中には何か月もプレイした方もいるかもしれません。
当時の開発者は、一般的なパーソナルコンピュータが8MHzプロセッサ、1メガバイトのメモリ、20メガバイトのハードディスク、フロッピーディスクドライブを搭載していた時代を覚えています。Prince of Persiaのようなゲームを開発することは大きな挑戦でした。
さらに当時は、開発者が技術的な問題を迅速に解決するのを助けるGoogleはありませんでした。技術的な問題の修正に何日もかかることがありました。そして極めつけは、6502アセンブリ言語を使って開発されていたことです。
これらすべての制約にもかかわらず、ソースコードは適切に実装されています:
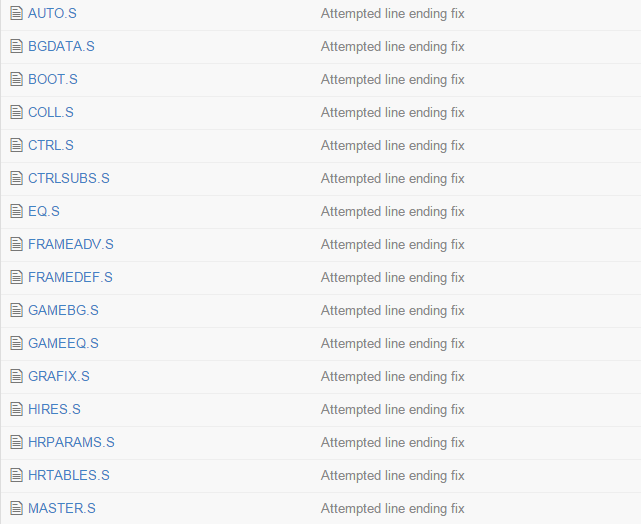
- ディレクトリとファイルを使ってモジュール化されている:
モジュール性は、ソフトウェアが独立した部分で構成される度合いを高めるソフトウェア設計技法です。モジュール化されたコードは、管理・保守が容易です。Prince of Persiaはディレクトリとファイルを使ってモジュール化されていました。このモジュール性はオペレーティングシステムによって提供され、あらゆる言語に適用できます。
コードは多数のファイルに分割されています。その一部の一覧は次のとおりです:
- 命名が理解しやすい
ソースコードを調べても、最近開発された多くのプロジェクトとは異なり、a、b、xのような変数名は見つかりません。名前は適切に選ばれており、なぜそれらが必要なのかを説明するコメントも不要です。
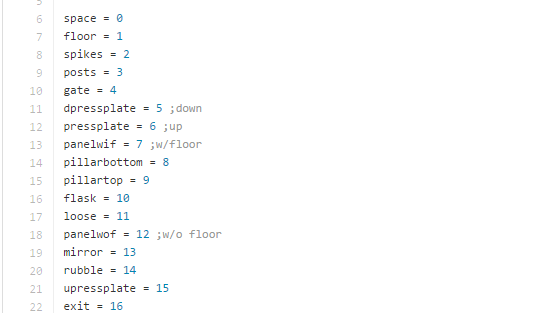
- コードが多数の小さなサブルーチンに分割されている
6502アセンブリ言語は非常に低レベルであり、コードを理解・保守しやすくするために「分割統治」の原則が適用されています。実際、コードは多数の小さなサブルーチンに分割されており、読みやすく保守しやすくなっています。以下は、そのソースコードに含まれる小さなサブルーチンの例です:
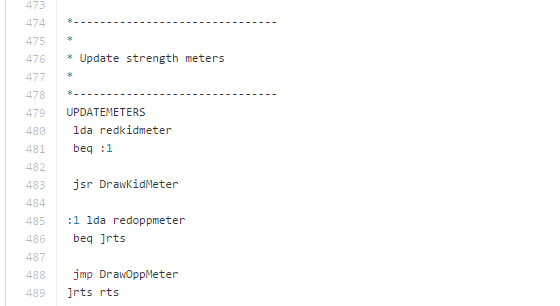
1989年には多くの制約が開発者の作業を困難にしていたにもかかわらず、コードは非常に適切に実装されています。では、2014年に、強力なコンピュータ、強力な言語、何千ものライブラリ、Googleがあるにもかかわらず、なぜ一部のプロジェクトは適切に実装されていないのでしょうか?
言語やフレームワークは、アプリケーションを構築するための単なる道具であり、主役は開発者です。最高の言語と最高のフレームワークを使っても、悪いコードを生み出すことは可能です。
コードをクリーンにする多くの実践は、言語に依存しません。優れた開発者は、使用する言語に関係なく、良識を持ってコードをクリーンで理解しやすいものにしなければなりません。
Doom 3
Doom 3は、 id Software が開発し、 Activisionが発売したビデオゲームです。このゲームはid Softwareにとって商業的な成功となり、350万本以上が販売されました。
2011年11月23日、id Softwareは伝統を守り、前世代エンジンの ソースコード を公開しました。このソースコードは多くの開発者によってレビューされました。例として、Fabienによるフィードバックを示します(原典):
Doom 3 BFGはC++で書かれています。C++は非常に広大な言語であり、優れたコードを生み出すことも、目を背けたくなるようなひどいコードを生み出すこともできます。幸い、id Softwareは「クラス付きC」に近いC++のサブセットに落ち着き、頭にすんなり入ってくるコードになっています:
- 例外を使わない。
- 参照を使わない(ポインタを使用)。
- テンプレートの使用は最小限。
- constを随所に使用。
- クラス。
- ポリモーフィズム。
- 継承。
多くのC++エキスパートは、もはや「クラス付きC」アプローチを推奨していません。しかし、Doom3は2000年から2004年にかけて開発されたため、現代的なC++機構が使われていない理由はそこにあるのかもしれません。
ここでは、 CppDepend を使ってソースコードを調べ、何がそれを特別なものにしているのかを探ってみましょう。
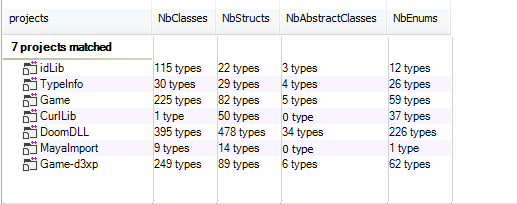
Doom3は少数のプロジェクトを使ってモジュール化されています。そのプロジェクトの一覧と、それらの型に関するいくつかの統計は次のとおりです:
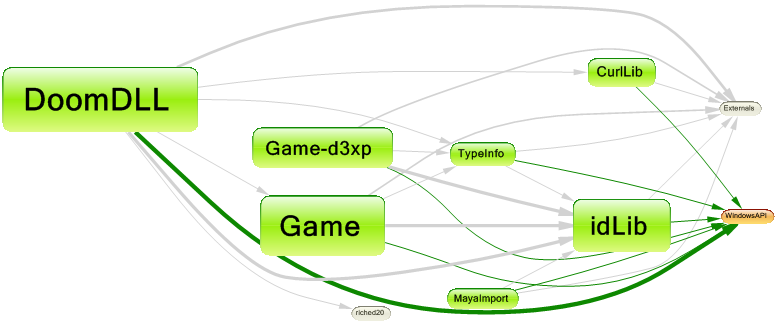
それらの関係を示す依存関係グラフは次のとおりです:
Doom3では多くのグローバル関数が定義されています。しかし、ほとんどの処理はクラスに実装されています。
データモデルは構造体を使って定義されています。ソースコードにおける構造体の使用を具体的に把握するため、上のメトリクスビューではそれらが青い長方形で示されています。
メトリクスビューでは、コードベースがツリーマップで表現されます。ツリーマッピングは、入れ子になった長方形を使ってツリー構造のデータを表示する方法です。使用されるツリー構造は、通常のコード階層です:
- プロジェクトには名前空間が含まれる。
- 名前空間には型が含まれる。
- 型にはメソッドとフィールドが含まれる。
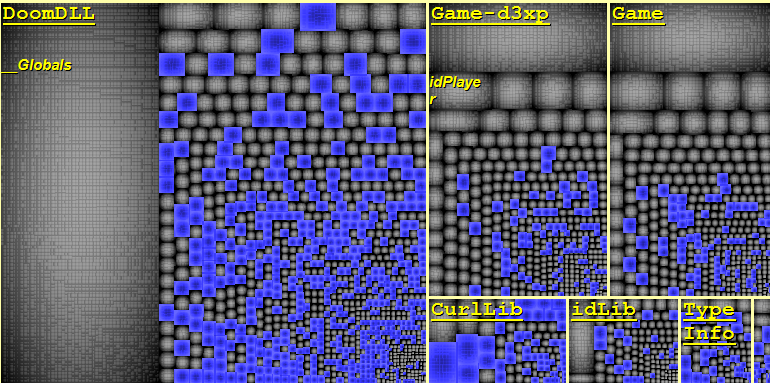
ご覧のとおり、多くの構造体が定義されています。たとえば、DoomDLLの型の40%以上が構造体です。それらはデータモデルを定義するために体系的に使用されています。この慣行は多くのプロジェクトで採用されていますが、マルチスレッドアプリケーションの場合、このアプローチには大きな欠点があります。公開フィールドを持つ構造体は不変ではないからです。
不変オブジェクトを使用することには、重要な利点が1つあります。並行プログラミングを劇的に単純化するのです。考えてみてください。適切なマルチスレッドコードを書くことがなぜ難しいのでしょうか。リソース(オブジェクトやその他のOSリソース)へのスレッドアクセスを同期するのが難しいからです。なぜこれらのアクセスを同期するのが難しいのでしょうか。複数のスレッドが複数のオブジェクトに対して行う複数の書き込み・読み取りアクセス間で競合状態が発生しないことを保証するのが難しいからです。書き込みアクセスがなくなったらどうなるでしょうか。言い換えると、スレッドがアクセスするオブジェクトの状態が変化しなければどうなるでしょうか。その場合、同期は不要になります。
少なくとも1つの基底クラスを持つクラスを検索してみましょう:
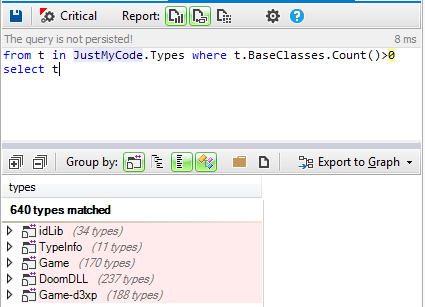
構造体とクラスのほぼ40%が基底クラスを持っています。一般にOOPでは、継承の利点の1つはポリモーフィズムです。ソースコードで定義されている仮想メソッドを青色で示します:
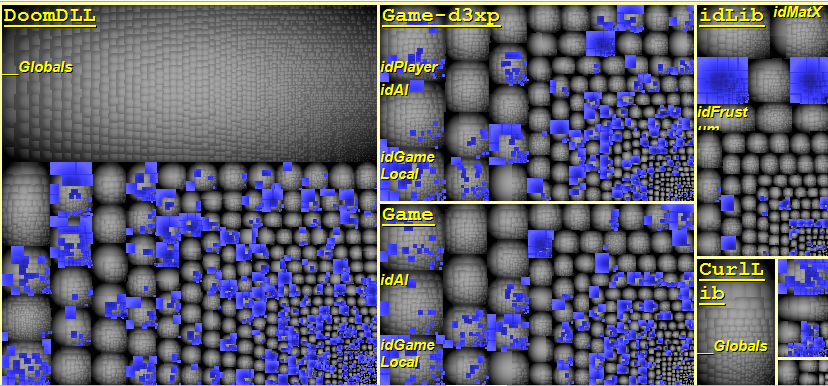
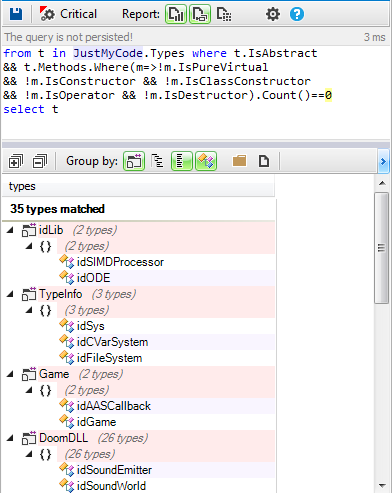
メソッドの30%以上が仮想メソッドです。純粋仮想メソッドは少数です。定義されているすべての抽象クラスの一覧は次のとおりです:
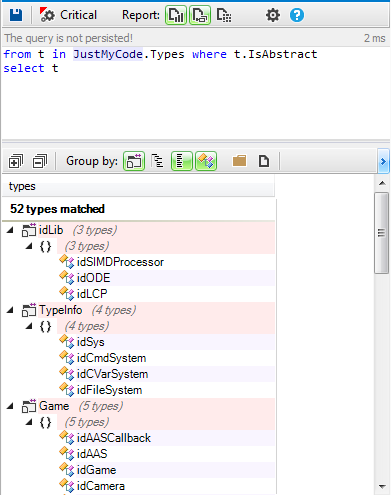
定義されている抽象クラスは52個だけで、そのうち35個は純粋インターフェース、つまりすべての仮想メソッドが純粋仮想メソッドとして定義されています。
RTTIを使用しているメソッドを検索してみましょう。
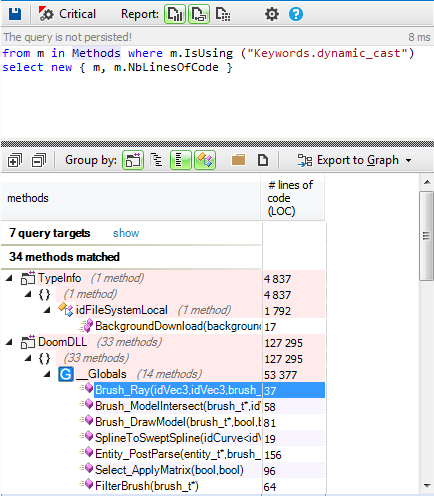
RTTIを使用しているメソッドはごく少数です。
要約すると、使用されているのは基本的なOOP概念だけです。高度なデザインパターンはなく、インターフェースや抽象クラスの使いすぎもなく、RTTIの使用は限定的で、データは構造体として定義されています。
ここまでは、このコードを、多くのC++開発者に批判されている「クラス付きC」アプローチを採用した他の多くのコードと区別する特別な点はありません。
その秘密を理解する助けとなる、開発者による興味深い選択をいくつか示します:
1. 有用なサービスを提供する共通の基底クラスを用意する
多くのクラスがidClassを継承しています:
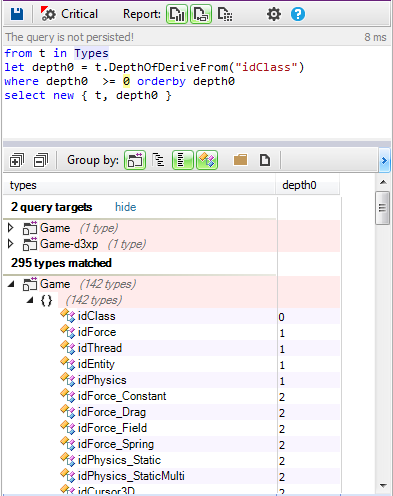
idClassは次のサービスを提供します:
- インスタンス生成。
- 型情報の管理。
- イベント管理。
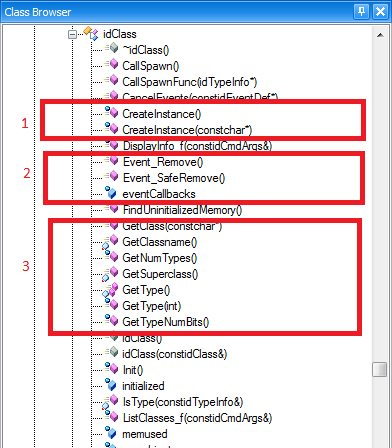
2. 文字列操作を容易にする
一般に、文字列はプロジェクトで最もよく使われる型であり、文字列を使った多くの操作が行われるため、それらを操作する関数が必要です。
Doom3では、文字列を操作するための有用なメソッドのほぼすべてを備えたidStrクラスが定義されています。他の多くのフレームワークが提供する文字列クラスのように、独自のメソッドを定義する必要はありません。
3. ソースコードはGUIフレームワーク(MFC)から強く分離されている
MFCを使う多くのプロジェクトでは、コードがMFCの型と強く結合しており、コード内の至る所でMFCの型を見つけることができます。
Doom3では、コードはMFCから強く分離されており、GUIクラスだけがMFCに直接依存しています。これは次のCQLinqクエリが示すとおりです:
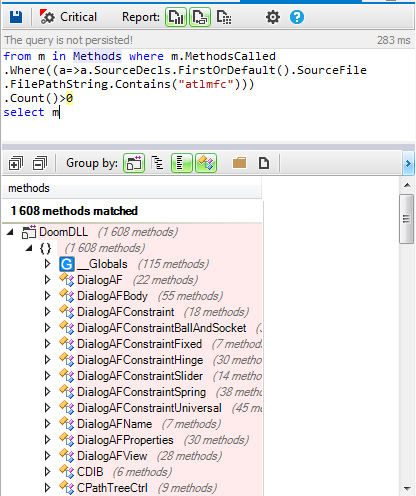
この選択は生産性に大きな影響を与えます。実際、GUI開発者だけがMFCフレームワークに対処すればよく、他の開発者はMFCに時間を浪費せずに済みます。
4. 非常に優れたユーティリティライブラリ(idlib)を提供する
ほぼすべてのプロジェクトで、最もよく使われる型はユーティリティクラスです。次のクエリ結果が示すとおりです:
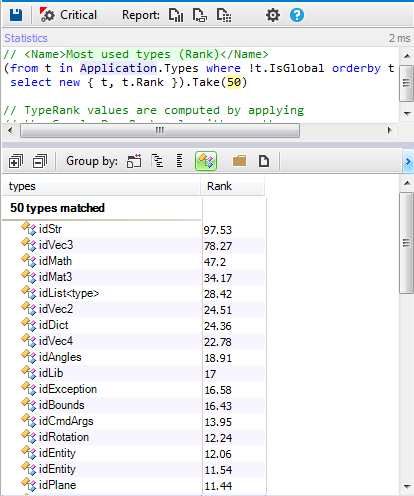
ご覧のとおり、最もよく使われているのはユーティリティクラスです。C++開発者が優れたユーティリティフレームワークを使わない場合、開発時間の大部分を技術レイヤーとの闘いに費やすことになります。
idlibは、文字列、コンテナ、メモリを扱うために必要なすべてのメソッドを備えた有用なクラスを提供します。これにより開発者の作業が容易になり、ゲームロジックにより集中できるようになります。
5. 実装が非常に理解しやすい
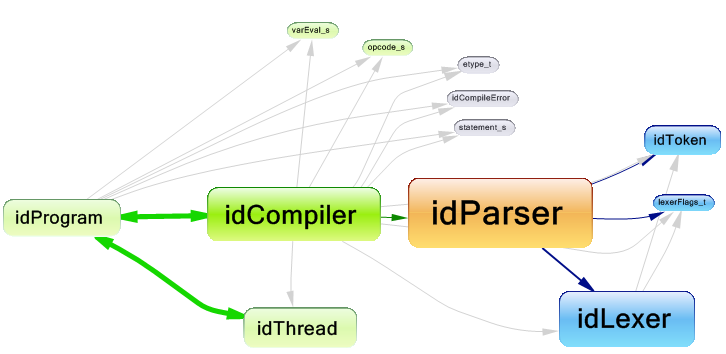
Doom3には独自実装のコンパイラが含まれています。C++開発者ならご存じのとおり、パーサーやコンパイラの開発は容易な作業ではありません。それでもDoom3の実装は非常に理解しやすく、コードも非常にクリーンです。
コンパイラが使用するクラスの依存関係グラフは次のとおりです:
以下は、コンパイラのソースコードからの抜粋です:
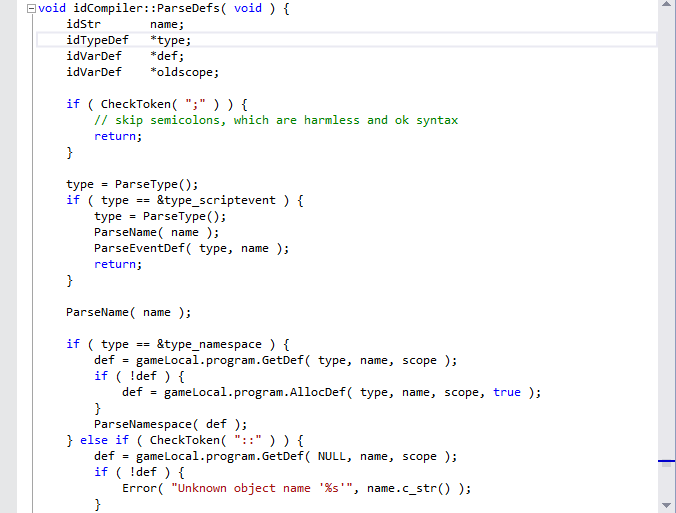
これまで多くのパーサーやコンパイラのソースコードを調べてきました。しかし、これほど理解しやすいコンパイラのソースコードに出会ったのは初めてです。Doom3のソースコード全体にも同じことが言えます。まるで魔法です。Doom3のソースコードを読み進めると、私たちは「WOW、美しい!」と言うほかありません。
Doom3の設計上の選択は非常に基本的なものですが、設計者は、開発者がゲームロジックにより集中できるようにし、技術レイヤーの作業をすべて簡素化する多くの決定を行いました。これにより生産性が大幅に向上しています。
ただし、「クラス付きC」を使用する場合、自分が何をしているのかを正確に理解している必要があります。Doom3の開発者のようなエキスパートでなければなりません。初心者は、Modern C++の推奨事項を無視するリスクを取るべきではありません。