
ChatGPTは最近人気を博しています。コード品質に関する長年の経験を持つチームとして、ChatGPTに新しいソフトウェアメトリクスを作成するよう依頼する実験を行うことにしました。クエリを送信する前、有用な結果が得られるか、あるいは何らかの結果が得られるのかどうか疑問に思っていました。回答は次のような内容になるのではないかと懸念していました。
「新しいソフトウェアメトリクスの作成には、コード品質を改善する指標としての信頼性を実証するために、実際のプロジェクトでの広範なテストが必要です。」
しかし、驚いたことに、私たちはメトリクスを受け取りました :)
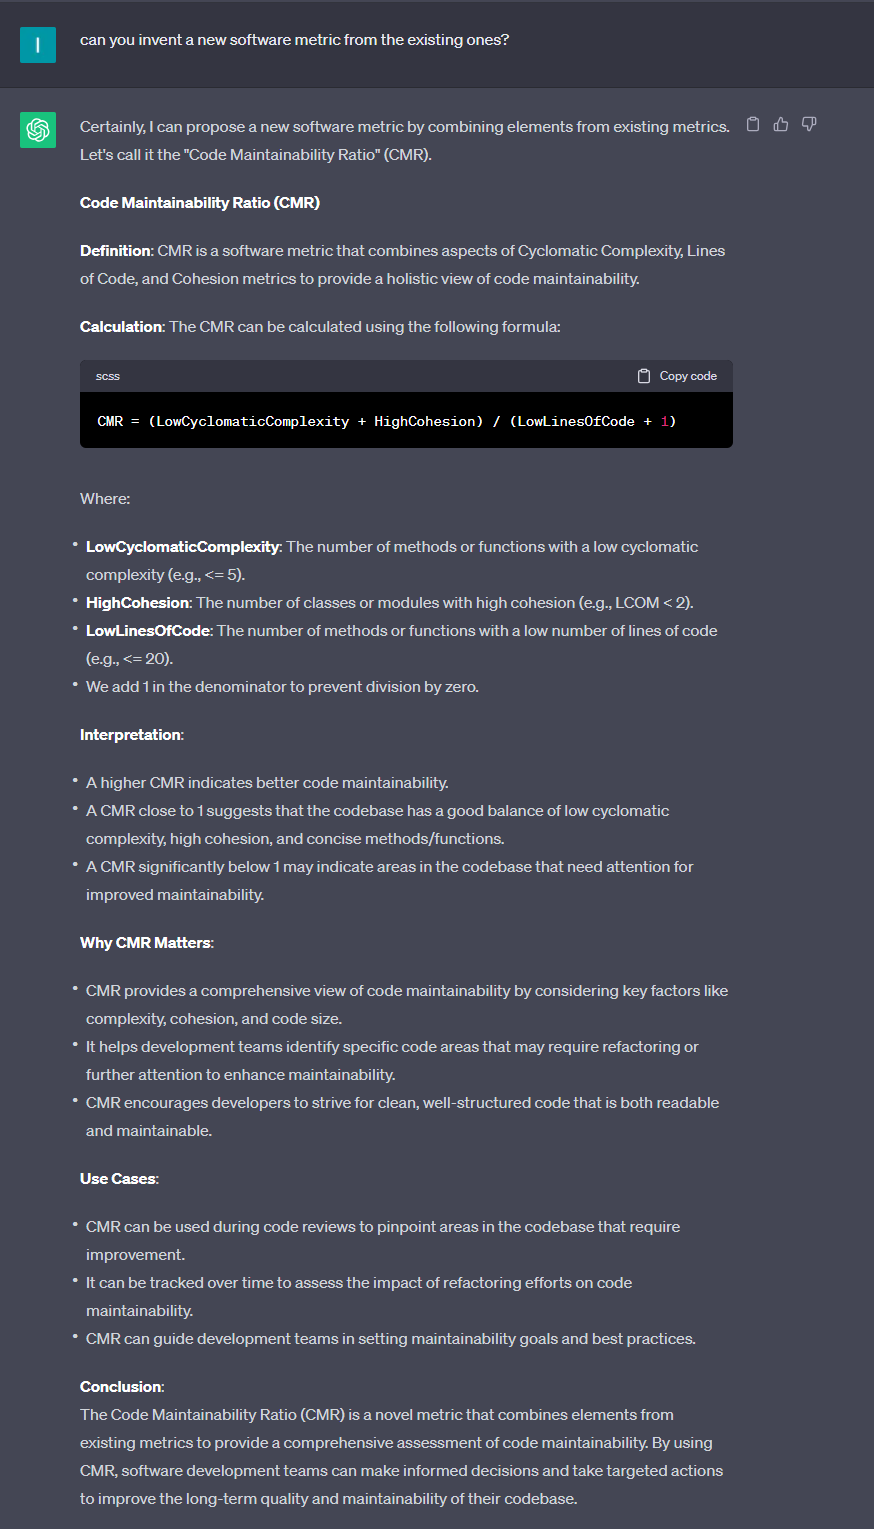
しかし、このメトリクスは本当に保守性の信頼できる指標なのでしょうか?
式を分析してみましょう。`lowCyclomaticComplexity + HighCohesion`
この式の背後にある理論は次のとおりです。
- 保守性はメソッドの複雑さに依存します。
- 保守性は型の凝集性にも依存します。
- 循環的複雑度と凝集性の間に直接的な相関はないため、式で`+`演算子を使用しました。
- 信頼できる結果を得るには、コードサイズを考慮した比率を使用する方が適切です。
一見すると、この式は有望に見えます。しかし、実際のプロジェクトでは、特に次の記述に関して、この式に重大な問題があります。
「循環的複雑度と凝集性の間に直接的な相関はありません。」
このような場合、これら2つのメトリクスが密接に関連しているか、一方のメトリクスが常に他方を上回っているかを確認する必要があります。一方のメトリクスが常に他方を支配している場合、組み合わせたメトリクスが無意味になる可能性があります。私たちのケースでは、lowComplexityメトリクスが凝集性メトリクスよりもはるかに高くなる可能性があり、それを覆い隠して全体的なメトリクスの意味を薄めてしまう可能性があります。
このメトリクスを改善するために、自然対数、乗算、除算、その他の数学関数などの追加の演算子を導入して式を洗練させ、より信頼できる結果を得ることができます。これは、保守性指数(Maintainability Index)で行われていることと似ています。
`Maintainability Index = 171 – 5.2 * ln(Halstead Volume) – 0.23 * (Cyclomatic Complexity) – 16.2 * ln(Lines of Code)`
ソフトウェアメトリクスの式はどのように洗練させるのでしょうか?
魔法のようなものはありません。実際のプロジェクトでの広範なテストと、これらのメトリクスを数ヶ月、時には数年にわたって扱う作業が必要であり、それによって信頼できるメトリクスにつながる係数や演算子を特定します。
結論
ChatGPT、そしてAI全般は貴重なツールですが、近い将来に人間の専門知識に取って代わることはないことを忘れないことが重要です。人間による検証と監督は、すべての分野で重要です。だから心配しないでください。AIはあなたの仕事を奪いません。あなたがより良く仕事をするのを助けてくれます。