
すべてのプロジェクトには独自のスタイルガイド、つまりコードの書き方に関する一連の規約があります。基本的なコーディングルールを選ぶマネージャーもいれば、より高度なものを好むマネージャーもいます。しかし、多くのプロジェクトではコーディングルールがまったく指定されておらず、各開発者が独自のスタイルを使用しています。
コードベース内のすべてのコードが一貫したスタイルで書かれていると、大規模なコードベースをはるかに理解しやすくなります。
コーディングのベストプラクティスに関するリソースはたくさんあります。良いコーディングルールは次の方法で学べます。
- 書籍や雑誌を読む。
- オンラインリソースを利用する。
- 同僚から学ぶ。
- トレーニングコースを受講する。
数ヶ月間エキスパートと一緒に働いて、チームのコーディングスキルを向上させることもできます。しかし、適切な人材を見つけるのは容易ではなく、企業にとって多くの費用がかかる可能性があります。しかし、Linus Torvaldsのような卓越した開発者から学べるのに、なぜエキスパートを探す必要があるでしょうか?彼が開発または保守したソースコードを探索するだけで、効率的なCコードの書き方について貴重な洞察が得られます。
Linus Torvaldsは、Linuxカーネルの生みの親であり長年にわたるその主要開発者として、また非常に人気のある分散バージョン管理システム Gitの生みの親として広く認識されています。それだけで、彼のコードは研究する価値が十分にあります :)
Gitソースコードの内部
Gitのコードスニペットを見てみましょう。
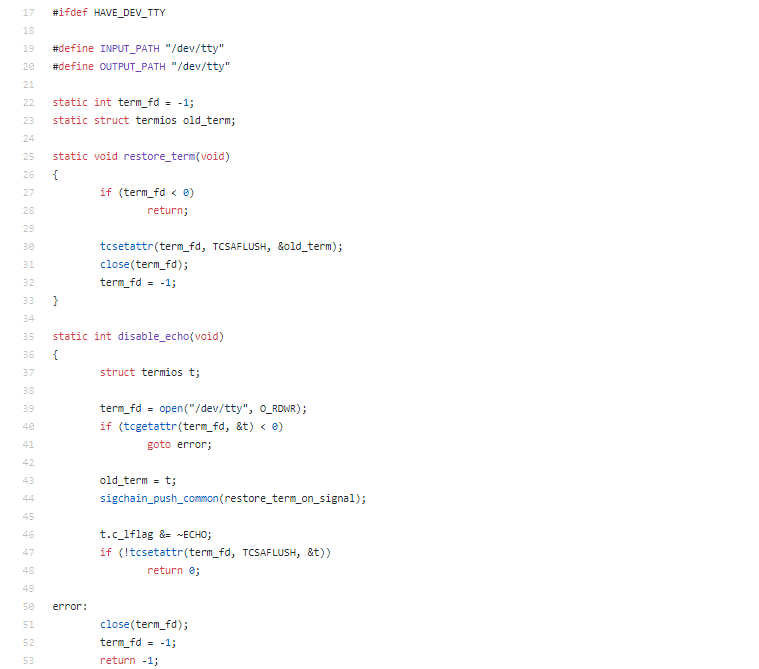
このコードに関するいくつかの観察結果は次のとおりです。
- 関数はstaticで宣言されている。
- 関数はエラーコードを返す。
- 関数のパラメータは少ない。
- 関数は可能な限り早く終了する。
- 変数はstaticで宣言されている。
- 変数名はわかりやすい。
- 関数は非常に短い。
- コードが適切にインデントされています。
- 本体内に余分なコメントがない。コード自体が語っている。
- 関数本体は適切にインデントされている。
- defineガードが明確である。
Gitソースコードをざっと見ると、それがどれほど一貫して実装されているかがわかります。同じベストプラクティスが全体に適用されています。これを確認するために、static関数を検索してみましょう。
from m in Methods where m.IsStatic select m
ツリーマップは、CQLinqクエリにマッチしたコード要素の概要を把握するのに非常に便利です。青い長方形が結果を表しています。
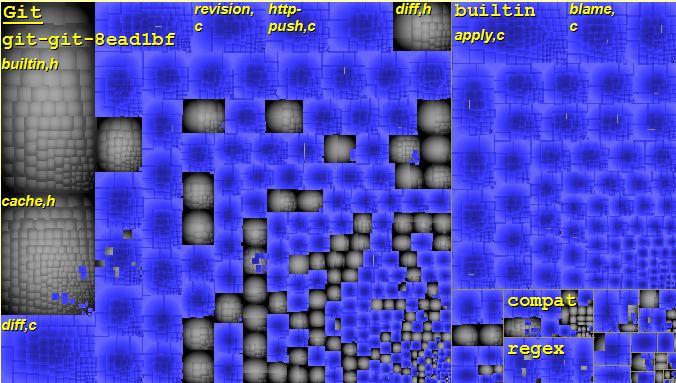
ほぼすべての関数がstaticで宣言されているため、それらは宣言された翻訳単位内でのみ見えます。
Linuxカーネルソースコードの内部
Linuxソースコードに移って、次の関数実装を見てみましょう。
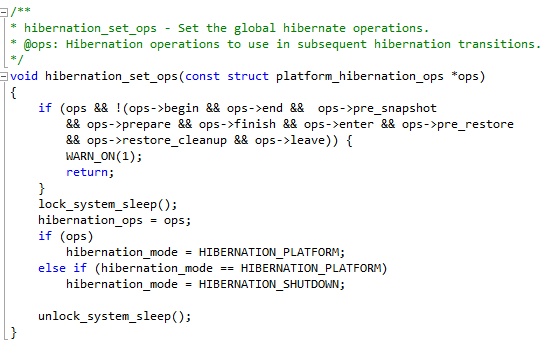
コードは非常にクリーンに見えます。特に、この関数は
- コード行数がわずかです。
- シグネチャが適切に定義されています。
- コメントが適切です。
- コードが適切にインデントされています。
- 変数名が非常に明確です。
- const正確性が守られています。
- 入力パラメータをチェックし、特定の条件を満たさない場合に警告を発します。
別の開発者は、同じ関数をこのように実装するかもしれません。
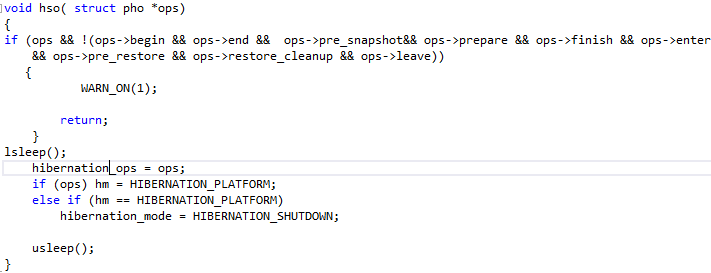
コーディングスタイルは、ソースコードの可読性に大きな影響を与えます。開発者のトレーニングに数時間を投資し、定期的なコードレビューを実施することで、コードの保守と進化がはるかに容易になります。
Let’s explore the Linux kernel source code using CppDepend を使用してLinuxカーネルソースコードを探索し、その開発者が採用しているいくつかの基本的なコーディングルールを発見してみましょう。
モジュール性
モジュール性とは、ソフトウェアが別々のパーツで構成される度合いを高めるソフトウェア設計手法です。モジュラーなコードは管理と保守が容易です。
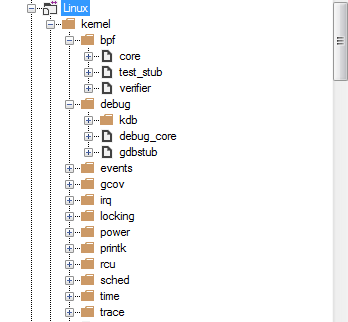
名前空間、コンポーネント、クラスなどの論理的構造を持たないCのような手続き型言語では、モジュール性はディレクトリとファイルを通じて実現できます。
考えられるシナリオは次のとおりです。
- すべてのソースファイルを1つのディレクトリに置く。
- モジュールまたはサブモジュールに関連するファイルを特定のディレクトリに分離する。
Linuxカーネルの場合、ディレクトリとサブディレクトリを使用してカーネルソースコードをモジュール化しています。
 カプセル化
カプセル化とは、実装内部の関数とデータを隠すことです。Cでは、カプセル化はキーワードstaticを使用して行われます。これらのエンティティはファイルスコープの関数と変数と呼ばれます。
次のCQLinqクエリを実行して、すべてのstatic関数を検索してみましょう。

メトリクスビューを使用して、どれだけの関数が該当するかをよく把握できます。メトリクスビューでは、コードベースがツリーマップで表現されます。ツリーマッピングは、ネストされた長方形を使用してツリー構造のデータを表示する方法です。CppDependのツリーマップで使用されるツリー構造は、通常のコード階層です。
- プロジェクトはディレクトリを含む。
- ディレクトリはファイルを含む。
- ファイルは構造体、関数、変数を含む。
ツリーマップビューは、CQLinqクエリの結果を表現する便利な方法を提供し、クエリに該当する型を視覚的に確認できます。
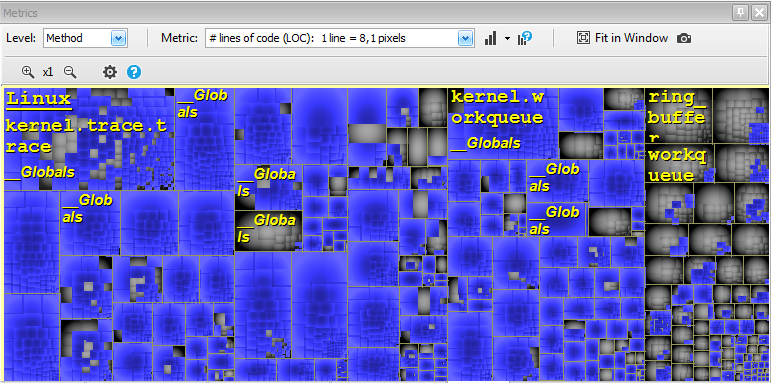
ご覧のとおり、多くの関数がstaticで宣言されています。
次にstaticフィールドを検索してみましょう。
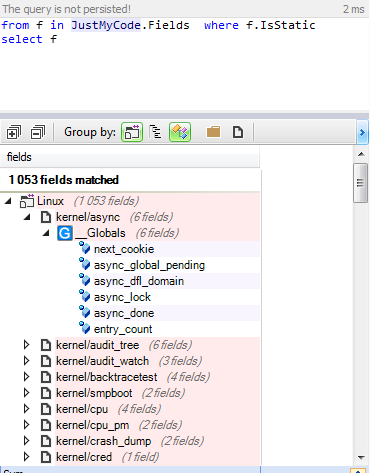
関数と同様に、多くの変数がstaticで宣言されています。
Linuxカーネルソースコードでは、関数と変数がファイルスコープに対してプライベートである必要がある場合には常にカプセル化が使用されています。
構造体を使用してデータモデルを格納する
Cプログラミングでは、関数は変数を使用して処理を実行します。これらの変数は次のものが考えられます。
- 静的変数。
- グローバル変数。
- ローカル変数。
- 構造体の変数。
各プロジェクトにはデータモデルがあり、多くのソースファイルで使用される可能性があります。グローバル変数を使用するのは1つの選択肢ですが、一般的には関連するデータを構造体にグループ化する方が適切です。
プリミティブ型のグローバル変数を検索してみましょう。
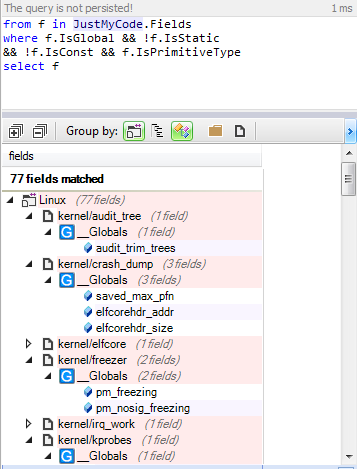
ごくわずかな変数のみが該当し、その一部は(elfcorehdr_addrとelfcorehdr_size)や(pm_freezingとpm_nosig_freezing)のように、おそらく構造体にグループ化できる可能性があります。
関数は短く心地よく保つ
関数の長さに関するアドバイスを、 Linuxコーディングスタイルのウェブページから紹介します。
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.
30行を超えるコードを持つ関数を検索してみましょう。
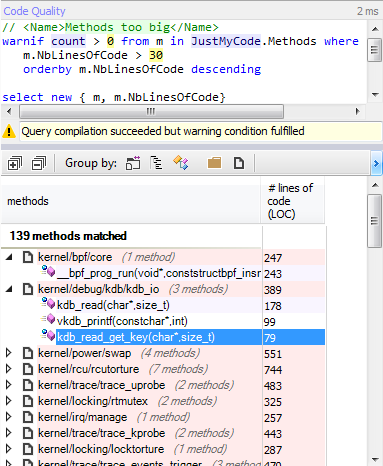
30行を超えるコードを持つメソッドはごくわずかです。
関数のパラメータ数
NbParameters > 8の関数は、呼び出しが苦痛になり、パフォーマンスを低下させる可能性があります。もう一つの選択肢は、引数の受け渡しを処理するための専用の構造体を提供することです。
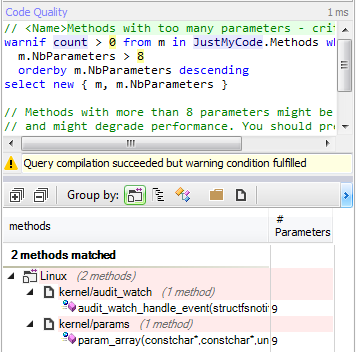
8つを超えるパラメータを持つ関数は2つだけです。
ローカル変数の数
NbVariablesが8を超えるメソッドは、理解と保守が困難になる可能性があります。NbVariablesが15を超えるメソッドは非常に複雑であり、ツールによって自動生成された場合を除き、より小さなメソッドに分割すべきです。
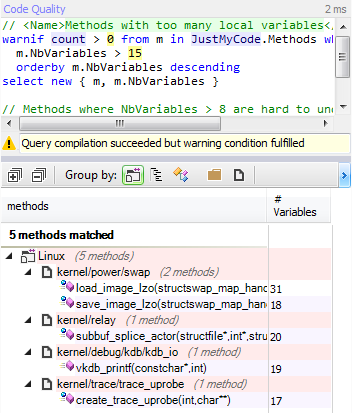
15を超えるローカル変数を持つ関数は5つだけです。
複雑な関数の定義を避ける
複雑な関数を特定するために多くのメトリクスを使用できます。NBLinesOfCode、パラメータの数、ローカル変数の数が最も基本的なものの一部です。
複雑な関数を特定するための他の有用なメトリクスもあります。
- 循環的複雑度は、手続き内で取り得る決定の数に等しい、人気のある手続き型ソフトウェアメトリクスです。
- ネスト深度は、メソッド本体内の最もネストされたスコープの最大深度に関する、メソッドに対して定義されるメトリクスです。
- 最大ネストループは、関数内のループネストの最大レベルに等しい値です。
これらのメトリクスの許容される最大値は、チームの好みに大きく依存します。普遍的なしきい値はありません。
リファクタリングの候補となる関数を検索してみましょう。
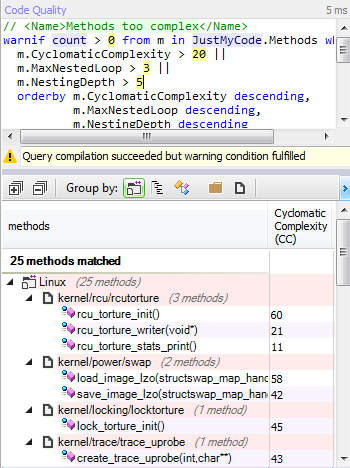
複雑と見なせる関数はごくわずかです。
命名規則
普遍的な命名規則はありません。各プロジェクトは、そのニーズに最も適したものを採用できます。最も重要なのは、選択した規則を一貫して適用することです。
Linuxの場合、構造体は小文字で始まらなければなりません。カーネルソースコード全体でそれが守られているかを確認できます。次のクエリを実行してみましょう。
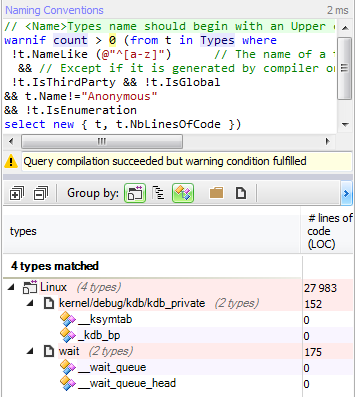
小文字の代わりに「_」で始まる構造体は4つだけです。
インデント
インデントはコードを読みやすくするのに非常に便利です。その背後にある動機を、 Linuxコーディングスタイルのウェブページから紹介します。
Rationale: The whole idea behind indentation is to clearly define where
a block of control starts and ends.  Especially when you've been looking
at your screen for 20 straight hours, you'll find it a lot easier to see
how the indentation works if you have large indentations.

Now, some people will claim that having 8-character indentations makes
the code move too far to the right, and makes it hard to read on a
80-character terminal screen.  The answer to that is that if you need
more than 3 levels of indentation, you're screwed anyway, and should fix
your program.有名なオープンソースプロジェクトを探索することは、特にそれらのプロジェクトがエキスパートによって開発・保守されている場合、プログラミングスキルを向上させる素晴らしい方法です。プロジェクトをダウンロードしてビルドする必要はありません。GitHubでコードを閲覧するだけでよいのです。