
Clang 已被证明是一个成熟的 C 和 C++ 编译器,与 GCC 和微软的编译器齐名,但它的特别之处在于它不仅仅是一个编译器。得益于其基于库的架构,它还是一个构建工具的基础设施,使其功能更容易被重用并集成到其他项目中。Clang 的设计:
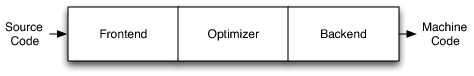
与许多其他编译器设计一样,Clang 编译器分为三个阶段:
- 前端解析源代码,检查错误,并构建特定语言的抽象语法树(AST)来表示输入代码。
- 优化器对前端生成的 AST 执行优化。
- 后端生成由机器执行的最终代码;它依赖于目标平台。
Clang 与其他编译器有什么区别?
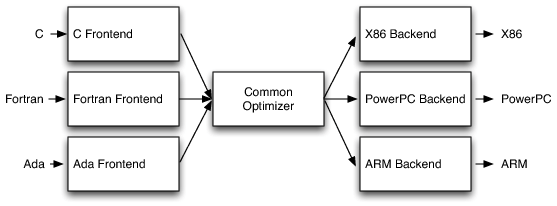
其设计中最重要的区别在于 Clang 基于 LLVM。LLVM 背后的理念是使用 LLVM 中间表示(IR),它类似于 Java 的字节码。LLVM IR 旨在承载编译器优化器部分中的中层分析和变换。它在设计时考虑了许多具体目标,包括支持轻量级运行时优化、跨函数/过程间优化、全程序分析和激进的重组变换等。不过,它最重要的一点是:它本身被定义为一种具有一等地位、语义定义明确的语言。
有了这种设计,我们可以重用编译器的一大部分来创建其他编译器;例如,您只需更换前端部分即可支持其他语言。
探索这个强大的编译器基础设施、了解它的设计和实现方式,是非常有意思的。C++ 开发者可以从它的代码库中学到许多良好的实践。
让我们使用CppDepend和CQLinq来透视它的源代码,探究其开发团队的一些设计和实现选择。
1- 模块化:
1-1 使用库进行模块化
Clang 的一个主要设计理念是采用基于库的架构。在这种设计中,前端的各个部分可以被清晰地划分为独立的库,然后根据不同需求和用途进行组合。此外,基于库的方式鼓励良好的接口设计,也让新开发者更容易参与进来(因为他们只需要理解全局中的一小部分)。
DSM(依赖结构矩阵)是表示和浏览组件之间依赖关系的一种紧凑方式。非空的 DSM 单元格包含一个数字,该数字代表该单元格所表示的耦合强度。耦合强度可以用参与耦合的成员/方法/字段/类型或命名空间的数量来表示。DSM 还可以向我们展示库之间的循环依赖。
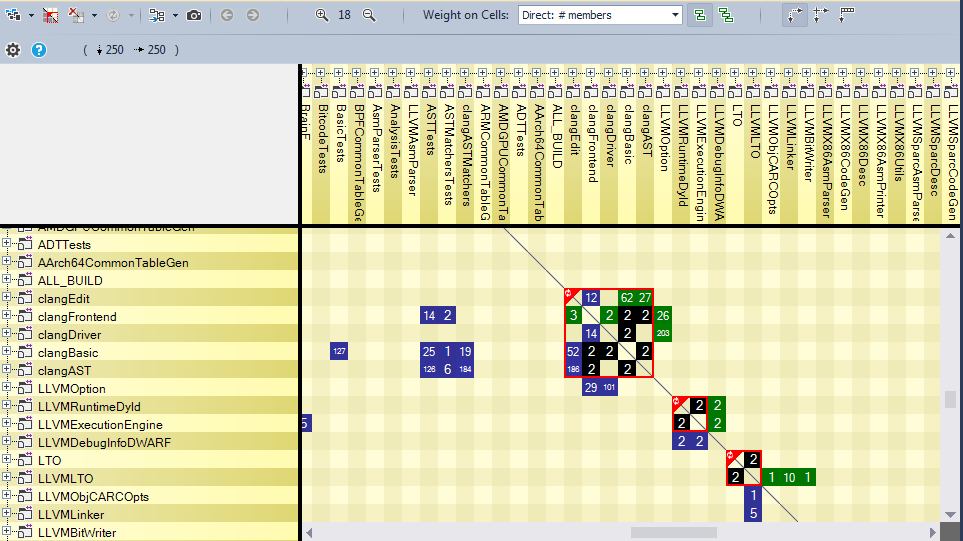
这张依赖图显示了 Clang 直接使用的库。
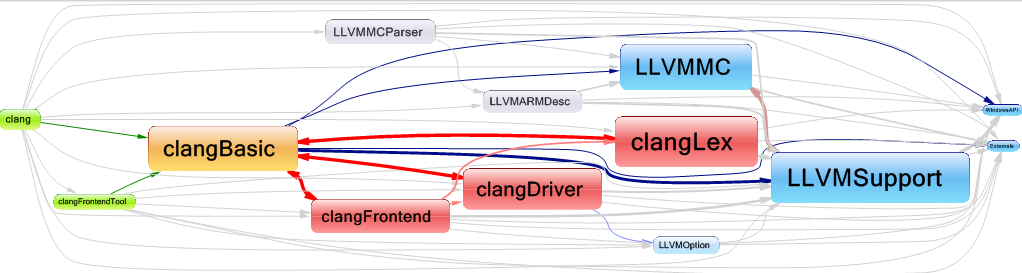
我们可以看到,clangBasic/clangFrontend、clangBasic/clangDriver 和 clangBasic/clangLex 这三对库之间存在循环依赖。建议消除库之间的循环依赖,使代码更易读、更易维护。
clangFrontend 使用 clangBasic 很正常。但是,为什么 clangBasic 会使用 clangFrontend 库呢?
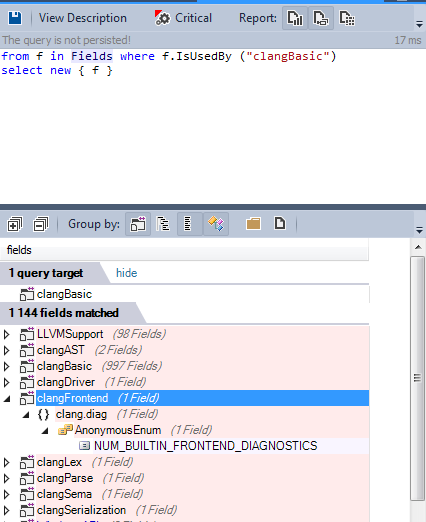
只有一个枚举字段导致了这个循环依赖;只需对代码进行重构,就能轻松消除这个依赖。
1-2 使用命名空间进行模块化
在 C++ 中,命名空间也被用来模块化代码库,对 LLVM/Clang 来说,使用命名空间主要有三个原因:
- 许多命名空间只包含枚举,如下面的 CQLinq 查询所示,它列出了只包含枚举的命名空间:
在大型项目中,无法保证两个不同的枚举不会使用相同的名称。这个问题在 C++11 中通过enum class得到了解决,它隐式地将枚举值限定在枚举名称的作用域内。代码可以在不久的将来重构为使用 C++11 的枚举类。
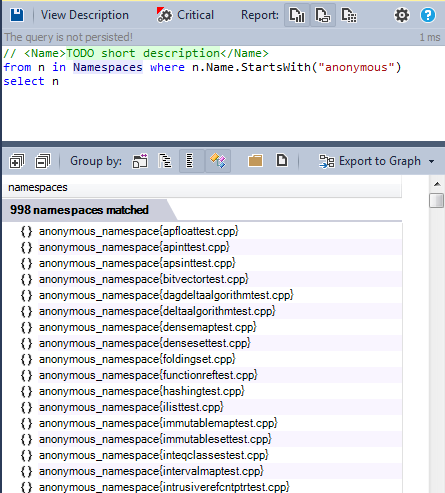
- 匿名命名空间:没有名字的命名空间可以避免创建全局静态变量。您创建的"匿名"命名空间只在创建它的文件中可访问。下面是使用的所有匿名命名空间的列表:
- 模块化代码库:让我们搜索所有非匿名命名空间:
命名空间为模块化应用程序提供了良好的方式。LLVM/Clang 定义了 500 多个命名空间来强化其模块化,这使代码更易读、更易维护。
2- 使用的编程范式:
C++ 不仅仅是一门面向对象的语言。正如 Bjarne Stroustrup 所指出的:"C++ 是一门多范式语言。"它支持许多不同的程序风格(即范式),面向对象编程只是其中之一。其他范式还包括过程式编程和泛型编程。
2-1 过程式范式
2-1-1 全局函数
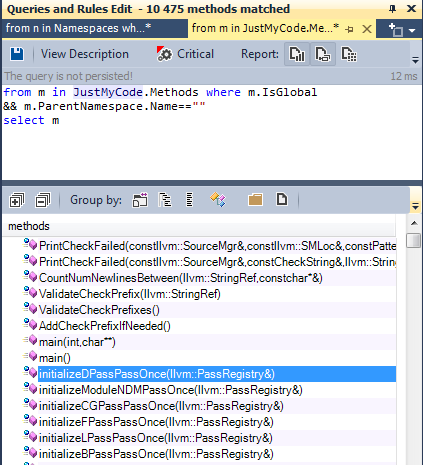
让我们搜索 LLVM/Clang 源代码中定义的所有全局函数:
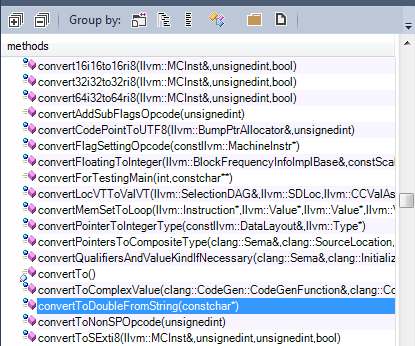
我们可以把这些函数分为三类:
1 – 工具函数:例如,许多函数涉及从一种类型到另一种类型的转换。
2 – 运算符:定义了许多运算符,如下面的 CQLinq 查询结果所示:
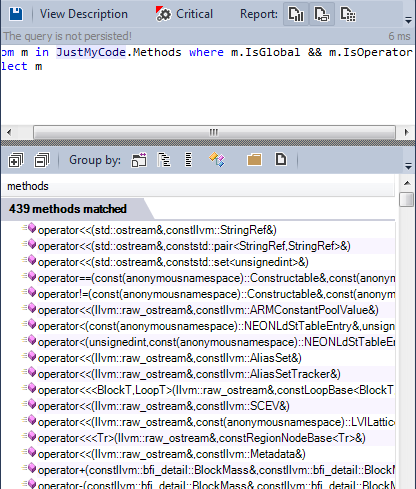
几乎所有种类的运算符都在 LLVM/Clang 源代码中实现了。
3 – 与编译器逻辑相关的函数:实现了许多包含编译器处理逻辑的全局函数。
也许这些函数可以按类别分组为类中的静态方法,或组织到命名空间中。
2-1-2 静态全局函数
除非您确实需要从其他源文件调用某个全局函数,否则将其声明为 static 是一项最佳实践。
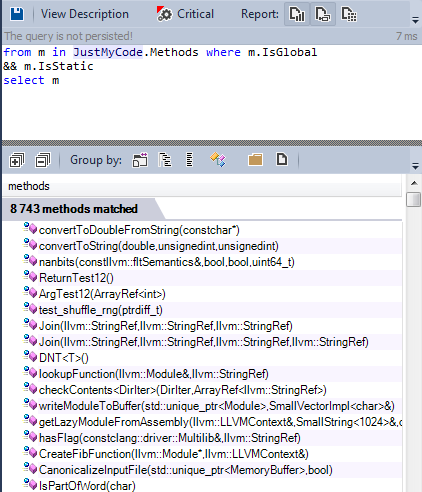
几乎所有全局函数都被声明为 static。
2-1-3 可以改为 static 的全局函数
未导出的全局函数——既未定义在匿名命名空间中,也未被定义文件之外的任何方法使用——是重构为 static 的良好候选。
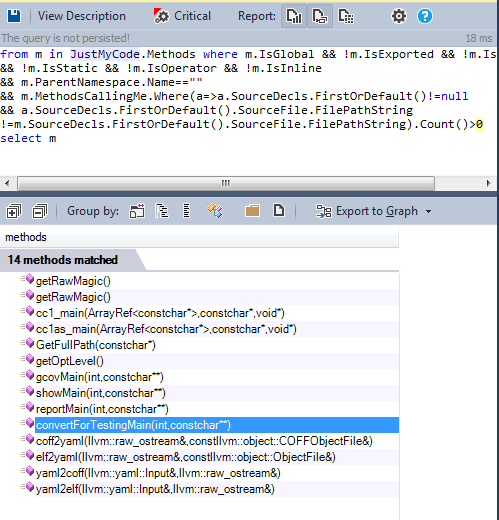
我们可以看到,很少有函数是重构为静态函数的候选。
2-2 面向对象范式
2-2-1 继承
在面向对象编程(OOP)中,继承是在对象之间建立"是一个"(is-a)关系的一种方式。它经常与重用现有代码的方式相混淆,而这不是好的做法,因为为实现重用而继承会导致紧耦合。代码重用应该通过组合来实现(组合优于继承)。让我们搜索所有至少拥有一个基类的类:
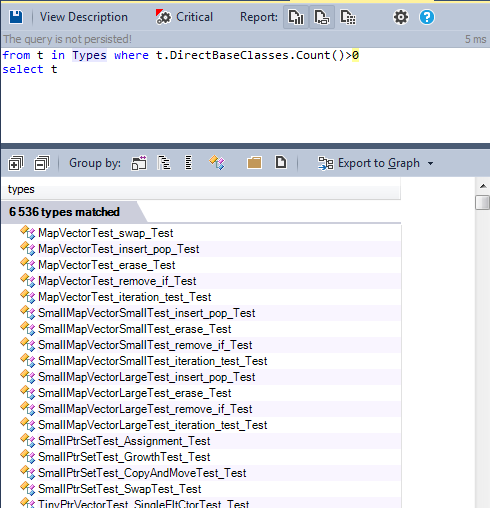
为了更好地了解该查询涉及的类,我们可以使用度量视图。
在度量视图中,代码库通过矩形树图(Treemap)表示。矩形树图是一种使用嵌套矩形展示树状结构数据的方法。CppDepend 矩形树图中使用的树结构是常见的代码层级:
- 项目包含命名空间。
- 命名空间包含类型。
- 类型包含方法和字段。
矩形树图视图为表示 CQLinq 查询结果提供了一种实用的方式,蓝色矩形代表查询结果,这样我们就可以直观地看到查询涉及的类型。
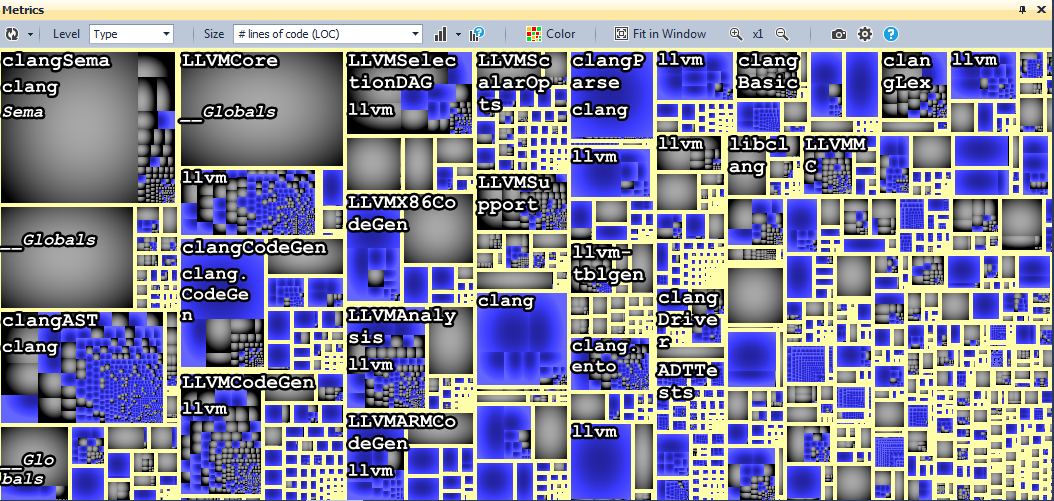
我们可以看到,继承在 LLVM/Clang 源代码中被广泛使用。
多重继承:让我们搜索继承自多个具体类的类。
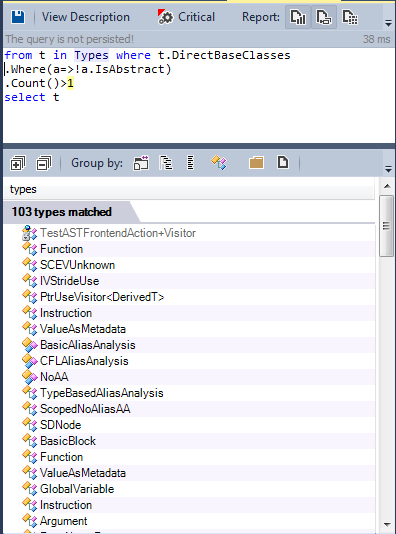
多重继承并未被广泛使用;只有不到 1% 的类继承自多个类。
2-2-2 虚方法
让我们搜索源代码中定义的所有虚方法:
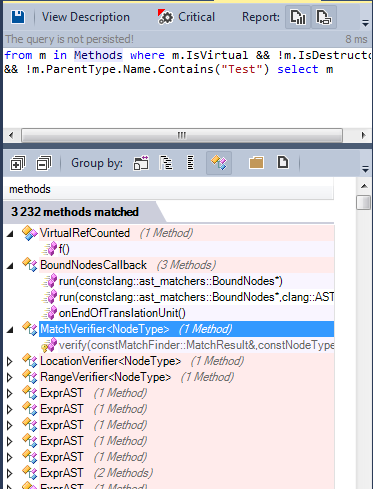
许多方法是虚方法,其中一些是纯虚方法:
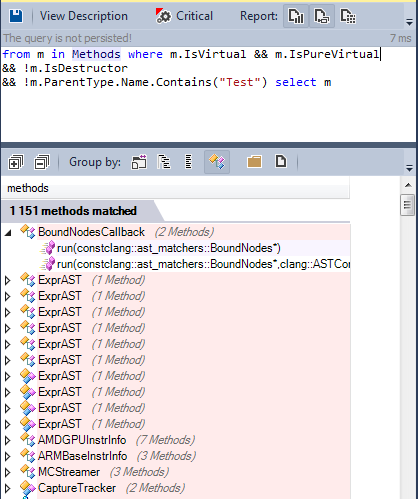
OOP 范式在 LLVM/Clang 源代码中被广泛使用。那么泛型编程范式呢?
2-3 泛型编程
C++ 通过模板提供了表达泛型编程思想的独特能力。模板提供了一种参数化多态形式,可以表达泛型算法和数据结构。C++ 模板的实例化机制确保:当泛型算法或数据结构被使用时,会针对该特定用途创建一个完全优化的特化版本,使泛型算法能够与非泛型算法一样高效。
2-3-1 泛型类型
让我们搜索引擎源代码中定义的所有泛型类型:
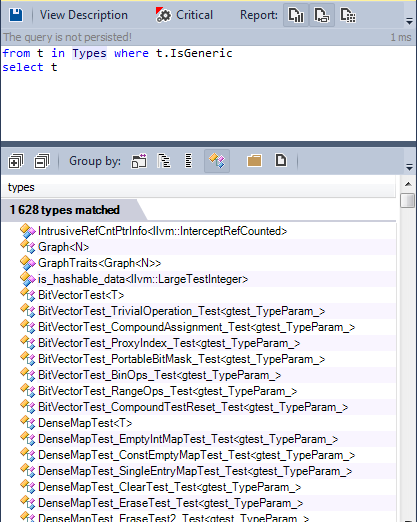
许多类型被定义为泛型。现在让我们搜索泛型方法:
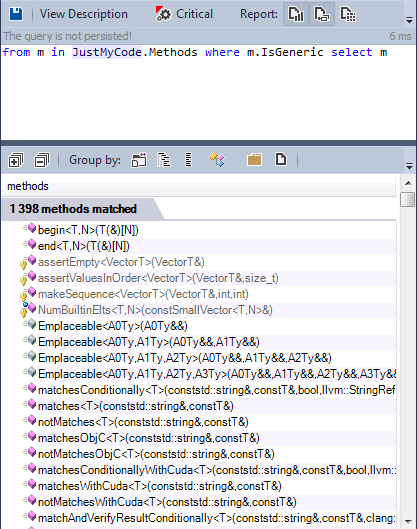
不到 1% 的方法是泛型的。
总结一下,LLVM/Clang 源代码混合使用了三种范式。
3- 用 POD 定义数据模型
在面向对象编程中,POD(plain old data,平凡旧数据)是一种仅表示为被动字段值集合(实例变量)的数据结构,不使用面向对象的特性。在计算机科学中,这被称为被动数据结构。
让我们搜索源代码中的 POD 类型。
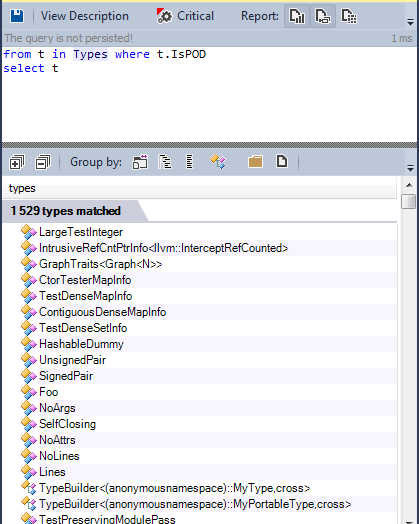
超过 1500 个类型被定义为 POD 类型;其中许多用于定义编译器的数据模型。
4- 四人帮(GoF)设计模式
设计模式是软件工程中的一个概念,描述软件设计中常见问题的复用性解决方案。四人帮模式是其中最著名的。让我们来看看 LLVM/Clang 源代码中使用的一些模式。
4-1 工厂模式
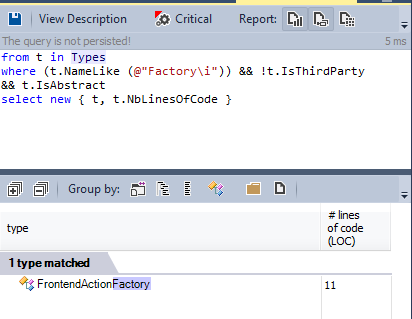
使用工厂有助于隔离实例化逻辑并提高内聚性。下面是源代码中定义的工厂列表:
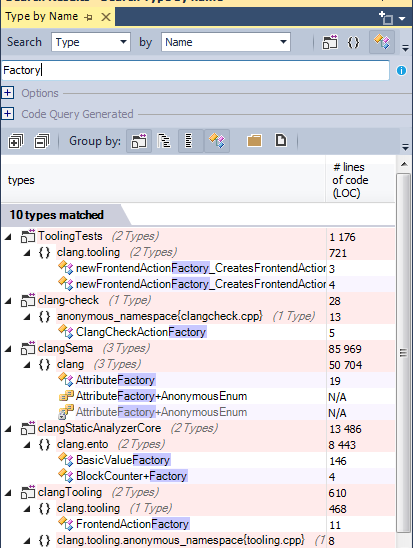
下面是抽象工厂的列表:
4-3 观察者模式
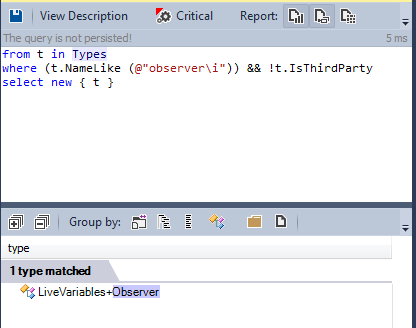
观察者模式是一种软件设计模式,其中一个对象维护一个依赖者列表(称为观察者),并在任何状态发生变化时自动通知它们,通常是调用它们的某个方法。
源代码中只定义了一个观察者:
4-4 访问者模式
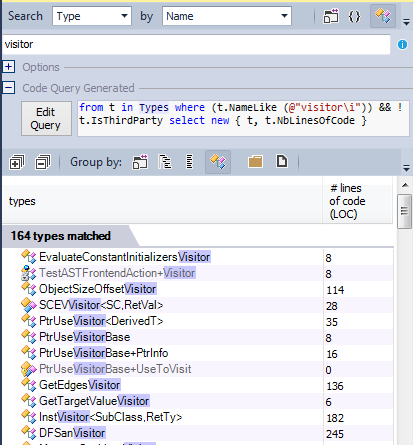
当我们需要遍历一个结构并对其每个节点执行特定操作时,推荐使用访问者模式。
在 LLVM/Clang 源代码中,访问者模式被广泛使用:
5- 耦合与内聚
5-1 耦合
低耦合是可取的,因为应用程序某一区域的变更将减少对整个应用程序其他部分的修改需求。从长远来看,这可以节省大量与修改和添加新功能相关的时间、精力和成本。
低耦合可以通过使用抽象类或使用泛型类型和方法来实现。
让我们搜索源代码中定义的所有抽象类:
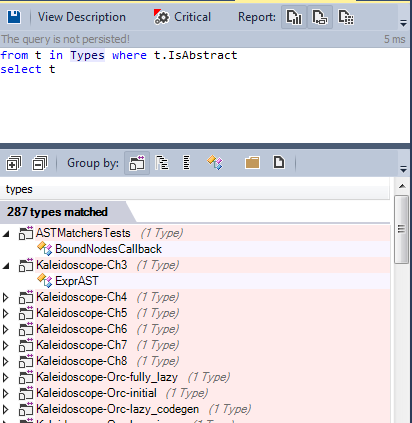
超过 280 个类型被声明为抽象的。不过,低耦合也通过使用泛型类型和泛型方法得以强化。
内聚
单一职责原则指出,一个类不应该有超过一个变更的理由。这样的类被称为内聚的。高 LCOM 值通常表明类的内聚性较差。LCOM 度量有好几种。LCOM 的取值范围是 [0-1]。LCOM HS(HS 代表 Henderson-Sellers) 的取值范围是 [0-2]。LCOM HS 值高于 1 应被视为警示信号。下面是 LCOM 度量的计算方法:
LCOM = 1 – (sum(MF)/M*F);LCOM HS = (M – sum(MF)/F)(M-1)
其中:
- M 是类中方法的数量(静态方法和实例方法都计入;还包括构造函数、属性的 getter/setter 以及事件的 add/remove 方法)。
- F 是类中实例字段的数量。
- MF 是访问某个特定实例字段的类方法数量。
- Sum(MF) 是对类中所有实例字段的 MF 求和。
这些公式背后的基本思想可以表述为:如果一个类的所有方法都使用它的所有实例字段,那么这个类就是完全内聚的,这意味着 sum(MF)=M*F,于是 LCOM = 0 且 LCOMHS = 0。
LCOMHS 值高于 1 应被视为警示信号。
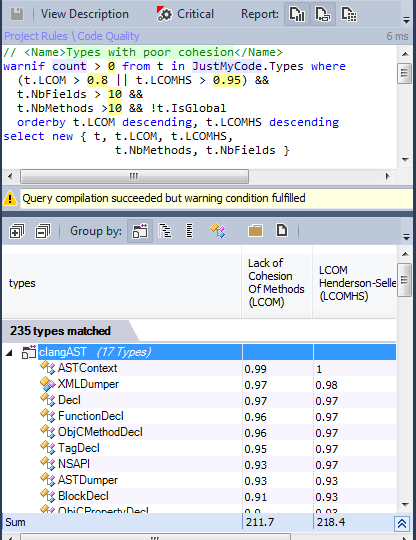
涉及 235 个类;也许其中一些类可以通过重构来提高内聚性。
6- 不可变性、纯性与副作用
6-1 不可变类型
基本上,如果一个对象在创建后其状态不再改变,那么它就是不可变的。因此,如果一个类的实例是不可变的,这个类就是不可变的。
使用不可变对象有一个重要理由:它能极大简化并发编程。想一想——为什么编写正确的多线程代码是一项艰巨的任务?因为很难同步多个线程对资源(对象或其他操作系统资源)的访问。为什么难以同步这些访问?因为很难保证多个线程对多个对象进行的多次读写访问之间不会发生竞态条件。如果不再有写访问呢?换句话说,如果线程访问的对象的状态不再改变呢?那就不再需要同步了!
不可变类的另一个好处是它们永远不会违反 LSP(里氏替换原则)。下面是引自其维基百科页面的 LSP 定义:
Liskov 的行为子类型概念定义了可变对象的可替换性概念;也就是说,如果 S 是 T 的子类型,那么程序中 T 类型的对象可以替换为 S 类型的对象,而不改变该程序的任何期望属性(例如正确性)。
下面是源代码中定义的不可变类型列表:
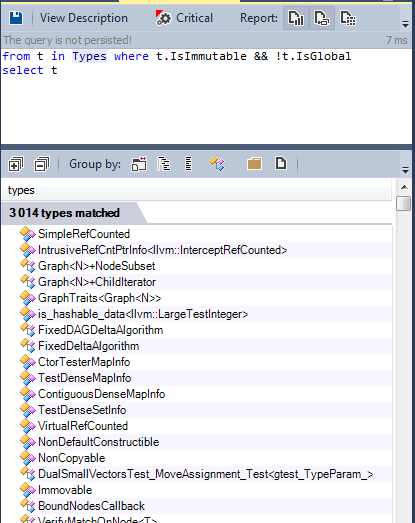
6-2 纯性与副作用
不可变类型的主要好处在于它们消除了副作用。关于这一点,Wes Dyer说得比我好,所以我引用他的话:
我们都知道,一般来说使用全局变量不是好主意。这基本上是暴露副作用的极端情况(全局作用域)。许多不使用全局变量的程序员没有意识到,同样的原则在更小的范围内也适用于字段、属性、参数和变量:除非有充分的理由,否则不要修改它们。(……)提高单元可靠性的一种方法是消除副作用。这让单元的组合和集成变得更加容易和健壮。由于它们没有副作用,无论环境如何,它们的行为总是一致的。这被称为引用透明性。
编写没有副作用的函数/方法——也就是纯函数,即不修改对象的函数——可以让您更容易推理程序的正确性。
下面是所有无副作用方法的列表。
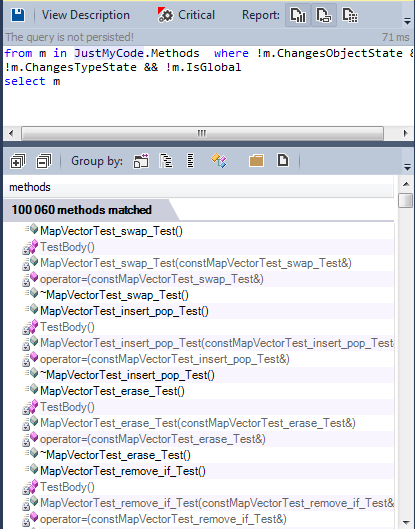
超过 10 万个方法是纯函数。
7- 实现质量
7-1 过大的方法
代码行数很多的方法不易维护和理解。让我们搜索超过 60 行的方法。
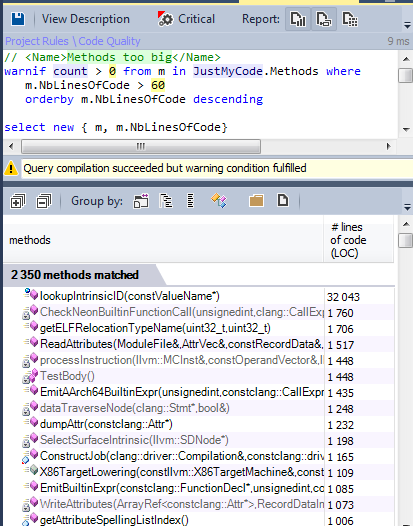
LLVM/Clang 源代码包含超过 10 万个方法,因此不到 2% 的方法可以被认为是过大的。
7-2 参数过多的方法
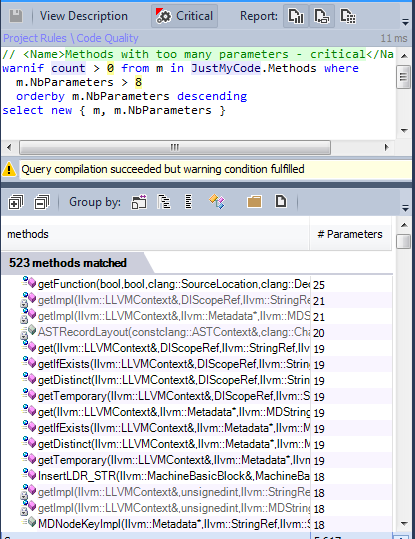
很少有方法拥有超过 8 个参数。
7-3 局部变量过多的方法
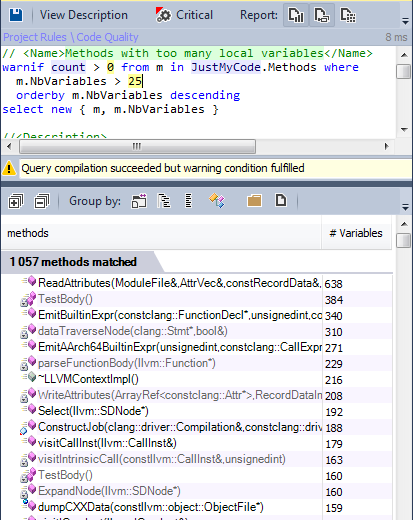
不到 1% 的方法拥有大量局部变量。
7-4 过于复杂的方法
有许多度量可以检测复杂函数;代码行数(NBLinesOfCode)、参数个数和局部变量个数是其中最基本的。
还有其他一些检测复杂函数的有趣度量:
- 圈复杂度是一个流行的过程式软件度量,等于一个过程中可能发生的决策数量。
- 嵌套深度是针对方法定义的度量,与方法体中最深层嵌套作用域的最大深度相关。
- 最大嵌套循环(Max Nested Loops)等于函数中循环嵌套的最大层数。
这些度量可容忍的最大值取决于团队的选择;没有标准值。
让我们在代码库中搜索可以被认为是复杂的方法。
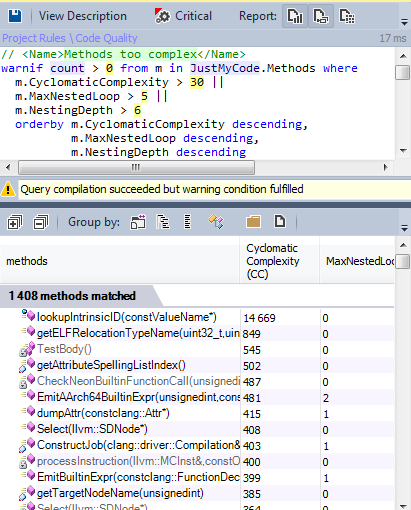
只有 1.5% 的方法是降低复杂度的重构候选。
7-5 Halstead 复杂度
Halstead 复杂度度量是 Maurice Howard Halstead 于 1977 年提出的软件度量。Halstead 认为,软件的度量应该反映算法在不同语言中的实现或表达,但独立于其在特定平台上的执行。因此,这些度量是从代码中静态计算出来的。
Halstead 引入了许多度量。让我们以 TimeToImplement 为例,它表示编写一个方法所需的时间(以秒为单位)。
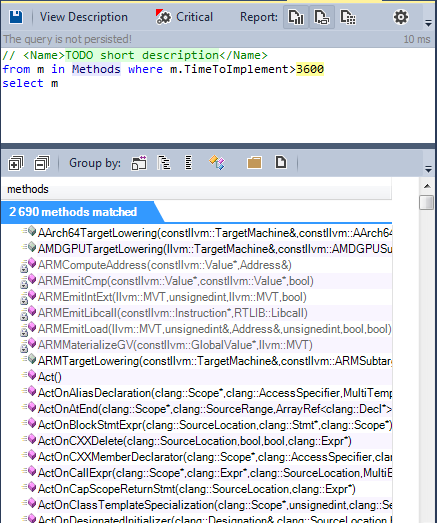
有 2690 个方法需要超过一小时才能实现。
8- RTTI
RTTI 指系统在运行时(而非编译时)报告对象动态类型并提供该类型信息的能力。然而,RTTI 在 C++ 社区中一直存在争议。许多 C++ 开发者选择不使用这一机制。
LLVM/Clang 开发团队呢?
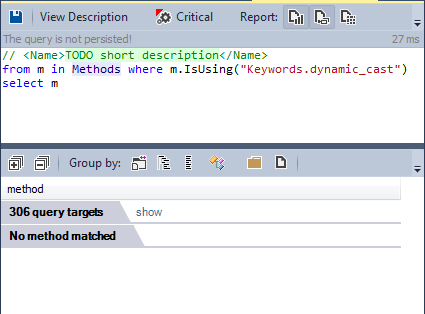
没有任何方法使用 dynamic_cast 关键字。LLVM/Clang 团队选择不使用 RTTI 机制。
9- 异常
异常处理是另一个有争议的 C++ 特性。许多知名的开源 C++ 项目都不使用它。
让我们搜索源代码中是否抛出了异常。
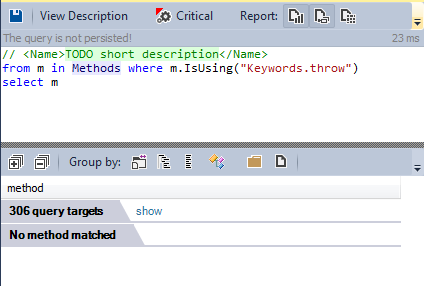
与 RTTI 一样,异常机制也未被使用。
10- 一些统计数据
10-1 最常用的类型
了解一个项目中最常用的类型是很有意义的;事实上,这些类型必须被精心设计、实现和测试,对它们的任何修改都可能影响整个项目。
我们可以使用TypesUsingMe度量来找到它们:
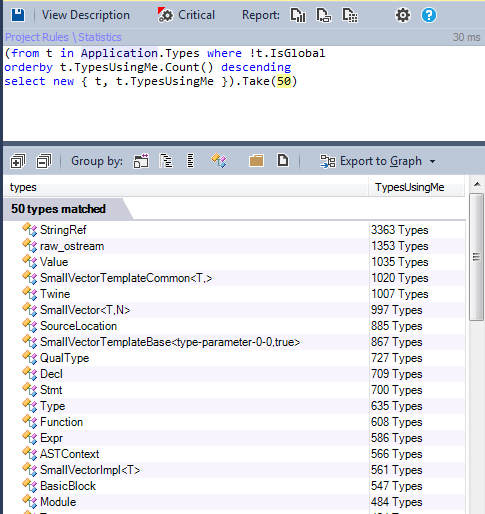
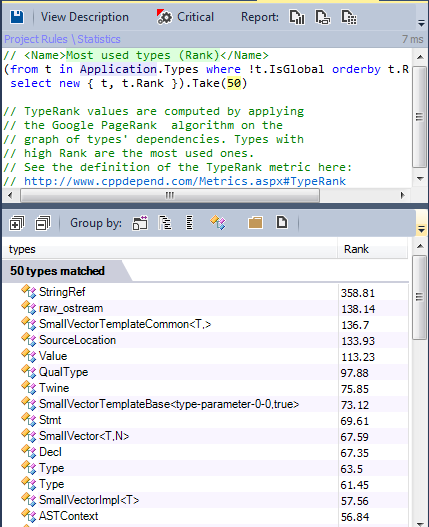
不过,还有另一个查找热门类型的有趣度量:TypeRank。
TypeRank 值是通过将谷歌 PageRank 算法应用于类型依赖图计算得出的。应用了以 0.15 为中心的相似变换,使平均 TypeRank 为 1。
TypeRank 高的类型应该经过更仔细的测试,因为这类类型中的 Bug 可能会造成更严重的后果。
下面是按 TypeRank 度量得出的所有热门类型的结果:
10-2 最常用的方法
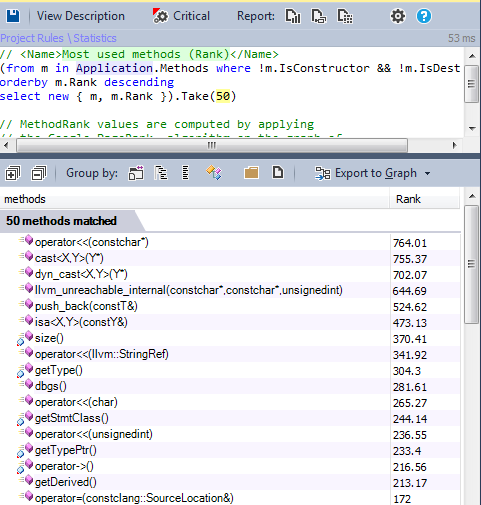
10-3 调用许多其他方法的方法
了解使用了大量其他方法的方法是很有意义的;这可能揭示这些方法中的设计问题,在某些情况下需要进行重构,使其更易读、更易维护。
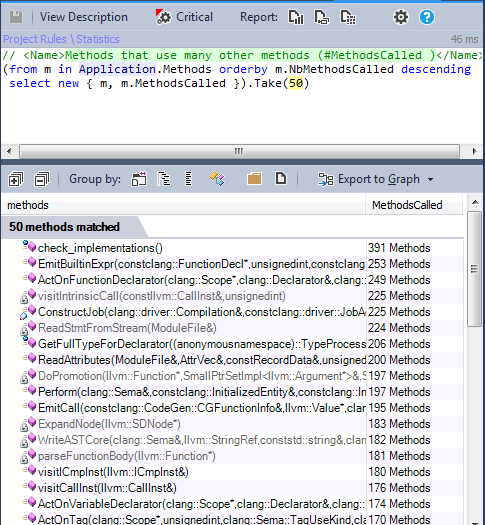
总结
LLVM/Clang 设计和实现得非常出色,与任何其他项目一样,可以通过一些重构来改进它。在本文中,我们发现了源代码中可以做出的一些小改进。欢迎您深入研究它的源代码,以提升您的 C++ 技能。