
Clang s'est révélé être un compilateur mature pour le C et le C++, comme GCC et les compilateurs de Microsoft, mais ce qui le rend spécial, c'est qu'il n'est pas seulement un compilateur. C'est aussi une infrastructure pour construire des outils, grâce à son architecture fondée sur des bibliothèques, qui facilite la réutilisation de ses fonctionnalités et leur intégration dans d'autres projets. La conception de Clang :
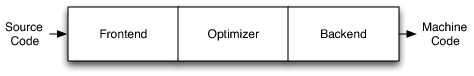
Comme beaucoup d’autres conceptions de compilateurs, le compilateur Clang comporte trois phases :
- Le front end analyse le code source, vérifie l'absence d'erreurs et construit un arbre syntaxique abstrait (AST) spécifique au langage pour représenter le code d'entrée.
- L'optimiseur effectue des optimisations sur l'AST généré par le front end.
- Le back end génère le code final à exécuter par la machine ; il dépend de la cible.
Quelle est la différence entre Clang et les autres compilateurs ?
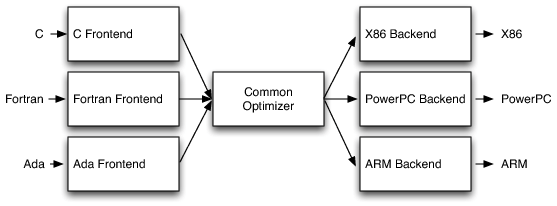
La différence la plus importante dans sa conception est que Clang est fondé sur LLVM. L'idée derrière LLVM est d'utiliser la représentation intermédiaire LLVM (LLVM IR), qui s'apparente au bytecode de Java. LLVM IR est conçue pour accueillir les analyses et transformations de niveau intermédiaire que l'on trouve dans la partie optimiseur d'un compilateur. Elle a été conçue avec de nombreux objectifs précis en tête, notamment la prise en charge d'optimisations légères à l'exécution, d'optimisations inter-fonctions/interprocédurales, de l'analyse de programme complet et de transformations de restructuration agressives, etc. Son aspect le plus important, cependant, est qu'elle est elle-même définie comme un langage de premier ordre doté d'une sémantique bien définie.
Avec cette conception, nous pouvons réutiliser une grande partie du compilateur pour créer d'autres compilateurs ; vous pouvez, par exemple, simplement changer la partie front end pour prendre en charge d'autres langages.
Il est très intéressant d'explorer cette puissante infrastructure de compilation et de découvrir comment elle est conçue et implémentée. Les développeurs C++ peuvent tirer de nombreuses bonnes pratiques de sa base de code.
Passons son code source aux rayons X à l'aide de CppDepend et CQLinq pour explorer certains choix de conception et d'implémentation de son équipe de développement.
1- La modularité :
1-1 La modularité à l'aide de bibliothèques
Un concept de conception majeur de Clang est son utilisation d'une architecture fondée sur des bibliothèques. Dans cette conception, les différentes parties du front-end peuvent être clairement divisées en bibliothèques distinctes, qui peuvent ensuite être combinées selon différents besoins et usages. En outre, l'approche par bibliothèques encourage de bonnes interfaces et facilite l'implication de nouveaux développeurs (car ils n'ont besoin de comprendre que de petites parties de l'ensemble).
La DSM (Dependency Structure Matrix) est un moyen compact de représenter et de parcourir les dépendances entre les composants. Une cellule DSM non vide contient un nombre. Ce nombre représente la force du couplage représenté par la cellule. La force du couplage peut s'exprimer en nombre de membres/méthodes/champs/types ou espaces de noms impliqués dans le couplage. La DSM peut aussi nous montrer les cycles de dépendances entre les bibliothèques.
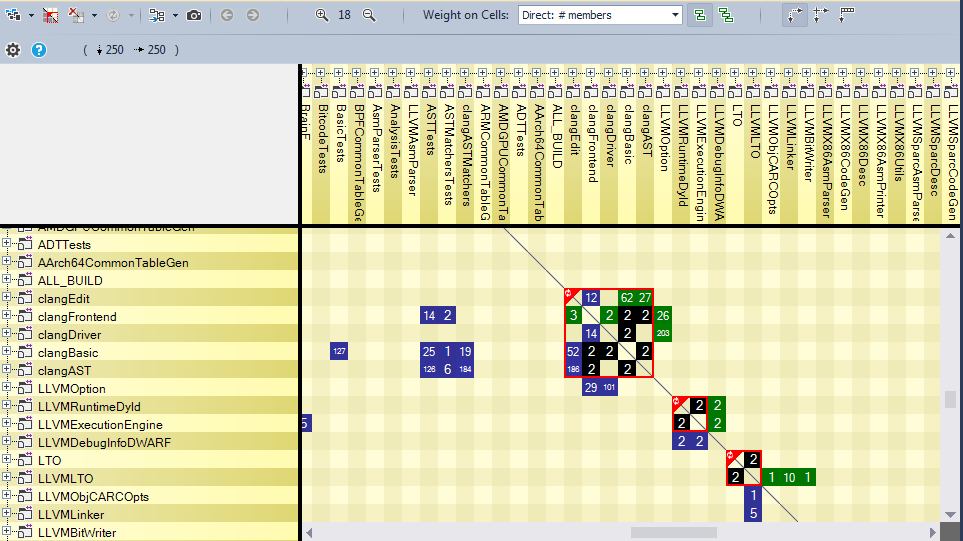
Ce graphe de dépendances montre les bibliothèques utilisées directement par Clang.
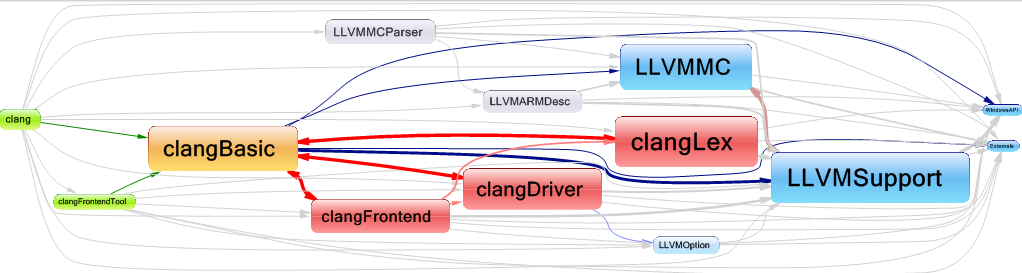
Comme on peut le voir, il existe trois cycles de dépendances entre les bibliothèques clangBasic/clangFrontend, clangBasic/clangDriver et clangBasic/clangLex. Il est recommandé d'éliminer les cycles de dépendances entre bibliothèques pour rendre le code plus lisible et plus maintenable.
Il est normal que clangFrontend utilise clangBasic. En revanche, pourquoi clangBasic utilise-t-elle la bibliothèque clangFrontend ?
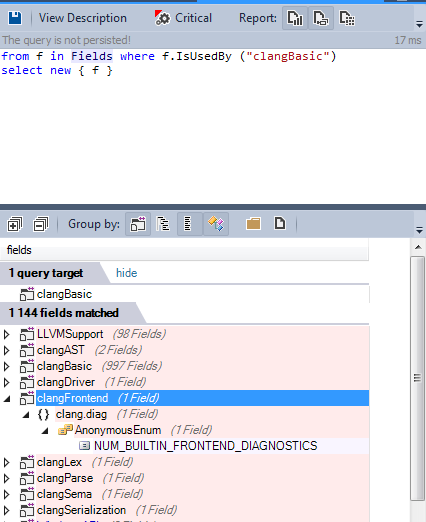
Un seul champ d'énumération provoque ce cycle de dépendances ; le code pourrait être refactorisé pour supprimer facilement cette dépendance.
1-2 La modularité à l'aide d'espaces de noms
En C++, les espaces de noms sont également utilisés pour modulariser la base de code, et pour LLVM/Clang, ils servent trois raisons principales :
- De nombreux espaces de noms ne contiennent que des énumérations, comme le montre cette requête CQLinq, qui nous donne ceux qui ne contiennent que des énumérations :
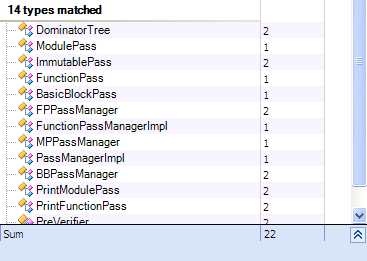
Dans un grand projet, rien ne garantit que deux énumérations distinctes n'utilisent pas le même nom. Ce problème a été résolu dans C++11 à l'aide de enum class, qui limite implicitement la portée des valeurs de l'énumération au nom de celle-ci. Le code pourrait être refactorisé dans un avenir proche pour utiliser les énumérations de classes de C++11.
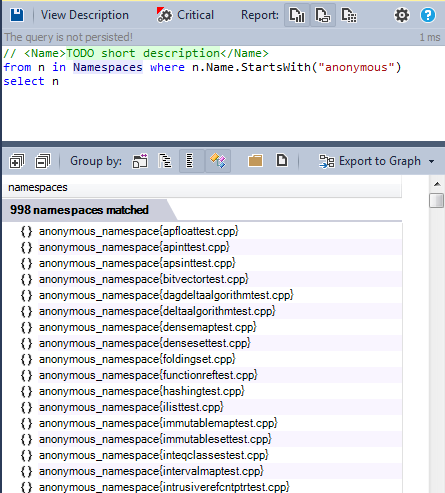
- Les espaces de noms anonymes : un espace de noms sans nom évite de créer des variables globales statiques. L'espace de noms « anonyme » que vous avez créé ne sera accessible que dans le fichier où vous l'avez créé. Voici la liste de tous les espaces de noms anonymes utilisés :
- Modulariser la base de code : cherchons tous ceux qui ne sont pas anonymes :
Les espaces de noms offrent un bon moyen de modulariser une application. LLVM/Clang définit plus de 500 espaces de noms pour renforcer sa modularité, ce qui rend le code plus lisible et plus maintenable.
2- Le paradigme utilisé :
Le C++ n'est pas seulement un langage orienté objet. Comme le souligne Bjarne Stroustrup, « le C++ est un langage multi-paradigmes ». Il prend en charge de nombreux styles de programmes, ou paradigmes, différents, et la programmation orientée objet n'en est qu'un. Parmi les autres figurent la programmation procédurale et la programmation générique.
2-1 Le paradigme procédural
2-1-1 Les fonctions globales
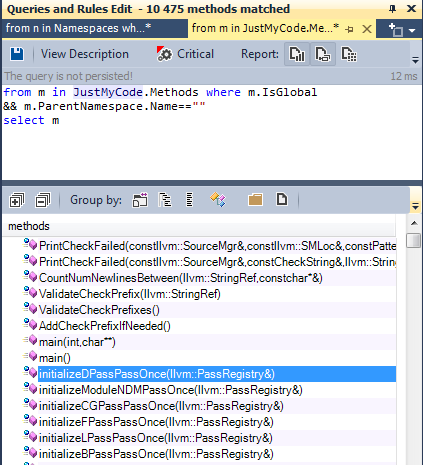
Cherchons toutes les fonctions globales définies dans le code source de LLVM/Clang :
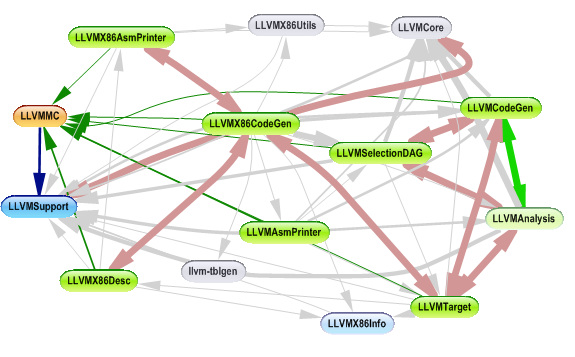
Nous pouvons classer ces fonctions en trois catégories :
1 – Les fonctions utilitaires : par exemple, de nombreuses fonctions concernent la conversion d'un type vers un autre.
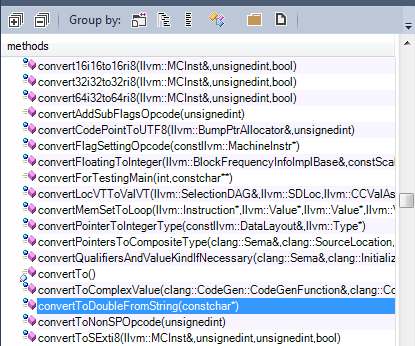
2 – Les opérateurs : de nombreux opérateurs sont définis, comme le montre le résultat de cette requête CQLinq :
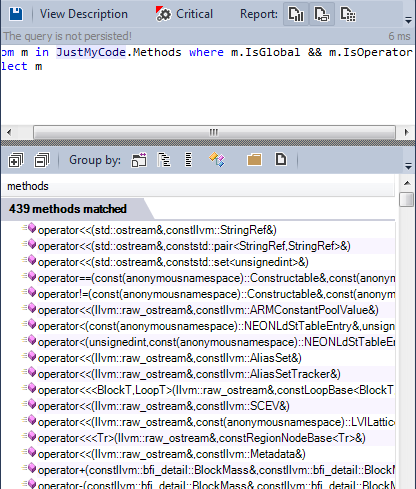
Presque toutes les sortes d'opérateurs sont implémentées dans le code source de LLVM/Clang.
3 – Les fonctions liées à la logique du compilateur : de nombreuses fonctions globales contenant des traitements du compilateur sont implémentées.
Ces fonctions pourraient peut-être être regroupées par catégorie sous forme de méthodes statiques dans des classes, ou organisées en espaces de noms.
2-1-2 Les fonctions globales statiques
C'est une bonne pratique de déclarer une fonction globale comme statique, sauf si vous avez un besoin précis de l'appeler depuis un autre fichier source.
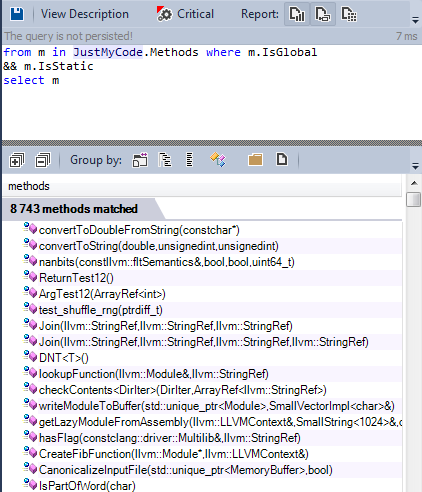
Presque toutes les fonctions globales sont déclarées statiques.
2-1-3 Les fonctions globales candidates à devenir statiques
Les fonctions globales non exportées, non définies dans un espace de noms anonyme et non utilisées par une méthode en dehors du fichier où elles sont définies, sont de bonnes candidates pour être refactorisées en fonctions statiques.
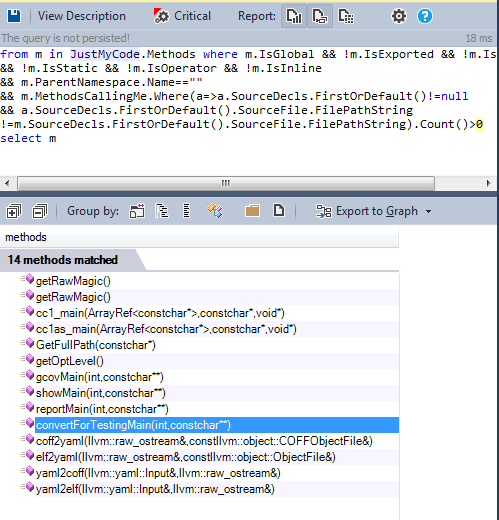
Comme on peut le voir, très peu de fonctions sont candidates à une refactorisation en fonctions statiques.
2-2 Le paradigme orienté objet
2-2-1 L'héritage
En programmation orientée objet (POO), l'héritage est un moyen d'établir une relation « est un » entre des objets. Il est souvent confondu avec un moyen de réutiliser du code existant, ce qui n'est pas une bonne pratique, car l'héritage pour la réutilisation d'implémentation conduit à un couplage fort. La réutilisabilité du code s'obtient par la composition (la composition plutôt que l'héritage). Cherchons toutes les classes qui ont au moins une classe de base :
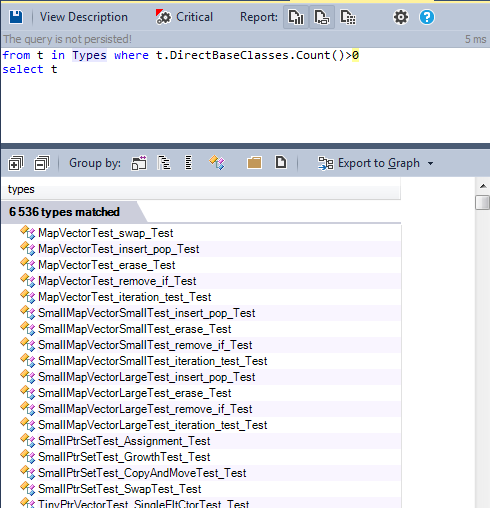
Et pour avoir une meilleure idée des classes concernées par cette requête, nous pouvons utiliser la vue métriques.
Dans la vue métriques, la base de code est représentée à l'aide d'une treemap. Le treemapping est une méthode d'affichage de données structurées en arbre au moyen de rectangles imbriqués. La structure arborescente utilisée dans une treemap CppDepend est la hiérarchie habituelle du code :
- Les projets contiennent des espaces de noms.
- Les espaces de noms contiennent des types.
- Les types contiennent des méthodes et des champs.
La vue treemap offre un moyen pratique de représenter le résultat d'une requête CQLinq ; les rectangles bleus représentent ce résultat, ce qui permet de voir visuellement les types concernés par la requête.
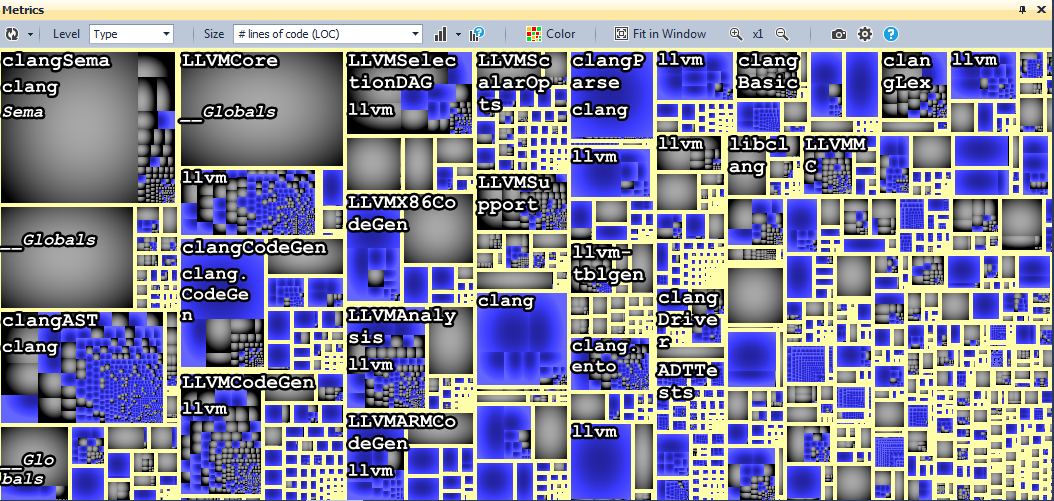
Comme on peut le constater, l'héritage est largement utilisé dans le code source de LLVM/Clang.
L'héritage multiple : cherchons les classes héritant de plus d'une classe concrète.
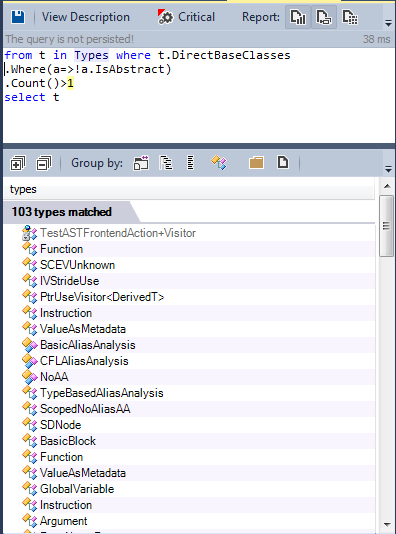
L'héritage multiple n'est pas largement utilisé ; moins de 1 % des classes héritent de plus d'une classe.
2-2-2 Les méthodes virtuelles
Cherchons toutes les méthodes virtuelles définies dans le code source :
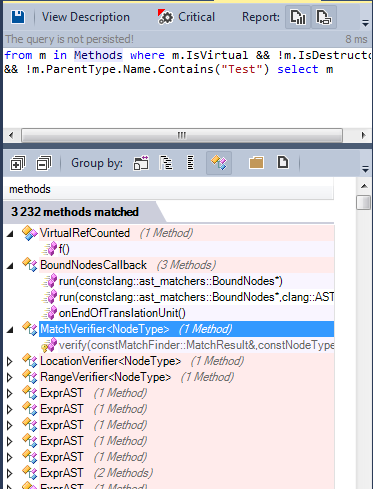
De nombreuses méthodes sont virtuelles, et certaines sont virtuelles pures :
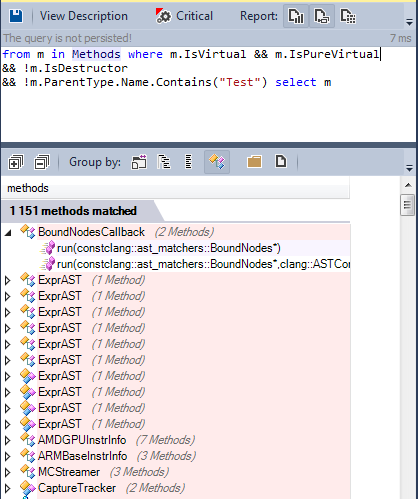
Le paradigme POO est largement utilisé dans le code source de LLVM/Clang. Qu'en est-il du paradigme de la programmation générique ?
2-3 La programmation générique
Le C++ offre des capacités uniques pour exprimer les idées de la programmation générique grâce aux templates. Les templates fournissent une forme de polymorphisme paramétrique qui permet d'exprimer des algorithmes et des structures de données génériques. Le mécanisme d'instanciation des templates C++ garantit que, lorsqu'un algorithme ou une structure de données générique est utilisé, une version entièrement optimisée et spécialisée sera créée et adaptée à cet usage particulier, permettant aux algorithmes génériques d'être aussi efficaces que leurs homologues non génériques.
2-3-1 Les types génériques
Cherchons tous les types génériques définis dans le code source du moteur :
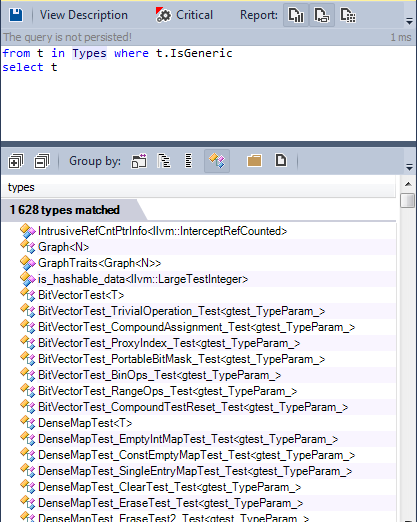
De nombreux types sont définis comme génériques. Cherchons maintenant les méthodes génériques :
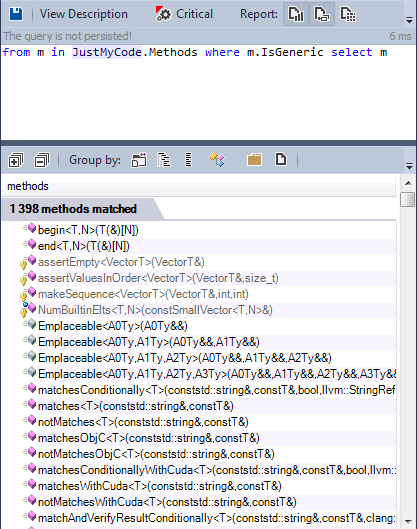
Moins de 1 % des méthodes sont génériques.
Pour résumer, le code source de LLVM/Clang mélange les trois paradigmes.
3- Des POD pour définir le modèle de données
En programmation orientée objet, un plain old data (POD) est une structure de données représentée uniquement comme une collection passive de valeurs de champs (variables d'instance), sans utiliser de fonctionnalités orientées objet. En informatique, on parle de structure de données passive.
Cherchons les types POD dans le code source.
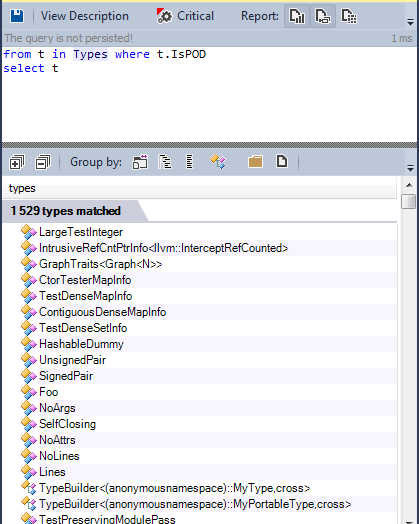
Plus de 1 500 types sont définis comme des types POD ; beaucoup d'entre eux servent à définir le modèle de données du compilateur.
4- Les design patterns du Gang of Four
Les design patterns sont un concept de génie logiciel décrivant des solutions récurrentes à des problèmes courants de conception logicielle. Les patterns du Gang of Four figurent parmi les plus populaires. Découvrons-en quelques-uns utilisés dans le code source de LLVM/Clang.
4-1 La fabrique (Factory)
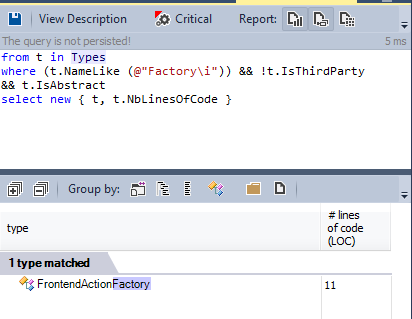
L'utilisation d'une fabrique aide à isoler la logique d'instanciation et à améliorer la cohésion. Voici la liste des fabriques définies dans le code source :
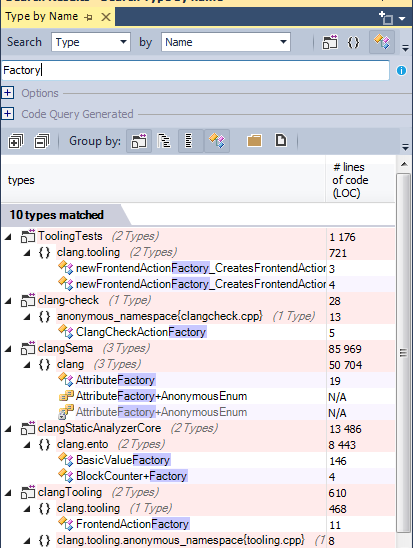
Et voici la liste de celles qui sont abstraites :
4-3 L'observateur (Observer)
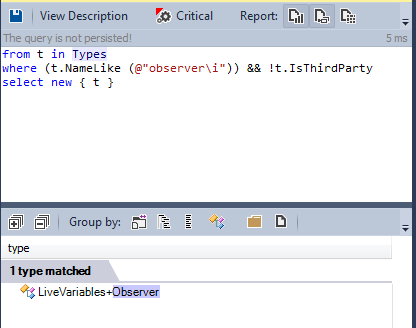
Le pattern observateur est un design pattern logiciel dans lequel un objet maintient une liste de ses dépendants, appelés observateurs, et les notifie automatiquement de tout changement d'état, généralement en appelant l'une de leurs méthodes.
Un seul observateur est défini dans le code source :
4-4 Le visiteur (Visitor)
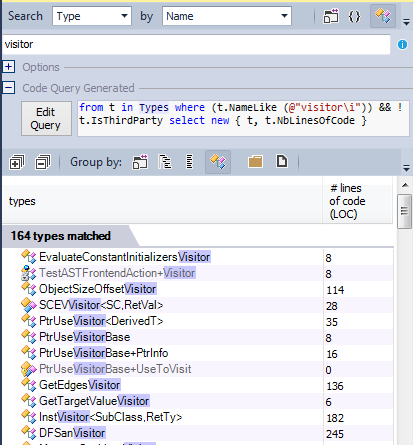
Le pattern visiteur est recommandé lorsqu'il faut parcourir une structure et effectuer une opération spécifique sur chacun de ses nœuds.
Dans le code source de LLVM/Clang, le pattern visiteur est largement utilisé :
5- Couplage et cohésion
5-1 Le couplage
Un faible couplage est souhaitable, car une modification dans une zone d'une application nécessitera moins de changements dans l'ensemble de l'application. À long terme, cela peut alléger une grande partie du temps, des efforts et des coûts associés à la modification et à l'ajout de nouvelles fonctionnalités à une application.
Un faible couplage peut être obtenu en utilisant des classes abstraites ou des types et méthodes génériques.
Cherchons toutes les classes abstraites définies dans le code source :
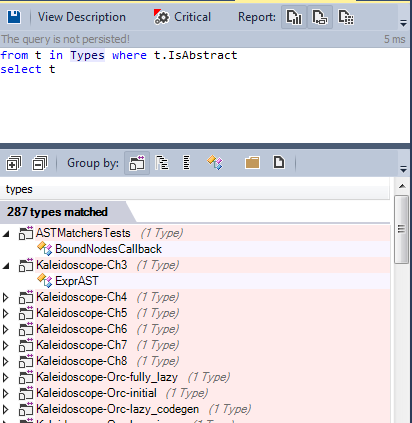
Plus de 280 types sont déclarés abstraits. Cependant, le faible couplage est également renforcé par l'utilisation de types et de méthodes génériques.
La cohésion
Le principe de responsabilité unique stipule qu'une classe ne devrait pas avoir plus d'une raison de changer. Une telle classe est dite cohésive. Une valeur LCOM élevée désigne généralement une classe peu cohésive. Il existe plusieurs métriques LCOM. LCOM prend ses valeurs dans l'intervalle [0-1]. LCOM HS (HS pour Henderson-Sellers) prend ses valeurs dans l'intervalle [0-2]. Une valeur LCOM HS supérieure à 1 doit être considérée comme alarmante. Voici comment calculer les métriques LCOM :
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
Où :
- M est le nombre de méthodes de la classe (les méthodes statiques et d'instance sont comptées ; cela inclut aussi les constructeurs, les accesseurs/mutateurs de propriétés et les méthodes d'ajout/suppression d'événements).
- F est le nombre de champs d’instance de la classe.
- MF est le nombre de méthodes de la classe accédant à un champ d’instance donné.
- Sum(MF) est la somme des MF sur tous les champs d’instance de la classe.
L'idée sous-jacente à ces formules peut s'énoncer ainsi : une classe est totalement cohésive si toutes ses méthodes utilisent tous ses champs d'instance, ce qui signifie que sum(MF)=M*F, et alors LCOM = 0 et LCOMHS = 0.
Une valeur LCOMHS supérieure à 1 doit être considérée comme alarmante.
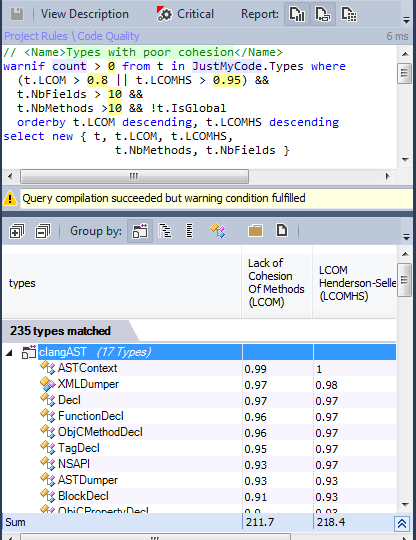
235 classes sont concernées ; certaines pourraient peut-être être refactorisées pour améliorer leur cohésion.
6- Immutabilité, pureté et effets de bord
6-1 Les types immuables
Fondamentalement, un objet est immuable si son état ne change pas une fois l'objet créé. Par conséquent, une classe est immuable si ses instances sont immuables.
Il y a un argument important en faveur de l'utilisation d'objets immuables : cela simplifie considérablement la programmation concurrente. Réfléchissez-y — pourquoi écrire du code multithreadé correct est-il une tâche difficile ? Parce qu'il est difficile de synchroniser l'accès des threads aux ressources (objets ou autres ressources du système). Pourquoi est-il difficile de synchroniser ces accès ? Parce qu'il est difficile de garantir l'absence de situations de compétition (race conditions) entre les multiples accès en lecture et en écriture effectués par plusieurs threads sur plusieurs objets. Et s'il n'y avait plus d'accès en écriture ? Autrement dit, si l'état des objets accédés par les threads ne change pas ? Alors il n'y a plus besoin de synchronisation !
Un autre avantage des classes immuables est qu'elles ne peuvent jamais violer le LSP (principe de substitution de Liskov). Voici une définition du LSP citée de sa page wiki :
La notion de sous-type comportemental de Liskov définit une notion de substituabilité pour les objets mutables ; c'est-à-dire que si S est un sous-type de T, alors les objets de type T dans un programme peuvent être remplacés par des objets de type S sans altérer aucune des propriétés désirables de ce programme (par exemple, sa correction).
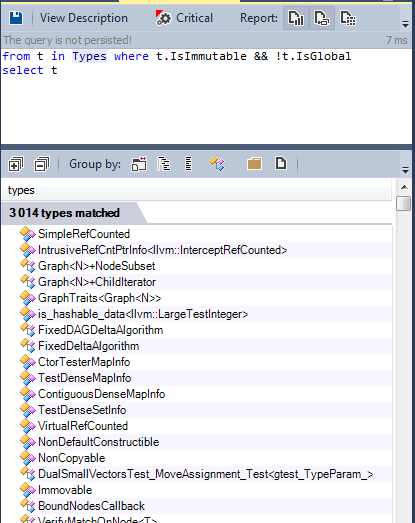
Voici la liste des types immuables définis dans le code source :
6-2 Pureté et effets de bord
Le principal avantage des types immuables vient du fait qu'ils éliminent les effets de bord. Je ne pourrais pas le dire mieux que Wes Dyer, alors je le cite :
Nous savons tous qu'en général, ce n'est pas une bonne idée d'utiliser des variables globales. C'est essentiellement l'extrême de l'exposition des effets de bord (la portée globale). Beaucoup de programmeurs qui n'utilisent pas de variables globales ne réalisent pas que les mêmes principes s'appliquent aux champs, propriétés, paramètres et variables à une échelle plus limitée : ne les modifiez pas sans bonne raison.(…)Une façon d'augmenter la fiabilité d'une unité est d'éliminer les effets de bord. Cela rend la composition et l'intégration des unités entre elles beaucoup plus faciles et plus robustes. Comme elles sont exemptes d'effets de bord, elles fonctionnent toujours de la même manière, quel que soit l'environnement. C'est ce qu'on appelle la transparence référentielle.
Écrire vos fonctions/méthodes sans effets de bord — de sorte qu'elles soient des fonctions pures, c'est-à-dire qu'elles ne modifient pas l'objet — facilite le raisonnement sur la correction de votre programme.
Voici la liste de toutes les méthodes sans effets de bord.
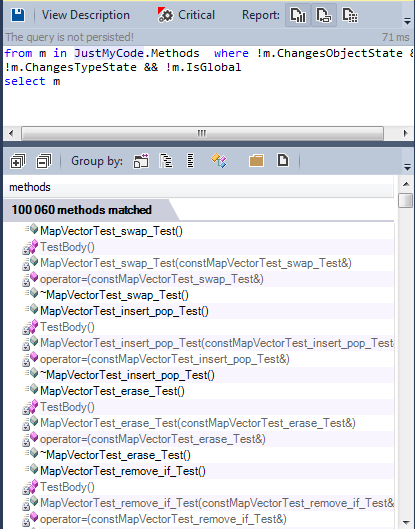
Plus de 100 000 méthodes sont pures.
7- La qualité de l'implémentation
7-1 Les méthodes trop longues
Les méthodes comportant de nombreuses lignes de code ne sont pas faciles à maintenir ni à comprendre. Cherchons les méthodes de plus de 60 lignes.
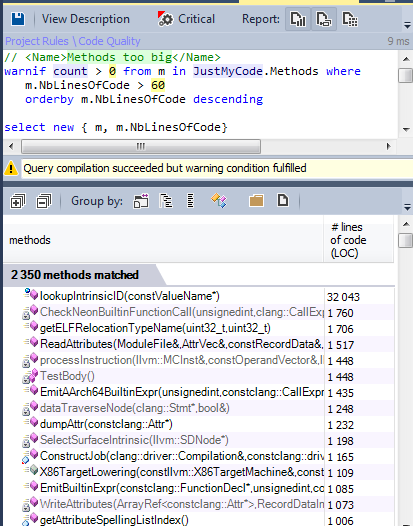
Le code source de LLVM/Clang contient plus de 100 000 méthodes, donc moins de 2 % peuvent être considérées comme trop longues.
7-2 Les méthodes avec beaucoup de paramètres
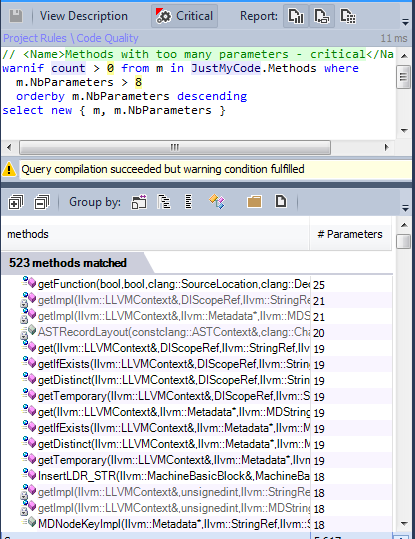
Peu de méthodes ont plus de 8 paramètres.
7-3 Les méthodes avec beaucoup de variables locales
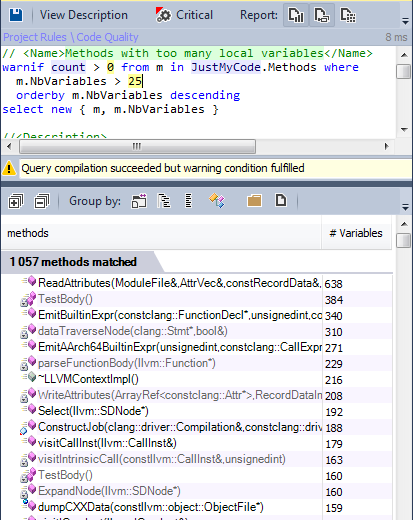
Moins de 1 % ont beaucoup de variables locales.
7-4 Les méthodes trop complexes
De nombreuses métriques permettent de détecter les fonctions complexes ; NBLinesOfCode, le nombre de paramètres et le nombre de variables locales sont les plus basiques.
Il existe d’autres métriques intéressantes pour détecter les fonctions complexes :
- La complexité cyclomatique est une métrique logicielle procédurale populaire, égale au nombre de décisions pouvant être prises dans une procédure.
- La profondeur d'imbrication (Nesting Depth) est une métrique définie sur les méthodes qui correspond à la profondeur maximale de la portée la plus imbriquée dans le corps d'une méthode.
- Max Nested Loops est égal au niveau maximal d’imbrication des boucles dans une fonction.
La valeur maximale tolérée pour ces métriques dépend des choix de l'équipe ; il n'existe pas de valeurs standard.
Cherchons les méthodes qui pourraient être considérées comme complexes dans la base de code.
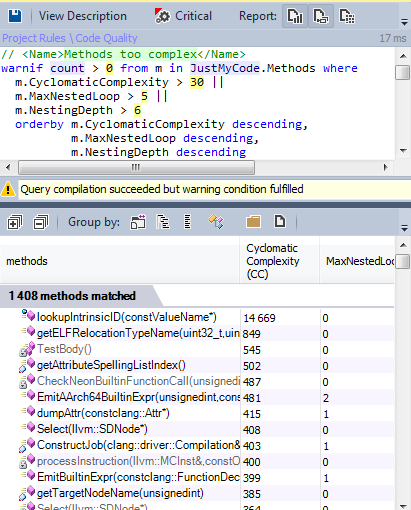
Seulement 1,5 % sont candidates à une refactorisation pour réduire leur complexité.
7-5 La complexité de Halstead
Les mesures de complexité de Halstead sont des métriques logicielles introduites par Maurice Howard Halstead en 1977. Halstead a fait l'observation que les métriques du logiciel devraient refléter l'implémentation ou l'expression des algorithmes dans différents langages, tout en étant indépendantes de leur exécution sur une plateforme spécifique. Ces métriques sont donc calculées statiquement à partir du code.
De nombreuses métriques ont été introduites par Halstead. Prenons l'exemple de TimeToImplement, qui représente le temps nécessaire pour programmer une méthode, en secondes.
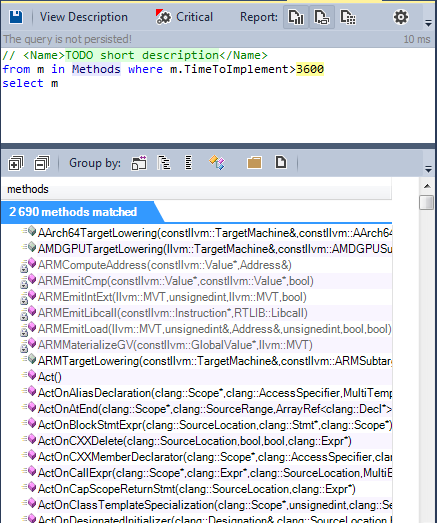
2 690 méthodes nécessitent plus d'une heure pour être implémentées.
8- RTTI
RTTI désigne la capacité du système à rendre compte du type dynamique d'un objet et à fournir des informations sur ce type à l'exécution (par opposition à la compilation). Cependant, RTTI est devenu controversé au sein de la communauté C++. De nombreux développeurs C++ choisissent de ne pas utiliser ce mécanisme.
Qu'en est-il de l'équipe de développement de LLVM/Clang ?
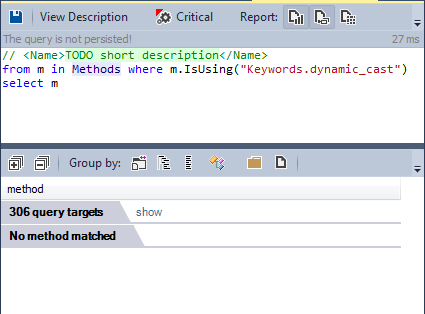
Aucune méthode n'utilise le mot-clé dynamic_cast. L'équipe LLVM/Clang a choisi de ne pas utiliser le mécanisme RTTI.
9- Les exceptions
La gestion des exceptions est une autre fonctionnalité controversée du C++. De nombreux projets C++ open source bien connus ne l'utilisent pas.
Cherchons si une exception a été levée dans le code source.
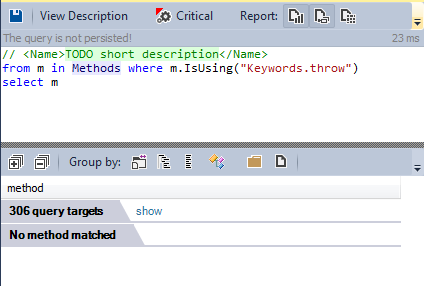
Comme pour RTTI, le mécanisme des exceptions n'est pas utilisé.
10- Quelques statistiques
10-1 Les types les plus populaires
Il est intéressant de connaître les types les plus utilisés dans un projet ; en effet, ces types doivent être bien conçus, implémentés et testés, et toute modification peut impacter l'ensemble du projet.
Nous pouvons les trouver à l'aide de la métrique TypesUsingMe:
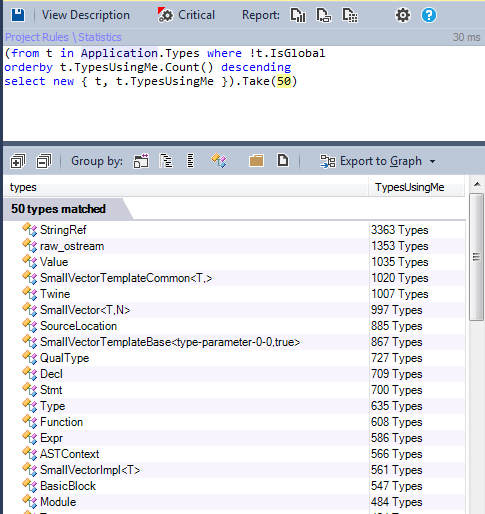
Cependant, il existe une autre métrique intéressante pour chercher les types populaires : TypeRank.
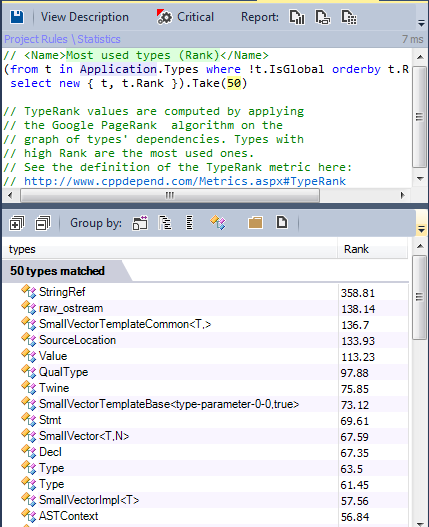
Les valeurs TypeRank sont calculées en appliquant l'algorithme PageRank de Google au graphe des dépendances entre types. Une homothétie de centre 0,15 est appliquée de sorte que le TypeRank moyen soit de 1.
Les types avec un TypeRank élevé devraient être testés avec plus de soin, car les bugs y sont susceptibles d’être plus catastrophiques.
Voici le résultat de tous les types populaires selon la métrique TypeRank :
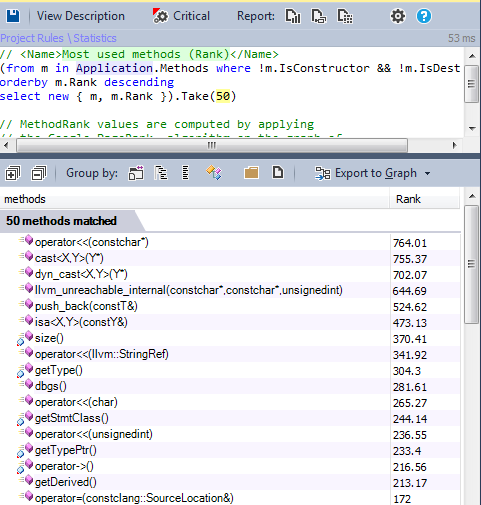
10-2 Les méthodes les plus populaires
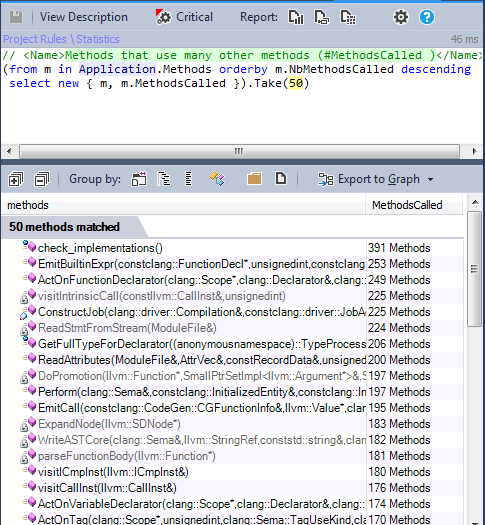
10-3 Les méthodes appelant de nombreuses autres méthodes
Il est intéressant de connaître les méthodes qui en utilisent beaucoup d'autres ; cela peut révéler un problème de conception dans ces méthodes, et dans certains cas, une refactorisation est nécessaire pour les rendre plus lisibles et plus maintenables.
Résumé
LLVM/Clang est très bien conçu et implémenté, et comme pour tout autre projet, certaines refactorisations pourraient être effectuées pour l'améliorer. Dans cet article, nous avons découvert quelques modifications mineures possibles à apporter au code source. N'hésitez pas à explorer son code source pour améliorer vos compétences en C++.