
Clangは、GCCやMicrosoftのコンパイラと同様に、成熟したC/C++コンパイラであることを証明しています。しかし、Clangを特別なものにしているのは、単なるコンパイラではないという点です。ライブラリベースのアーキテクチャのおかげで、その機能を再利用し、ほかのプロジェクトへ統合しやすい、ツールを構築するための基盤でもあります。 Clangの設計:
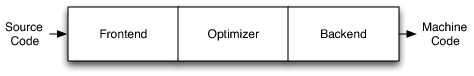
多くのコンパイラ設計と同様に、Clangコンパイラには3つのフェーズがあります。
- フロントエンドはソースコードを解析し、エラーをチェックして、入力コードを表す言語固有の抽象構文木(AST)を構築します。
- オプティマイザは、フロントエンドが生成したASTに対して最適化を実行します。
- バックエンドは、マシンが実行する最終コードを生成します。この部分はターゲットに依存します。
Clangとほかのコンパイラの違いは何か?
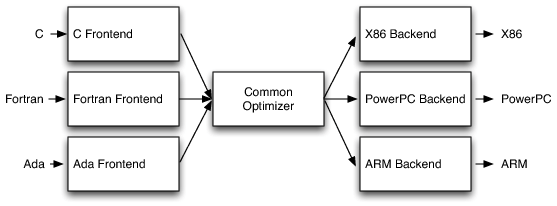
設計上の最も重要な違いは、ClangがLLVMを基盤としている点です。LLVMの背景にある考え方は、JavaにおけるバイトコードのようなLLVM中間表現(IR)を使うことです。LLVM IRは、コンパイラのオプティマイザ部にある中間レベルの解析と変換を収容するように設計されています。軽量な実行時最適化、関数間・手続き間最適化、プログラム全体の解析、積極的な再構造化変換など、多くの具体的な目標を念頭に設計されました。しかし最も重要なのは、LLVM IR自体が明確に定義された意味論を持つ第一級の言語として定義されている点です。
この設計により、コンパイラの大部分を再利用してほかのコンパイラを作成できます。たとえば、フロントエンド部分だけを変更すれば、ほかの言語を処理できます。
この強力なコンパイラ基盤を探索し、その設計と実装を知ることは非常に興味深いことです。C++開発者は、そのコードベースから多くの良い実践を学べます。
それでは、 CppDepend と CQLinq を使ってそのソースコードをX線解析し、開発チームによる設計と実装の選択をいくつか探ってみましょう。
1. モジュール性:
1-1 ライブラリによるモジュール性
Clangの主要な設計概念の1つは、ライブラリベースのアーキテクチャを採用していることです。この設計では、フロントエンドのさまざまな部分を独立したライブラリにきれいに分割し、さまざまなニーズや用途に合わせて組み合わせられます。さらに、ライブラリベースのアプローチは優れたインターフェースを促進し、新しい開発者が参加しやすくします。全体像の小さな部分だけを理解すればよいからです。
DSM(Dependency Structure Matrix)は、コンポーネント間の依存関係をコンパクトに表現し、ナビゲートするための方法です。空でないDSMセルには数値が入ります。この数値は、そのセルが表す結合の強さを示します。結合の強さは、その結合に関与するメンバー、メソッド、フィールド、型、名前空間の数で表せます。DSMを使うと、ライブラリ間の依存関係サイクルも確認できます。
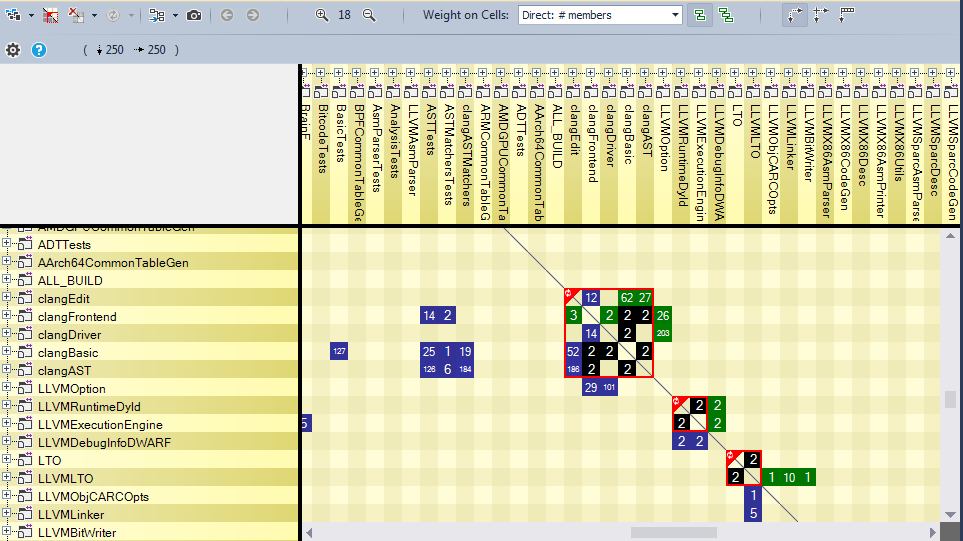
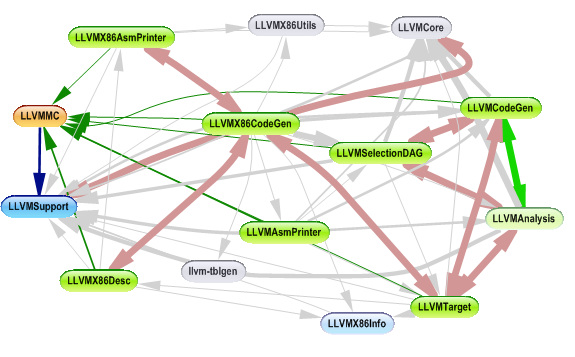
この依存関係グラフは、Clangが直接使用しているライブラリを示しています。
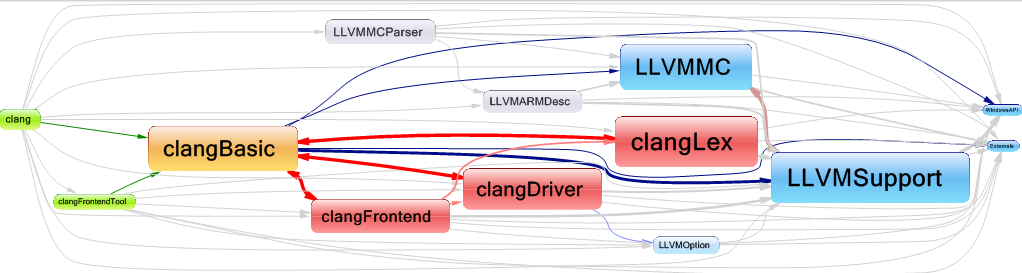
ご覧のとおり、clangBasic/clangFrontend、clangBasic/clangDriver、clangBasic/clangLex というライブラリ間に3つの依存関係サイクルがあります。コードの可読性と保守性を高めるため、ライブラリ間の依存関係サイクルは解消することが推奨されます。
clangFrontend が clangBasic を使うのは自然です。しかし、なぜ clangBasic が clangFrontend ライブラリを使っているのでしょうか。
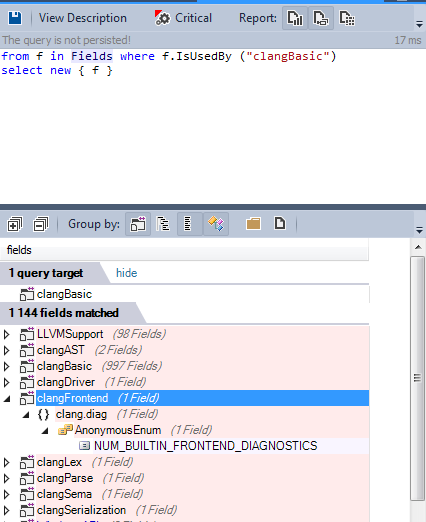
この依存関係サイクルは、たった1つの列挙型フィールドが原因です。この依存関係は、コードをリファクタリングすれば簡単に取り除けます。
1-2 名前空間によるモジュール性
C++では、名前空間もコードベースをモジュール化するために使われます。LLVM/Clangでは、主に3つの理由で使用されています。
- 多くの名前空間には列挙型だけが含まれています。次のCQLinqクエリは、列挙型だけを含む名前空間を示しています。
大規模プロジェクトでは、2つの異なる列挙型が同じ名前を使わないという保証はありません。この問題はC++11で enum classを使うことで解決されました。enum class は、列挙値を列挙型名のスコープ内に暗黙的に閉じ込めます。近い将来、コードをリファクタリングしてC++11の enum class を使うことも可能です。
- 匿名名前空間:名前のない名前空間を使うと、グローバル static 変数を作らずに済みます。作成した「匿名」名前空間は、それを作成したファイル内からのみアクセスできます。使用されているすべての匿名名前空間の一覧を次に示します。
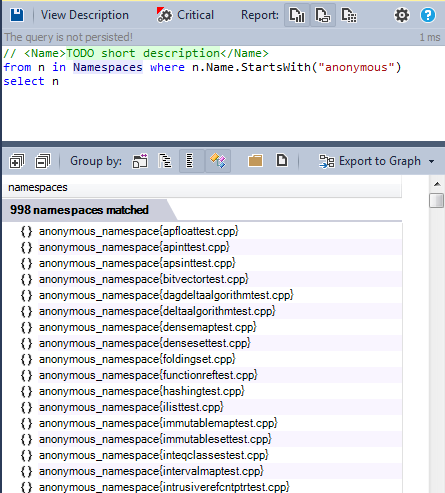
- コードベースのモジュール化:次に、匿名ではない名前空間をすべて検索してみましょう。
名前空間は、アプリケーションをモジュール化する良い方法です。LLVM/Clangではモジュール性を強化するために500個を超える名前空間が定義されており、コードの可読性と保守性が高められています。
2. 使用されているパラダイム:
C++は単なるオブジェクト指向言語ではありません。Bjarne Stroustrup が指摘しているように、「C++はマルチパラダイム言語」です。さまざまなスタイルのプログラム、つまりパラダイムをサポートしており、オブジェクト指向プログラミングはその1つにすぎません。ほかには、手続き型プログラミングやジェネリックプログラミングなどがあります。
2-1 手続き型パラダイム
2-1-1 グローバル関数
LLVM/Clangのソースコードで定義されているすべてのグローバル関数を検索してみましょう。
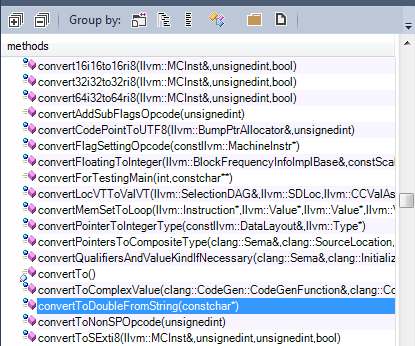
これらの関数は3つのカテゴリに分類できます。
1. ユーティリティ関数:たとえば、多くの関数は型から別の型への変換に関するものです。
2. 演算子:次のCQLinqクエリ結果が示すように、多くの演算子が定義されています。
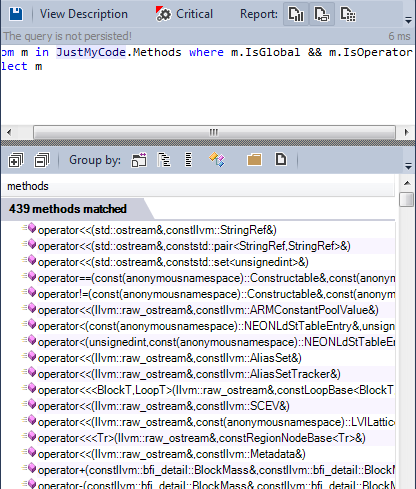
LLVM/Clangのソースコードでは、ほぼすべての種類の演算子が実装されています。
3. コンパイラロジックに関連する関数:コンパイラ処理を含む多くのグローバル関数が実装されています。
これらの関数は、カテゴリ別にクラスの静的メソッドとしてまとめるか、名前空間に整理できるかもしれません。
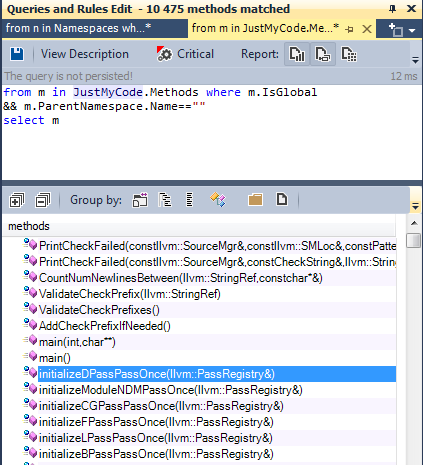
2-1-2 静的グローバル関数
別のソースファイルから呼び出す特別な必要がない限り、グローバル関数は static として宣言するのがベストプラクティスです。
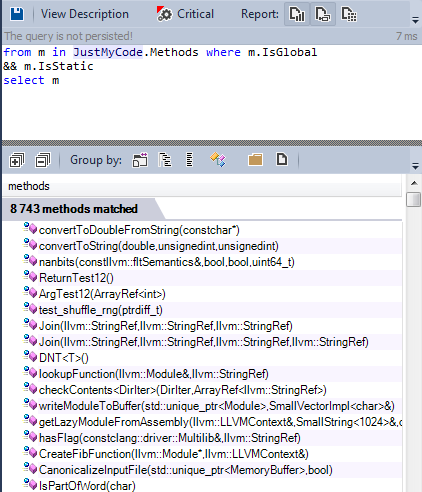
ほぼすべてのグローバル関数が static として宣言されています。
2-1-3 static化の候補となるグローバル関数
エクスポートされておらず、匿名名前空間内でも定義されておらず、定義されたファイル外のどのメソッドからも使用されていないグローバル関数は、static へリファクタリングする良い候補です。
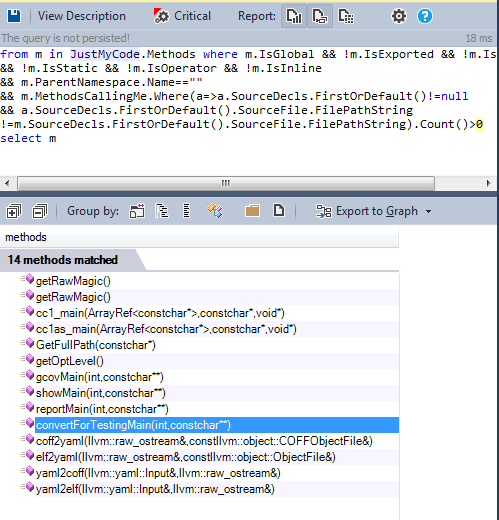
ご覧のとおり、static関数へのリファクタリング候補となる関数はごくわずかです。
2-2 オブジェクト指向パラダイム
2-2-1 継承
オブジェクト指向プログラミング(OOP)において、継承はオブジェクト間に is-a 関係を確立する方法です。これは既存コードを再利用する方法と混同されがちですが、実装再利用のための継承は強い結合を招くため、良い習慣ではありません。コードの再利用性はコンポジションによって実現されます(継承よりコンポジション)。少なくとも1つの基底クラスを持つすべてのクラスを検索してみましょう。
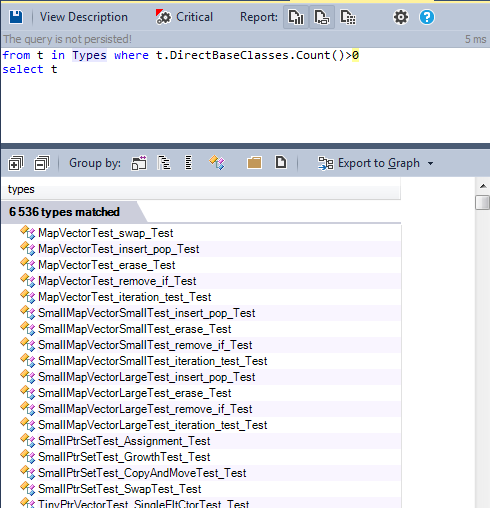
このクエリの対象となるクラスをよりよく把握するため、Metric View を使えます。
Metric View では、コードベースはツリーマップとして表現されます。Treemapping は、入れ子になった長方形を使ってツリー構造のデータを表示する手法です。CppDependのツリーマップで使われるツリー構造は、通常のコード階層です。
- プロジェクトは名前空間を含む。
- 名前空間は型を含む。
- 型はメソッドとフィールドを含む。
ツリーマップビューは、CQLinqクエリの結果を表現する便利な方法です。青い長方形がこの結果を表すため、クエリの対象となる型を視覚的に確認できます。
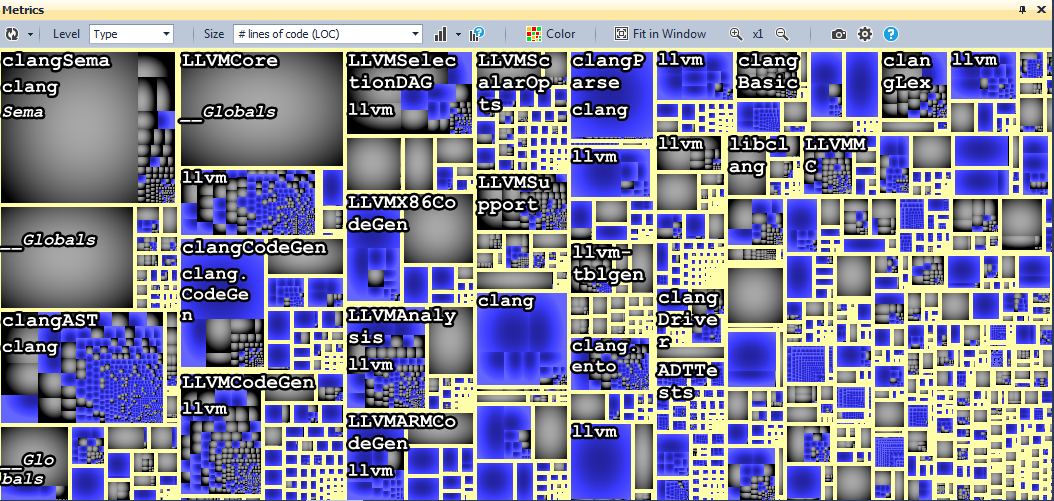
ご覧のとおり、LLVM/Clangのソースコードでは継承が広く使われています。
多重継承:複数の具象クラスを継承しているクラスを検索してみましょう。
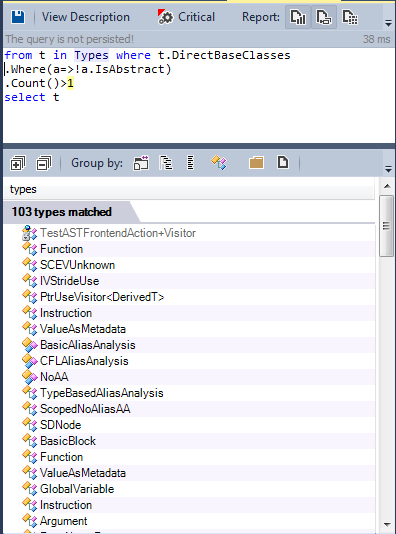
多重継承は広く使われていません。複数のクラスを継承しているクラスは1%未満です。
2-2-2 仮想メソッド
ソースコードで定義されているすべての仮想メソッドを検索してみましょう。
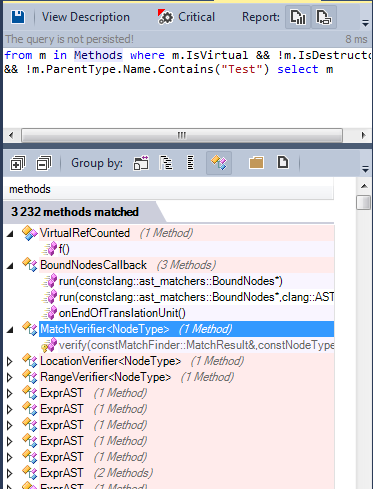
多くのメソッドが仮想メソッドであり、その一部は純粋仮想です。
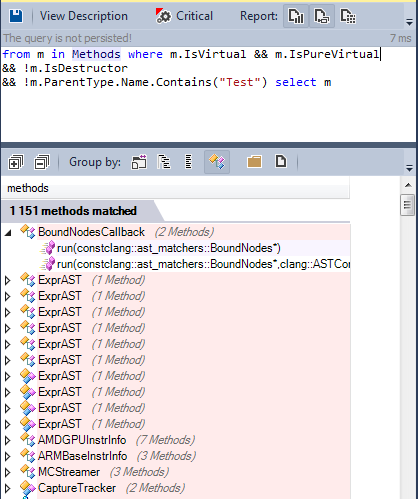
LLVM/Clangのソースコードでは、OOPパラダイムが広く使われています。では、ジェネリックプログラミングパラダイムはどうでしょうか。
2-3 ジェネリックプログラミング
C++は、テンプレートを通じてジェネリックプログラミングの考え方を表現する独自の能力を提供します。テンプレートは、ジェネリックなアルゴリズムとデータ構造を表現できるパラメトリックポリモーフィズムの一形態を提供します。C++テンプレートのインスタンス化機構により、ジェネリックなアルゴリズムやデータ構造が使用されると、その特定の用途に合わせて完全に最適化・特殊化されたバージョンが生成されます。そのため、ジェネリックアルゴリズムは非ジェネリックなものと同じくらい効率的になります。
2-3-1 ジェネリック型
エンジンのソースコードで定義されているすべてのジェネリック型を検索してみましょう。
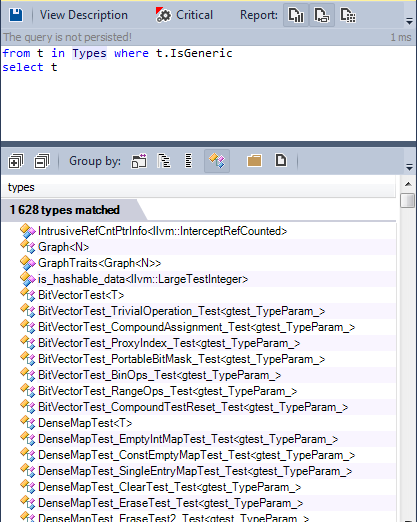
多くの型がジェネリックとして定義されています。次に、ジェネリックメソッドを検索してみましょう。
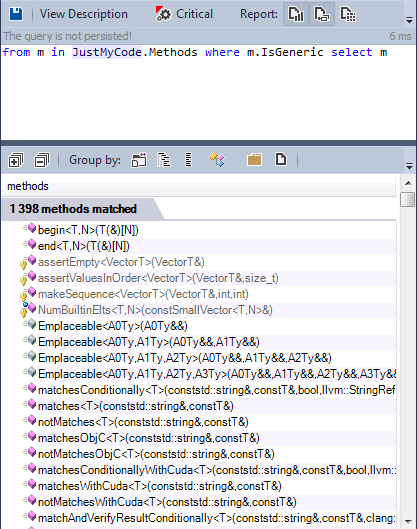
ジェネリックなメソッドは1%未満です。
要約すると、LLVM/Clangのソースコードでは3つのパラダイムが混在しています。
3. データモデルを定義するPOD
オブジェクト指向プログラミングにおけるプレーンオールドデータ(POD)は、オブジェクト指向機能を使わず、フィールド値(インスタンス変数)の受動的な集合としてだけ表現されるデータ構造です。計算機科学では、受動的データ構造として知られています。
ソースコード内のPOD型を検索してみましょう。
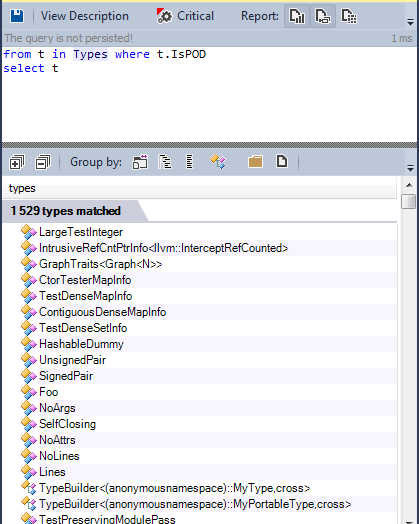
1,500個を超える型がPOD型として定義されており、その多くはコンパイラのデータモデルを定義するために使われています。
4. Gang of Four のデザインパターン
デザインパターンは、ソフトウェア設計でよくある問題に対する繰り返し使える解決策を表すソフトウェア工学の概念です。Gang of Four のパターンは最も有名なものの1つです。llvm/clang のソースコードで使われているものをいくつか見てみましょう。
4-1 ファクトリー
ファクトリーを使うと、インスタンス化ロジックを分離し、凝集度を高められます。ソースコードで定義されているファクトリーの一覧を次に示します。
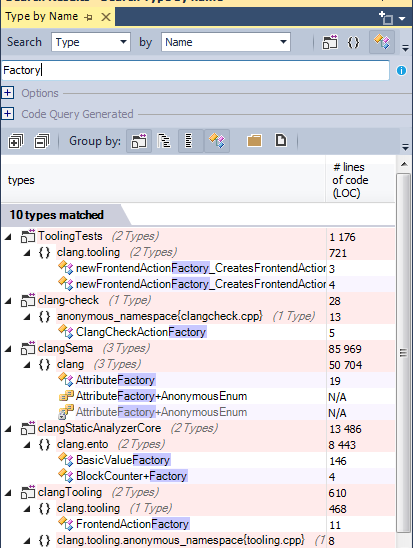
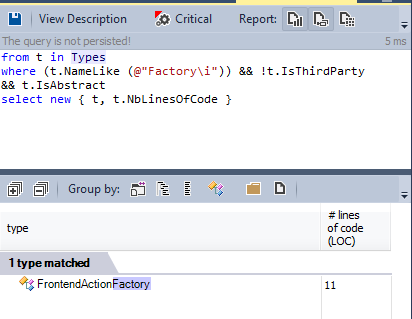
次に、抽象ファクトリーの一覧を示します。
4-3 オブザーバー
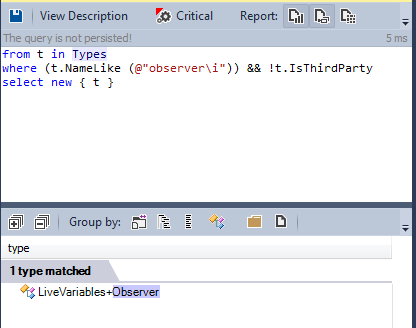
オブザーバーパターンは、オブジェクトがオブザーバーと呼ばれる依存先の一覧を保持し、状態が変化したときに、通常はそのメソッドの1つを呼び出して自動的に通知するソフトウェアデザインパターンです。
ソースコードで定義されているオブザーバーは1つだけです。
4-4 ビジター
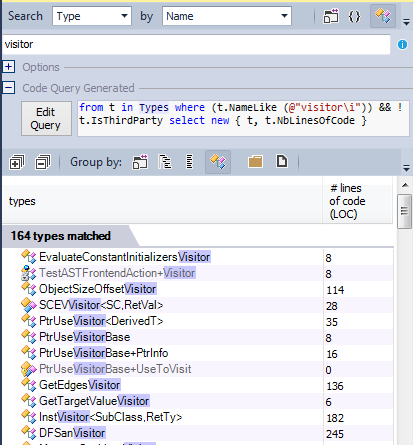
ビジターパターンは、構造を走査し、その各ノードに対して特定の操作を実行する必要がある場合に推奨されます。
LLVM/Clangのソースコードでは、ビジターパターンが広く使われています。
5. 結合度と凝集度
5-1 結合度
低結合が望ましいのは、アプリケーションの1つの領域での変更が、アプリケーション全体で必要になる変更を減らすためです。長期的には、アプリケーションの修正や新機能追加に伴う時間、労力、コストを大きく削減できます。
低結合は、抽象クラスを使うか、ジェネリック型とジェネリックメソッドを使うことで実現できます。
ソースコードで定義されているすべての抽象クラスを検索してみましょう。
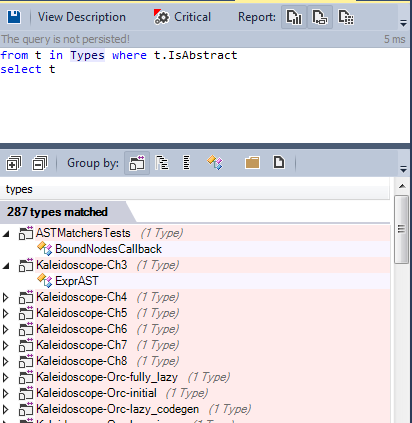
280個を超える型が抽象型として宣言されています。ただし、低結合はジェネリック型とジェネリックメソッドを使うことでも強化されます。
凝集度
単一責任の原則は、クラスが変更される理由を1つだけ持つべきだと述べています。このようなクラスは凝集度が高いと言われます。一般に、高いLCOM値は凝集度の低いクラスを示します。LCOMには複数のメトリクスがあります。LCOMは [0-1] の範囲の値を取ります。LCOM HS(HSはHenderson-Sellersの略)は [0-2] の範囲の値を取ります。LCOM HS値が1を超える場合は要注意と見なすべきです。LCOMメトリクスの計算方法は次のとおりです。
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
ここで、
- M はクラス内のメソッド数です(静的メソッドとインスタンスメソッドの両方を数え、コンストラクタ、プロパティのゲッター/セッター、イベントの追加/削除メソッドも含みます)。
- F はクラス内のインスタンスフィールド数です。
- MF は、特定のインスタンスフィールドにアクセスするクラスのメソッド数です。
- Sum(MF) は、クラスのすべてのインスタンスフィールドについて MF を合計した値です。
これらの式の背景にある考え方は、次のように表現できます。クラスのすべてのメソッドがすべてのインスタンスフィールドを使用する場合、そのクラスは完全に凝集しており、sum(MF)=M*F となり、LCOM = 0、LCOMHS = 0 になります。
LCOMHS値が1を超える場合は、要注意と見なすべきです。
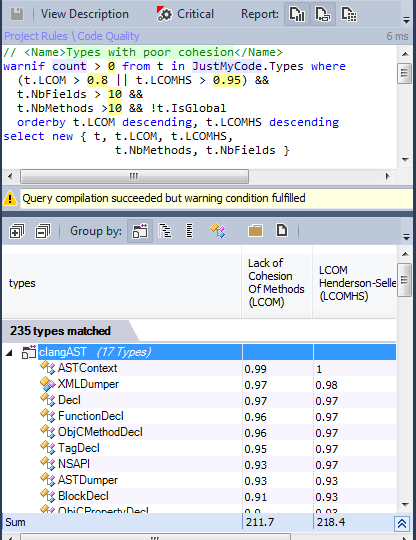
235個のクラスが該当します。凝集度を高めるために、一部のクラスをリファクタリングできるかもしれません。
6. 不変性、純粋性、副作用
6-1 不変型
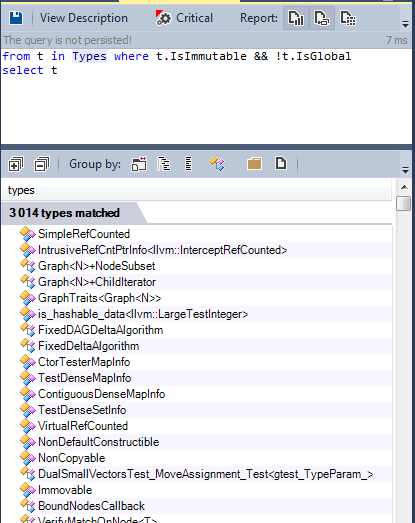
基本的に、オブジェクトは作成後に状態が変化しない場合に不変です。したがって、クラスのインスタンスが不変であれば、そのクラスは不変です。
不変オブジェクトを使うことには、重要な利点が1つあります。並行プログラミングを劇的に単純化できるのです。考えてみてください。なぜ正しいマルチスレッドコードを書くのは難しいのでしょうか。それは、リソース(オブジェクトやその他のOSリソース)へのスレッドアクセスを同期させるのが難しいからです。なぜこれらのアクセスを同期させるのが難しいのでしょうか。複数のスレッドが複数のオブジェクトに対して行う多数の読み書きアクセス間で競合状態が発生しないことを保証するのが難しいからです。では、書き込みアクセスがなくなったらどうなるでしょうか。言い換えれば、スレッドからアクセスされるオブジェクトの状態が変化しなければどうなるでしょうか。その場合、同期はもう必要ありません。
不変クラスのもう1つの利点は、LSP(リスコフの置換原則)に違反することがない点です。Wikiページから引用したLSPの定義は次のとおりです。
リスコフの振る舞い的サブタイプの概念は、変更可能なオブジェクトに対する置換可能性を定義します。つまり、S が T のサブタイプであれば、プログラム内の T 型のオブジェクトを S 型のオブジェクトに置き換えても、そのプログラムの望ましい性質(正しさなど)が変わらないということです。
ソースコードで定義されている不変型の一覧を次に示します。
6-2 純粋性と副作用
不変型の主な利点は、副作用を排除できることから生まれます。この点については、 Wes Dyerの表現が最も的確なので、引用します。
一般に、グローバル変数を使うのは良い考えではないことを私たちは皆知っています。これは基本的に、副作用を(グローバルスコープへ)さらす極端な例です。グローバル変数を使わない多くのプログラマーは、同じ原則が、より限定的なスコープでもフィールド、プロパティ、パラメータ、変数に適用されることに気づいていません。正当な理由がない限り、それらを変更してはいけません。(…)ユニットの信頼性を高める1つの方法は、副作用を排除することです。これにより、ユニットの合成と統合がはるかに簡単で堅牢になります。副作用がないため、環境に関係なく常に同じように動作します。これは参照透過性と呼ばれます。
副作用のない関数やメソッドを書き、それらを 純粋関数、つまりオブジェクトを変更しない関数 にすることで、プログラムの正しさについて考えやすくなります。
副作用のないすべてのメソッドの一覧を次に示します。
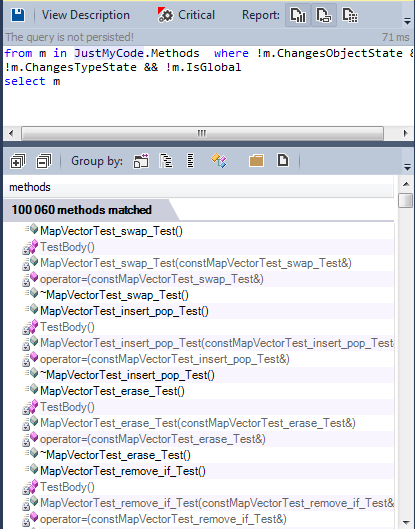
10万個を超えるメソッドが純粋です。
7. 実装品質
7-1 大きすぎるメソッド
コード行数の多いメソッドは、保守も理解も容易ではありません。60行を超えるメソッドを検索してみましょう。
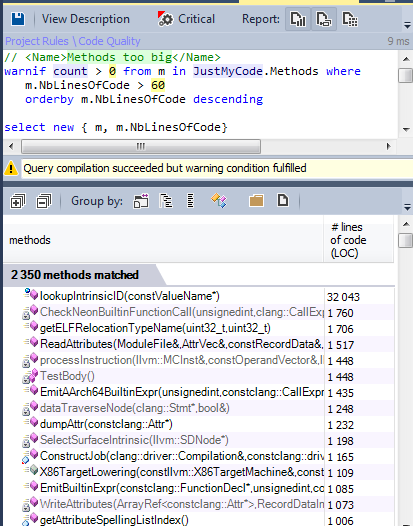
LLVM/Clangのソースコードには10万個を超えるメソッドが含まれているため、大きすぎると見なせるものは2%未満です。
7-2 パラメータの多いメソッド
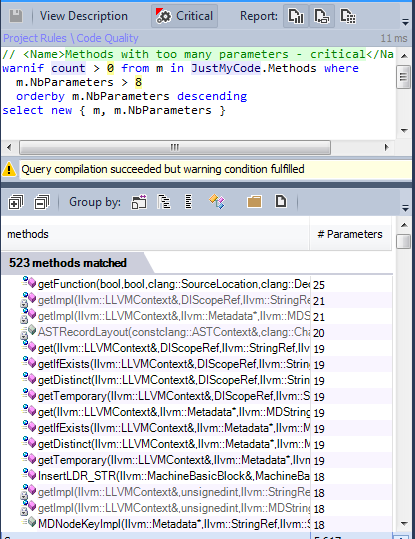
8個を超えるパラメータを持つメソッドは少数です。
7-3 ローカル変数の多いメソッド
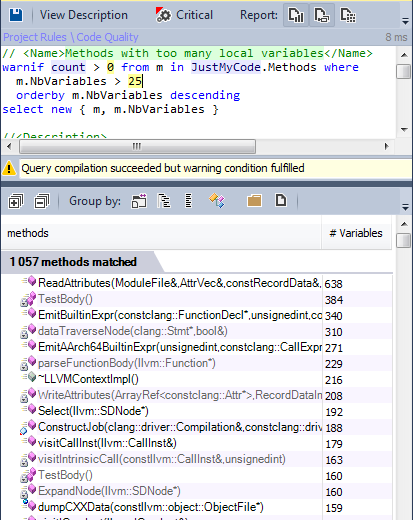
ローカル変数が多いメソッドは1%未満です。
7-4 複雑すぎるメソッド
複雑な関数を検出するメトリクスは多数あります。NBLinesOfCode、パラメータ数、ローカル変数数は基本的なものです。
複雑な関数を検出するための、ほかにも興味深いメトリクスがあります。
- 循環的複雑度は広く使われている手続き型ソフトウェアメトリクスで、プロシージャ内で取り得る判定の数に等しくなります。
- ネスト深度はメソッドに対して定義されるメトリクスで、メソッド本体内で最も深く入れ子になったスコープの最大深度に関係します。
- 最大ネストループは、関数内のループネストの最大レベルに等しくなります。
これらのメトリクスで許容される最大値はチームの判断に依存し、標準的な値はありません。
コードベース内で複雑と見なせるメソッドを検索してみましょう。
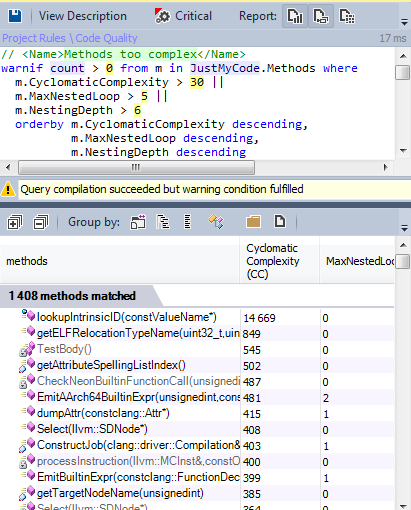
複雑さを減らすためにリファクタリングの候補となるメソッドは1.5%だけです。
7-5 Halstead複雑度
Halstead複雑度 メトリクスは、Maurice Howard Halstead が1977年に導入したソフトウェアメトリクスです。Halsteadは、ソフトウェアのメトリクスは、さまざまな言語におけるアルゴリズムの実装や表現を反映する一方で、特定プラットフォーム上での実行からは独立しているべきだと考えました。そのため、これらのメトリクスはコードから静的に計算されます。
Halsteadは多くのメトリクスを導入しました。例として、メソッドをプログラミングするのに必要な時間を秒で表す TimeToImplement を見てみましょう。
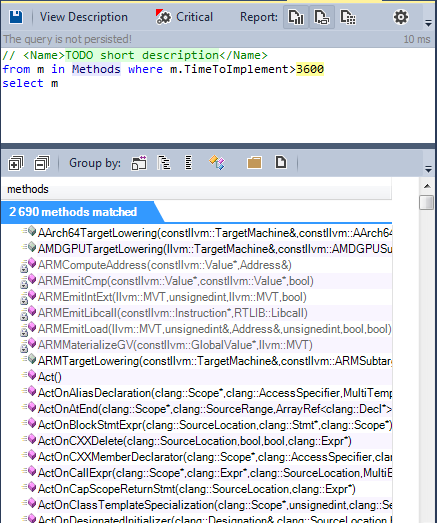
2,690個のメソッドは、実装に1時間以上を要します。
8. RTTI
RTTIとは、システムがオブジェクトの動的型を報告し、その型に関する情報を(コンパイル時ではなく)実行時に提供する能力を指します。しかし、RTTIはC++コミュニティ内で物議を醸してきました。多くのC++開発者は、この仕組みを使わないことを選んでいます。
LLVM/Clangの開発チームはどうでしょうか。
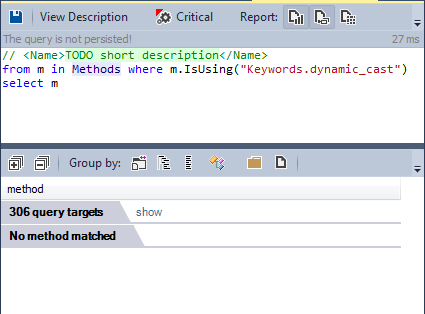
dynamic_cast キーワードを使用しているメソッドはありません。LLVM/ClangチームはRTTI機構を使用しないことを選んでいます。
9. 例外
例外処理も、物議を醸すC++機能の1つです。多くの有名なオープンソースC++プロジェクトでは使用されていません。
ソースコード内で例外がスローされているかを検索してみましょう。
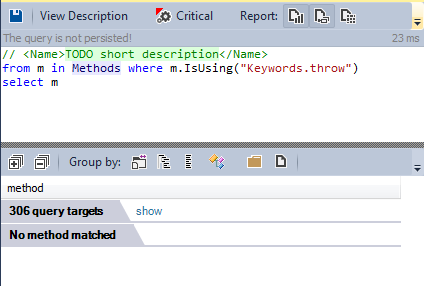
RTTIと同様に、例外機構も使用されていません。
10. いくつかの統計
10-1 最もよく使われる型
プロジェクトで最もよく使われる型を知ることは興味深いことです。これらの型は、適切に設計・実装・テストされている必要があり、変更するとプロジェクト全体に影響する可能性があるからです。
これらは TypesUsingMe メトリクスを使って見つけられます。
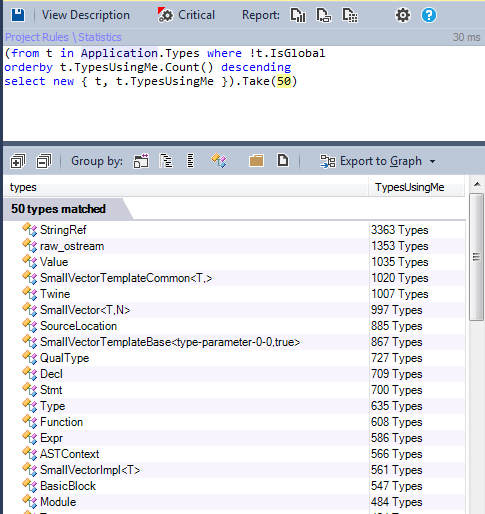
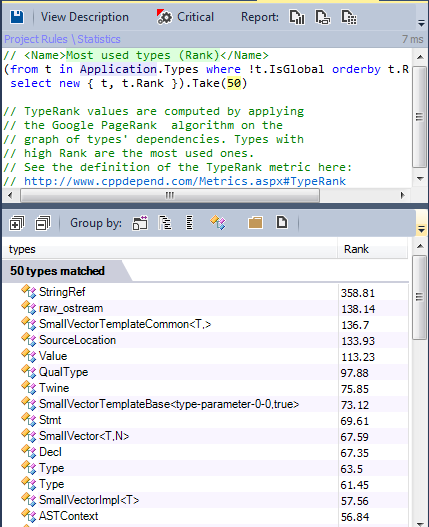
ただし、よく使われる型を探すためのもう1つの興味深いメトリクスとして TypeRank があります。
TypeRank値は、Google PageRank アルゴリズムを型の依存関係グラフに適用して計算されます。平均TypeRankが1になるよう、中心0.15の相似変換が適用されます。
TypeRankの高い型は、バグがより重大な影響を及ぼす可能性が高いため、より慎重にテストすべきです。
TypeRankメトリクスによる、よく使われるすべての型の結果を次に示します。
10-2 最もよく使われるメソッド
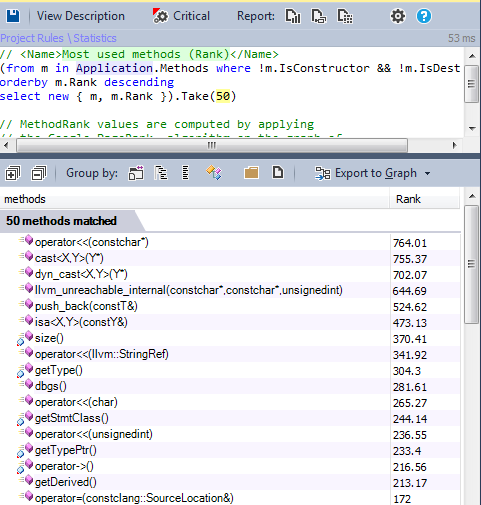
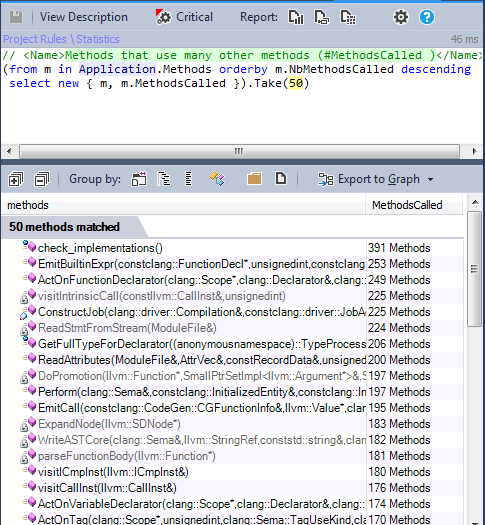
10-3 多くのメソッドを呼び出すメソッド
多くのメソッドを使用しているメソッドを知ることは興味深いことです。それらのメソッドに設計上の問題があることを示している可能性があり、場合によっては、可読性と保守性を高めるためのリファクタリングが必要になります。
まとめ
LLVM/Clangは非常によく設計・実装されていますが、ほかのプロジェクトと同様に、改善のためのリファクタリングは可能です。この記事では、ソースコードに加えられる可能性のある小さな変更をいくつか紹介しました。C++スキルを高めるために、ぜひそのソースコードを探索してみてください。