"Ein Bild sagt mehr als tausend Worte“ ist eine bekannte Redewendung. Sie besagt, dass sich eine komplexe Idee mit einem einzigen Bild vermitteln lässt oder dass ein Bild die Bedeutung beziehungsweise das Wesen eines Gegenstands wirkungsvoller transportiert als eine Beschreibung.
Diese Redewendung lässt sich auch auf die Softwareentwicklung übertragen. Ein kleines Projekt kann man durch das Lesen seines Quellcodes leicht verstehen. Große Projekte werden jedoch schnell komplex und schwer überschaubar. In solchen Fällen hilft es, den Quellcode mit Graphen und Diagrammen zu visualisieren, damit Entwickler die Struktur leichter erfassen können.
Sehen wir uns einige nützliche Diagramme an, die CppDepend zum Verständnis einer Codebasis bereitstellt.
I – Treemap-Diagramm
Treemapping ist eine Methode zur Darstellung baumartig strukturierter Daten mithilfe verschachtelter Rechtecke. Die CppDepend-Treemap verwendet dabei die übliche Codehierarchie:
- C/C++-Projekte enthalten Namespaces,
- Namespaces enthalten Typen,
- Typen enthalten Methoden und Felder.
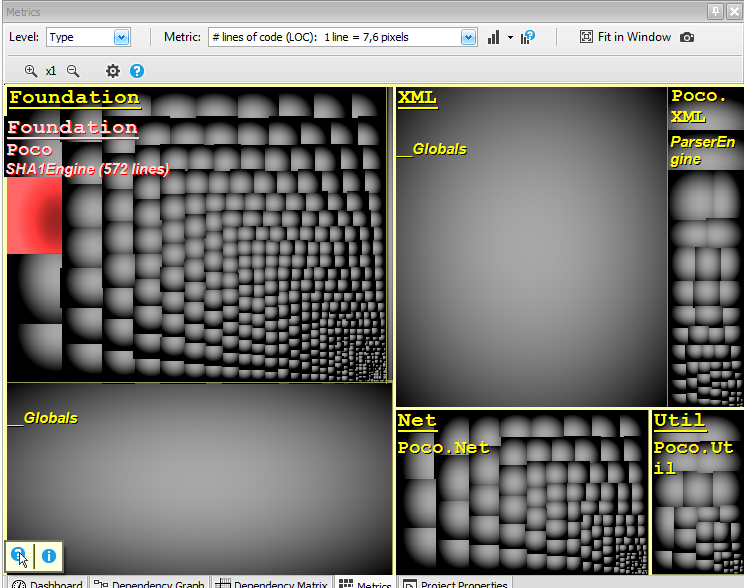
In einer Treemap repräsentieren Rechtecke Codeelemente. Die Option „Level“ bestimmt, welche Art von Codeelement jedes einzelne Rechteck darstellt. Sie kann fünf Werte annehmen: Projekt, Namespace, Typ, Methode und Feld. Die beiden folgenden Screenshots zeigen dieselbe Codebasis – links auf Type-Ebene und rechts auf Namespace-Ebene.
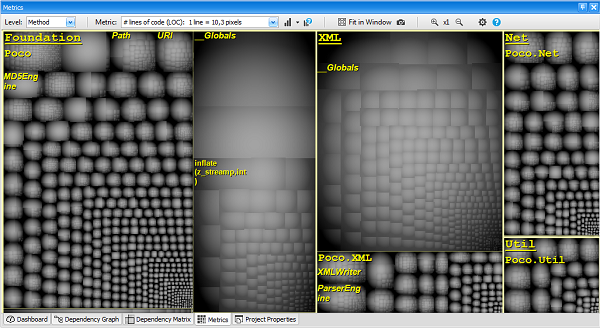
Die Option „Code Metric“ der Treemap bestimmt die Größe der Rechtecke. Ist beispielsweise der Level auf Typ und die Metrik auf Anzahl der Codezeilen, repräsentiert jedes einzelne Rechteck einen Typ; seine Größe ist proportional zur Anzahl der Codezeilen des entsprechenden Typs.
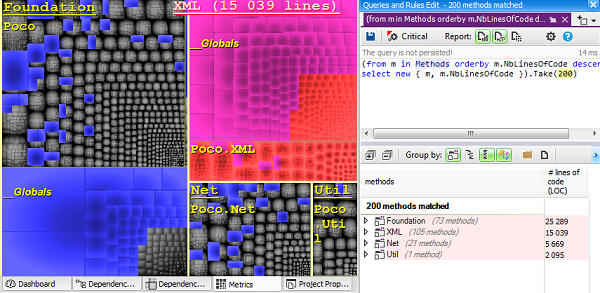
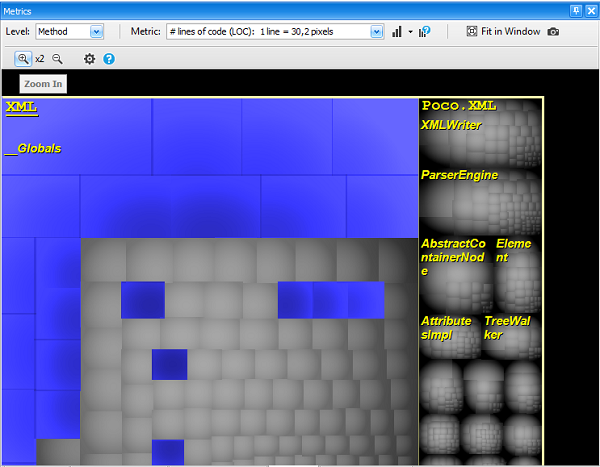
Wird gerade eine CQLinq-Abfrage bearbeitet, erscheinen die von ihr gefundenen Codeelemente in der Treemap als blaue Rechtecke. Im folgenden Screenshot findet eine CQLinq-Abfrage die 200 größten Methoden. Der Treemap-Level ist hier Methode und die Metrik ist Anzahl der Codezeilen. Wie erwartet repräsentieren die blauen Rechtecke die 200 größten Einzelrechtecke der Treemap.
Der folgende Screenshot zeigt außerdem, dass das aktuell ausgewählte Codeelement – hier das Projekt XML) is shown as a red rectangle on the treemap.
Typische Szenarien
Durch eine geeignete Kombination aus Metrik und Level macht die Metric View Muster sichtbar, die sonst nur schwer zu erkennen wären. Zu groß, zu komplex: CppDepend stellt zahlreiche Codemetriken bereit, um übermäßig großen oder komplexen Code aufzuspüren. Methoden mit zu vielen Parametern, Variablen, Codezeilen oder zu hoher zyklomatischer Komplexität sollten vermieden werden. Gleiches gilt für Typen mit zu vielen Codezeilen.
Im folgenden Screenshot ist der Treemap-Level auf Typ und die Metrik ist Anzahl der Codezeilen. Große Rechtecke stehen für große Typen der Codebasis. Wenn Sie mit der Maus über ein Rechteck fahren, werden die Metrikwerte des Typs angezeigt – hier die Anzahl seiner Codezeilen. Treemapping hilft damit nicht nur, übermäßig große und komplexe Codeelemente zu erkennen, sondern auch ihre jeweilige Größe und Komplexität zu vergleichen.
Problemstellen lokalisieren
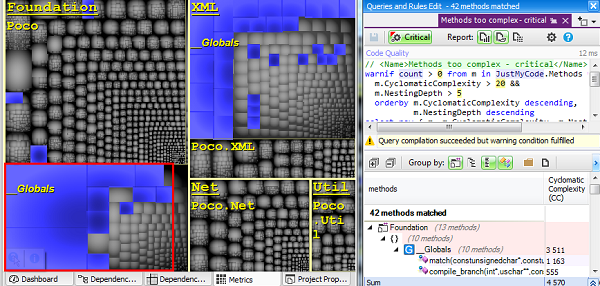
Im folgenden Screenshot verwenden wir eine CQLinq-Abfrage, um Methoden mit zu vielen Parametern und Variablen zu finden. Blaue Rechtecke markieren die gefundenen Methoden. Interessant ist, dass einige davon gruppiert erscheinen. Da die Treemap hierarchisch aufgebaut ist, bedeutet eine solche Gruppierung, dass die Codeelemente zum selben übergeordneten Element gehören. Tatsächlich gehören die zwölf gruppierten Methoden hier zum selben Typ.
Ohne Treemapping wäre es schwierig gewesen, den übergeordneten Typ dieser zwölf Methoden zu erkennen. Der Code-Quality-Reviewer kann sich nun gezielt auf diesen Bereich konzentrieren, der offenbar mehr Probleme enthält als andere Teile der Codebasis.
Top-down-Codeexploration
Die Treemap Metric View von CppDepend unterstützt Zoom-in und Zoom-out. So lässt sich bequem auf ein bestimmtes Projekt, einen Namespace oder eine Klasse fokussieren. Das ist besonders hilfreich, um den Umfang von Komponenten anhand ihrer Codezeilen zu untersuchen und zu vergleichen.
Produktivität sollte keinesfalls anhand der Anzahl von Codezeilen gemessen werden. Im Kontext einer Organisation kann die Zahl der Codezeilen jedoch eine nützliche Metrik für präzisere Softwareschätzungen sein. Die Funktionen einer Codebasis sind in Assemblies, Namespaces und Typen organisiert. Beim Treemapping werden diese Artefakte als nebeneinanderliegende Rechtecke dargestellt. Ihre Flächen – und damit das Gewicht einzelner Funktionen – lassen sich visuell vergleichen. Wer die Codegröße regelmäßig per Treemap untersucht, entwickelt ein sehr gutes Gefühl für Umfang und Kosten von Features.
Visualisieren Sie testweise eine Ihnen gut bekannte Codebasis als Treemap. Wahrscheinlich werden Sie von der unerwarteten Größe mancher Features überrascht sein.
Beobachtungen zur Codestruktur
Die Metric View kann auch mit anderen Metriken als Umfang (Codezeilen, Anzahl der Methodenparameter …) oder Komplexität interessante Erkenntnisse liefern.
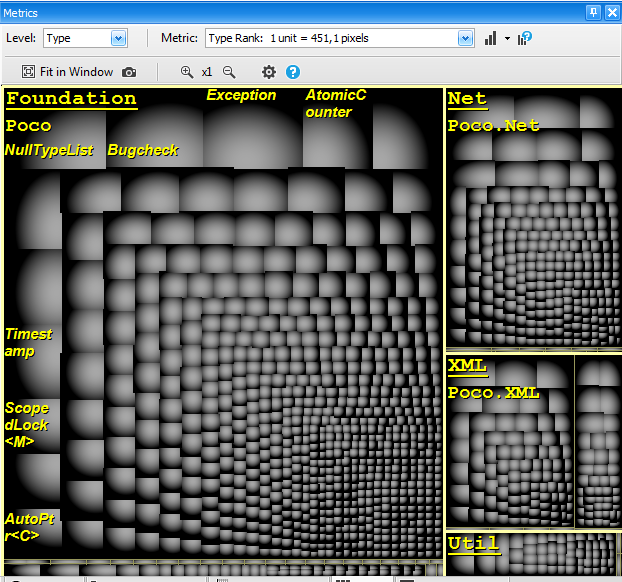
The Ranking-Metrik ist eine Codemetrik, die die Popularität eines Typs oder einer Methode innerhalb einer Codebasis misst. In Verbindung mit Treemapping zeigt sie klar, wo häufig verwendete Typen deklariert sind. Dadurch wird schnell sichtbar, welche Elemente der Codebasis besonders wichtig sind.
The screenshot below shows the types of the Microsoft DLR (Dynamic Language Runtime) Codebasis als Treemap mit der Ranking-Metrik. Die Treemap zeigt, dass CallSite and Expression zentrale Konzepte der DLR sind – und genau das entspricht der Realität.
Ähnliche interessante Beobachtungen zur Codestruktur lassen sich mit Metriken wie afferenter/efferenter Kopplung oder Level.
II – Abhängigkeitsgraph
CppDepend bietet zahlreiche Funktionen, um eine bestehende Codearchitektur mithilfe des Abhängigkeitsgraphen zu untersuchen. Zu den häufigsten Szenarien gehört der Aufrufgraph.
CppDepend kann den benötigten Aufrufgraphen in zwei Schritten erzeugen.
- Erstens: Fordern Sie die direkten und indirekten Aufrufer beziehungsweise Aufgerufenen eines Typs, Felds, einer Methode, eines Namespace oder Projekts an. Daraufhin wird eine CQLinq-Abfrage erzeugt, die alle gewünschten Elemente findet.
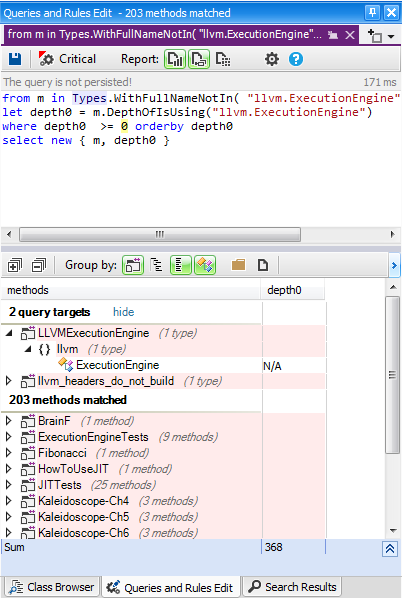
- Beachten Sie, dass im Ergebnis der CQLinq-Abfrage die Metrik DepthOfIsUsing/DepthOfIsUsedBy die Nutzungstiefe angibt (1 bedeutet direkt, 2 bedeutet über einen direkten Nutzer usw.). Die CQLinq-Abfrage lässt sich leicht so ändern, dass nur indirekte Aufrufer beziehungsweise Aufgerufene mit einer bestimmten Nutzungstiefe gefunden werden. Außerdem müssen diese Elemente nicht vom selben Typ wie das untersuchte Codeelement sein. Hier suchen wir beispielsweise nach Methoden, die einen Typ direkt oder indirekt verwenden.
- Zweitens: Sobald die CQLinq-Abfrage die gewünschten Aufrufer beziehungsweise Aufgerufenen gefunden hat, können die Ergebnisse in den Abhängigkeitsgraphen exportiert werden. Dadurch entsteht der gewünschte Aufrufgraph.
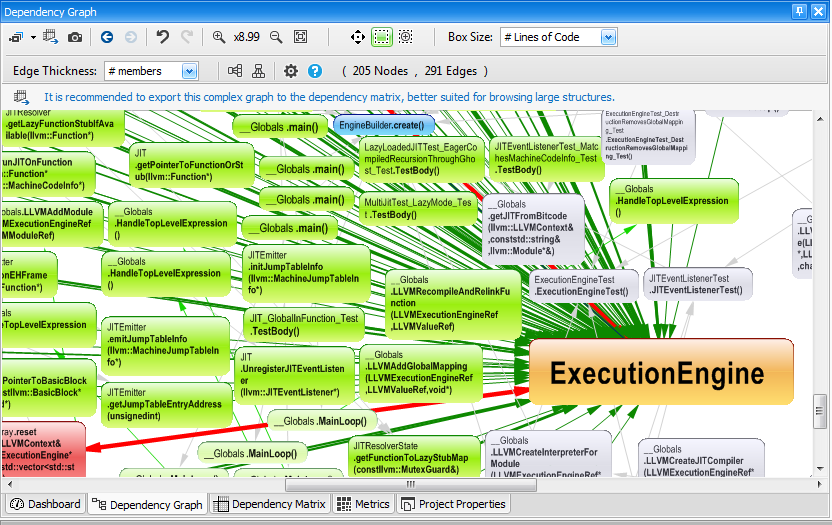
Klassenvererbungsgraph
Für einen Klassenvererbungsgraphen wird dasselbe zweistufige Verfahren wie im vorherigen Abschnitt zum Aufrufgraphen verwendet.
- Erstens: Erzeugen Sie eine CQLinq-Abfrage für alle Klassen, die von einer bestimmten Klasse erben oder ein bestimmtes Interface implementieren. Dabei entsteht beispielsweise folgende CQLinq-Abfrage:
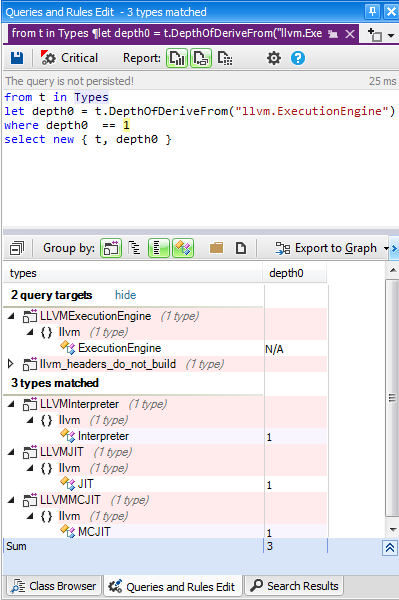
- Zweitens: Exportieren Sie das Ergebnis der CQLinq-Abfrage in den Abhängigkeitsgraphen, um den gewünschten Vererbungsgraphen anzuzeigen.
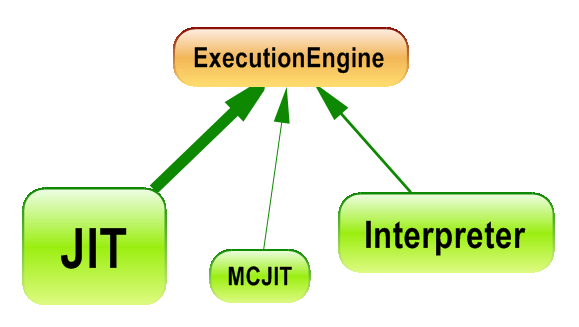
Kopplungsgraph
Manchmal muss genau bekannt sein, welche Codeelemente an einer bestimmten Abhängigkeit beteiligt sind – insbesondere, wenn die Auswirkungen einer strukturellen Änderung abgeschätzt werden sollen. Im folgenden Screenshot beschreibt das CppDepend-Info-Panel die Kopplung zwischen zwei Projekten.
Wenn Sie auf eine Zelle der Abhängigkeitsmatrix zeigen, erfahren Sie, dass X Typen aus Projekt A Y Typen aus Projekt B verwenden. Die Option Weight on Cell kann dabei auf # methods, # members oder # namespaces gesetzt werden, wenn die Kopplung nicht anhand von Typen gemessen werden soll.
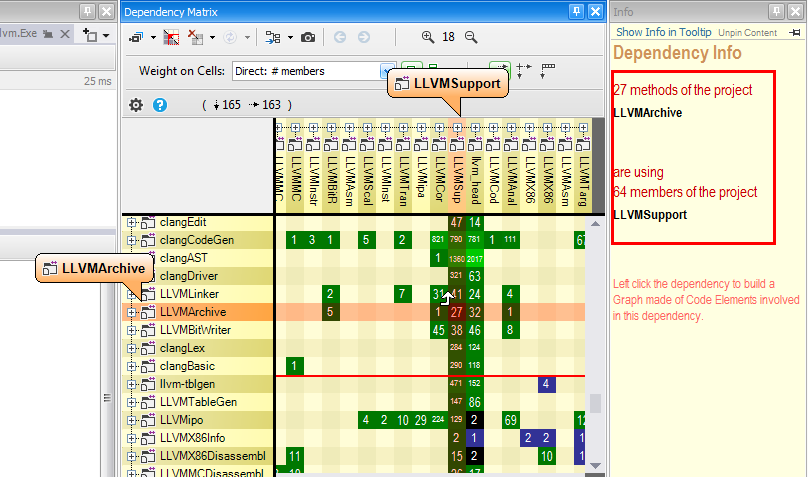
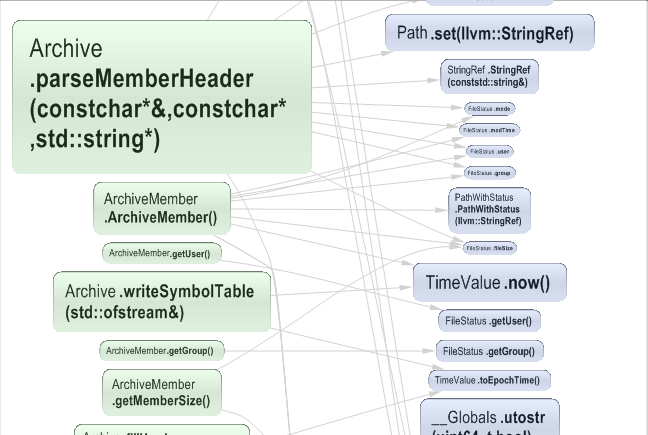
Ein einfacher Linksklick auf die Matrixzelle zeigt den folgenden Kopplungsgraphen.
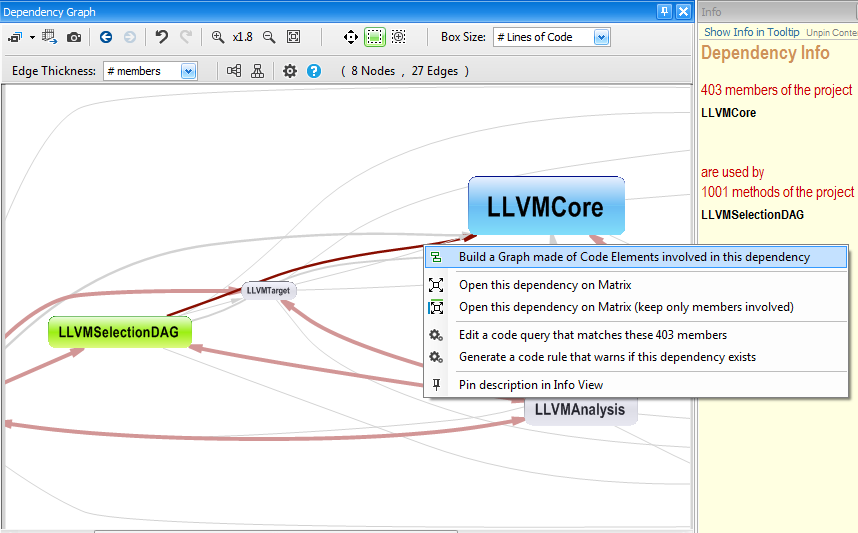
Ein Kopplungsgraph kann auch aus einer Kante des Abhängigkeitsgraphen erzeugt werden. Hier lässt sich die Option Edge Thickness auf einen anderen Wert als # Typen.
Pfadgraph
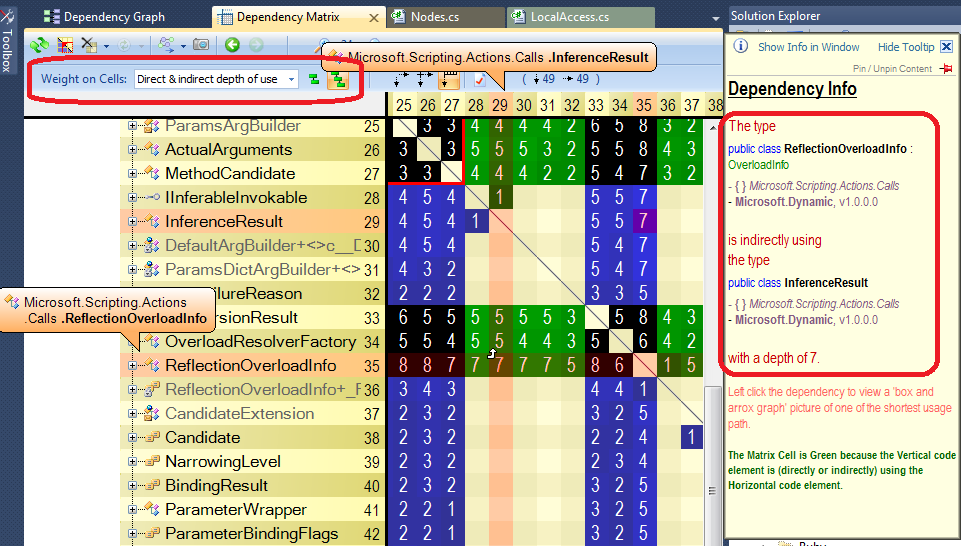
Wenn Sie einen Pfad oder Abhängigkeitszyklus zwischen zwei Codeelementen untersuchen möchten, zeigen Sie zunächst die Abhängigkeitsmatrix mit folgender Option an: Weight on Cells: Direkte und indirekte Nutzungstiefe.
Blaue und grüne Matrixzellen repräsentieren Pfade, während schwarze Zellen Abhängigkeitszyklen. Hier zeigt das Info-Panel beispielsweise einen Pfad mit einer Mindestlänge von 7 zwischen den beiden beteiligten Typen.
Ein Linksklick auf die Zelle zeigt den folgenden Pfadgraphen.
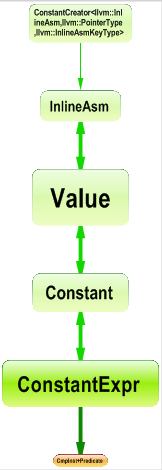
Graph aller Pfade
In bestimmten Situationen müssen alle Pfade von Codeelement A zu Codeelement B bekannt sein. Hier zeigt das Info-Panel beispielsweise einen Pfad mit einer Mindestlänge von 2 zwischen den beiden Typen.
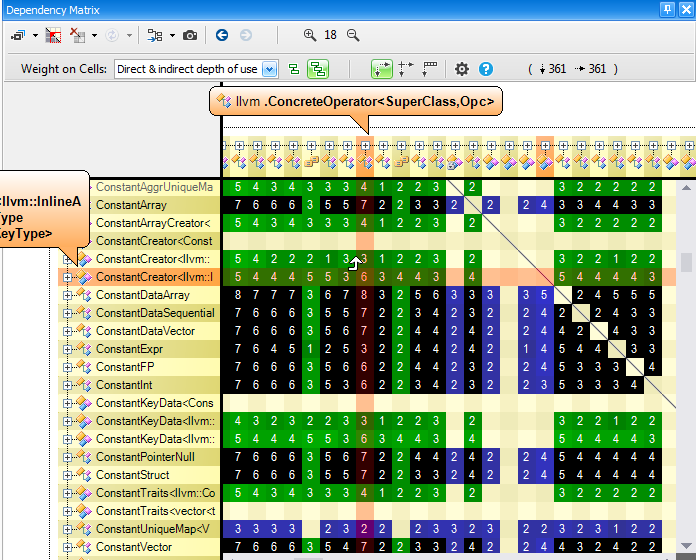
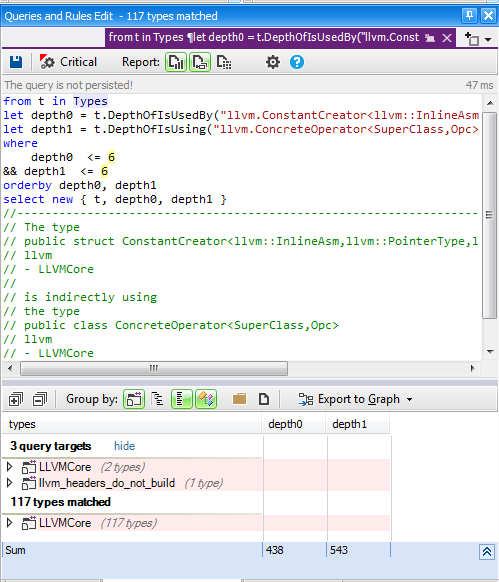
Wenn die zwölf von der CQLinq-Abfrage gefundenen Typen anschließend in den Graphen exportiert werden, erscheinen alle Pfade von A nach B.
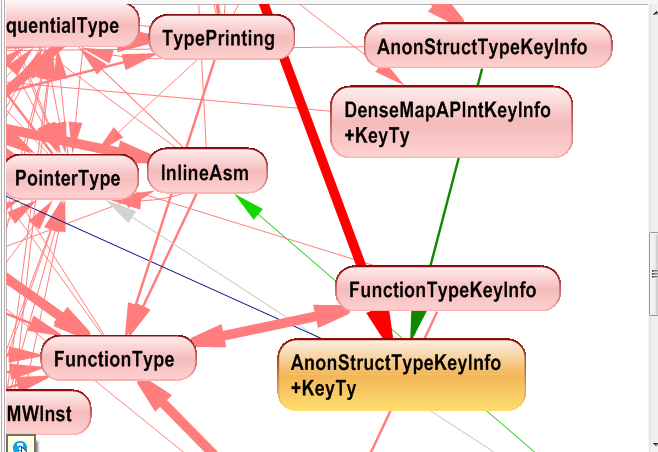
Zyklusgraph
Wie im vorherigen Abschnitt erläutert, muss für Abhängigkeitszyklen zunächst die Abhängigkeitsmatrix mit folgender Option angezeigt werden: Weight on Cells: Direkte und indirekte Nutzungstiefe. Schwarze Zellen repräsentieren dann Zyklen.
Hier zeigt das Info-Panel beispielsweise einen Abhängigkeitszyklus mit einer Mindestlänge von 5 zwischen den beiden Typen.
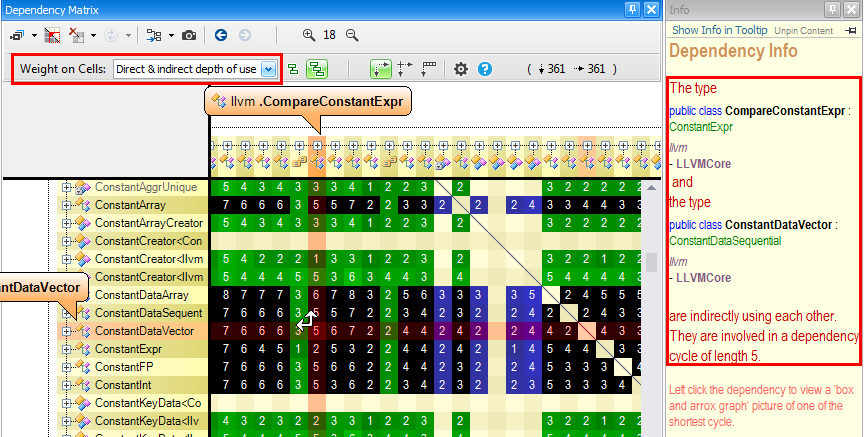
Ein Linksklick auf die Zelle zeigt den folgenden Zyklusgraphen.
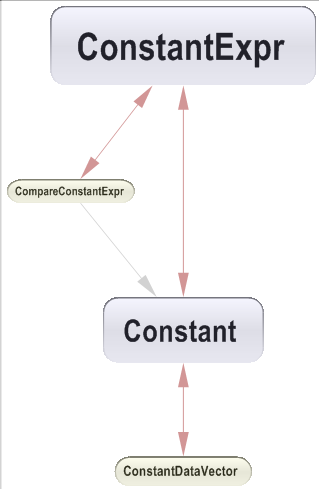
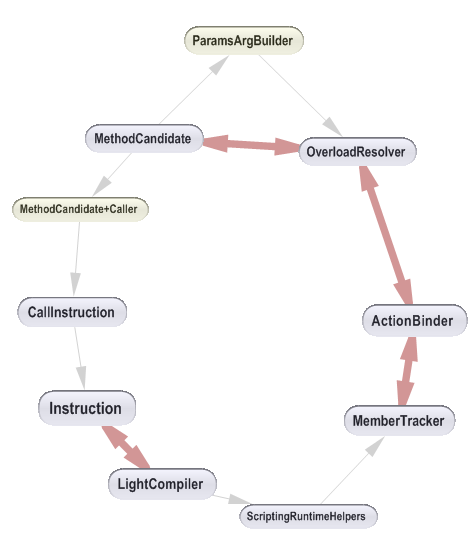
Ein sauberer, „runder“ Abhängigkeitszyklus wie oben ist eher die Ausnahme als die Regel.
Häufig führt die Darstellung eines Zyklus zu einem weniger „runden“ Graphen wie im folgenden Beispiel. Hier beträgt die Mindestlänge eines Zyklus zwischen den beiden gelb markierten Typen 12. Zählt man die durchlaufenen Kanten von einem gelben Typ zum anderen, erhält man 12; einige Kanten werden dabei mehrfach durchlaufen.
III – Dependency Structure Matrix
Großen Graphen mit einer Dependency Structure Matrix visualisieren
Wenn der Abhängigkeitsgraph unlesbar wird, lohnt sich der Wechsel zur Abhängigkeitsmatrix. Beide Darstellungsformen existieren nebeneinander, weil sie unterschiedliche Stärken haben:
- Der Abhängigkeitsgraph ist intuitiv, wird jedoch unlesbar, sobald zu viele Kanten zwischen den Knoten vorhanden sind.
- Die Abhängigkeitsmatrix benötigt etwas Einarbeitung. Sobald man sie beherrscht, ist sie bei der Untersuchung einer bestehenden Architektur jedoch deutlich effizienter als der Abhängigkeitsgraph. Weitere Informationen zur Lesbarkeit finden Sie unter Codestrukturmuster auf einen Blick erkennen
Zur Veranschaulichung werden im Folgenden dieselben Abhängigkeiten zwischen 77 Namespaces einmal als Abhängigkeitsgraph und einmal als Abhängigkeitsmatrix dargestellt.
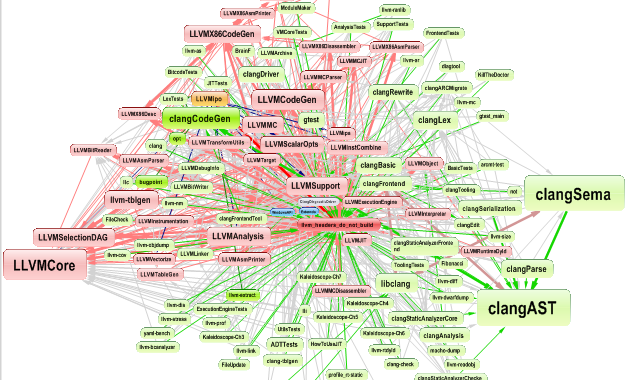
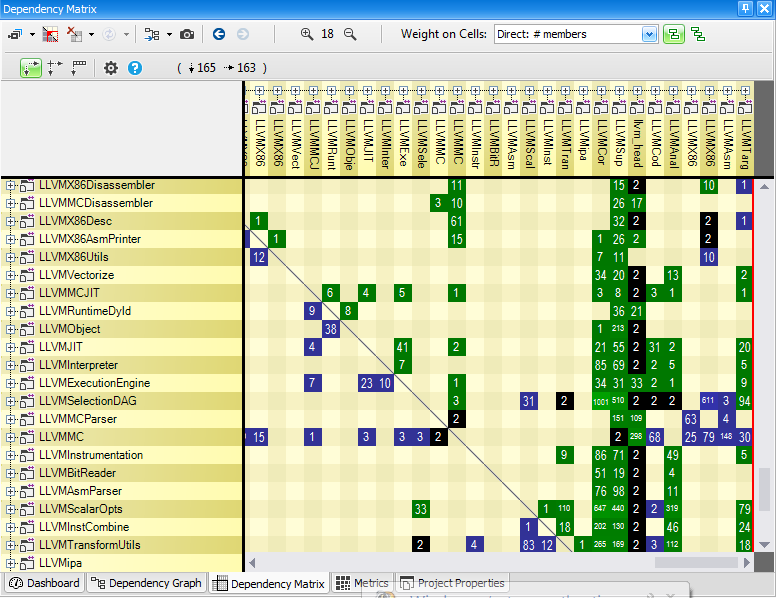
Die DSM (Dependency Structure Matrix) ist eine kompakte Möglichkeit, Abhängigkeiten zwischen Komponenten darzustellen und zu navigieren. Für viele Entwickler sehen Abhängigkeiten zunächst eher wie ein klassischer Graph aus:
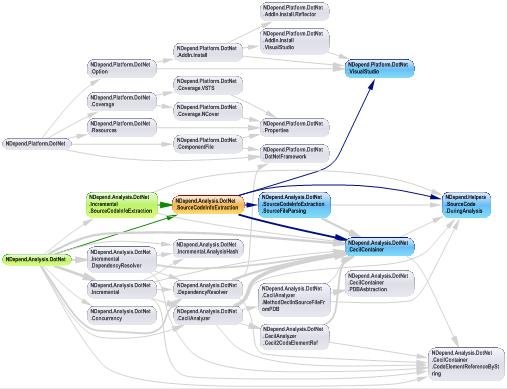
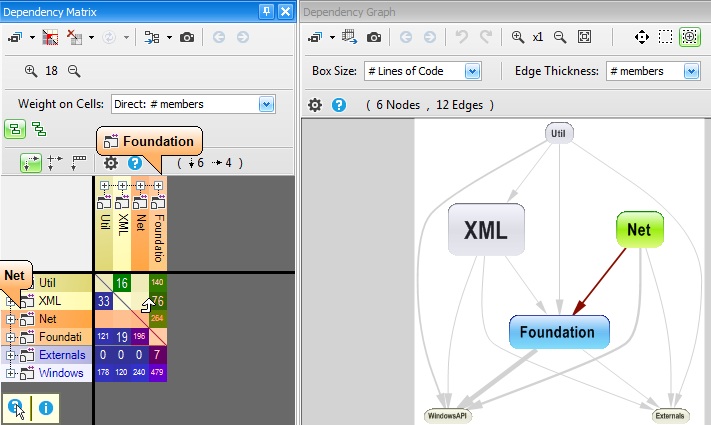
Eine DSM stellt dieselben Informationen wie ein Graph dar.
- Die Matrixüberschriften entsprechen den Boxen des Graphen.
- Nicht leere Matrixzellen entsprechen den Pfeilen des Graphen.
Dementsprechend wird im folgenden Screenshot die Kopplung von Net zu Foundation durch eine nicht leere Zelle in der Matrix und einen Pfeil im Graphen dargestellt.
Warum dieselben Informationen auf zwei Arten – Graph und DSM – darstellen? Weil beide Ansätze unterschiedliche Vor- und Nachteile haben:
- Ein Graph ist intuitiver, kann aber bei wachsender Zahl von Knoten und Kanten völlig unübersichtlich werden; schon einige Dutzend Boxen können einen übermäßig komplexen Graphen erzeugen.
- Eine DSM ist weniger intuitiv, kann große und komplexe Graphen jedoch sehr effizient darstellen. Man sagt daher, dass DSMs besser skalieren als Graphen.
Wer die Prinzipien einer DSM verstanden hat, bevorzugt sie häufig zur Darstellung von Abhängigkeiten. Der Hauptgrund: Strukturelle Muster lassen sich damit auf einen Blick erkennen. Dies wird in der zweiten Hälfte dieses Artikels erläutert.
CppDepend bietet kontextsensitive Hilfe, die erklärt, was in der DSM zu sehen ist. Die DSM verwendet ein einfaches Farbschema mit blauen, grünen und schwarzen Zellen. Wenn Sie mit der Maus über eine Zeile oder Spalte fahren, erläutert die kontextsensitive Hilfe die Bedeutung dieser Farben.
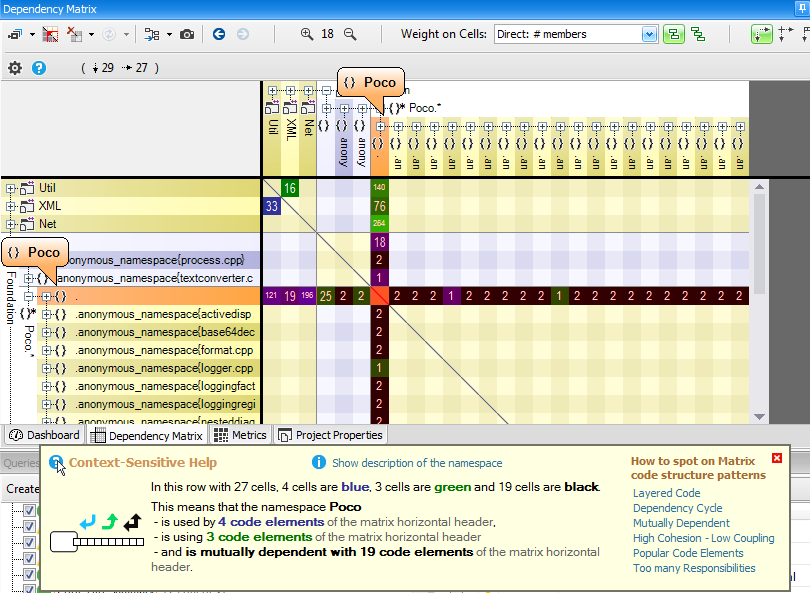
Eine nicht leere DSM-Zelle enthält eine Zahl. Sie repräsentiert die Stärke der durch die Zelle dargestellten Kopplung. Abhängig vom aktuellen Wert der Option Weight on Cells kann die Kopplungsstärke anhand der Anzahl beteiligter Member, Methoden, Felder, Typen oder Namespaces ausgedrückt werden. Zusätzlich zur kontextsensitiven Hilfe bietet die DSM ein Info-Panel, das die Kopplung in verständlicher Sprache erläutert.
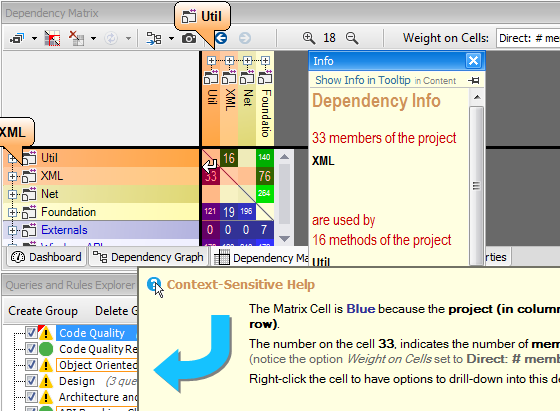
Die DSM von CppDepend bietet zahlreiche Optionen:
- Es gibt zahlreiche Funktionen zur detaillierten Untersuchung von Abhängigkeiten, etwa das Öffnen übergeordneter Spalten oder Zeilen und das Erweitern von Zellen.
- Sie unterstützt quadratische symmetrische sowie rechteckige nicht symmetrische DSMs.
- Horizontale und vertikale Überschriften können gekoppelt werden, sodass stets eine quadratische symmetrische Matrix entsteht.
- Sie bietet die Option Indirect usage bei der Zellen sowohl direkte als auch indirekte Nutzung anzeigen.
- Die vertikale Überschrift kann Codeelemente einer Ebene enthalten.
- ...
Am besten probieren Sie diese Funktionen selbst aus, indem Sie die Abhängigkeiten Ihrer eigenen Codebasis analysieren. Codestrukturmuster in einer Matrix erkennen
Wie in der Einleitung beschrieben, erleichtert eine DSM die Erkennung typischer Codestrukturmuster. Ein häufiges Beispiel ist geschichteter Code, also eine azyklische Struktur. Ist die Matrix dreieckig, mit allen blauen Zellen links unten und allen grünen Zellen rechts oben, ist die Struktur vollständig geschichtet und enthält keinen Abhängigkeitszyklus.
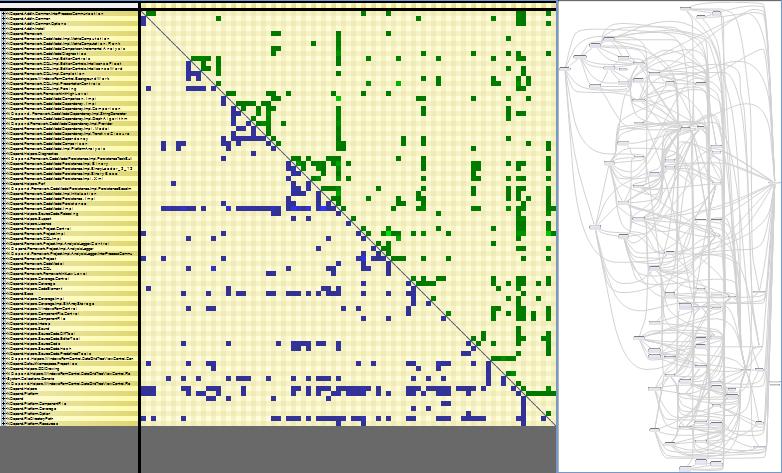
Rechts im Screenshot ist dieselbe geschichtete Struktur als Graph dargestellt. Alle Pfeile verlaufen von links nach rechts. Das Problem: Das Graphlayout skaliert schlecht. Schon hier ist die Gesamtstruktur kaum noch zu erkennen. Bei doppelt so vielen Boxen wäre der Graph völlig unlesbar, während die DSM-Darstellung davon kaum beeinträchtigt würde. Deshalb skaliert eine DSM besser als ein Graph.
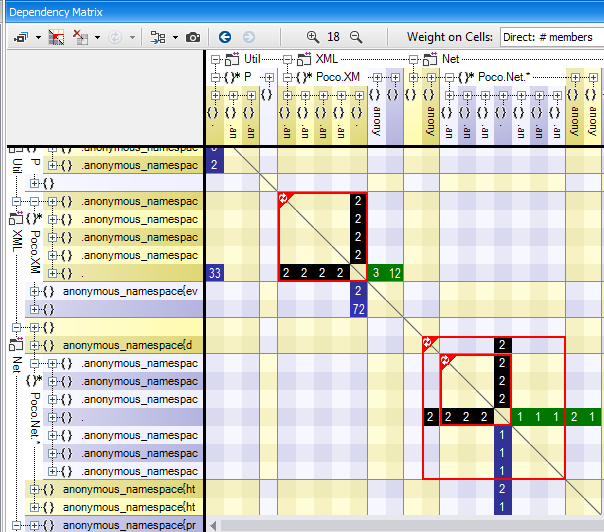
Nebenbemerkung: Interessanterweise setzen die meisten Graphlayout-Algorithmen einen azyklischen Graphen voraus. Um das Layout eines Graphen mit Zyklen zu berechnen, entfernen sie vorübergehend einige Abhängigkeiten, behandeln den Rest als geschichteten Graphen und fügen die entfernten Abhängigkeiten erst im letzten Berechnungsschritt wieder hinzu. Abhängigkeitszyklus: Enthält eine Struktur einen Zyklus, wird dieser in der DSM durch ein rotes Quadrat dargestellt. Innerhalb dieses Quadrats sind grüne und blaue Zellen über die Diagonale hinweg gemischt. Schwarze Zellen stehen für gegenseitige direkte Nutzung, also A verwendet B und B verwendet A.
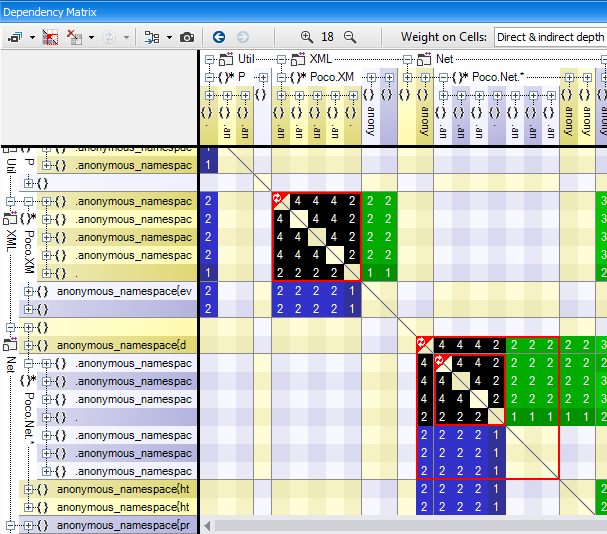
Die DSM von CppDepend bietet die besondere Option Indirect Dependency Eine indirekte Abhängigkeit zwischen A und B bedeutet, dass A etwas verwendet, das wiederum etwas verwendet usw., bis schließlich B verwendet wird. Unten ist dieselbe DSM mit einem Zyklus im indirekten Modus dargestellt. Das rote Quadrat enthält ausschließlich schwarze Zellen. Das bedeutet, dass für beliebige Elemente A und B innerhalb des Zyklus eine indirekte gegenseitige Abhängigkeit besteht.
Hier ist dieselbe Struktur als Graph dargestellt. Der rote Pfeil zeigt, dass mehrere Elemente gegenseitig voneinander abhängig sind. Der Graph hilft jedoch kaum dabei, alle am übergeordneten Zyklus beteiligten Elemente hervorzuheben.
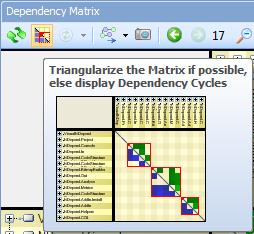
CppDepend bietet eine Schaltfläche, mit der vorhandene Zyklen in der DSM hervorgehoben werden können. Ist die Struktur geschichtet, bringt diese Funktion die Matrix in Dreiecksform und hält nicht leere Zellen möglichst nahe an der Diagonale.
Hohe Kohäsion – geringe Kopplung
Das Prinzip „hohe Kohäsion innerhalb einer Komponente, geringe Kopplung zwischen Komponenten“ ist heute weit verbreitet. Ohne Abhängigkeiten messen und visualisieren zu können, lässt sich Kohäsion und Kopplung jedoch nur schwer konkret bewerten. Eine DSM eignet sich gut, um hohe Kohäsion sichtbar zu machen. In der folgenden DSM ist um die Diagonale ein deutliches quadratisches Muster zu sehen. Die beteiligten Elemente hängen stark voneinander ab und weisen daher hohe Kohäsion auf. Da kein Zyklus vorhanden ist, sind sie zudem geschichtet. Sie sind gute Kandidaten, um in einem übergeordneten Artefakt wie einem Namespace oder einer Assembly zusammengefasst zu werden.
Dass die meisten Zellen um das Quadrat leer sind, deutet zugleich auf eine geringe Kopplung zwischen den Elementen des Quadrats und anderen Elementen hin.
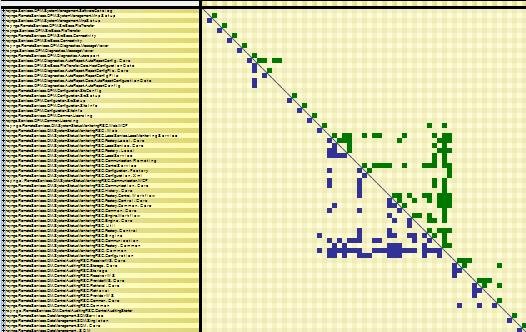
In der folgenden DSM sehen wir zwei Komponenten mit hoher Kohäsion – oberes und unteres Quadrat – und einer relativ geringen Kopplung zwischen ihnen.
Beim Refactoring ist ein solcher Indikator sehr hilfreich, um zu erkennen, ob sich grobe Komponenten sinnvoll in mehrere feiner granulare Komponenten aufteilen lassen.
Zu viele Verantwortlichkeiten
Das Single Responsibility Principle (SRP) ist in der Softwarearchitektur weit verbreitet. Es besagt, dass eine Klasse nicht mehr als einen Grund zur Änderung haben sollte. Eine weitere Interpretation lautet, dass eine Klasse nicht zu viele unterschiedliche andere Typen verwenden sollte. Überträgt man diese Idee auf Assemblies, Namespaces und Methoden, dann hat ein Codeelement, das Dutzende andere Elemente derselben Ebene verwendet, sehr wahrscheinlich zu viele Verantwortlichkeiten. Solcher Code wird häufig als God Class oder God Component bezeichnet.
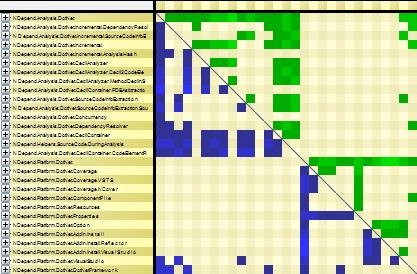
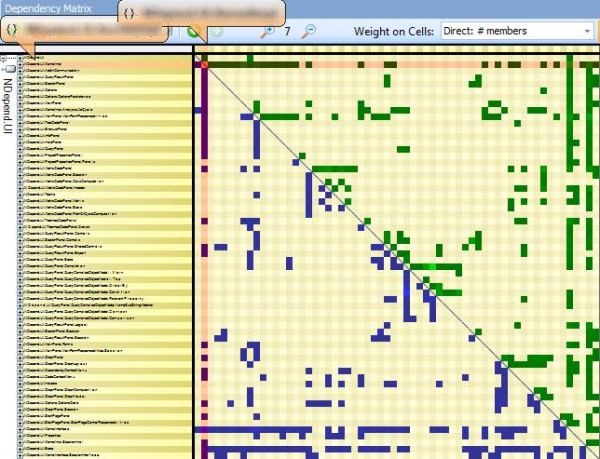
Eine DSM kann Codeelemente mit zu vielen Verantwortlichkeiten gezielt sichtbar machen. Solche Elemente erscheinen als Spalten mit vielen blauen und Zeilen mit vielen grünen Zellen. Die folgende DSM zeigt dieses Muster.
Häufig verwendete Codeelemente
Ein häufig verwendetes Codeelement wird von vielen anderen Codeelementen genutzt. Solche Elemente sind unvermeidlich – denken Sie etwa an die String Klasse. Ein häufig verwendetes Codeelement ist jedoch kein Fehler. Es bedeutet lediglich, dass jede Codebasis zentrale Konzepte besitzt, die durch stark genutzte Klassen repräsentiert werden.
Ein häufig verwendetes Codeelement erscheint als Spalte mit vielen grünen und als Zeile mit vielen blauen Zellen. Die folgende DSM hebt ein solches Element hervor.
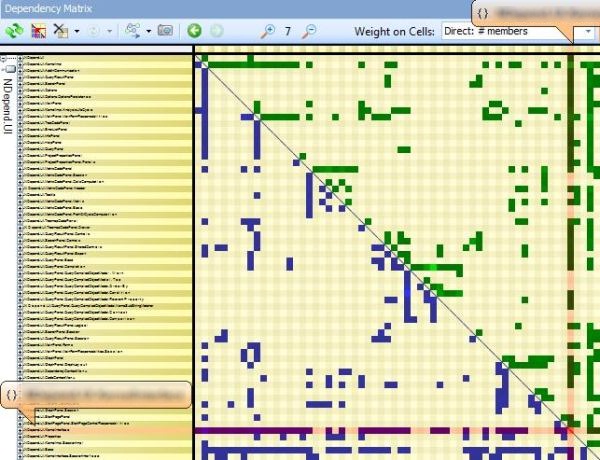
Bei einer sauber geschichteten Codestruktur befinden sich häufig verwendete Komponenten ganz natürlich auf einer niedrigen Ebene. Eine solche Komponente kann selbst nicht viele höher liegende Elemente verwenden, da sonst eine Abhängigkeit von einer niedrigen zu einer höheren Ebene entstünde und die azyklische Struktur verletzt würde.
Gegenseitig abhängig
Die Kopplung zwischen zwei Komponenten lässt sich anzeigen, indem Sie mit der rechten Maustaste auf eine nicht leere Zelle klicken und Open this dependency auswählen.
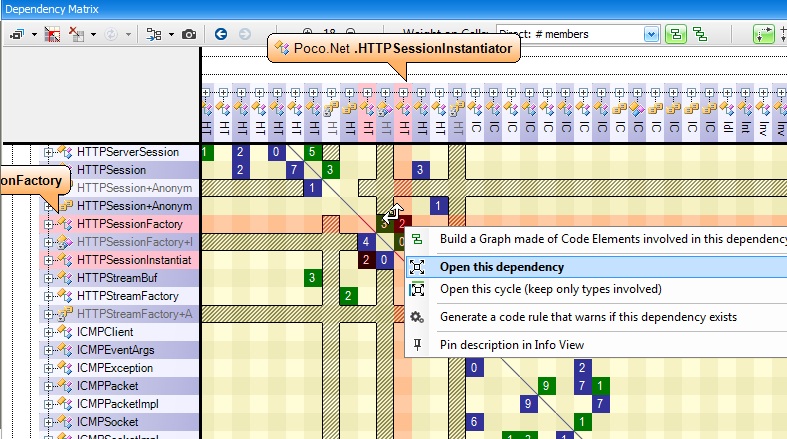
Ist die geöffnete Zelle schwarz, wie im Screenshot oben – A und B sind also gegenseitig abhängig –, enthält die resultierende rechteckige Matrix sowohl grüne als auch blaue und gegebenenfalls schwarze Zellen.
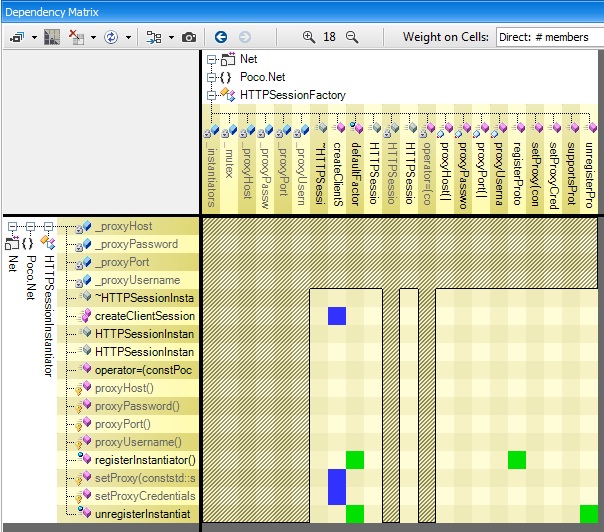
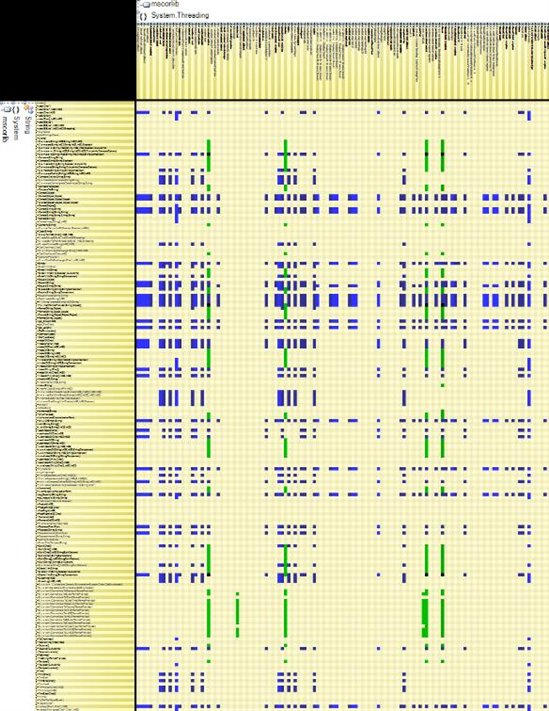
In einer solchen Situation fällt häufig ein Ungleichgewicht zwischen grünen und blauen Zellen auf – hier drei blaue gegenüber einer grünen. Denn selbst bei gegenseitiger Abhängigkeit zweier Codeelemente gibt es oft eine natürliche Ebenenordnung. Betrachten wir beispielsweise den System.Threading Namespace und die System.String Klasse. Beide sind gegenseitig voneinander abhängig. Die Matrix zeigt jedoch, dass Threading deutlich stärker von String abhängt als umgekehrt, da es deutlich mehr blaue als grüne Zellen gibt. Das bestätigt die Annahme, dass Threading auf einer höheren Ebene liegt als String.