«Une image vaut mille mots» est un idiome anglais. Il exprime l'idée qu'une idée complexe peut être transmise avec une simple image fixe, ou qu'une image d'un sujet en transmet le sens ou l'essence plus efficacement qu'une description.
Cet idiome peut aussi s'appliquer à la programmation logicielle. En effet, on comprend facilement un mini-projet en explorant son code source. En revanche, un gros projet peut vite devenir complexe et difficile à comprendre. Dans de tels cas, il vaut mieux visualiser le code source à l'aide de graphes et de diagrammes pour faciliter la compréhension des développeurs.
Explorons quelques diagrammes utiles fournis par CppDepend pour comprendre une base de code.
I - Le diagramme treemap
Le treemapping est une méthode d'affichage de données arborescentes à l'aide de rectangles imbriqués. L'arborescence utilisée dans le treemap de CppDepend est la hiérarchie de code habituelle :
- Les projets C/C++ contiennent des espaces de noms,
- Les espaces de noms contiennent des types,
- Les types contiennent des méthodes et des champs.
Avec un treemap, les rectangles représentent des éléments de code. L'option level détermine le type d'élément de code représenté par chaque rectangle unitaire. L'option level peut prendre 5 valeurs : project, namespace, type, method et field. Les deux captures d'écran ci-dessous montrent la même base de code représentée avec le niveau type à gauche et le niveau namespace à droite.
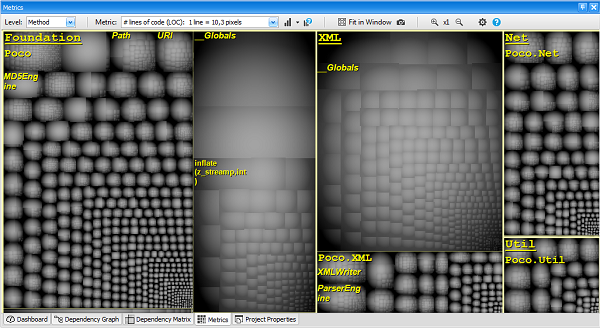
L'option Code Metric du treemap détermine la taille des rectangles. Par exemple, si le niveau est défini sur type et la métrique sur nombre de lignes de code, chaque rectangle unitaire représente un type, et la taille d'un rectangle unitaire est proportionnelle au nombre de lignes de code du type correspondant.
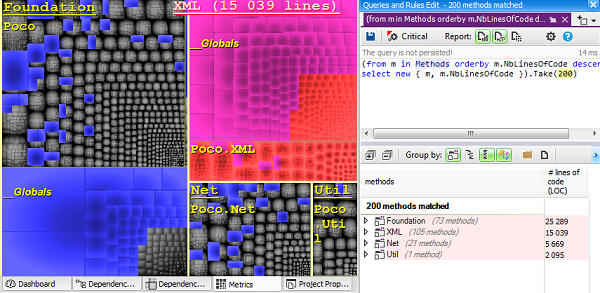
Si une requête CQLinq est en cours d'édition, l'ensemble des éléments de code correspondant à la requête s'affiche sur le treemap sous forme de rectangles bleus. Dans la capture d'écran ci-dessous, une requête CQLinq correspond aux 200 plus grosses méthodes. Ici, le niveau du treemap est method et la métrique sur nombre de lignes de code. Comme prévu, on peut voir que les rectangles bleus représentent les 200 plus grands rectangles unitaires du treemap.
La capture d'écran ci-dessous montre aussi que l'élément de code actuellement sélectionné (ici le projet XML) s'affiche sous forme de rectangle rouge sur le treemap.
Scénarios courants
En choisissant une combinaison appropriée de valeurs de métrique et de niveau, la vue Metric vous aide à voir des motifs qui seraient difficiles à repérer autrement. Trop gros, trop complexe CppDepend fournit de nombreuses métriques de code pour repérer le code trop volumineux et trop complexe. Les méthodes avec trop de paramètres, de variables, de lignes de code ou une complexité cyclomatique excessive doivent être évitées. Il en va de même pour les types avec trop de lignes de code.
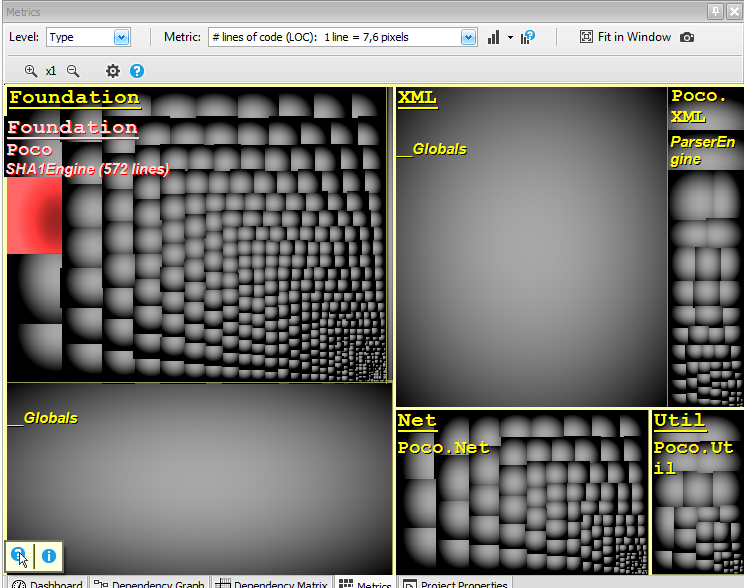
Dans la capture d'écran ci-dessous, le niveau du treemap est défini sur type et la métrique sur nombre de lignes de code. Les grands rectangles représentent les gros types de la base de code. Survoler un rectangle affiche les valeurs des métriques du type, ici son nombre de lignes de code. De toute évidence, le treemapping du code aide non seulement à repérer les éléments de code trop volumineux et trop complexes, mais aussi à comparer leurs tailles et complexités respectives.
Localisation des défauts
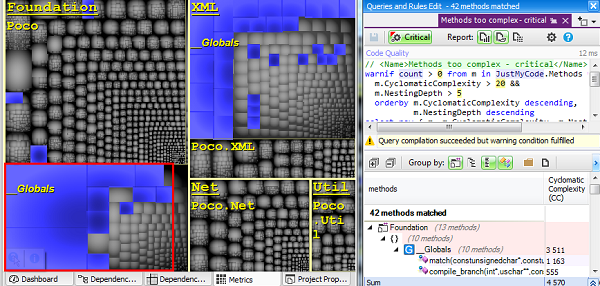
Dans la capture d'écran ci-dessous, nous utilisons une requête CQLinq pour trouver les méthodes avec trop de paramètres et de variables. Les rectangles bleus montrent les méthodes correspondantes sur le treemap. Le point intéressant ici est que certaines méthodes correspondantes semblent regroupées. Comme le treemap est une vue hiérarchique, si un ensemble d'éléments de code est regroupé, cela signifie que ces éléments appartiennent au même parent. Et en effet, les 12 méthodes regroupées ici appartiennent au même type.
Identifier les types parents de ces 12 méthodes aurait été difficile sans le treemapping. Le relecteur de qualité du code peut maintenant se concentrer sur cette zone, qui semble contenir plus de défauts que d'autres parties de la base de code.
Exploration du code de haut en bas
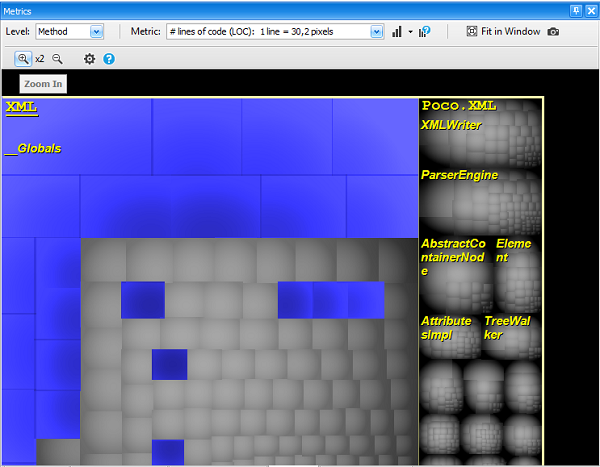
La vue treemap de CppDepend prend en charge le zoom avant et arrière. Cela facilite le zoom sur un projet, un espace de noms ou une classe particulier. Cela peut être particulièrement utile pour explorer et comparer le volume des composants en termes de lignes de code.
La productivité ne doit en aucun cas être mesurée en nombre de lignes de code. Cependant, le comptage des lignes de code s'est avéré être une métrique utile pour estimer précisément un logiciel, compte tenu du contexte d'une organisation. Les fonctionnalités de la base de code sont organisées en assemblys, espaces de noms et types. Avec le treemapping, ces artefacts deviennent des rectangles côte à côte. Les surfaces des rectangles, et donc le poids des fonctionnalités, peuvent être comparées visuellement. Pouvoir explorer périodiquement la taille du code via le treemapping est une façon unique de se forger une intuition précise du poids et du coût des fonctionnalités.
Essayez l'expérience de visualiser un treemap d'une base de code que vous connaissez bien, et vous serez surpris de découvrir des tailles de fonctionnalités inattendues.
Observations sur la structure du code
Choisir d'utiliser la vue Metric avec une métrique autre que le volume (lignes de code, nombre de paramètres des méthodes…) ou la complexité peut révéler des observations intéressantes.
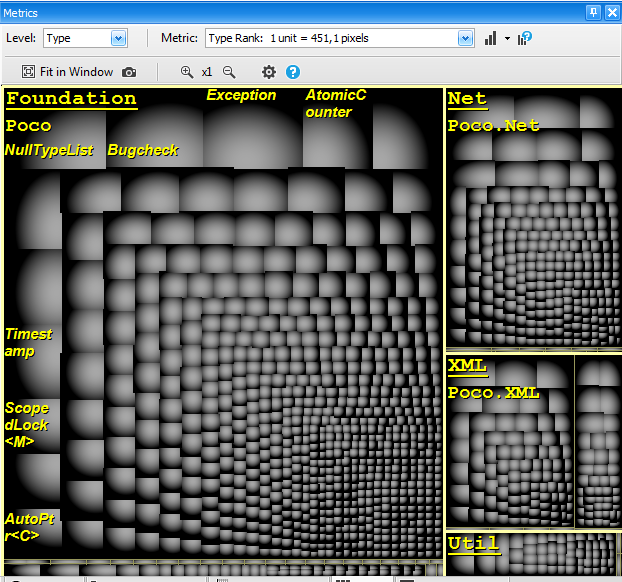
La métrique de ranking est une métrique de code qui mesure la popularité d'un type ou d'une méthode dans une base de code. Utiliser le treemapping avec la métrique de ranking donne une vue claire de l'endroit où les types populaires sont déclarés. Cela révèle rapidement ce qui est important dans la base de code.
La capture d'écran ci-dessous montre les types de la base de code Microsoft DLR (Dynamic Language Runtime) représentés en treemap avec la métrique de ranking. Le treemap indique que CallSite et Expression sont des concepts populaires du DLR, et c'est bien le cas.
Le même genre d'observations intéressantes sur la structure du code peut être fait avec des métriques comme le couplage afférent/efférent ou Level.
II - Le graphe de dépendances
CppDepend offre un large éventail de fonctionnalités pour aider les utilisateurs à explorer une architecture de code existante à l'aide du graphe de dépendances. Voici les scénarios d'exploration de code les plus populaires : Graphe d'appels
CppDepend peut générer n'importe quel graphe d'appels dont vous avez besoin en deux étapes.
- Premièrement : demander les appelants/appelés directs et indirects d'un type, d'un champ, d'une méthode, d'un espace de noms ou d'un projet. L'effet est que la requête CQLinq suivante est générée pour correspondre à tous les appelants ou appelés demandés.
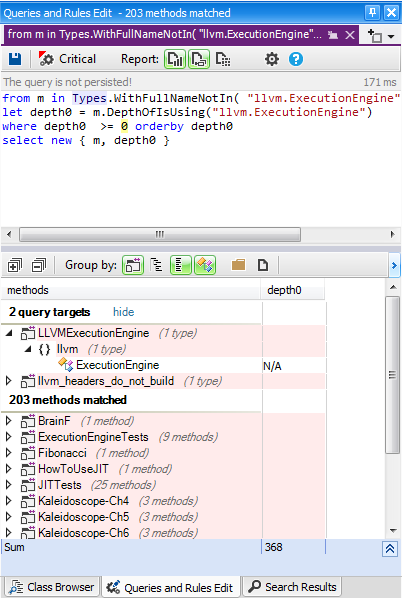
- Notez que, dans le résultat de la requête CQLinq, la métrique DepthOfIsUsing/DepthOfIsUsedBy montre la profondeur d'utilisation (1 signifie direct, 2 signifie via un utilisateur direct, etc.). La requête CQLinq peut facilement être modifiée pour ne correspondre qu'aux appelants/appelés indirects avec une certaine condition sur la profondeur d'utilisation. Notez aussi que les appelants/appelés demandés ne sont pas nécessairement du même genre que l'élément de code concerné. Par exemple, ici nous demandons les méthodes qui utilisent un type directement ou indirectement.
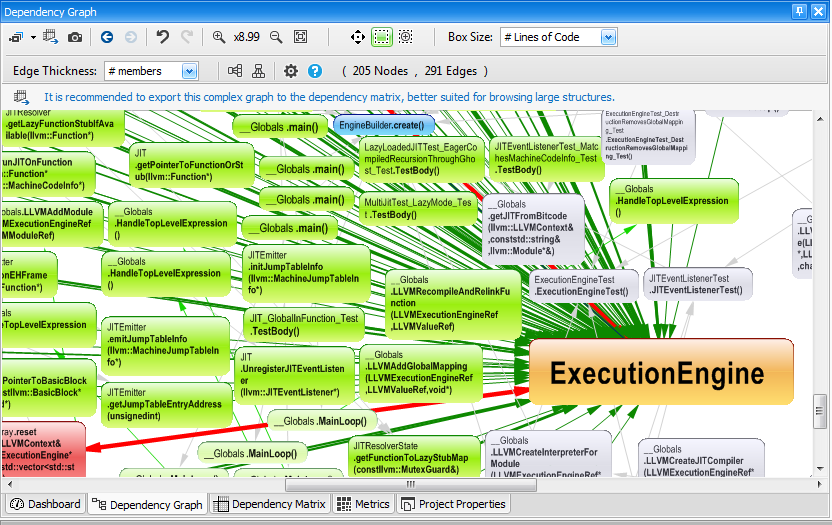
- Deuxièmement : une fois que la requête CQLinq correspond à l'ensemble des appelants/appelés souhaités, l'ensemble des résultats peut être exporté vers le graphe de dépendances. Cela affiche le graphe d'appels souhaité.
Graphe d'héritage des classes
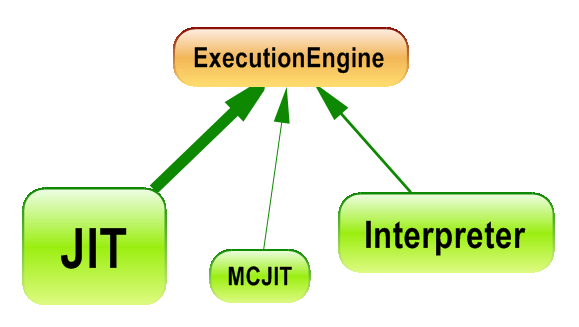
Pour afficher un graphe d'héritage des classes, la même procédure en deux étapes présentée dans la section précédente (sur la génération d'un graphe d'appels) doit être appliquée.
- Premièrement : générer une requête CQLinq demandant l'ensemble des classes qui héritent d'une classe particulière (ou qui implémentent une interface particulière). Ici, la requête CQLinq suivante est générée :
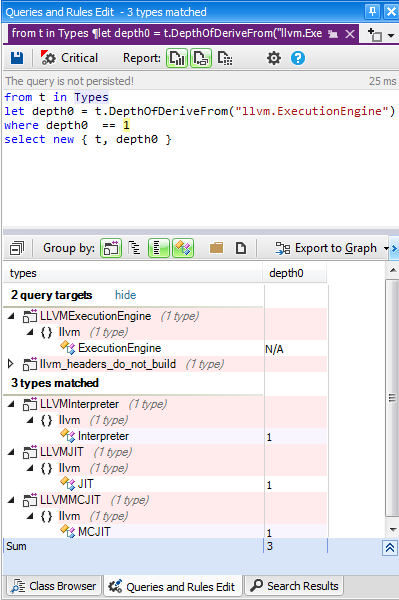
- Deuxièmement : exporter le résultat de la requête CQLinq vers le graphe de dépendances pour afficher le graphe d'héritage souhaité.
Graphe de couplage
Vous pourriez avoir besoin de savoir exactement quels éléments de code sont impliqués dans une dépendance particulière, surtout lorsque vous devez anticiper l'impact d'un changement structurel. Dans la capture d'écran ci-dessous, le panneau Info de CppDepend décrit un couplage entre 2 projets.
En pointant sur une cellule de la matrice de dépendances, il vous indique que X types d'un projet A utilisent Y types d'un projet B. Notez que vous pouvez changer l'option Weight on Cell en # methods, # members ou # namespaces si vous devez mesurer le couplage en termes autres que les types.
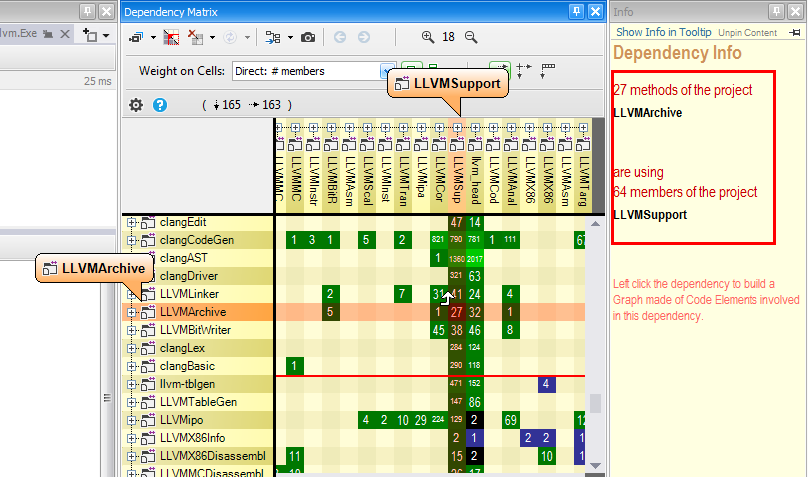
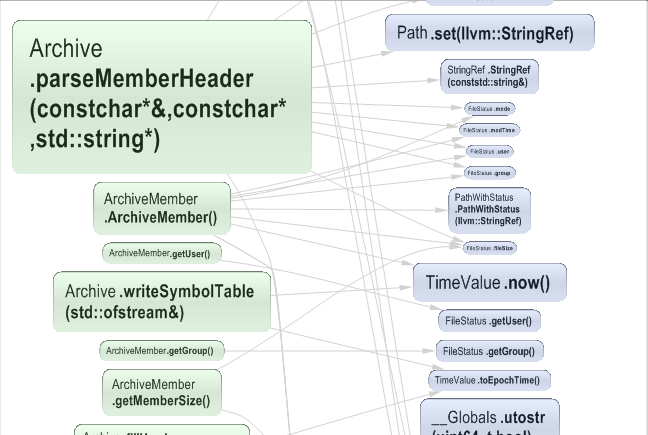
Un simple clic gauche sur la cellule de la matrice affiche le graphe de couplage ci-dessous.
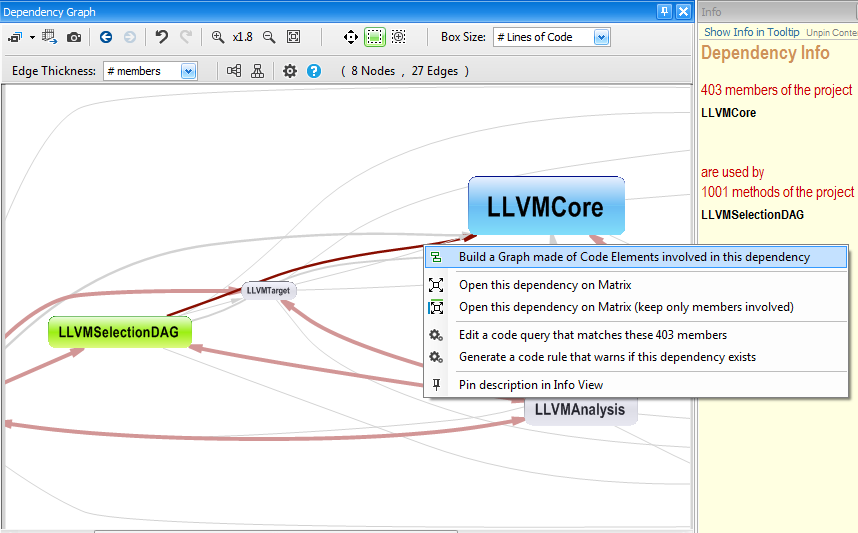
Un graphe de couplage peut aussi être généré à partir d'une arête du graphe de dépendances. Ici, vous pouvez ajuster l'option Edge Thickness sur autre chose que # type.
Graphe de chemin
Si vous voulez étudier un chemin ou un cycle de dépendances entre deux éléments de code, la première chose à faire est d'afficher la matrice de dépendances avec l'option Weight on Cells : profondeur d'utilisation directe et indirecte.
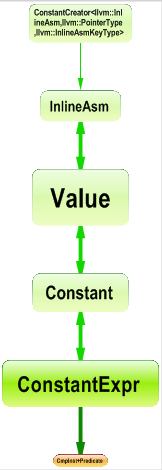
Les cellules bleues et vertes de la matrice représenteront des chemins, tandis que les cellules noires représenteront des cycles de dépendances. Par exemple, ici le panneau Info nous indique qu'il existe un chemin de longueur minimale 7 entre les 2 types concernés.
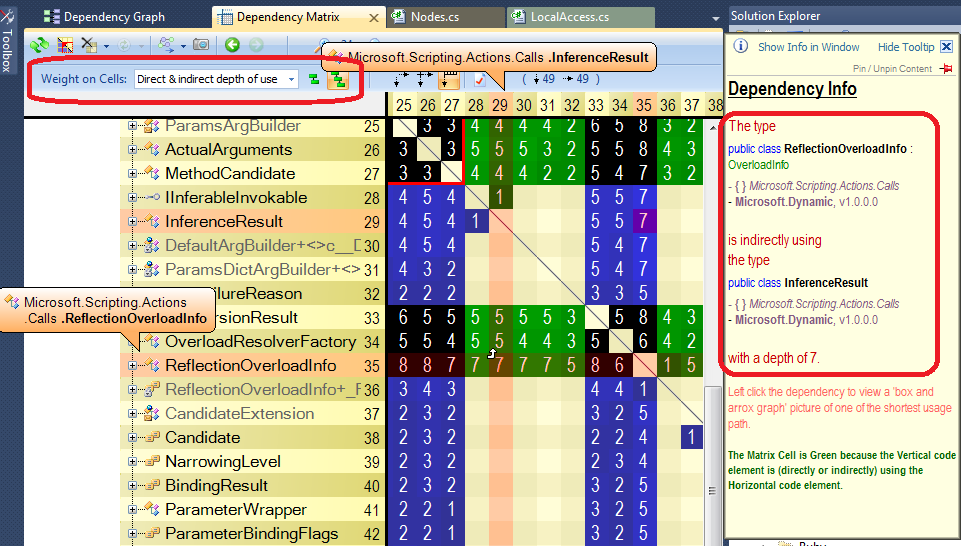
Un simple clic gauche sur la cellule affiche le graphe de chemin ci-dessous.
Graphe de tous les chemins
Dans certaines situations, vous aurez besoin de connaître tous les chemins d'un élément de code A vers un élément de code B. Par exemple, ici le panneau Info nous indique qu'il existe un chemin de longueur minimale 2 entre les 2 types concernés.
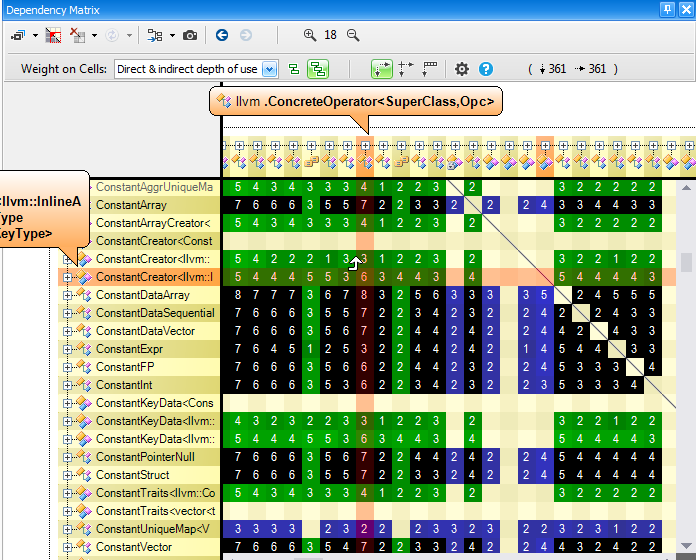
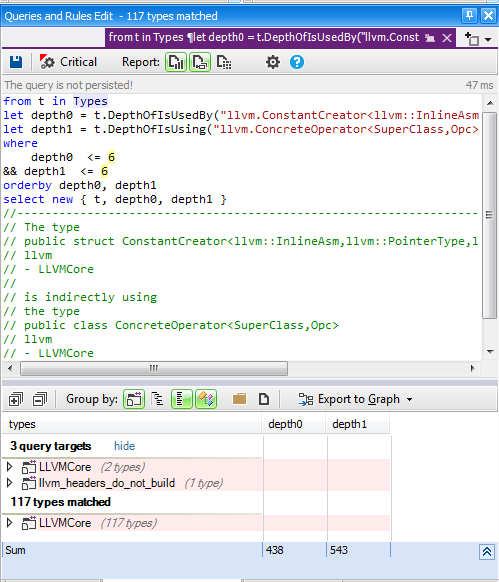
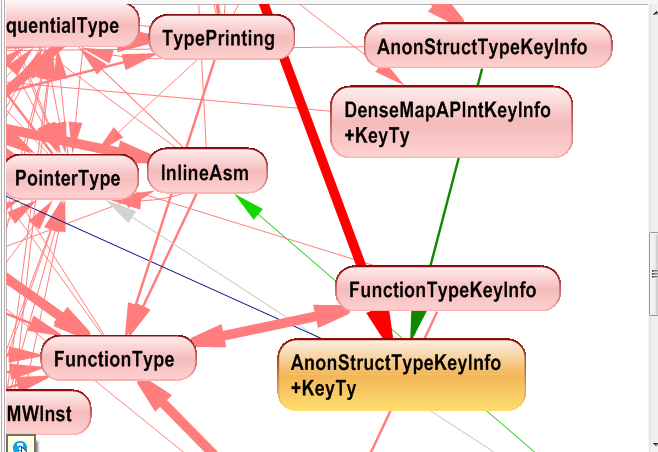
Enfin, exporter les 12 types correspondant à la requête CQLinq vers le graphe montre tous les chemins de A vers B.
Graphe de cycle
Comme nous l'avons expliqué dans la section précédente, pour traiter les graphes de cycles de dépendances, la première chose à faire est d'afficher la matrice de dépendances avec l'option Weight on Cells : profondeur d'utilisation directe et indirecte. Les cellules noires représentent alors les cycles.
Par exemple, ici le panneau Info nous indique qu'il existe un cycle de dépendances de longueur minimale 5 entre les 2 types concernés.
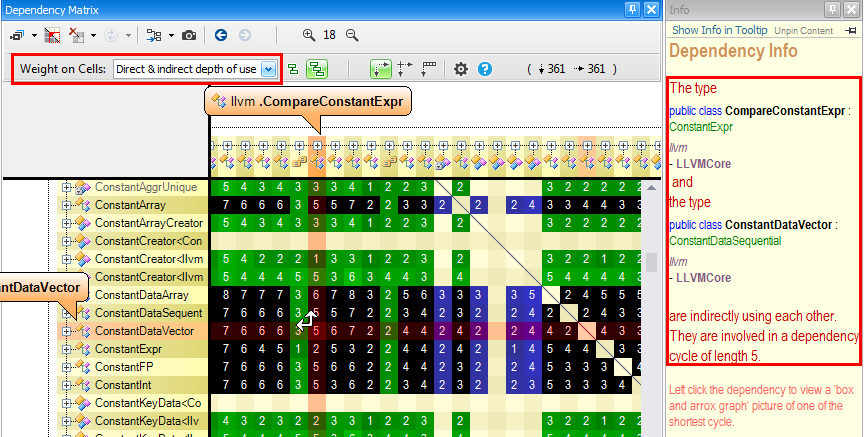
Un simple clic gauche sur la cellule affiche le graphe de cycle ci-dessous.
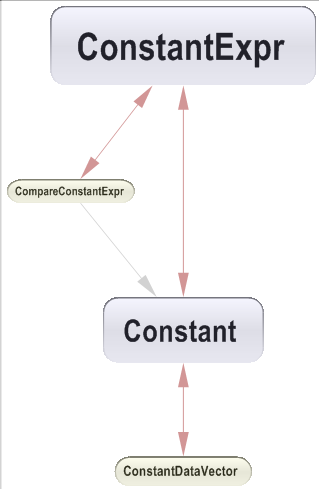
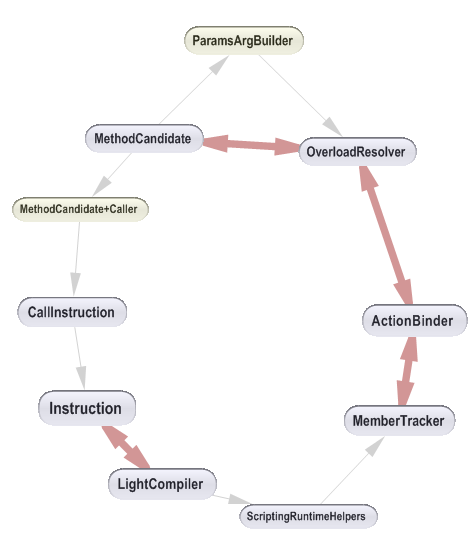
Notez qu'obtenir un cycle de dépendances propre et « arrondi » comme celui montré ci-dessus est l'exception plutôt que la règle.
Souvent, mettre en évidence un cycle produira un graphe non « arrondi » comme celui montré ci-dessous. Dans cet exemple, la longueur minimale d'un cycle entre les 2 types concernés (en jaune) est de 12. Comptez le nombre d'arêtes traversées d'un type jaune à l'autre, et vous obtiendrez 12. Vous verrez que certaines arêtes sont comptées plus d'une fois.
III - La matrice de structure des dépendances
Un grand graphe visualisé avec la matrice de structure des dépendances
Ici, nous tenons à souligner le fait que lorsque le graphe de dépendances devient illisible, il vaut la peine de passer à la matrice de dépendances. Le graphe de dépendances et la matrice de dépendances coexistent parce que :
- Le graphe de dépendances est intuitif mais devient illisible dès qu'il y a trop d'arêtes entre les nœuds.
- La matrice de dépendances demande du temps pour être comprise, mais une fois maîtrisée, vous verrez qu'elle est bien plus efficace que le graphe de dépendances pour explorer une architecture existante. Plus d'informations sur la lisibilité de la matrice de dépendances sont disponibles dans Identifier les motifs de structure du code en un coup d'œil
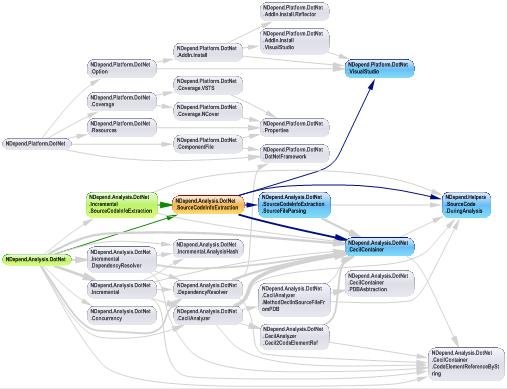
Pour illustrer le propos, voici ci-dessous les mêmes dépendances entre 77 espaces de noms, montrées à travers un graphe de dépendances et une matrice de dépendances.
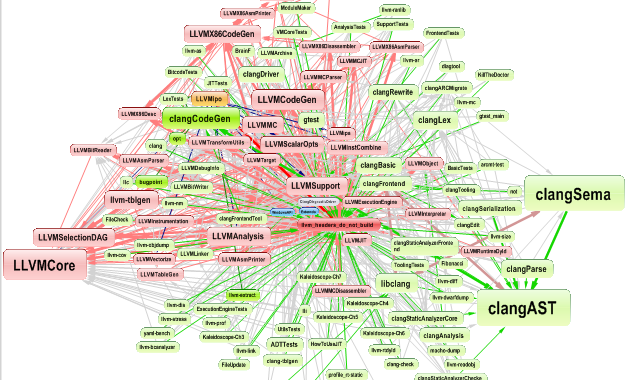
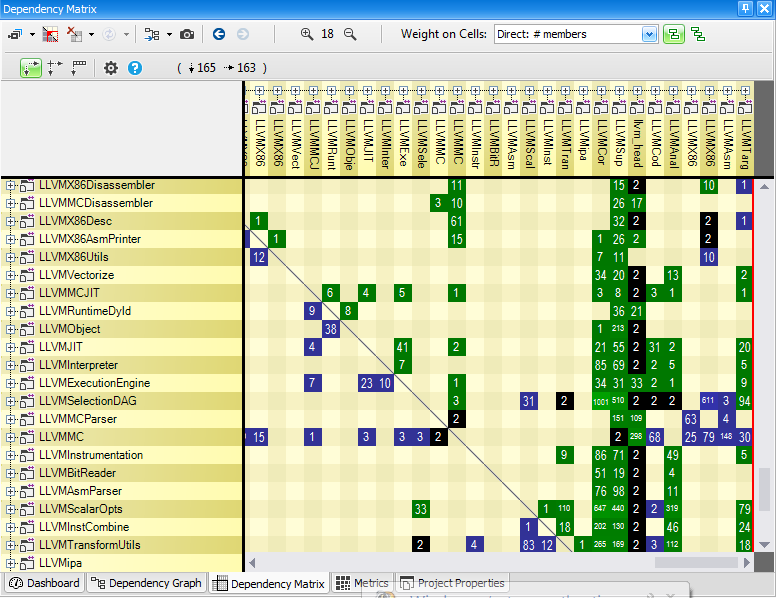
La DSM (Dependency Structure Matrix) est une façon compacte de représenter et de parcourir les dépendances entre composants. Pour la plupart des ingénieurs, parler de dépendances, c'est parler de quelque chose qui ressemble à ceci :
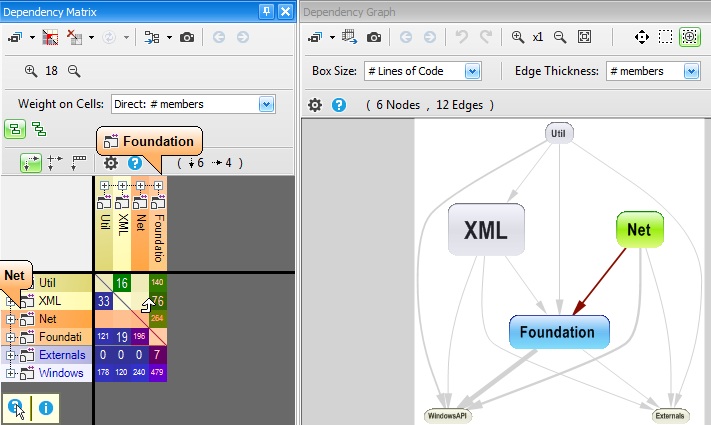
La DSM est utilisée pour représenter la même information qu'un graphe.
- Les éléments d'en-tête de la matrice représentent les boîtes du graphe.
- Les cellules non vides de la matrice correspondent aux flèches du graphe.
Par conséquent, dans la capture ci-dessous, le couplage de Net vers Foundation est représenté par une cellule non vide dans la matrice et par une flèche dans le graphe.
Pourquoi utiliser deux façons différentes — graphe et DSM — de représenter la même information ? Parce qu'il y a un compromis :
- Un graphe est plus intuitif mais peut devenir totalement incompréhensible lorsque le nombre de nœuds et d'arêtes augmente (quelques dizaines de boîtes peuvent suffire à produire un graphe trop complexe).
- La DSM est moins intuitive mais peut être très efficace pour représenter des graphes grands et complexes. On dit que la DSM passe mieux à l'échelle que les graphes.
Une fois les principes de la DSM compris, on préfère généralement la DSM aux graphes pour représenter les dépendances. C'est principalement parce que la DSM permet de repérer les motifs structurels en un coup d'œil. C'est ce qu'explique la seconde moitié de ce document.
CppDepend offre une aide contextuelle pour expliquer à l'utilisateur ce qu'il voit sur la DSM. La DSM de CppDepend repose sur un schéma simple de 3 couleurs pour les cellules : bleu, vert et noir. Lorsqu'on survole une ligne ou une colonne avec la souris, l'aide contextuelle explique la signification de ce code couleur :
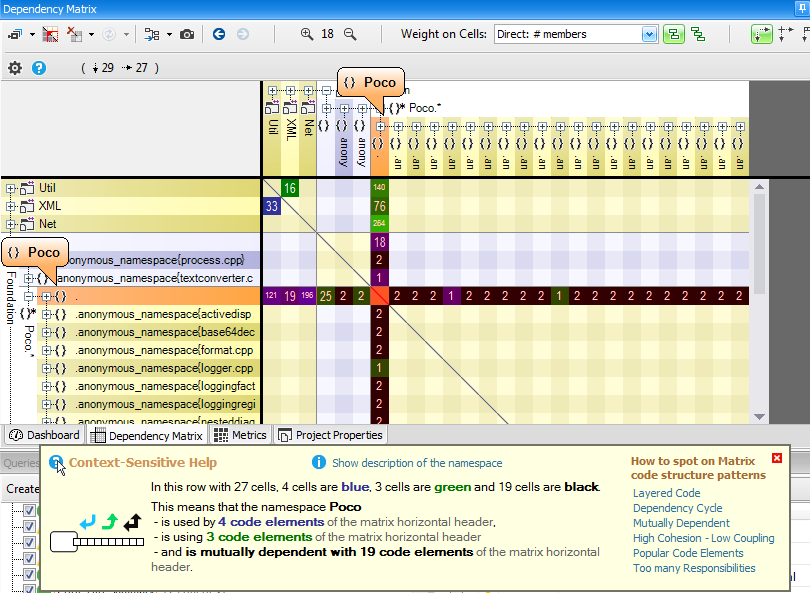
Une cellule DSM non vide contient un nombre. Ce nombre représente la force du couplage représenté par la cellule. La force du couplage peut être exprimée en nombre de membres/méthodes/champs/types ou espaces de noms impliqués dans le couplage, selon la valeur actuelle de l'option Weight on Cells. En plus de l'aide contextuelle, la DSM offre aussi un panneau Info qui explique le couplage avec une description en langage clair :
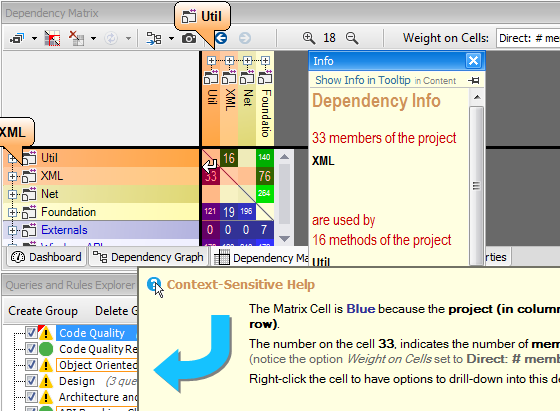
La DSM de CppDepend propose de nombreuses options à essayer :
- Elle offre de nombreuses facilités pour creuser dans l'exploration des dépendances (une colonne/ligne parente peut être ouverte, les cellules peuvent être étendues…).
- Elle peut gérer des DSM carrées symétriques et des DSM rectangulaires non symétriques.
- Les en-têtes horizontaux et verticaux peuvent être liés pour toujours avoir une matrice carrée symétrique.
- Elle est fournie avec l'option Indirect usage, où les cellules montrent l'utilisation directe et indirecte.
- L'en-tête vertical peut contenir des éléments de code de premier niveau.
- ...
Il est recommandé d'essayer toutes ces fonctionnalités vous-même, en analysant les dépendances de votre base de code. Identifier les motifs de structure du code sur une matrice
Comme expliqué dans l'introduction, la DSM a la particularité d'offrir une identification facile des motifs de structure de code courants. Présentons les scénarios les plus fréquents : Code en couches Un motif rendu évident par une DSM est une structure en couches (c'est-à-dire une structure acyclique). Lorsque la matrice est triangulaire, avec toutes les cellules bleues dans le triangle inférieur gauche et toutes les cellules vertes dans le triangle supérieur droit, cela montre que la structure est parfaitement en couches. Autrement dit, la structure ne contient aucun cycle de dépendances.
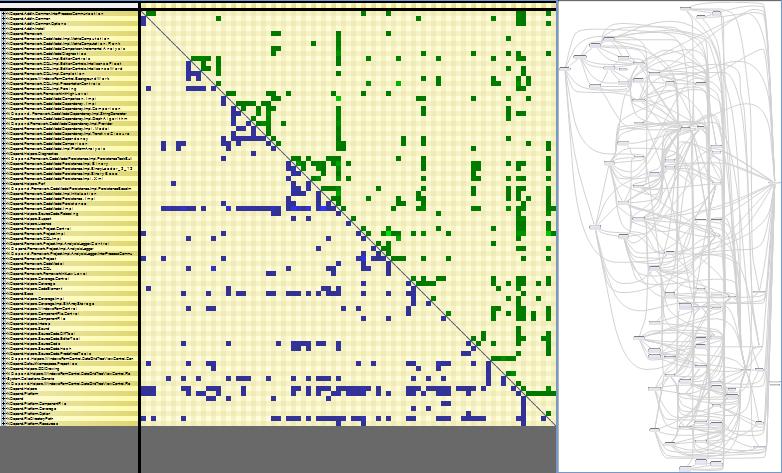
Sur la partie droite de la capture, la même structure en couches est représentée avec un graphe. Toutes les flèches ont la même direction de gauche à droite. Le problème des graphes, c'est que leur disposition ne passe pas à l'échelle. Ici, on voit à peine la vue d'ensemble de la structure. Si le nombre de boîtes était multiplié par 2, le graphe serait complètement illisible. En revanche, la représentation DSM ne serait pas affectée ; on dit que la DSM passe mieux à l'échelle que les graphes.
Remarque : fait intéressant, la plupart des algorithmes de disposition de graphes reposent sur le fait qu'un graphe est acyclique. Pour calculer la disposition d'un graphe avec des cycles, ces algorithmes écartent temporairement certaines dépendances pour travailler sur un graphe en couches, puis rajoutent les dépendances écartées à la dernière étape du calcul. Cycle de dépendances Si une structure contient un cycle, celui-ci est affiché par un carré rouge sur la DSM. On peut voir qu'à l'intérieur du carré rouge, des cellules vertes et bleues sont mélangées de part et d'autre de la diagonale. Il y a aussi des cellules noires qui représentent une utilisation directe mutuelle (c'est-à-dire A utilise B et B utilise A).
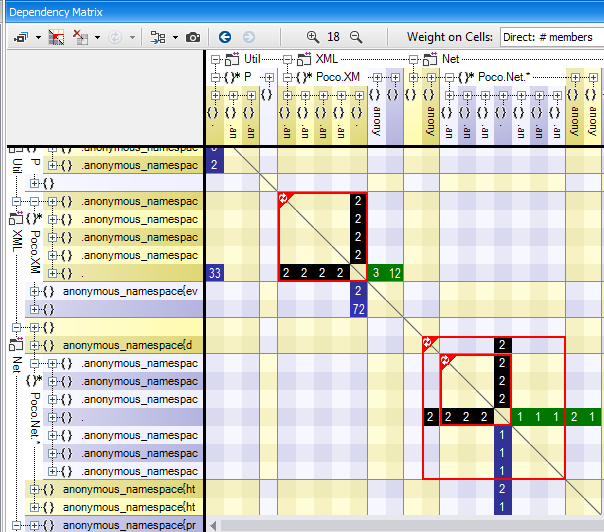
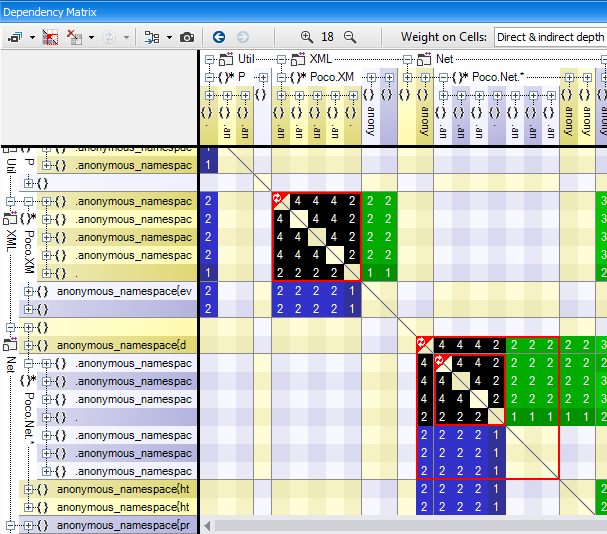
La DSM de CppDepend est fournie avec l'unique option Indirect Dependency. Une dépendance indirecte entre A et B signifie que A utilise quelque chose, qui utilise quelque chose, qui utilise quelque chose… qui utilise B. Ci-dessous, la même DSM avec un cycle est montrée en mode indirect. On peut voir que le carré rouge est rempli uniquement de cellules noires. Cela signifie simplement que pour tous les éléments A et B du cycle, A et B sont indirectement et mutuellement dépendants.
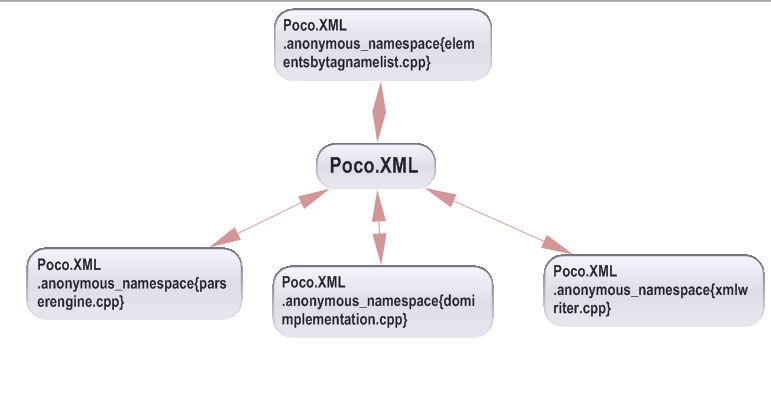
Voici la même structure représentée avec un graphe. La flèche rouge montre que plusieurs éléments sont mutuellement dépendants. Mais le graphe n'aide en rien à mettre en évidence tous les éléments impliqués dans le cycle parent.
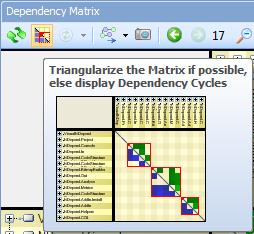
Notez que dans CppDepend, nous fournissons un bouton pour mettre en évidence les cycles dans la DSM (le cas échéant). Si la structure est en couches, ce bouton triangularise la matrice et maintient les cellules non vides aussi près que possible de la diagonale.
Forte cohésion – Faible couplage
L'idée d'une forte cohésion (au sein d'un composant) / d'un faible couplage (entre composants) est populaire de nos jours. Mais si vous ne pouvez pas mesurer et visualiser les dépendances, il est difficile d'obtenir une évaluation concrète de la cohésion et du couplage. La DSM est douée pour montrer la forte cohésion. Dans la DSM ci-dessous, un agrégat carré évident autour de la diagonale est affiché. Cela signifie que les éléments impliqués dans le carré ont une forte cohésion : ils sont fortement dépendants les uns des autres. De plus, on peut voir qu'ils sont en couches puisqu'il n'y a pas de cycle. Ce sont certainement des candidats pour être regroupés dans un artefact parent (comme un espace de noms ou une assembly).
En revanche, le fait que la plupart des cellules autour du carré soient vides indique un faible couplage entre les éléments du carré et les autres éléments.
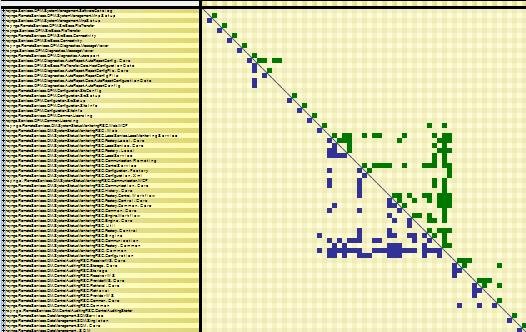
Dans la DSM ci-dessous, on peut voir 2 composants à forte cohésion (carrés supérieur et inférieur) et un couplage assez faible entre eux.
Lors d'une refactorisation, avoir un tel indicateur peut être très utile pour savoir s'il y a des opportunités de scinder des composants grossiers en plusieurs composants plus fins.
Trop de responsabilités
Le principe de responsabilité unique (SRP) gagne en popularité dans la communauté des architectes logiciels. Le principe stipule qu'une classe ne devrait pas avoir plus d'une raison de changer. Une autre façon d'interpréter le SRP est qu'une classe ne devrait pas utiliser trop d'autres types différents. Si l'on étend l'idée à d'autres niveaux (assemblys, espaces de noms et méthodes), alors certainement, si un élément de code utilise des dizaines d'autres éléments de code différents (au même niveau), il a trop de responsabilités. Le terme classe God ou composant God est souvent utilisé pour décrire un tel morceau de code.
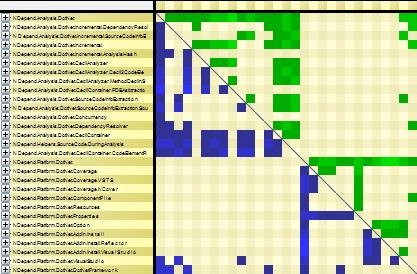
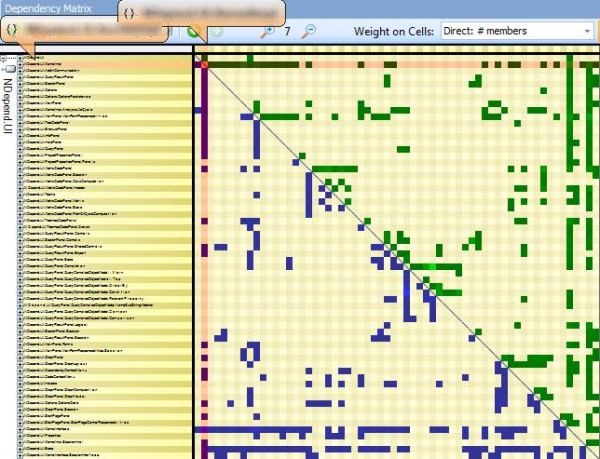
La DSM peut aider à repérer les éléments de code ayant trop de responsabilités. Un tel élément de code est représenté par des colonnes avec beaucoup de cellules bleues et des lignes avec beaucoup de cellules vertes. La DSM ci-dessous expose ce phénomène.
Éléments de code populaires
Un élément de code populaire est utilisé par de nombreux autres éléments de code. Les éléments de code populaires sont inévitables (pensez à la classe String par exemple), mais un élément de code populaire n'est pas un défaut. Cela signifie simplement que dans chaque base de code, il y a des concepts centraux représentés par des classes populaires.
Un élément de code populaire est représenté par des colonnes avec beaucoup de cellules vertes et des lignes avec beaucoup de cellules bleues. La DSM ci-dessous met en évidence un élément de code populaire.
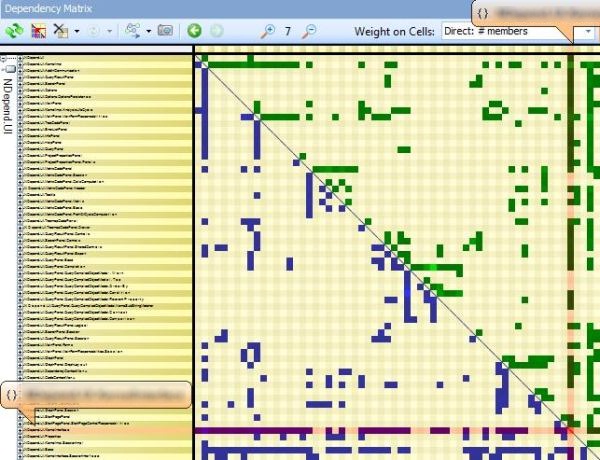
Une chose à noter est que lorsque vous gardez votre structure de code parfaitement en couches, les composants populaires sont naturellement maintenus à un niveau bas. En effet, un composant populaire ne peut pas, de fait, utiliser beaucoup de choses : comme les composants populaires sont de bas niveau, ils ne peuvent pas utiliser quelque chose de plus haut niveau. Cela créerait une dépendance du bas niveau vers le haut niveau, ce qui briserait la propriété acyclique de la structure.
Mutuellement dépendants
Vous pouvez voir le couplage entre 2 composants en faisant un clic droit sur une cellule non vide et en sélectionnant le menu Open this dependency.
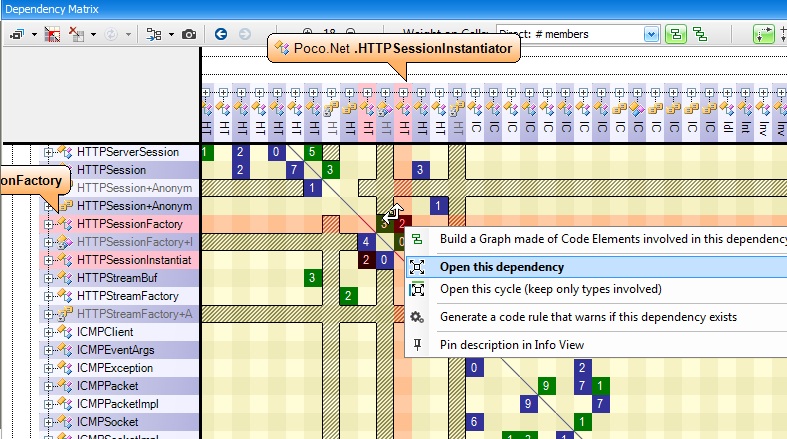
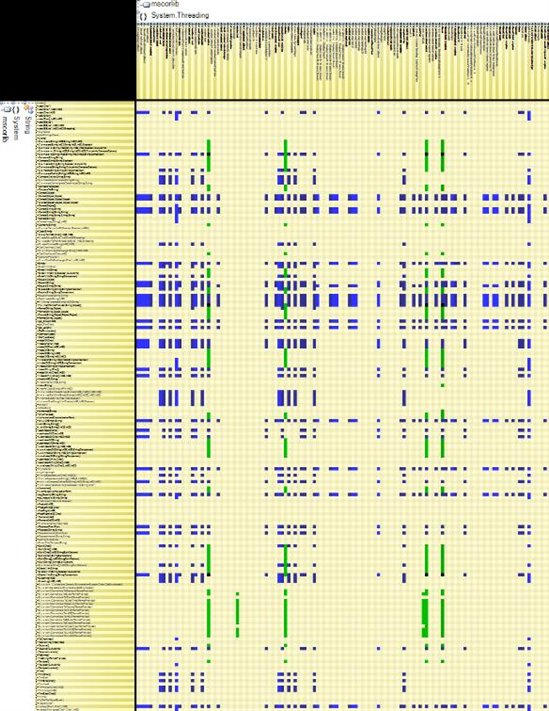
Si la cellule ouverte est noire, comme dans la capture ci-dessus (c'est-à-dire si A et B sont mutuellement dépendants), alors la matrice rectangulaire résultante contiendra à la fois des cellules vertes et bleues (et éventuellement aussi des cellules noires), comme dans la capture ci-dessous.
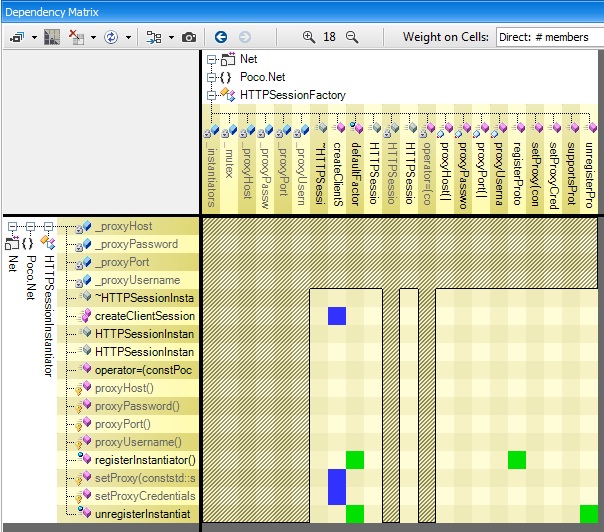
Dans cette situation, vous remarquerez souvent un déficit de cellules vertes ou bleues (3 cellules bleues pour 1 cellule verte ici). C'est parce que même si 2 éléments de code sont mutuellement dépendants, il existe souvent un ordre de niveau naturel entre eux. Par exemple, considérons l'espace de noms System.Threading et la classe System.String. Ils sont mutuellement dépendants ; ils reposent l'un sur l'autre. Mais la matrice montre que Threading est beaucoup plus dépendant de String que l'inverse (il y a beaucoup plus de cellules bleues que de cellules vertes). Cela confirme l'intuition que Threading est à un niveau plus élevé que String.