「百聞は一見に如かず」という英語の慣用句があります。これは、複雑な考えが1枚の静止画像だけで伝えられること、あるいは対象の画像が説明文よりもその意味や本質を効果的に伝えることを指します。
この慣用句はソフトウェアプログラミングにも当てはまります。実際、小規模なプロジェクトであれば、ソースコードを調べることで容易に理解できます。しかし、大規模プロジェクトはすぐに複雑になり、理解が難しくなります。このような場合には、グラフや図を使ってソースコードを可視化し、開発者が理解しやすくする方が効果的です。
ここでは、コードベースを理解するために CppDepend が提供する便利な図をいくつか見ていきましょう。
I. ツリーマップ図
ツリーマッピングは、入れ子になった長方形を使ってツリー構造のデータを表示する方法です。CppDependのツリーマップで使用されるツリー構造は、通常のコード階層です:
- C/C++プロジェクトには名前空間が含まれる。
- 名前空間には型が含まれる。
- 型にはメソッドとフィールドが含まれる。
ツリーマップでは、長方形がコード要素を表します。レベルオプションは、各単位長方形が表すコード要素の種類を決定します。レベルオプションには、project、namespace、type、method、fieldの5つの値を指定できます。以下の2つのスクリーンショットは、同じコードベースを、左側では型レベル、右側では名前空間レベルで表したものです。
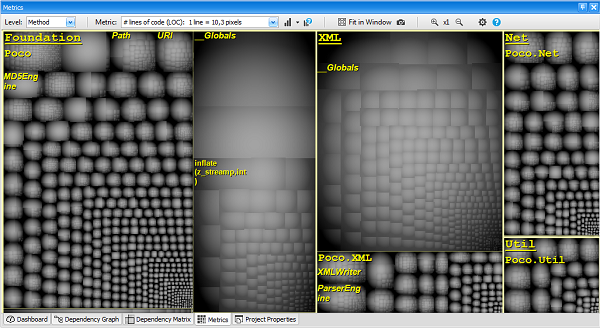
ツリーマップのコードメトリクスオプションは、長方形のサイズを決定します。たとえば、レベルが 型 に設定され、メトリクスが コード行数に設定されている場合、各単位長方形は1つの型を表し、単位長方形のサイズは対応する型のコード行数に比例します。
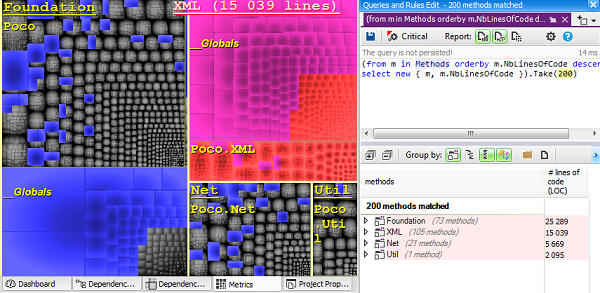
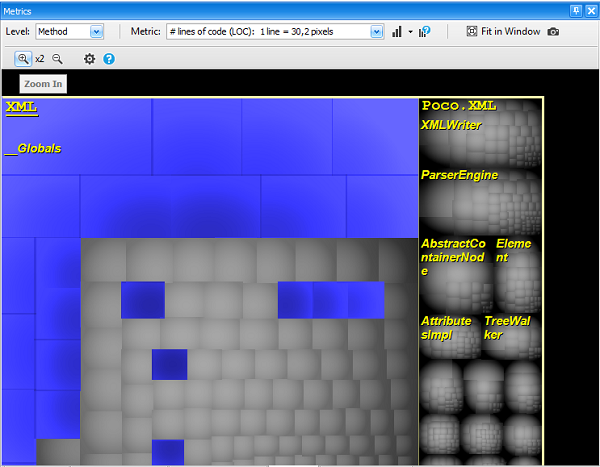
CQLinqクエリが現在編集中の場合、そのクエリに一致したコード要素の集合は、ツリーマップ上に青い長方形の集合として表示されます。下のスクリーンショットでは、CQLinqクエリが最も大きい200個のメソッドに一致しています。ここではツリーマップのレベルが メソッド に設定され、メトリクスが コード行数です。予想どおり、青い長方形がツリーマップ内で最も大きい200個の単位長方形を表していることが分かります。
下のスクリーンショットは、現在選択されているコード要素(ここではプロジェクト XML)がツリーマップ上に赤い長方形として表示されることも示しています。
一般的なシナリオ
メトリクスとレベルの値を適切に組み合わせることで、Metric Viewでは他の方法では見つけにくいパターンを確認できます。大きすぎる、複雑すぎるコード CppDependには、過度に大きく、過度に複雑なコードを見つけるための多くのコードメトリクスが用意されています。パラメータ、変数、コード行数が多すぎるメソッドや、循環的複雑度が過度に高いメソッドは避けるべきです。コード行数が多すぎる型についても同様です。
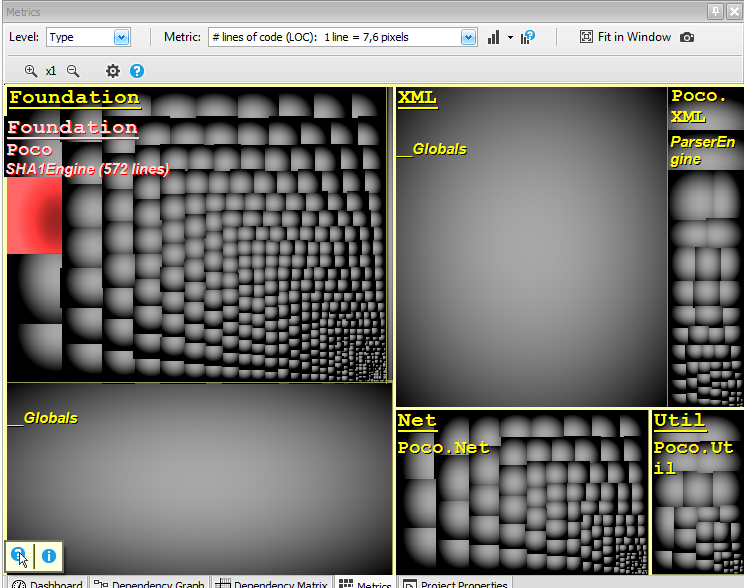
下のスクリーンショットでは、ツリーマップのレベルが 型 に設定され、メトリクスが コード行数に設定されています。大きな長方形は、コードベース内の大きな型を表します。長方形にマウスを重ねると、その型のメトリクス値、ここでは型のコード行数が表示されます。コードのツリーマッピングは、過度に大きく複雑なコード要素を見つけるのに役立つだけでなく、それぞれのサイズと複雑さを比較するのにも役立つことが明らかです。
欠陥の局在化
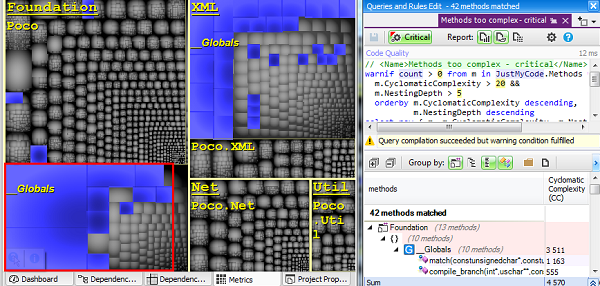
下のスクリーンショットでは、CQLinqクエリを使用して、パラメータと変数が多すぎるメソッドを検索しています。青い長方形は、ツリーマップ上で一致したメソッドを示しています。ここで興味深いのは、一致したメソッドの一部がグループ化されているように見える点です。ツリーマップは階層ビューであるため、コード要素の集合がグループ化されている場合、それらのコード要素が同じ親に属していることを意味します。実際、ここでグループ化されている12個のメソッドは同じ型に属しています。
ツリーマッピングがなければ、これら12個のメソッドの親型を特定するのは困難だったでしょう。これでコード品質レビュー担当者は、コードベースの他の部分よりも多くの欠陥を含んでいるように見えるこの領域に集中できます。
トップダウンのコード探索
CppDependのツリーマップメトリクスビューは、ズームインとズームアウトをサポートしています。これにより、特定のプロジェクト、名前空間、クラスへ簡単にズームインできます。コード行数の観点からコンポーネントの量を探索・比較する場合に特に便利です。
生産性をコード行数で測定すべきではありません。しかし、組織のコンテキストを考慮した場合、コード行数のカウントはソフトウェアを正確に見積もるための有用なメトリクスであることが実証されています。コードベースの機能は、アセンブリ、名前空間、型へと整理されています。ツリーマッピングでは、これらの成果物が並んで配置された長方形になります。長方形の面積、つまり機能の重みを視覚的に比較できます。ツリーマッピングを通じてコードサイズを定期的に探索できることは、機能の重みとコストを正確に把握するための独自の方法です。
よく知っているコードベースのツリーマップを可視化してみてください。予期していなかった機能のサイズを発見して驚くはずです。
コード構造の観察
量(コード行数、メソッドのパラメータ数など)や複雑さ以外のメトリクスでMetric Viewを使用すると、興味深い観察結果が得られる場合があります。
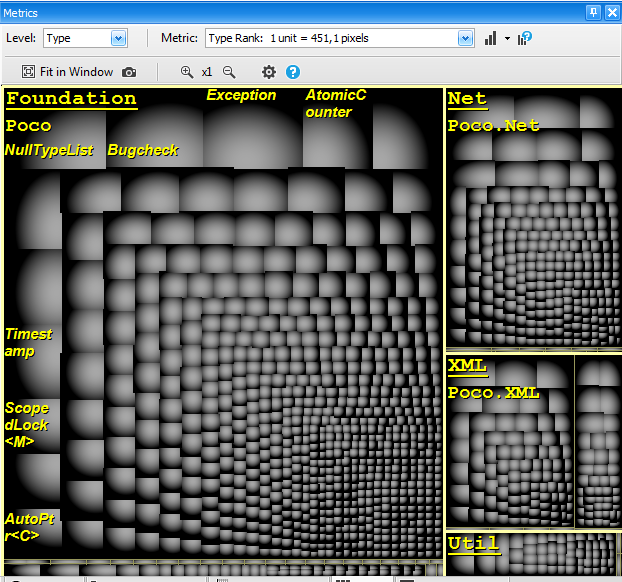
The ランキングメトリクス は、コードベース内での型またはメソッドの人気度を測定するコードメトリクスです。ランキングメトリクスでツリーマッピングを使用すると、人気のある型がどこで宣言されているかを明確に把握できます。これにより、コードベースで重要なものがすぐに分かります。
下のスクリーンショットは、 Microsoft DLR(Dynamic Language Runtime) コードベースの型をランキングメトリクスでツリーマップ化したものです。ツリーマップは、 CallSite と Expression がDLRの人気のある概念であることを示しており、実際にそのとおりです。
同様の興味深いコード構造の観察は、次のようなコードメトリクスでも行えます: 求心性/遠心性結合 または レベル。
II. 依存関係グラフ
CppDependは、依存関係グラフを使用して既存のコードアーキテクチャを探索できる、幅広い機能を提供しています。最も一般的なコード探索シナリオは次のとおりです。呼び出しグラフ
CppDependは、2段階のプロセスで必要な任意の呼び出しグラフを生成できます。
- 最初に、型、フィールド、メソッド、名前空間、プロジェクトの直接および間接の呼び出し元/呼び出し先を要求します。これにより、要求されたすべての呼び出し元または呼び出し先に一致する次のCQLinqクエリが生成されます。
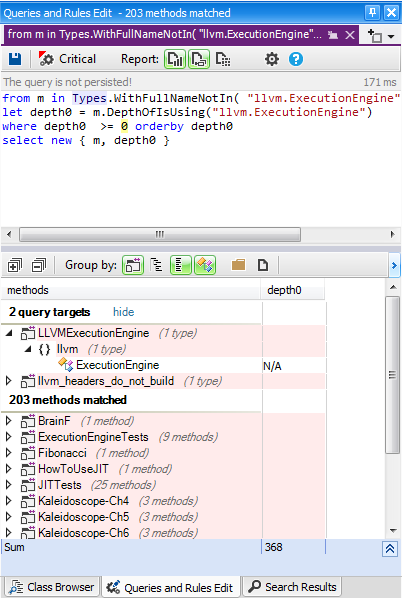
- CQLinqクエリ結果では、メトリクス DepthOfIsUsing/DepthOfIsUsedBy が使用の深さを示している点に注意してください(1は直接、2は直接使用している要素経由などを意味します)。CQLinqクエリは、使用の深さに特定の条件を付けて、間接的な呼び出し元/呼び出し先だけに一致するよう簡単に変更できます。また、要求される呼び出し元/呼び出し先は、対象となるコード要素と同じ種類である必要はありません。たとえばここでは、ある型を直接または間接的に使用するメソッドを要求しています。
- 次に、CQLinqクエリがユーザーが求める呼び出し元/呼び出し先の集合に一致したら、一致した結果の集合を依存関係グラフへエクスポートできます。これにより、目的の呼び出しグラフが表示されます。
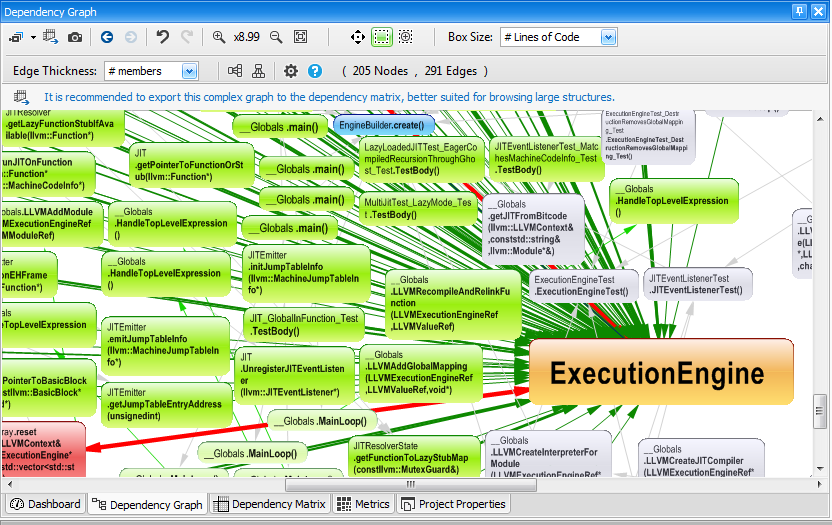
クラス継承グラフ
クラス継承グラフを表示するには、前のセクション(呼び出しグラフの生成)で示したのと同じ2段階の手順を適用する必要があります。
- 最初に、特定のクラスを継承するクラス(または特定のインターフェースを実装するクラス)の集合を要求するCQLinqクエリを生成します。ここでは、次のCQLinqクエリが生成されます:
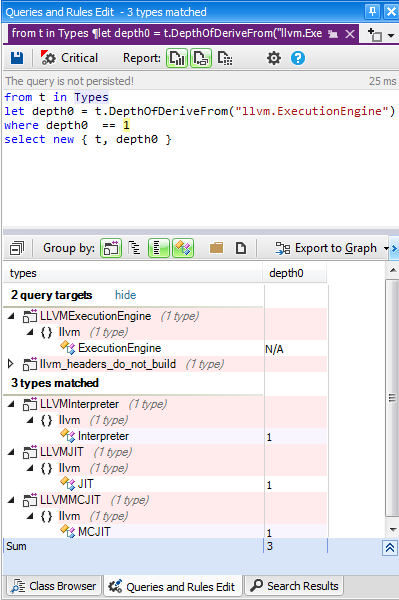
- 次に、CQLinqクエリの結果を依存関係グラフへエクスポートして、目的の継承グラフを表示します。
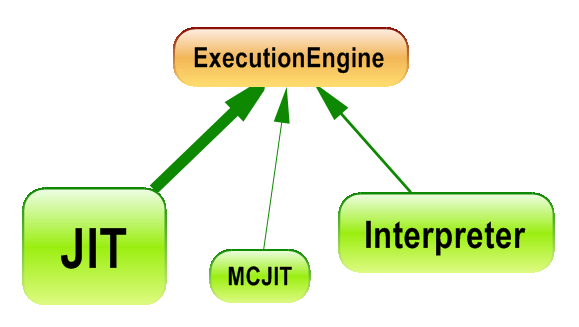
結合グラフ
特に構造変更の影響を予測する必要がある場合には、特定の依存関係にどのコード要素が関係しているのかを正確に知る必要があるかもしれません。下のスクリーンショットでは、CppDependの情報パネルが2つのプロジェクト間の結合を示しています。
依存関係マトリクスのセルをポイントすると、プロジェクトAのX個の型がプロジェクトBのY個の型を使用していることが示されます。なお、型以外の観点で結合を測定する必要がある場合には、 Weight on Cell オプションを # methods、 # members または # namespaces に変更できます。
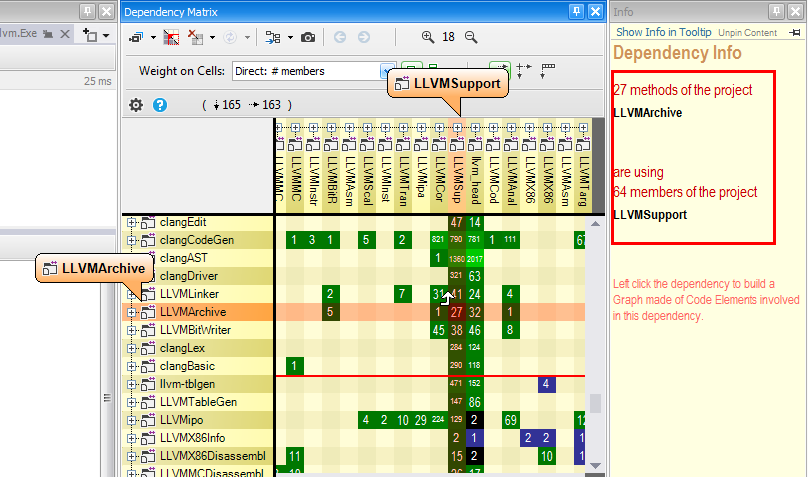
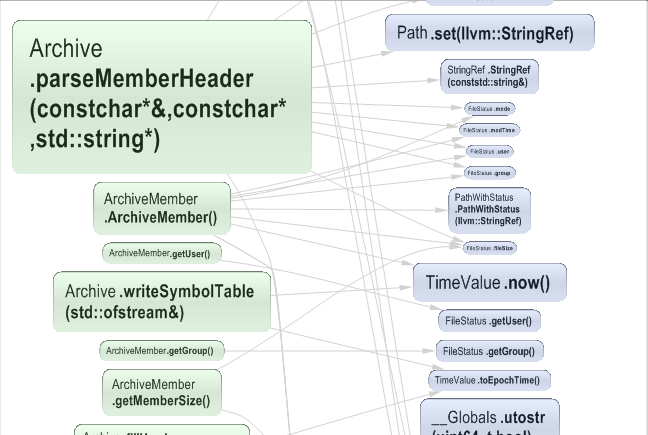
マトリクスセルを左クリックするだけで、下の結合グラフが表示されます。
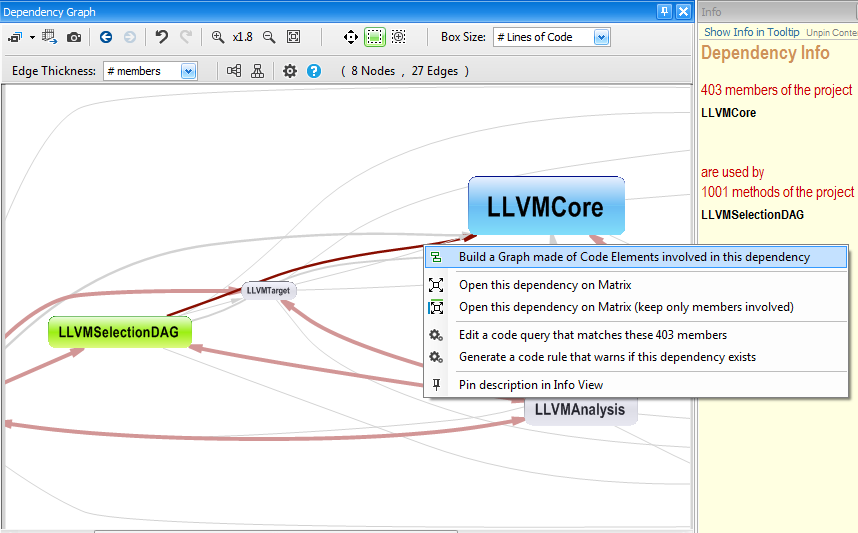
結合グラフは、依存関係グラフのエッジからも生成できます。ここでは、 Edge Thickness オプションを # type。
パスグラフ
2つのコード要素間のパスまたは依存関係サイクルを調査したい場合、最初に行うべきことは、次のオプションで依存関係マトリクスを表示することです: Weight on Cells: Direct & indirect depth of use.
青と緑のマトリクスセルは パスを表し、黒いセルは 依存関係サイクルを表します。たとえばここでは、情報パネルが、関係する2つの型の間に最小長7のパスがあることを示しています。
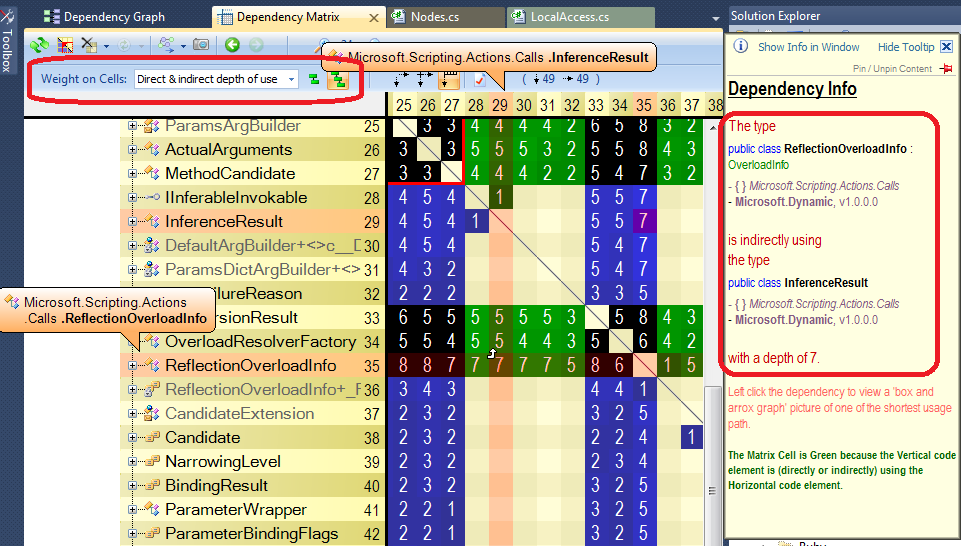
セルを左クリックするだけで、下のパスグラフが表示されます。
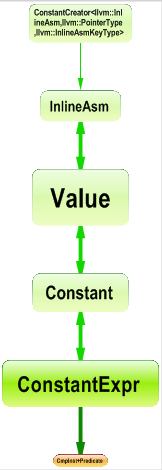
全パスグラフ
状況によっては、コード要素Aからコード要素Bへのすべてのパスを知る必要があります。たとえばここでは、情報パネルが、関係する2つの型の間に最小長2のパスがあることを示しています。
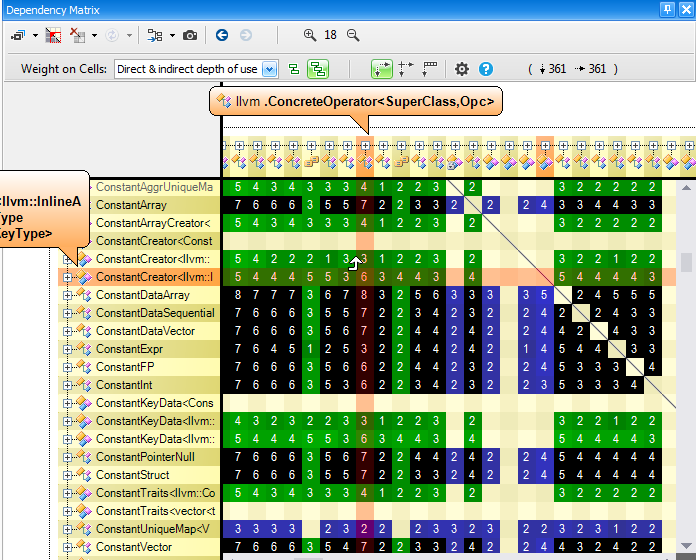
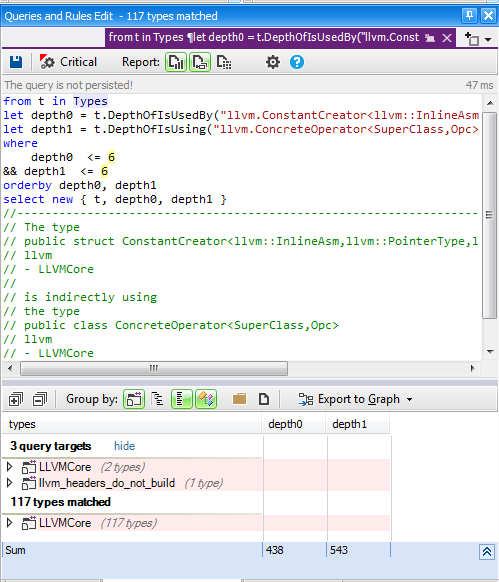
最後に、CQLinqクエリに一致した12個の型をグラフへエクスポートすると、AからBへのすべてのパスが表示されます。
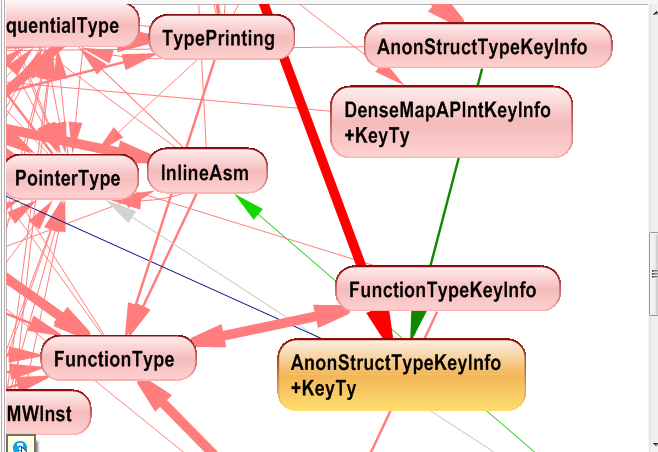
サイクルグラフ
前のセクションで説明したように、依存関係サイクルグラフを扱うには、まず次のオプションで依存関係マトリクスを表示します: Weight on Cells: Direct & indirect depth of use. その後、黒いセルがサイクルを表します。
たとえばここでは、情報パネルが、関係する2つの型の間に最小長5の依存関係サイクルがあることを示しています。
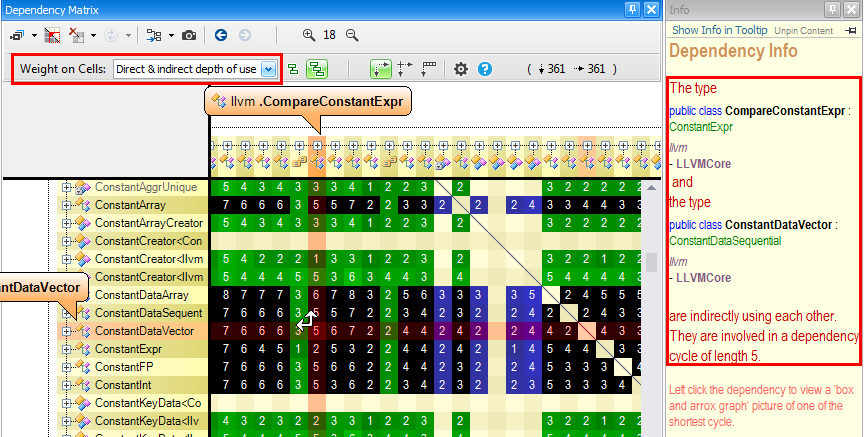
セルを左クリックするだけで、下のサイクルグラフが表示されます。
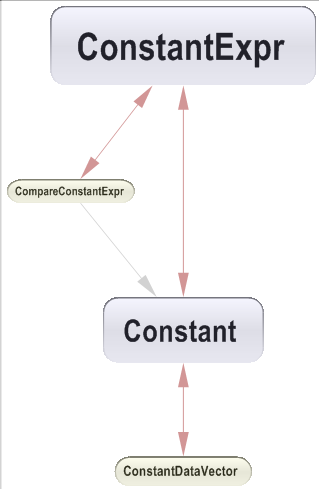
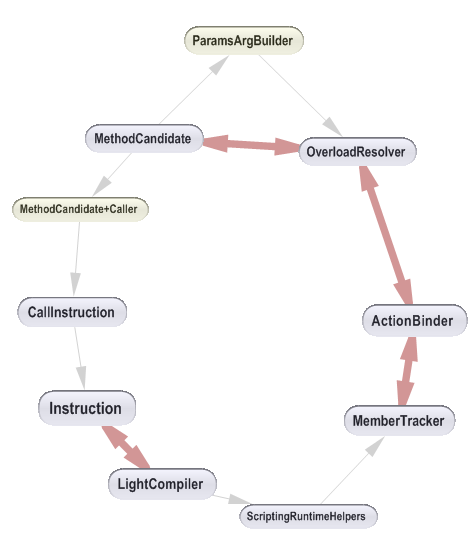
なお、上に示したようなクリーンで「円形の」依存関係サイクルが得られるのは、規則ではなく例外です。
多くの場合、サイクルを表示すると、下に示すような「円形ではない」グラフになります。この例では、関係する2つの型(黄色)間のサイクルの最小長は12です。一方の黄色の型からもう一方の黄色の型までに横切るエッジの数を数えると、12になります。一部のエッジが複数回カウントされていることが分かります。
III. 依存構造マトリクス
依存構造マトリクスで可視化された大規模グラフ
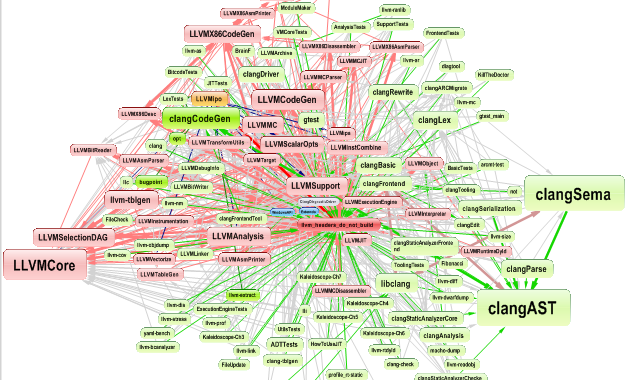
ここでは、依存関係グラフが読み取れなくなった場合には、依存関係マトリクスへの切り替えが有効だという点を強調したいと思います。依存関係グラフと依存関係マトリクスが共存しているのは、次の理由によります:
- 依存関係グラフは直感的ですが、ノード間のエッジが多くなりすぎるとすぐに読み取れなくなります。
- 依存関係マトリクスは理解に時間がかかりますが、一度習得すれば、既存のアーキテクチャを探索するうえで依存関係グラフよりもはるかに効率的であることが分かります。依存関係マトリクスの可読性に関する詳細は「 コード構造パターンを一目で識別する
」を参照してください。この点を説明するために、以下に77個の名前空間間の同じ依存関係を、依存関係グラフと依存関係マトリクスで示します。
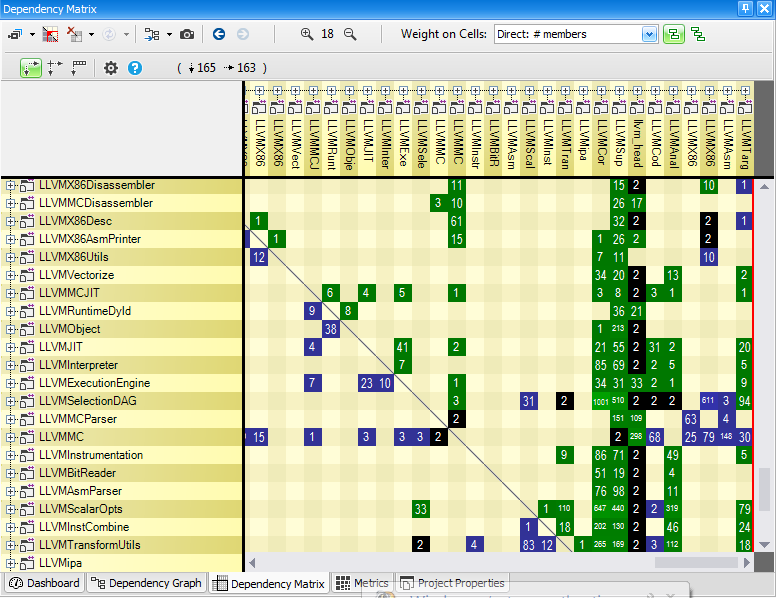
DSM(Dependency Structure Matrix)は、コンポーネント間の依存関係を表現し、それらを横断的に辿るためのコンパクトな方法です。ほとんどのエンジニアにとって、依存関係について語るとは、次のようなものについて語ることを意味します:
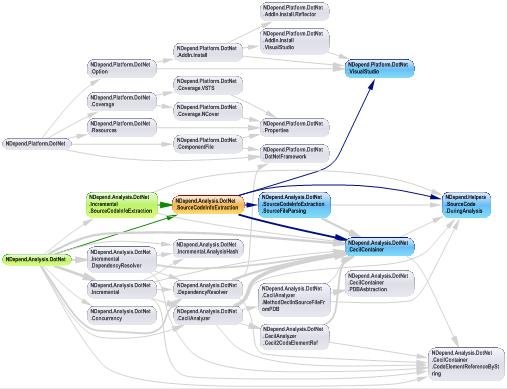
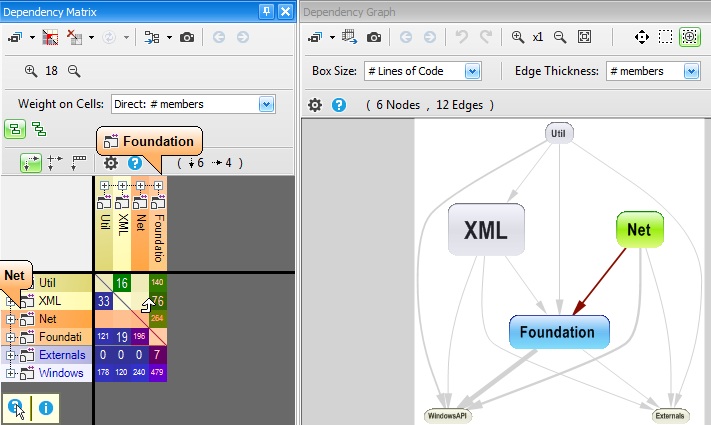
DSMは、グラフと同じ情報を表すために使用されます。
- マトリクスのヘッダー要素はグラフのボックスを表します。
- マトリクスの空でないセルはグラフの矢印に対応します。
その結果、下のスナップショットでは、 Net から Foundation への結合は、マトリクス内の空でないセルと、グラフ内の矢印で表されています。
なぜ、同じ情報を表すのにグラフとDSMという2つの異なる方法を使うのでしょうか。そこにはトレードオフがあるからです:
- グラフはより直感的ですが、ノードとエッジの数が増えると完全に理解不能になる可能性があります(数十個のボックスだけでも、過度に複雑なグラフになることがあります)。
- DSMは直感性に欠けますが、大規模で複雑なグラフを表現するうえでは非常に効率的です。DSMはグラフよりもスケールすると言われます。
DSMの原則を理解すると、依存関係を表現する際には、一般的にグラフよりもDSMを好むようになります。主な理由は、DSMを使うと構造パターンを一目で見つけられることです。これについては、このドキュメントの後半で説明します。
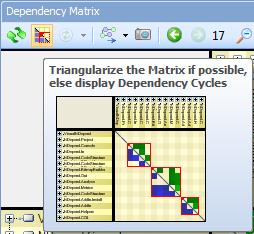
CppDependには、ユーザーがDSM上で見ているものを理解できるようにするコンテキスト依存ヘルプがあります。CppDependのDSMは、DSMセルに青、緑、黒の単純な3色スキームを採用しています。マウスで行または列にカーソルを重ねると、コンテキスト依存ヘルプがこの配色の意味を説明します:
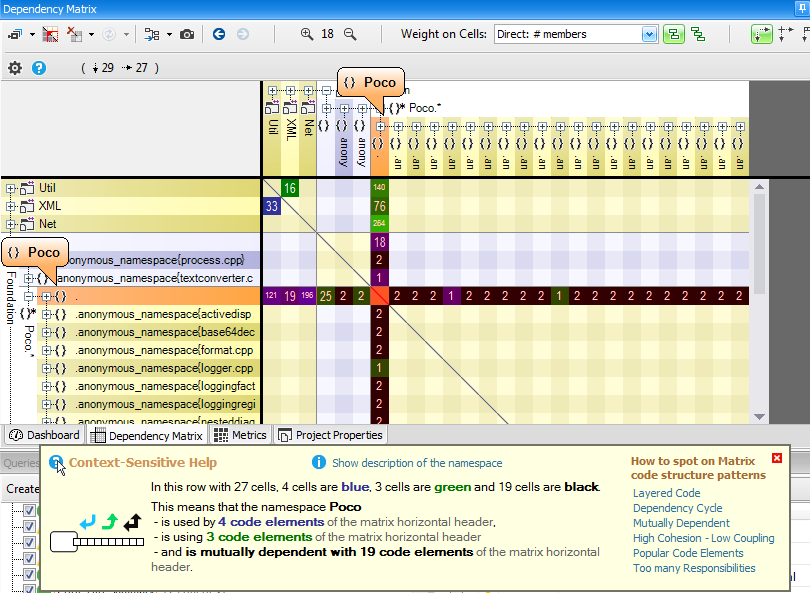
空でないDSMセルには数値が含まれます。この数値は、そのセルが表す結合の強さを表します。結合の強さは、 Weight on Cells オプションの現在値に応じて、結合に関係するメンバー、メソッド、フィールド、型、名前空間の数で表されます。コンテキスト依存ヘルプに加えて、DSMには結合を平易な英語で説明する情報パネルもあります:
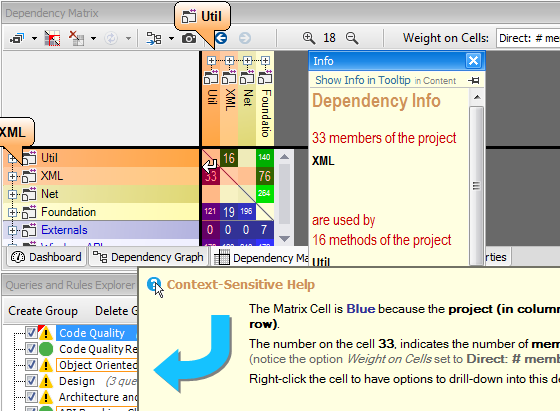
CppDependのDSMには、試せる多数のオプションがあります:
- 依存関係の探索を深めるための多くの機能がある(親の列/行を開く、セルを展開するなど)。
- 正方形の対称DSMと、長方形の非対称DSMの両方を処理できる。
- 水平ヘッダーと垂直ヘッダーを連結して、常に正方形の対称マトリクスを維持できる。
- さらに、 Indirect usage オプションもあり、セルには直接および間接的な使用が表示されます。
- 垂直ヘッダーには階層化されたコード要素を含められる。
- …
これらの機能はすべて、実際に自分のコードベースの依存関係を解析して試してみることをお勧めします。マトリクス上でコード構造パターンを識別する
はじめに説明したように、DSMには一般的なコード構造パターンを容易に識別できるという特徴があります。最も一般的なシナリオを紹介しましょう。レイヤードコード DSMによって明らかになるパターンの1つは、レイヤード構造(つまり非循環構造)です。マトリクスが三角形になり、すべての青いセルが左下の三角形に、すべての緑のセルが右上の三角形に配置されている場合、その構造が完全にレイヤード化されていることを示します。言い換えると、その構造には依存関係サイクルが含まれていません。
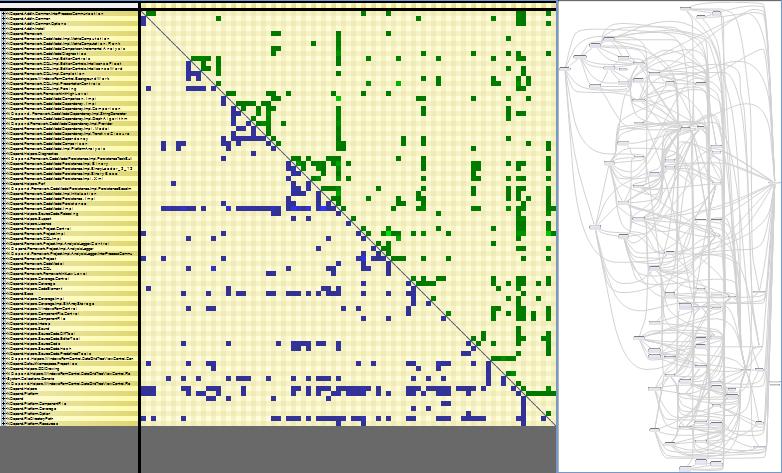
スナップショットの右側では、同じレイヤード構造がグラフで表現されています。すべての矢印が左から右へ同じ方向を向いています。グラフの問題は、グラフレイアウトがスケールしないことです。ここでは構造の全体像をかろうじて確認できます。ボックスの数が2倍になれば、グラフは完全に読み取れなくなるでしょう。一方、DSM表現は影響を受けません。DSMはグラフよりもスケールすると言われるのはこのためです。
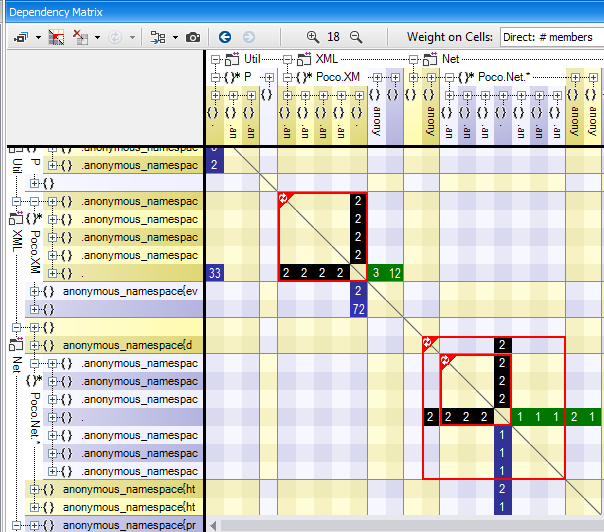
補足:興味深いことに、ほとんどのグラフレイアウトアルゴリズムは、グラフが非循環であるという事実に依存しています。サイクルを含むグラフのレイアウトを計算するために、これらのアルゴリズムは一時的に一部の依存関係を破棄してレイヤードグラフとして処理し、計算の最後の段階で破棄した依存関係を追加します。 依存関係サイクル 構造にサイクルが含まれている場合、そのサイクルはDSM上に赤い四角形で表示されます。赤い四角形の内部では、緑と青のセルが対角線をまたいで混在していることが分かります。また、相互の直接使用(つまりAがBを使用し、BがAを使用している状態)を表す黒いセルもあります。
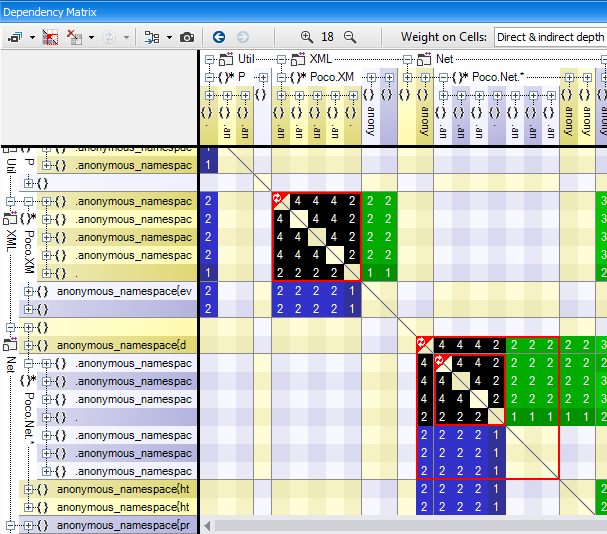
CppDependのDSMには、独自の Indirect Dependency オプションがあります。AとBの間の間接依存関係とは、Aがあるものを使用し、そのものが別のものを使用し、さらにそのものが別のものを使用し……最終的にBを使用している状態を意味します。以下には、同じサイクルを持つDSMが間接モードで示されています。赤い四角形が黒いセルだけで埋められていることが分かります。これは単純に、サイクル内の任意の要素AとBについて、AとBが間接的かつ相互に依存していることを意味します。
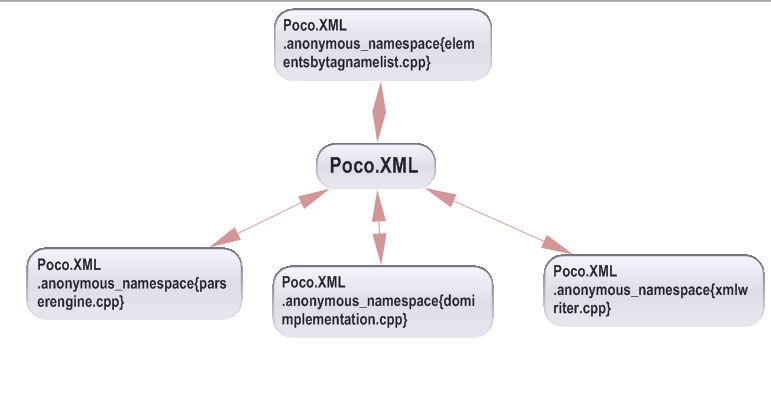
以下は、同じ構造をグラフで表したものです。赤い矢印は、複数の要素が相互に依存していることを示しています。しかしグラフでは、親サイクルに関係するすべての要素を強調表示するのに役立ちません。
CppDependでは、DSM内のサイクル(存在する場合)を強調表示するボタンを提供している点に注意してください。構造がレイヤード化されている場合、このボタンはマトリクスを三角化し、空でないセルを可能な限り対角線の近くに保ちます。
高凝集・低結合
高凝集(コンポーネント内)・低結合(コンポーネント間)という考え方は、今日広く知られています。しかし、依存関係を測定・可視化できなければ、凝集性と結合度を具体的に評価するのは困難です。DSMは高い凝集性を示すのに適しています。下のDSMでは、対角線の周囲に明確な四角形の集まりが表示されています。これは、その四角形に関係する要素が高い凝集性を持つこと、つまり互いに強く依存し合っていることを意味します。さらに、サイクルがないため、それらがレイヤード化されていることも分かります。これらは、名前空間やアセンブリなどの親成果物へグループ化する候補と言えるでしょう。
一方、四角形の周囲にあるほとんどのセルが空であることは、その四角形内の要素と他の要素との結合度が低いことを示しています。
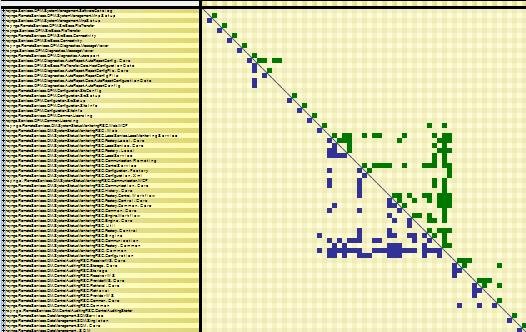
下のDSMでは、高い凝集性を持つ2つのコンポーネント(上側と下側の四角形)と、それらの間のかなり低い結合度を確認できます。
リファクタリング時には、このような指標があると、粗いコンポーネントをより細かい複数のコンポーネントへ分割する機会があるかどうかを判断するうえで非常に役立ちます。
責務が多すぎる
単一責任の原則(SRP)は、今日ソフトウェアアーキテクトのコミュニティで広まっています。この原則は、クラスには変更する理由が複数あってはならないと述べています。SRPのもう1つの解釈は、クラスが異なる他の型を多すぎるほど使用すべきではないというものです。この考えを他のレベル(アセンブリ、名前空間、メソッド)へ拡張すると、あるコード要素が(同じレベルの)数十個の異なるコード要素を使用している場合、そのコード要素には責務が多すぎると言えるでしょう。このようなコードを表す用語として、GodクラスやGodコンポーネントがよく使われます。
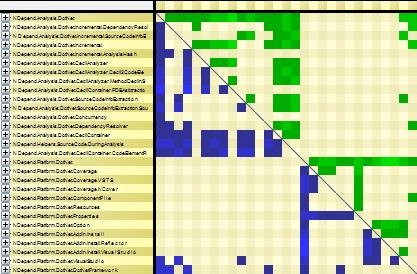
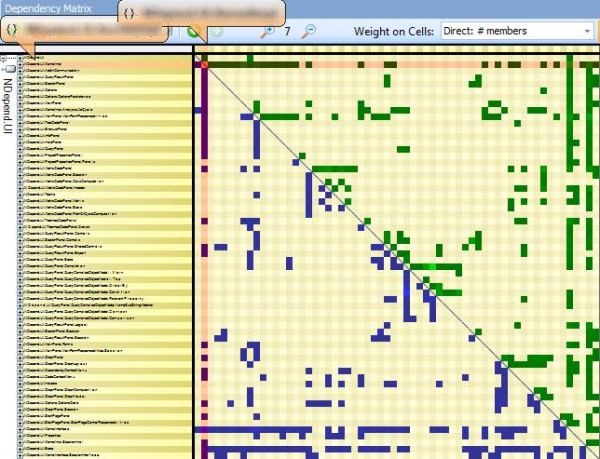
DSMは、責務が多すぎるコード要素を特定するのに役立ちます。そのようなコード要素は、多くの青いセルを持つ列と、多くの緑のセルを持つ行で表されます。下のDSMはこの現象を示しています。
人気のあるコード要素
人気のあるコード要素は、他の多くのコード要素から使用されます。人気のあるコード要素は避けられません(たとえば、 String クラスを考えてみてください)。ただし、人気があること自体は欠陥ではありません。すべてのコードベースには、人気のあるクラスで表される中心的な概念がいくつか存在するというだけです。
人気のあるコード要素は、多くの緑のセルを持つ列と、多くの青いセルを持つ行で表されます。下のDSMは、人気のあるコード要素を強調表示しています。
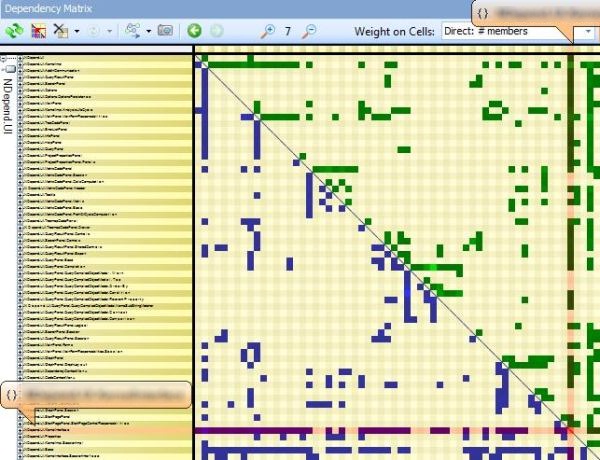
注目すべき点は、コード構造を完全にレイヤード化しておくと、人気のあるコンポーネントが自然に下位レベルに保たれることです。実際、人気のあるコンポーネントは本質的に多くのものを使用できません。人気のあるコンポーネントは下位レベルにあるため、より上位のレベルにあるものを使用できないからです。そのような使用は下位レベルから上位レベルへの依存関係を生み出し、構造の非循環性を壊してしまいます。
相互依存
2つのコンポーネント間の結合は、空でないセルを右クリックして、 Open this dependency メニューを選択すると確認できます。
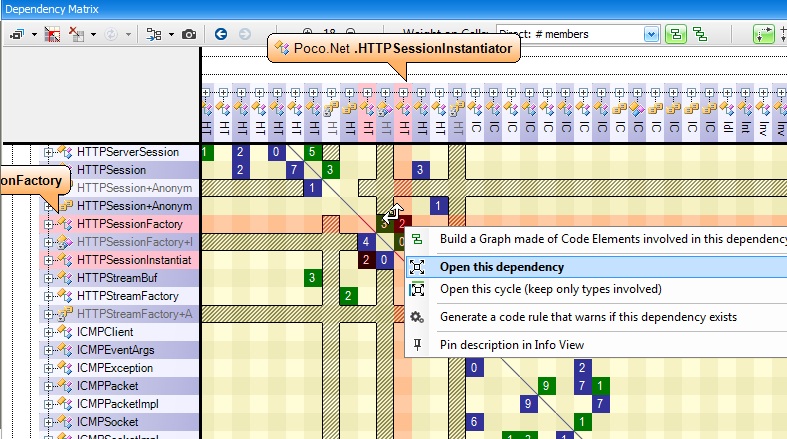
上のスナップショットのように、開いたセルが黒い場合(つまりAとBが相互に依存している場合)、結果として得られる長方形のマトリクスには、下のスナップショットのように緑と青の両方のセル(場合によっては黒いセルも)が含まれます。
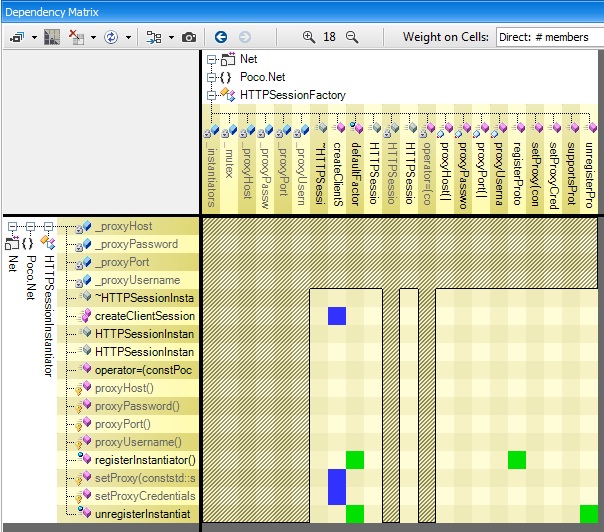
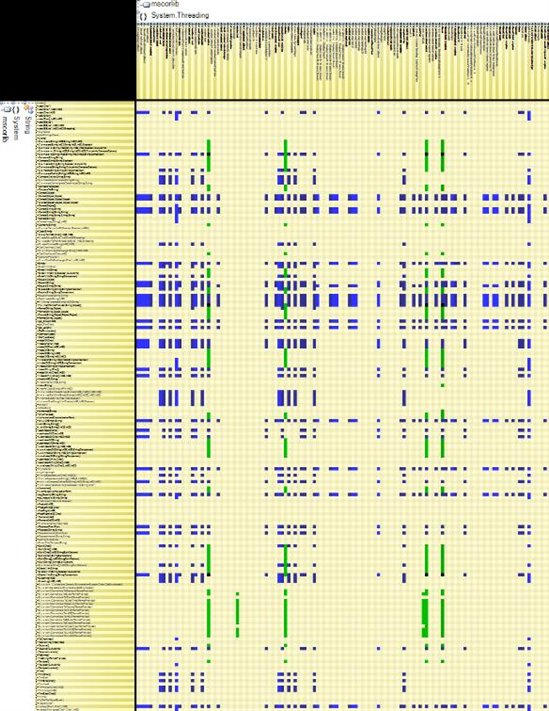
この状況では、緑または青のセルの数に偏りがあることに気づくことがよくあります(ここでは青3つに対して緑1つ)。これは、2つのコード要素が相互に依存している場合でも、それらの間には自然なレベル順序が存在することが多いためです。たとえば、 System.Threading 名前空間と System.String クラスを考えてみましょう。これらは相互に依存しており、互いに依存し合っています。しかし、マトリクスは Threading が String に、逆よりもはるかに強く依存していることを示しています(青いセルが緑のセルよりもはるかに多くなっています)。これは、 Threading が上位レベルにあり、下位レベルにあるのは String。