
Vor einigen Jahren kritisierte Linus Torvalds C++ und sagte:
ineffiziente abstrahierte Programmiermodelle, bei denen man zwei Jahre später feststellt, dass eine bestimmte Abstraktion nicht besonders effizient war. Inzwischen hängt jedoch der gesamte Code von den darauf aufgebauten Objektmodellen ab, sodass sich das Problem nicht mehr beheben lässt, ohne die Anwendung neu zu schreiben.
Viele C++-Entwickler teilen diese Meinung nicht. Dennoch müssen wir anerkennen, dass jedes Sprachfeature seinen Preis hat. Es ist besser, diese Kosten zu verstehen, als davon auszugehen, die eigene bevorzugte Programmiersprache sei perfekt.
Keine Sprache, Technologie und kein Betriebssystem ist perfekt. Wer die jeweiligen Grenzen und Nachteile kennt, kann das Werkzeug jedoch gezielter und effektiver einsetzen.
Dazu analysieren wir denGitQuellcode und betrachten einige Aspekte seines Designs. Git ist ein verteiltes Versionskontroll- und Source-Code-Management-System (SCM), bei dem Geschwindigkeit eine zentrale Rolle spielt. Ursprünglich wurde Git von Linus Torvalds für die Entwicklung des Linux-Kernels entworfen und entwickelt; inzwischen wird es von zahlreichen weiteren Projekten eingesetzt.
Vergleichen wir den Refactoring-Mehraufwand einiger OOP-Mechanismen von C++ mit ihren Entsprechungen in C.
Modularität: Namespace vs. Verzeichnis
Modularität ist eine Technik des Softwaredesigns, bei der Software stärker in voneinander getrennte Teile gegliedert wird. Modularer Code lässt sich dadurch leichter verwalten und warten.
Ein Projekt lässt sich auf zwei Arten modularisieren:
- Physisch: mithilfe von Verzeichnissen und Dateien. Diese Form der Modularität wird vom Betriebssystem bereitgestellt und kann unabhängig von der Programmiersprache eingesetzt werden.
- Logisch: mithilfe von Namespaces, Komponenten und Klassen. Diese Technik hängt von den Möglichkeiten der jeweiligen Sprache ab.
Bei der Entwicklung in C kann der Code mithilfe von Verzeichnissen strukturiert werden, um Module voneinander zu trennen. Hier sehen Sie den Abhängigkeitsgraphen zwischen einigen Git-Verzeichnissen.
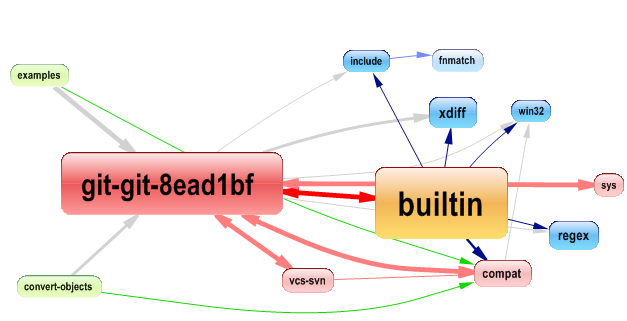
Mit C++ können wir stattdessen Namespaces verwenden, um den Code zu modularisieren. Diese Konstrukte werden von der Sprache selbst bereitgestellt. Im vorherigen Graphen könnten wir den Code also mit Namespaces statt mit Verzeichnissen strukturieren.
Vor- und Nachteile des C++-Ansatzes:Verständlichkeit:Der logische Ansatz ist verständlicher, weil die Modularität klar durch Sprachkonstrukte definiert wird. Schon beim Lesen des Codes lässt sich erkennen, zu welchem Modul ein Codeelement gehört.
Umgang mit Änderungen:Ein gutes Design benötigt in der Regel mehrere Iterationen. Beim physischen Ansatz können die Auswirkungen von Designänderungen deutlich begrenzter sein als beim logischen Ansatz: Oft muss lediglich eine Funktion oder Variable in eine andere Datei oder eine Datei in ein anderes Verzeichnis verschoben werden. In C++ kann dieselbe Änderung dagegen einen erheblichen Teil des Codes betreffen, weil die logische Modularität über Sprachkonstrukte umgesetzt wird und somit Codeänderungen erfordert.
Kapselung: Klasse vs. Datei
In C++ bezeichnet Kapselung das Zusammenfassen von Daten und Funktionen in einer Einheit, der Klasse. Der Programmierer greift dabei nicht direkt auf die Daten zu; der Zugriff erfolgt über die in der Klasse vorhandenen Funktionen.
Auch in C lässt sich Kapselung erreichen, allerdings über einen physischen Ansatz wie im Abschnitt zur Modularität beschrieben: Eine Datei kann Funktionen und die von ihnen verwendeten Daten enthalten; mit dem Schlüsselwort „static“ lässt sich die Sichtbarkeit von Funktionen und Variablen einschränken.
Git nutzt diese Technik, um Funktionen und Variablen zu verbergen. Suchen wir zur Überprüfung nach statischen Funktionen:
from m in Methods where m.IsStatic select m
Die Treemap bietet einen übersichtlichen Blick auf die Codeelemente, die von einer CQLinq-Abfrage erfasst werden; die blauen Rechtecke stellen die Ergebnisse dar.
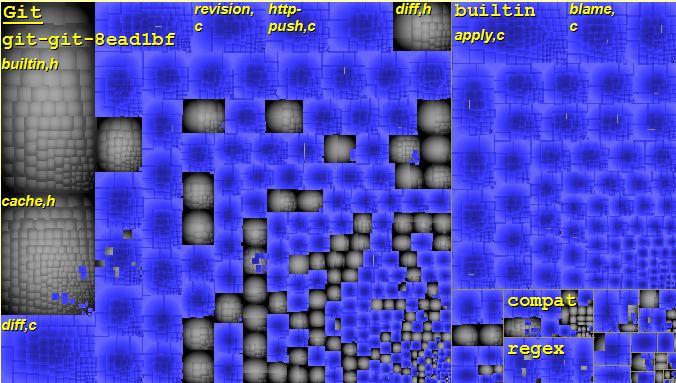
Fast alle Funktionen sind als static deklariert und damit nur innerhalb der Übersetzungseinheit sichtbar, in der sie deklariert wurden. Dasselbe gilt für die Variablen.
from f in Fields where f.IsStatic select f
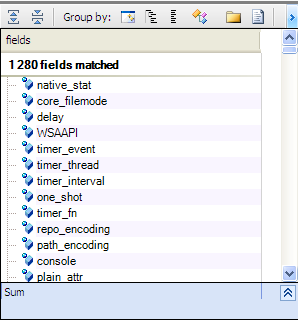 Easy to Understand:
Die Kapselungsmechanismen von C++ verbessern die Klarheit des Codes und machen Zusammenhänge leichter verständlich.
Umgang mit Änderungen: Wenn geändert werden muss, wo eine Variable oder Funktion gekapselt ist, kann dies in C sehr einfach sein; in C++ kann es dagegen viele Codestellen betreffen.
Polymorphie vs. Selection Idiom
Polymorphie bedeutet, dass sich Code, Operationen oder Objekte je nach Kontext unterschiedlich verhalten können.
Diese Technik ist in C++-Projekten weit verbreitet. Doch wie sieht es in C aus?
In prozeduralen Sprachen wird Auswahl typischerweise mit Schlüsselwörtern wie „switch“, „if“ oder sogar „goto“ umgesetzt. Dieser Ansatz erhöht jedoch tendenziell die zyklomatische Komplexität des Codes.
Suchen wir im Git-Quellcode nach komplexen Funktionen.
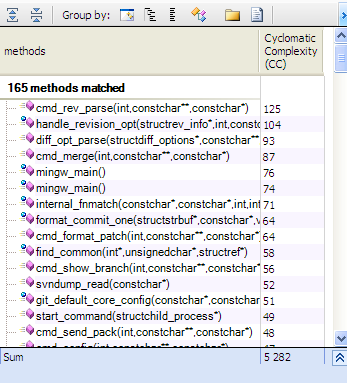
Obwohl Git gut entwickelt ist, können viele Funktionen als komplex gelten. Das liegt teilweise am intensiven Einsatz von Kontrollflussanweisungen wie „if“, „switch“ und „goto“. In C++ kann Polymorphie dagegen dazu beitragen, die Codekomplexität zu reduzieren.
Verständlichkeit: Polymorphie ermöglicht es, ein bestimmtes Verhalten in einer Klasse zu isolieren. Dadurch werden Übersichtlichkeit und Kohäsion des Codes verbessert.
Umgang mit Änderungen: Ein weiteres Verhalten kann bei Polymorphie eine zusätzliche Klasse erfordern. Beim Selection Idiom genügt dagegen ein weiterer case-Zweig in der switch-Anweisung.
Vererbung vs. Komposition
Git verwendet im Wesentlichen Structs, um die von Funktionen verarbeiteten Daten zu definieren. Suchen wir nach allen verwendeten Structs:
from t in Types where t.IsStructure select t
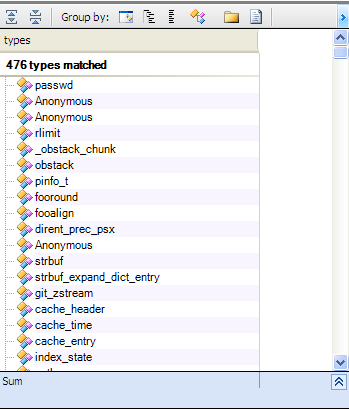
Interessanterweise sind nahezu alle Daten in Structs gekapselt. Zur Überprüfung können wir nach allen öffentlichen, nicht konstanten Variablen primitiver Typen suchen, die sich nicht innerhalb eines Structs befinden:
from f in Fields where f.IsPublic && f.IsPrimitiveType
&& !f.IsStatic && !f.IsConst
select f
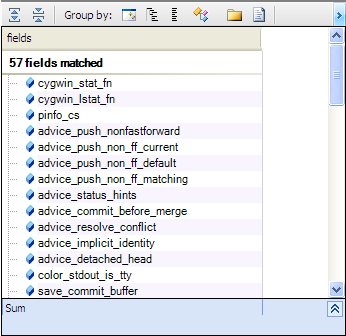
Nur wenige Variablen sind davon betroffen – ein positiver Punkt für das Design von Git.
Wie lässt sich nun ein Struct erweitern? In C können wir Komposition verwenden, etwa beim Struct „remote“, auf das viele andere Structs verweisen.
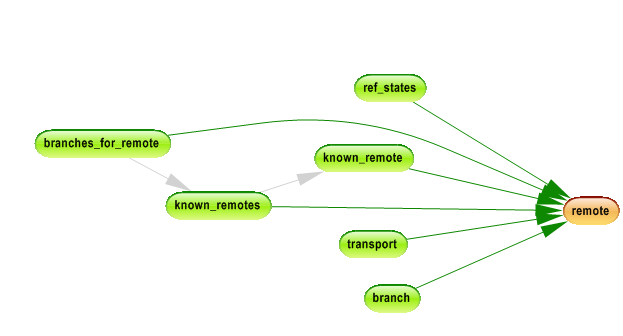
In C++ können wir Structs zusätzlich durch Vererbung erweitern; beispielsweise könnte known_remote von remote erben.
Verständlichkeit: Vererbung kann Beziehungen zwischen Daten verständlicher machen, muss jedoch mit Bedacht eingesetzt werden und eignet sich nur für echte „ist-ein“-Beziehungen.
Umgang mit Änderungen: Vererbung führt zu einer starken Kopplung, sodass Änderungen viele Codestellen betreffen können.
Fazit:
C++ bietet mehr Möglichkeiten, sauberen und gut strukturierten Code zu erstellen. Das hat jedoch seinen Preis: Änderungen und Refactorings können schwieriger werden.
Refactoring setzt voraus, den vorhandenen Code vor einer Änderung zu verstehen. C-Programme können schwerer zu verstehen, dafür aber leichter zu verändern sein.
Wie lässt sich die Auswirkung von Änderungen in C++ begrenzen?
Ein guter Weg, die Auswirkungen von Änderungen zu begrenzen, besteht darin, Design Patterns einzusetzen – insbesondere die Prinzipien loser Kopplung und hoher Kohäsion –, um Änderungen auf bestimmte Bereiche zu beschränken. Irrlicht ist, wie im vorherigenBeitrag, erläutert, ein gutes Beispiel für den Einsatz loser Kopplung.