
数年前、Linus Torvalds はC++を批判し、次のように述べました。
非効率な抽象化プログラミングモデルでは、2年後にある抽象化があまり効率的ではなかったことに気づきます。しかし、その時点ですべてのコードが周囲の便利なオブジェクトモデルに依存しており、アプリケーションを書き直さなければ修正できません。
多くのC++開発者はこの意見を快く思っていません。しかし、あらゆる言語機能にはコストが伴うことは認めなければなりません。自分の好きなプログラミング言語が完璧だと思い込むより、そのコストを理解する方が有益です。
どの言語、技術、OSも完璧ではないことを忘れてはなりません。しかし、その限界と欠点を知っていれば、より効果的に活用できます。
この目的のために、 Git のソースコードを分析し、いくつかの設計上の事実を探ります。Gitは速度を重視した分散型リビジョン管理・ソースコード管理(SCM)システムです。Gitは当初、Linuxカーネル開発のためにLinus Torvaldsによって設計・開発され、その後多くのプロジェクトで採用されました。
いくつかのC++ OOPメカニズムと、それに相当するCの仕組みについて、リファクタリングのオーバーヘッドを比較してみましょう。
モジュール性:名前空間 vs ディレクトリ
モジュール性とは、ソフトウェアが独立した部分で構成される度合いを高めるソフトウェア設計手法であり、モジュール化されたコードを管理・保守しやすくします。
プロジェクトをモジュール化するには、2つのアプローチがあります。
- 物理的な方法:ディレクトリとファイルを使う方法です。この形のモジュール性はOSによって提供され、どの言語にも適用できます。
- 論理的な方法:名前空間、コンポーネント、クラスを使う方法です。この手法は言語の機能に依存します。
Cで開発する場合、ディレクトリを使ってモジュールを分離し、コードを構造化できます。Gitのいくつかのディレクトリ間の依存関係グラフを次に示します。
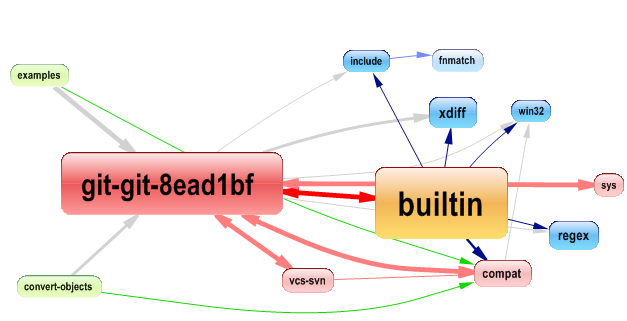
一方、CではなくC++を使えば、名前空間によってコードをモジュール化できます。これらの構文は言語によって提供されます。前のグラフでは、ディレクトリの代わりに名前空間を使ってコードをモジュール化できます。
C++アプローチの長所と短所:理解しやすさ: 論理的なアプローチの方が優れています。モジュール性が言語要素によって明確に定義されるため、コードを読むだけで、あるコード要素がどのモジュールに存在するかを把握できるからです。
変更の管理: 良い設計には一般に多くの反復が必要です。物理的なアプローチでは、設計変更の影響を論理的なアプローチよりもはるかに限定できます。実際、関数や変数を別ファイルへ移すか、ファイルを別ディレクトリへ移すだけで済みます。一方C++では、論理的なモジュール性が言語構文によって実装されるため、この種の変更はコード修正を必要とし、広範なコードに影響する可能性があります。
カプセル化:クラス vs ファイル
C++におけるカプセル化とは、データと関数をクラスと呼ばれる単一の単位にまとめるプロセスです。カプセル化の手法を使うと、プログラマーはデータへ直接アクセスできません。データには、クラス内に存在する関数を通じてのみアクセスできます。
Cでもカプセル化を実現できますが、モジュール性のセクションで説明したような物理的なアプローチを使います。クラスは、関数とそれらが使用するデータを含むファイルと考えることができ、「static」キーワードを使って関数と変数のアクセス範囲を制限できます。
Gitはこの手法を使って関数と変数を隠蔽しています。それを確認するため、static 関数を検索してみましょう。
from m in Methods where m.IsStatic select m
ツリーマップは、CQLinqクエリの影響を受けるコード要素を明確に把握するのに非常に便利です。青い長方形が結果を表します。
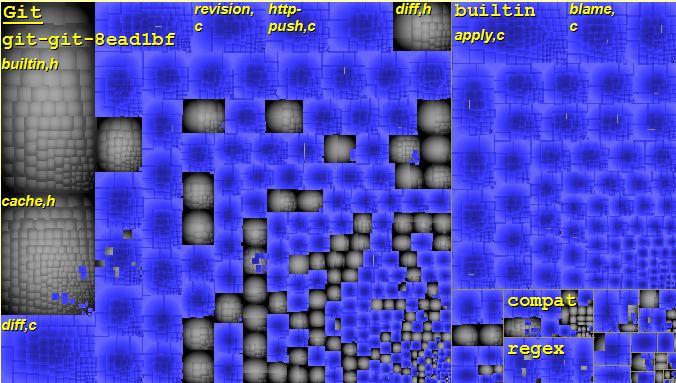
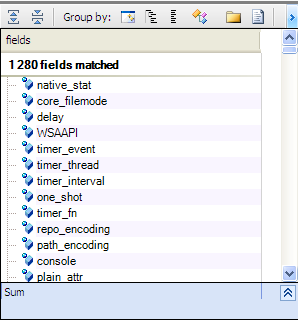
ほぼすべての関数が static として宣言されており、宣言された翻訳単位内でのみ可視になっています。同じことが変数にも当てはまります。
from f in Fields where f.IsStatic select f
 理解しやすさ:
C++のカプセル化機構を使うと、コードの明確さが向上し、関係も理解しやすくなります。
変更の管理:変数や関数がカプセル化されている場所を変更しなければならない場合、Cでは非常に簡単ですが、C++では広範なコードに影響する可能性があります。
ポリモーフィズム vs 選択イディオム
ポリモーフィズムとは、コード、操作、オブジェクトがコンテキストによって異なる振る舞いをできることを意味します。
この手法はC++プロジェクトで広く使われていますが、Cではどうでしょうか。
手続き型言語では、通常「switch」「if」、さらには「goto」などのキーワードを使って選択を実装しますが、このアプローチはコードの循環的複雑度を高める傾向があります。
Gitのソースコード内にある複雑な関数を検索してみましょう。
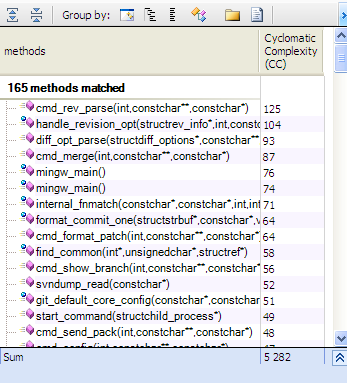
Gitはよく開発されていますが、複雑と見なせる関数が多くあります。これは部分的には、「if」「switch」「goto」などの制御フロー文を多用しているためです。一方C++では、ポリモーフィズムを使ってコードの複雑さを最小限に抑えられます。
理解しやすさ:ポリモーフィズムを使うと、特定の振る舞いをクラスに分離でき、コードの可視性と凝集度が向上します。
変更の管理:ポリモーフィズムで新しい振る舞いを追加する場合、新しいクラスの追加が必要になることがあります。一方、選択イディオムでは、switch文の下に新しいcaseを追加するだけで済みます。
継承 vs コンポジション
Gitでは主に構造体を使って、関数が操作するデータを定義しています。使用されているすべての構造体を検索してみましょう。
from t in Types where t.IsStructure select t
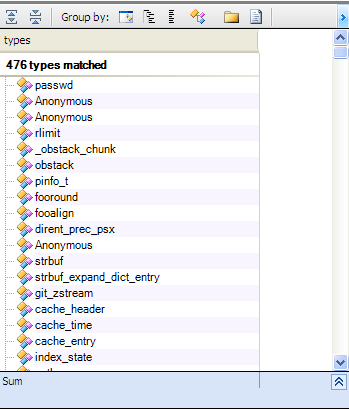
興味深いことに、ほぼすべてのデータが構造体内にカプセル化されています。これを確認するため、構造体内にない非constの公開プリミティブ変数をすべて検索できます。
from f in Fields where f.IsPublic && f.IsPrimitiveType
&& !f.IsStatic && !f.IsConst
select f
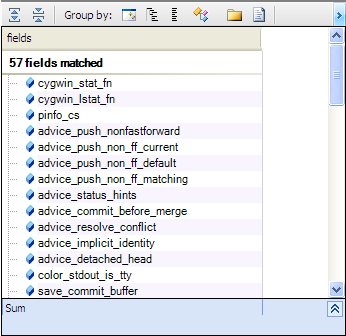
該当する変数はごくわずかであり、これはGit設計の良い点です。
では、構造体を拡張する場合はどうでしょうか。Cではコンポジションを使えます。たとえば「remote」構造体は、多くの構造体から参照されています。
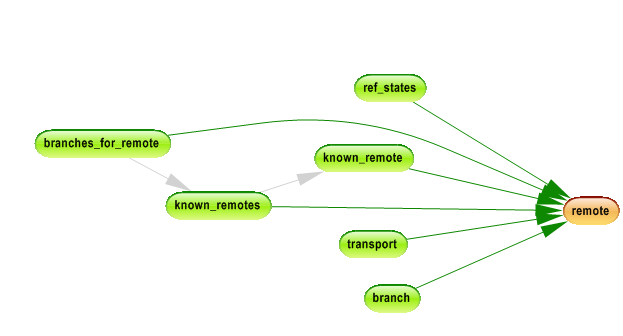
一方C++では、継承を使って構造体を拡張することもできます。たとえば、known_remote 構造体は remote 構造体を継承できます。
理解しやすさ:継承を使うとデータを理解しやすくなることがありますが、使用時には注意が必要です。継承は「Is-a」関係にのみ使うべきです。
変更の管理:継承は高い結合を伴うため、変更が広範なコードに影響する可能性があります。
まとめ:
C++には、クリーンで構造の整ったコードを作成するための手段がより多く用意されています。しかし、それにはコストが伴い、変更やリファクタリングがより難しくなる可能性があります。
リファクタリングでは、変更前に既存コードを理解する必要があります。Cプログラムは理解が難しい一方で、変更は容易な場合があります。
C++で変更の影響を限定するにはどうすればよいのでしょうか。
変更の影響を限定する良い方法は、デザインパターン、特に疎結合と高凝集の原則を使い、変更を特定の領域に閉じ込めることです。Irrlichtは、以前の 記事で説明したように、疎結合を活用する良い例です。