
Il y a quelques années, Linus Torvalds critiquait le C++ en ces termes :
des modèles de programmation abstraits inefficaces, où deux ans plus tard vous vous apercevez qu'une certaine abstraction n'était pas très efficace, mais que tout votre code repose désormais sur les jolis modèles d'objets qui l'entourent, et que vous ne pouvez plus le corriger sans réécrire votre application.
Beaucoup de développeurs C++ n'apprécient pas cette opinion. Il faut pourtant admettre que chaque fonctionnalité d'un langage a un coût, et qu'il vaut mieux comprendre ce coût plutôt que de supposer que votre langage de programmation préféré est parfait.
Gardez à l'esprit qu'aucun langage, aucune technologie ni aucun système d'exploitation n'est parfait. En connaître les limites et les inconvénients peut cependant vous aider à l'utiliser plus efficacement.
Pour cela, nous allons analyser le code source de Git et découvrir quelques faits de conception. Git est un système de gestion de versions distribué et de gestion de code source (SCM) axé sur la rapidité. Git a été initialement conçu et développé par Linus Torvalds pour le développement du noyau Linux ; il a depuis été adopté par de nombreux autres projets.
Comparons le surcoût de refactoring de certains mécanismes POO du C++ avec leurs équivalents en C.
Modularité : espace de noms contre répertoire
La modularité est une technique de conception logicielle qui augmente la mesure dans laquelle un logiciel est composé de parties distinctes, ce qui rend le code modulaire plus facile à gérer et à maintenir.
Nous pouvons modulariser un projet selon deux approches :
- Physiquement : en utilisant des répertoires et des fichiers. Cette forme de modularité est fournie par le système d'exploitation et peut s'appliquer à n'importe quel langage.
- Logiquement : en utilisant des espaces de noms, des composants et des classes. Cette technique dépend des capacités du langage.
Lorsqu'on développe en C, le code peut être structuré à l'aide de répertoires pour isoler les modules. Voici le graphe de dépendances entre certains répertoires de Git.
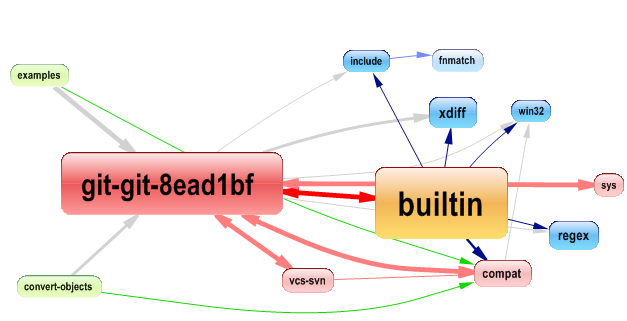
Avec le C++, en revanche, nous pouvons utiliser les espaces de noms pour modulariser le code ; ces constructions sont fournies par le langage. Pour le graphe précédent, nous pouvons utiliser des espaces de noms pour modulariser notre code au lieu de répertoires.
Avantages et inconvénients de l'approche C++ :Facilité de compréhension : L'approche logique est meilleure, car la modularité est bien définie par les artéfacts du langage, et la simple lecture du code permet de savoir dans quel module se trouve un élément de code.
La gestion des changements : une bonne conception nécessite généralement de nombreuses itérations, et avec l'approche physique, l'impact des changements de conception peut être bien plus limité qu'avec l'approche logique : en effet, il suffit de déplacer une fonction ou une variable d'un fichier à un autre, ou un fichier d'un répertoire à un autre. Avec le C++, en revanche, un tel changement peut affecter une quantité importante de code, car la modularité logique est implémentée au moyen de constructions du langage et requiert donc des modifications du code.
Encapsulation : classe contre fichier
En C++, l'encapsulation est le processus consistant à combiner données et fonctions en une seule unité appelée classe. Grâce à l'encapsulation, le programmeur ne peut pas accéder directement aux données. Celles-ci ne sont accessibles qu'à travers les fonctions présentes dans la classe.
En C, nous pouvons aussi réaliser l'encapsulation, mais par une approche physique comme celle décrite dans la section sur la modularité : une classe peut être un fichier contenant des fonctions et les données qu'elles utilisent, et nous pouvons limiter l'accessibilité des fonctions et des variables à l'aide du mot-clé « static ».
Git utilise cette technique pour masquer des fonctions et des variables ; pour le constater, cherchons les fonctions statiques :
from m in Methods where m.IsStatic select m
La treemap est très utile pour obtenir une vue d'ensemble claire des éléments de code concernés par une requête CQLinq ; les rectangles bleus représentent le résultat.
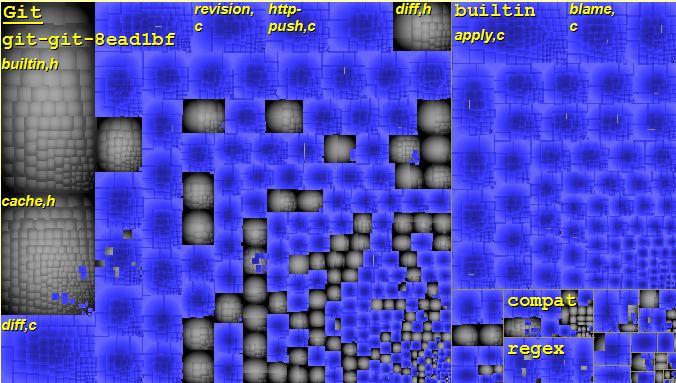
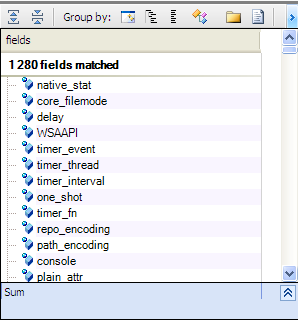
Presque toutes les fonctions sont déclarées static, de sorte qu'elles ne sont visibles que dans l'unité de traduction où elles sont déclarées ; la même observation vaut pour les variables.
from f in Fields where f.IsStatic select f
 Facilité de compréhension :
L'utilisation des mécanismes d'encapsulation du C++ améliore la clarté du code et rend les relations plus faciles à comprendre.
Gestion des changements: si l'on doit changer l'endroit où une variable ou une fonction est encapsulée, cela peut être très facile en C, mais en C++ cela peut impacter beaucoup de code.
Polymorphisme contre idiome de sélection
Le polymorphisme signifie que du code, des opérations ou des objets peuvent se comporter différemment selon les contextes.
Cette technique est largement utilisée dans les projets C++, mais qu'en est-il en C ?
Dans les langages procéduraux, la sélection est généralement implémentée à l'aide de mots-clés tels que « switch », « if » ou même « goto », mais cette approche tend à augmenter la complexité cyclomatique du code.
Cherchons les fonctions complexes dans le code source de Git.
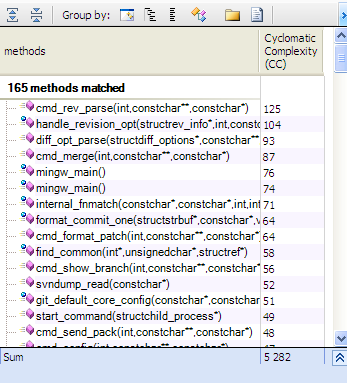
Même si Git est bien développé, de nombreuses fonctions peuvent être considérées comme complexes. Cela tient en partie à l'usage intensif d'instructions de flux de contrôle telles que « if », « switch » et « goto ». Avec le C++, en revanche, nous pouvons utiliser le polymorphisme pour minimiser la complexité du code.
Facilité de compréhension: l'utilisation du polymorphisme permet d'isoler un comportement spécifique dans une classe ; elle améliore la visibilité et la cohésion du code.
Gestion des changements: ajouter un autre comportement avec le polymorphisme peut impliquer l'ajout d'une autre classe ; avec l'idiome de sélection, en revanche, il suffit d'ajouter un cas supplémentaire sous l'instruction switch.
Héritage contre composition
Git utilise essentiellement des structs pour définir les données manipulées par les fonctions. Cherchons toutes les structs utilisées :
from t in Types where t.IsStructure select t
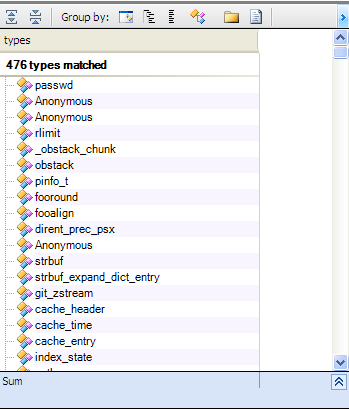
Fait intéressant, la quasi-totalité des données est encapsulée dans des structs. Pour le vérifier, nous pouvons chercher toutes les variables primitives publiques non const qui ne se trouvent pas dans une struct :
from f in Fields where f.IsPublic && f.IsPrimitiveType
&& !f.IsStatic && !f.IsConst
select f
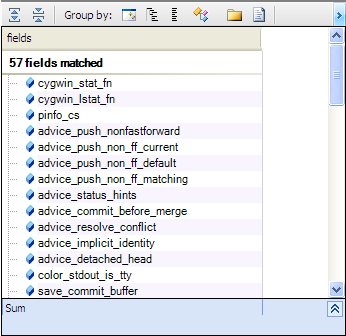
Seules quelques variables sont concernées, ce qui est un bon point pour la conception de Git.
Alors, comment étendre une struct ? En C, nous pouvons utiliser la composition, comme dans le cas de la struct « remote », à laquelle de nombreuses structs font référence.
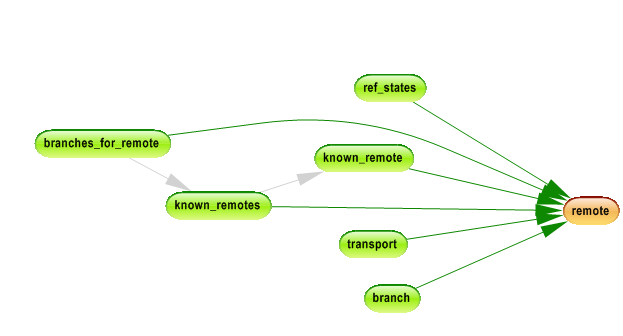
Avec le C++, cependant, nous pouvons aussi utiliser l'héritage pour étendre les structs ; par exemple, la struct known_remote pourrait hériter de remote.
Facilité de compréhension: l'utilisation de l'héritage peut améliorer la compréhension des données, mais il faut être prudent en l'employant ; il ne doit servir que pour la relation « est un ».
Gestion des changements: l'héritage implique un couplage fort, si bien que tout changement peut impacter beaucoup de code.
Conclusion :
Le C++ offre davantage de moyens de créer du code propre et bien structuré, mais cela a un coût : les changements et le refactoring peuvent être plus difficiles.
Le refactoring exige de comprendre le code existant avant d'y apporter des modifications. Les programmes C peuvent être plus difficiles à comprendre, mais plus faciles à modifier.
Comment limiter l'impact des changements en C++ ?
Un bon moyen de limiter l'impact des changements consiste à utiliser des design patterns, en particulier les principes de couplage faible et de forte cohésion, afin d'isoler les changements dans des zones spécifiques. Irrlicht, comme expliqué dans l' article précédent, est un bon exemple d'utilisation du couplage faible.