在现代软件工程中,开发者常常被教导要严格坚持单一语言范式:纯面向对象的 C++、严格的函数式编程,或单体的 C API。
llama.cpp 的巨大成功证明了一个不同的论点:务实胜过教条。
llama.cpp 并没有在整个项目中强制推行统一的设计模式,而是构建为一个分层体系,每一层都刻意采用最适合其特定问题域的范式进行工程设计——从底层 C 内存竞技场(arena)一直到现代 C++ 抽象。
让我们使用 CppDepend 分析 llama,并探索 llama.cpp 的整体代码质量:
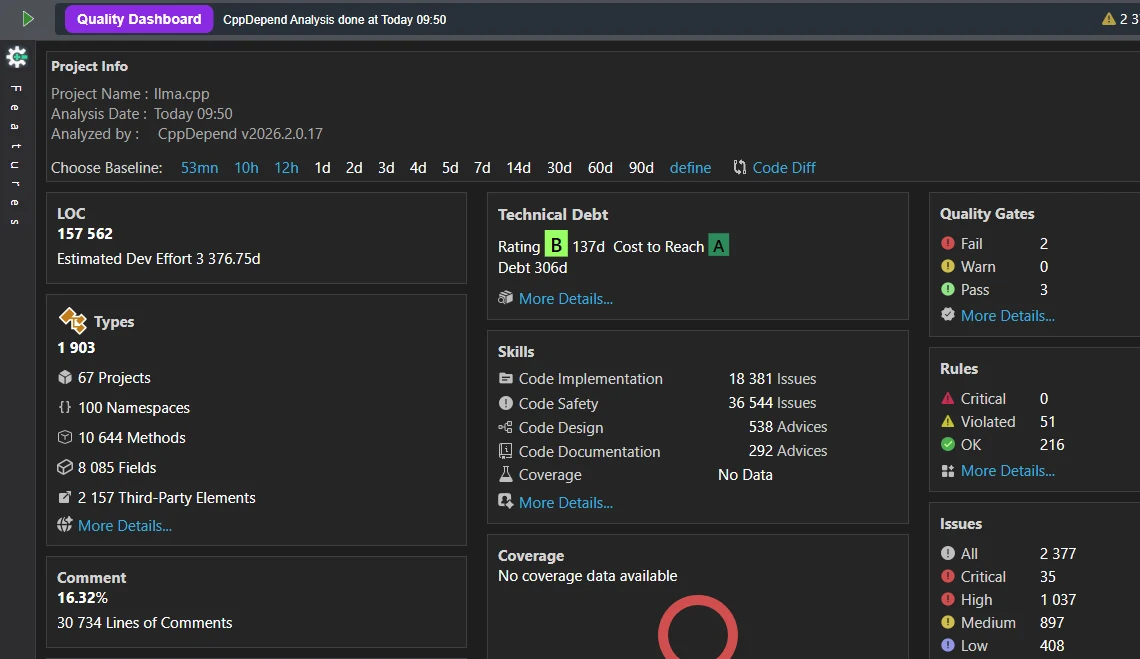
该项目在整体代码质量和技术债务方面获得了 B 级评级,展示了结构良好的架构和相对较低的技术债务密度。
1. 以 Code City 方式探索 llama.cpp
在评估了汇总仪表板之后,我们可以使用 Code City 功能直观地探索代码可以改进的地方。将代码库可视化为 3D Code City,可以立即提供关于耦合、热点、代码异味、方法大小和问题分布的视觉洞察。
在这座 Code City 中,每栋建筑代表一个方法,而颜色表示健康状况和问题的严重程度。将鼠标悬停在任何建筑上,都会显示详细的诊断指标。
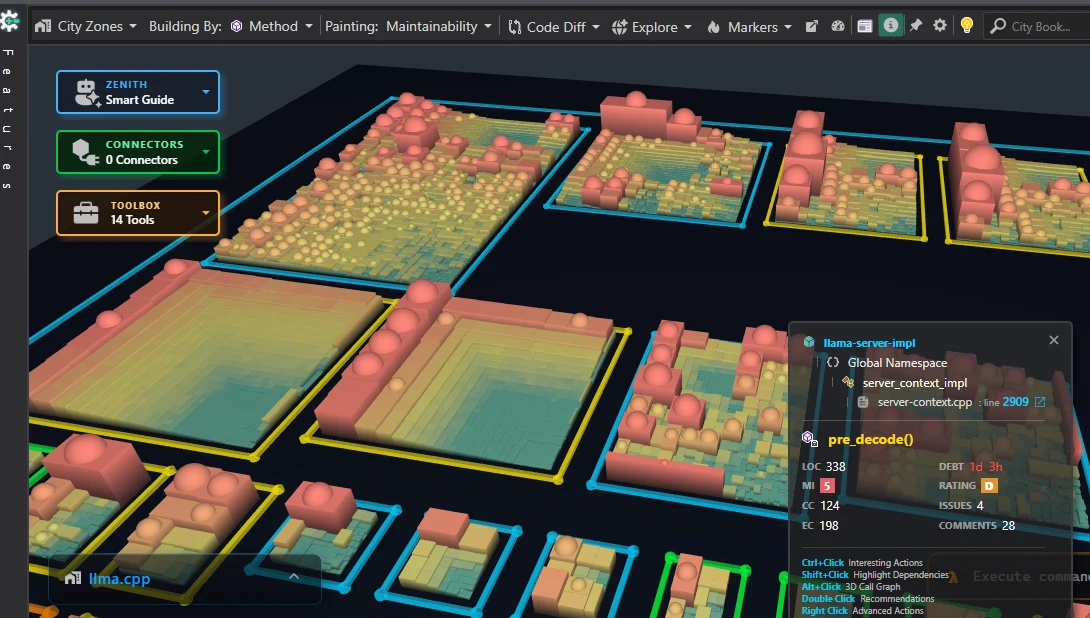
虽然许多方法以红色高亮显示,但仔细观察会发现它们通常只是代码异味。正如 Issues Explorer 所示,检测到了许多代码异味:
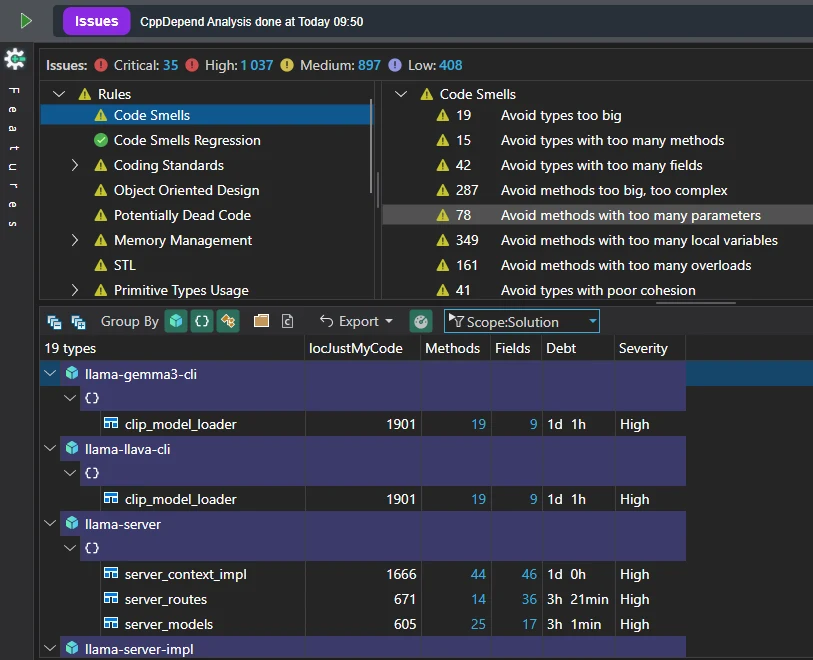
以下是这些函数即使设计是有意为之也会触发代码异味警告的一些原因:
1.1. 内联与缓存局部性(避免函数调用开销)
在底层 SIMD 和矩阵数学内核中,将一个 500 行的循环拆分为 10 个较小的辅助函数会破坏执行效率:
- 寄存器溢出与指令开销:函数调用会将寄存器压入栈并产生跳转指令。在每秒执行数十亿次的紧凑循环中(例如内部量化 GEMM 循环),函数调用开销会显著降低性能。
- 指令缓存命中:单一的巨型循环能让热点执行指令在 CPU 指令缓存(I-Cache)或 GPU 共享内存中保持连续,从而避免流水线停顿。
1.2. 通过集中式分发支持海量模型
llama.cpp 在单体式图构造函数(例如 llama_build_graph)中支持数十种模型架构(Llama、Mistral、Gemma、Mixtral、DeepSeek、Command R)。
- 详尽的架构 switch 块:llama.cpp 没有使用复杂的 C++ 面向对象继承体系(例如
class LlamaModel : public ModelBase),而是使用基于模型架构枚举的巨型 switch 语句。 - 权衡:静态分析器因其庞大的体量将其标记为"Brain Methods"(大脑方法)或"God Functions"(上帝函数),但这种过程式布局使图节点的构建完全透明,并在一个连续的代码块中清晰可见。
1.3. 量化类型爆炸(ggml_type switch 循环)
单个数学运算(如张量乘法)必须处理 F32、F16、Q4_0、Q4_K_M、Q8_0、IQ3_XXS 等多种组合。
// Common pattern triggering complexity warnings in GGML
switch (tensor->type) {
case GGML_TYPE_Q4_0: /* SIMD unroll for Q4_0 */ break;
case GGML_TYPE_Q4_K: /* SIMD unroll for Q4_K */ break;
case GGML_TYPE_Q8_0: /* SIMD unroll for Q8_0 */ break;
// ... 20+ quantization types unrolled directly in line
}由于每种量化类型都有自己的块布局和向量反量化数学运算,这些循环包含大量嵌套块,导致圈复杂度指标飙升。
1.4. 快速的开源演进("黑客 C"文化)
llama.cpp 从一个单文件 C++ 概念验证演变成了一个庞大的社区项目:
- 特性集成速度:当新论文或新模型架构发布时(例如自定义 RoPE 嵌入或 MoE 中的专家路由),贡献者会直接在现有的图构建函数中添加执行分支。
- 务实优先于抽象:该项目有意将原始执行速度和单文件修改的便利性置于严格的 OOP 设计模式之上。
2. llama.cpp:运用 GRASP 模式的艺术
llama.cpp 在独立的工作区模块中应用 GRASP(通用职责分配软件模式)原则,隔离核心职责,同时避免紧密的运行时耦合。
2.1. 高层模块化分解(GRASP Scope)
该项目没有构建一个庞大的单体可执行文件,而是将功能划分到不同的模块中:
2.2. GRASP 原则如何驱动解耦
高内聚与单一职责(SRP)
- ggml(张量运行时):专门负责张量结构(
ggml_tensor)、内存分配竞技场、计算图构建(ggml_cgraph)和后端编排。它对 LLM transformer、分词或提示词格式化零感知。 - libllama(include/llama.h, src/llama.cpp):管理 transformer 机制、GGUF 文件加载、KV 缓存分配和序列采样。它将矩阵数学运算完全下放给 ggml。
- common(llama-common / common/):封装跨领域的 CLI 工具、参数解析、控制台日志、CPU 亲和性、基准测试和推测执行逻辑。核心引擎的使用者可以直接链接 libllama,而无需依赖 common。
信息专家(Information Expert)
- 硬件后端(ggml-cuda、ggml-metal、ggml-vulkan):每个后端都是在其硬件目标上执行张量运算的唯一专家。硬件细节绝不会泄漏到 llama.cpp 或高层应用代码中。
受保护的变化与低耦合
- 纯 C API 边界(include/llama.h):高层应用仅通过 C 风格句柄(
llama_model*、llama_context*)与引擎交互。这创建了一道架构防火墙:llama.cpp 的整个内部实现可以重构,而不会破坏下游工具或绑定(Python、Node.js、Rust)。
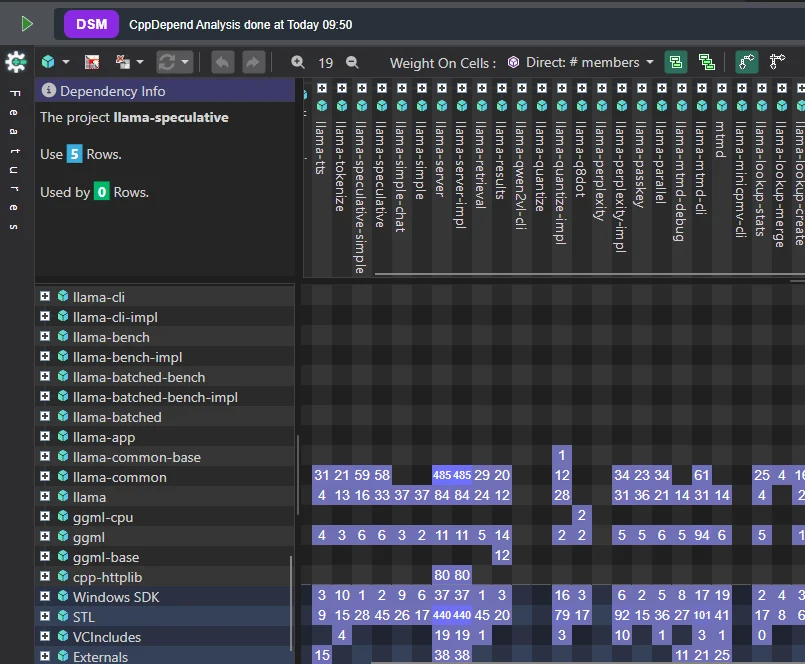
2.3. 依赖矩阵洞察:"块对角"模式
在依赖结构矩阵(DSM)中评估这种多项目配置时:
- 清晰的块隔离:矩阵呈现为对应 ggml、llama 和 common 的明显对角块。
- 没有不必要的串扰:ggml 组件从不引用 llama.cpp 或 common。llama 组件依赖 ggml,但对高层 CLI 代码完全无感知。
- 可插拔架构:你可以剥离 common/ 和 tools/,将 libllama 直接链接到嵌入式运行时或桌面应用程序中,占用极小。
3. 量化代码库的抽象程度
抽象类型在现代 C++ 中被广泛用于实现简洁、注重解耦的设计,但 llama.cpp 是这样的吗?让我们用这个查询在代码库中搜索抽象类型:
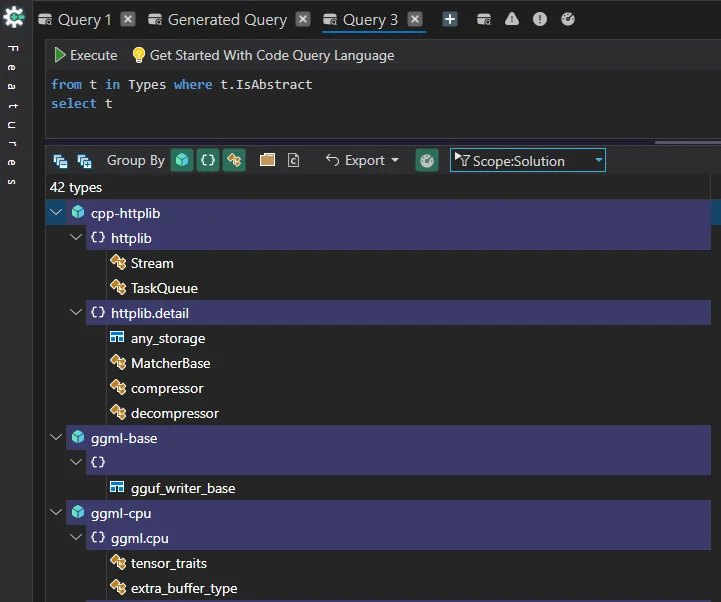
只有少数类型是抽象的,llama.cpp 刻意避免经典的面向对象编程(OOP)范式,如抽象基类、动态分发(虚函数)和繁重的继承体系。
这一设计选择归结为四个核心工程权衡:
3.1. 消除虚表开销与间接寻址
在高性能 C++ 中,虚函数调用需要在虚表(vtable)中查找函数指针。
- 缓存未命中与指针追逐:在深层张量图执行循环中,每秒数千次虚调用会引入分支预测错误,并迫使 CPU 流水线停顿。
- 内联阻碍:编译器通常无法内联虚方法调用,因为具体类型在编译时未知。通过使用普通 C 结构体、显式函数指针或静态模板,编译器可以将代码直接内联到原始汇编循环迭代中。
3.2. 可预测的内存布局优于多态指针存储
抽象类迫使你使用指针或智能指针(std::unique_ptr<ITensor>)来支持动态分发。
- 指针导致堆分配(malloc/new),造成堆内存碎片化。
- ggml(底层张量引擎)依赖平坦、连续的 bump 分配竞技场(
ggml_context)。内存偏移在执行开始前就被预先规划到单个静态图布局中。标准 OOP 抽象会破坏连续的内存布局,摧毁 L1/L2 缓存局部性。
3.3. 跨 C / 外语绑定的 ABI 稳定性
llama.cpp 旨在随处运行——嵌入到 Python(llama-cpp-python)、Rust、Go、Swift、C# 和 Node.js 中。
- 带有虚表的现代 C++ 类体系具有编译器修饰的符号名,在 GCC、Clang 和 MSVC 之间各不相同。
- 通过使用扁平的 C 风格结构体(
struct llama_model、struct llama_context)和 C 函数(llama_decode()),llama.cpp 暴露了干净的 C ABI 边界。任何语言都可以使用标准 C 头文件,而无需复杂的 C++ 运行时包装器。
3.4. 简单的计算图架构 vs 对象图
在标准软件应用中,多态用于建模业务实体(例如 class Dog : public Animal)。在 LLM 推理引擎中,领域模型由静态计算图和张量组成:
- 模型架构表示为张量数学节点序列(
ggml_mul_mat、ggml_add),而不是深层的对象树。 - 后端之间的差异(CUDA、Metal、Vulkan、CPU SIMD)通过静态后端分发、枚举标志或编译期执行流水线处理,而不是围绕每个操作的多态运行时包装器。
架构权衡总结
| 设计模式 | OOP / 抽象类 | llama.cpp C 风格 / 过程式 |
|---|---|---|
| 分发机制 | 动态(虚表查找) | 静态 / 直接 C 函数分发 |
| 内存分配 | 堆指针(new/malloc) | 连续预分配竞技场(ggml_context) |
| 编译器优化 | 受限(虚调用阻碍内联) | 最大化(热点 SIMD 循环易于内联) |
| 语言互操作 | 困难(需要复杂的 C++ 绑定) | 简单(暴露标准 C ABI) |
4. 在 Llama 模型中使用 POD 类型
C++ 中的 POD(Plain Old Data)类型是简单的 C 兼容数据结构,只保存数据,不带有现代 C++ 面向对象的额外开销。
让我们用这个代码查询搜索 llama.cpp 中使用的 POD 类型:
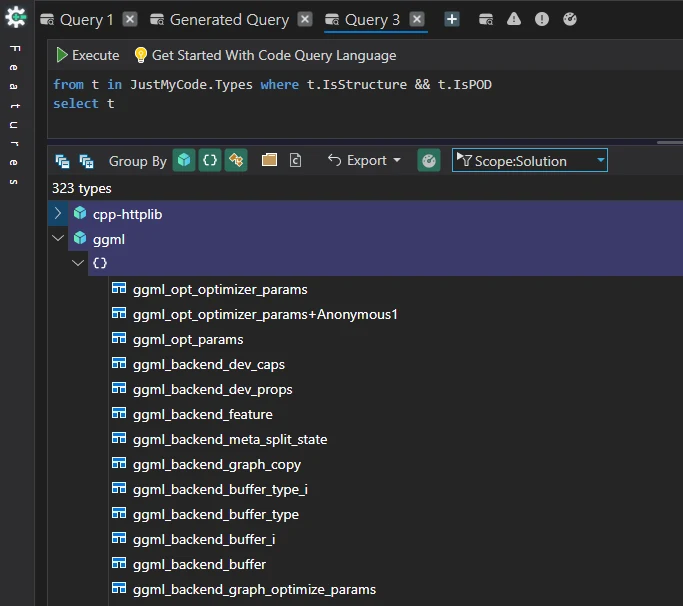
以下是 llama.cpp 处处使用简单 POD 结构体的原因:
4.1. 可预测的 C 兼容内存布局
C++ 中的 POD 结构体具有连续、确定性的内存占用,没有隐藏的编译器插入指针(例如用于虚函数的 vptr)。
- 直接序列化/反序列化:加载 GGUF 模型文件时,POD 结构允许将原始字节直接从磁盘读入内存(fread 或 mmap),直接进入结构体,无需复杂的解析、构造函数或对象分配。
- C ABI 兼容性:POD 结构体与标准 C 数据结构一一对应。这使得非 C++ 语言(Python、Rust、Go、Swift、C#)可以在内存中映射完全相同的结构体布局,而无需封送开销。
4.2. 极致的缓存局部性(L1/L2 缓存效率)
现代 CPU 的运行速度比主内存快数千倍。LLM 推理的性能在很大程度上依赖于让 CPU/GPU 流水线持续获得数据供给。
- 连续数组:由于 POD 类型内部没有隐藏开销或堆指针,它们可以紧密地打包到平坦、连续的数组中(
std::vector<llama_token_data>或原始内存竞技场)。 - 顺序缓存预取:在 token 采样或 KV 缓存管理期间迭代连续的 POD 结构体数组时,硬件预取器可以轻松地将后续元素加载到 L1/L2 缓存中,甚至早于循环请求它们。
4.3. 与自定义竞技场分配器兼容(ggml)
具有非平凡构造函数/析构函数的标准 C++ 对象需要 new 和 delete,它们在堆上动态分配内存。
- 堆分配会导致内存碎片化和不可预测的分配延迟。
- llama.cpp 通过
ggml_context使用 bump/竞技场分配器。原始内存一次性保留为一个巨大的块,POD 结构体直接放置在这个预分配的内存偏移处。由于 POD 不需要析构函数,回收或重置内存就像将单个指针重置为零一样快(offset = 0)。
4.4. 零运行时开销与平凡拷贝
POD 结构体在幕后没有隐藏的逻辑:
- 拷贝或移动 POD 结构体只是一次快速的内存拷贝操作(memcpy)。
- 按值或 const 引用传递 POD 结构体不会引入隐藏的拷贝构造函数或析构函数调用,让开发者完全掌控热点内部循环中的执行性能。
5. 标准模板库(STL)占用与使用情况
要了解 STL 在何处以及如何被使用,我们可以分析依赖矩阵,详细查看其在整个代码库中的使用情况。
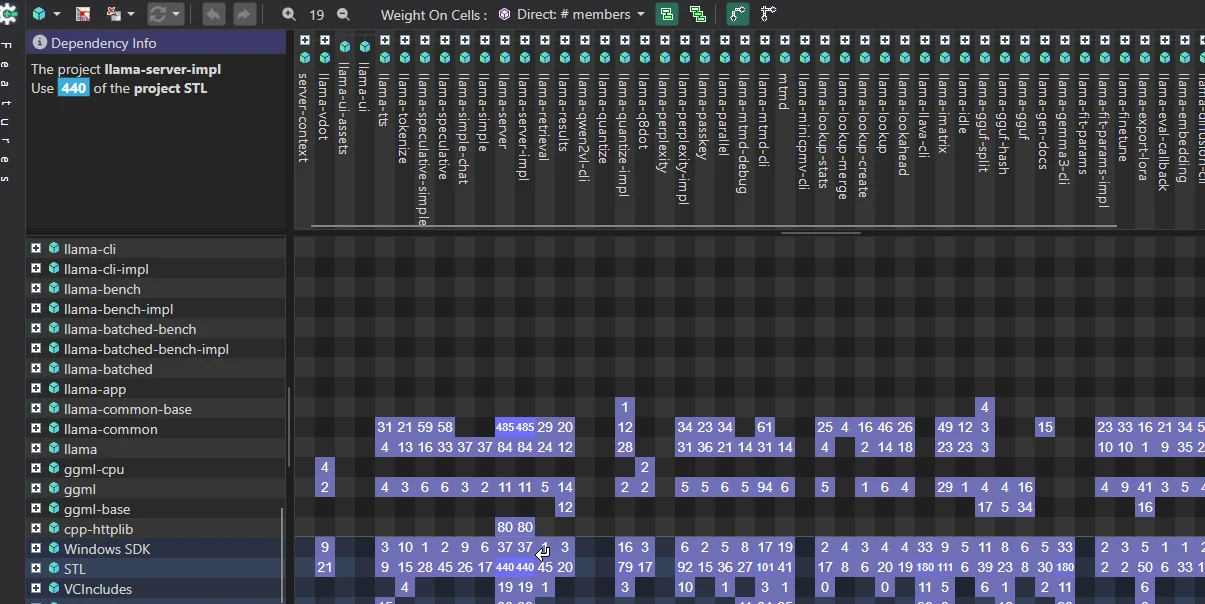
正如我们所见,STL 在高层模块中被大量使用,而底层模块很少使用它——甚至完全不使用。
5.1. llama-server:复杂的编排需要高层抽象
llama-server 是一个 HTTP API 守护进程,处理多线程、异步 I/O、槽位管理、JSON 解析、队列和 HTTP 状态。
它大量使用标准库特性(std::*),因为用底层过程式 C/C++ 编写网络编排代码是不切实际的:
- 并发与同步:
std::thread、std::mutex、std::condition_variable、std::future和std::atomic管理传入的 Web 请求并将推理任务排队。 - 复杂数据结构:
std::unordered_map、std::queue、std::map和std::vector处理多租户会话槽位、上下文状态和 token 序列。 - 字符串处理与格式化:
std::string、std::stringstream和正则表达式操作为 OpenAI 兼容的 REST 端点格式化 JSON 输入/输出。
5.2. 核心引擎(ggml 与 llama):为极致性能避免 STL
相比之下,ggml 和核心 llama 中的底层推理代码出于性能关键的原因避免深度使用 STL:
- 避免非确定性分配:像
std::vector或std::string这样的容器会在堆上动态分配和重新分配内存(malloc/free)。在热点张量矩阵乘法循环中,动态分配会触发操作系统系统调用并引入尾延迟尖峰。ggml 改用静态预分配的内存竞技场(ggml_context)。 - 二进制体积与编译速度:繁重的 C++ STL 模板展开(
<iostream>、<regex>、<algorithm>)会大幅增大二进制体积并减慢编译时间。保持核心计算文件精简,可以在嵌入式系统和轻量级微运行时上实现快速编译。 - 最大可移植性与裸机执行:ggml 运行在资源受限的平台、WASM(Web 浏览器)、微控制器和自定义硬件加速器上,这些环境中完整的 C++ 标准运行时可能被裁剪、缺失或效率低下。
6. 异常的使用
在内部计算层(ggml 和 llama)中严格避免使用 C++ 核心异常,尽管异常确实出现在高层辅助包装器中(llama-common、common/arg.cpp 和 llama-server)。
让我们用这个代码查询找出哪些模块使用了 std::exception 类:
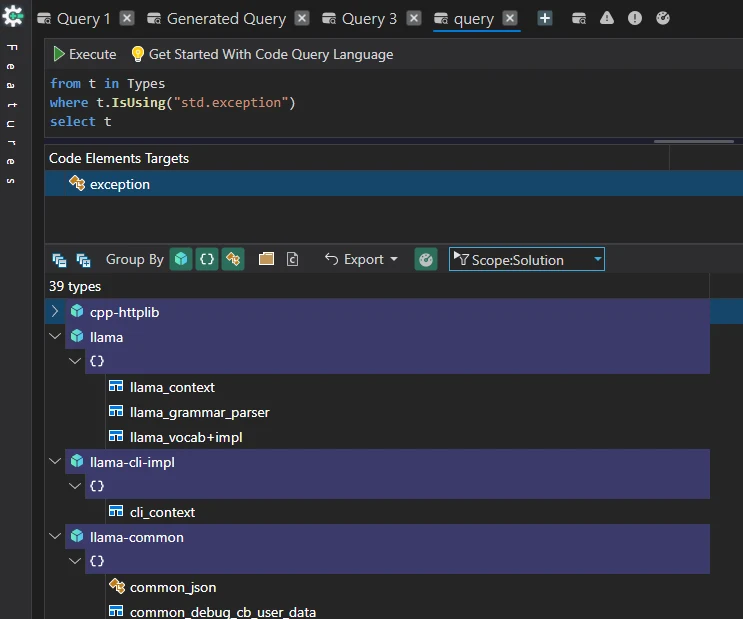
llama.cpp 在其架构中对错误处理遵循严格的划分:
6.1. ggml 与核心 llama:C 风格错误码与断言
在基础层中,异常处理被有意省略:
- 返回码与空指针:像
llama_decode()、llama_model_load()或内部分配例程这样的方法返回 nullptr、整数错误状态码(0、-1)或布尔标志,而不是抛出std::exception。 - 显式断言:不可恢复的不变量检查(例如张量维度不匹配或越界上下文执行)使用宏断言(
GGML_ASSERT/assert()),立即中止或安全地记录错误,而不是展开栈。 - C ABI 边界安全:llama.h 暴露的主要公共 API 是 C ABI。在 C++ 中跨 C 语言边界抛出 C++ 异常是未定义行为,因此核心函数绝不能让异常逃逸。
6.2. 高层包装器(llama-common 与 llama-server):选择性使用 C++ 异常
异常出现在高层工具中,以方便开发者:
- CLI 参数解析(arg.cpp):在解析命令行参数时抛出
std::runtime_error或std::invalid_argument(例如格式错误的标志选项或缺失的模型路径)。 - 服务器与第三方库(llama-server):使用 nlohmann::json 或 HTTP 解析器等库,这些库在解析错误负载时会自然抛出异常。这些异常在服务器循环顶层的 try/catch 块中被捕获。
为什么核心推理避免异常
- 零栈展开开销:启用异常(-fexceptions)会引入二进制代码膨胀和隐藏的控制流路径。在热点循环中禁用或避免异常,可以保持 SIMD 执行流水线和编译器优化的激进性。
- 确定性控制流:LLM 矩阵运算和内存竞技场(
ggml_context)需要显式清理。抛出的异常很容易绕过非 RAII 的自定义竞技场析构函数,导致大规模的 GPU/CPU 内存泄漏。 - 跨语言安全:语言绑定(Python、Rust、C#、Go)期望简单的 C 风格返回码,以便在其各自的本地语言运行时中干净地映射异常。
7. 命名空间的使用
在现代 C++ 中,命名空间是用于将代码组织为逻辑分组并防止跨库名称冲突的作用域边界。
让我们探索命名空间是否在 llama.cpp 中被广泛使用:
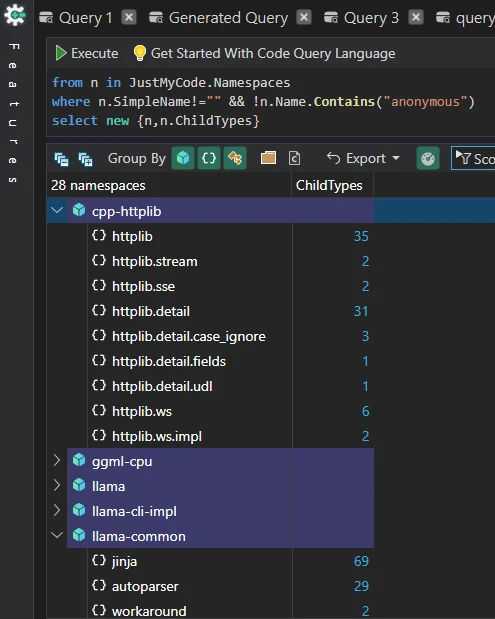
命名空间在 cpp-httplib 和 llama-common 中很突出,但在其余库中几乎不存在。以下是这种模式的一些原因:
7.1. 核心引擎(ggml)是纯 C
llama.cpp 的基础是 ggml 张量求值库。ggml 用标准 C(C99/C11)编写,以确保跨硬件后端(CPU、CUDA、Metal、Vulkan、OpenCL)的可移植运行时执行。
- 由于 C 不支持命名空间,ggml 为函数和结构体使用显式的
ggml_前缀(例如ggml_init、ggml_tensor、ggml_cgraph),以隔离符号而无需 C++ 命名空间。
7.2. ABI 稳定性与 C API 兼容性
llama.cpp 的主要设计目标之一是作为一个可嵌入的轻量级引擎,为其他语言(Python、Rust、Go、Java、Swift、C#)提供绑定。
- C++ 名称修饰:C++ 命名空间会在编译时改变导出的符号名。
- 为了暴露干净、未修饰的符号,使其与 dlopen 和 C FFI 包装器无缝配合,核心头文件导出纯 C ABI(
extern "C")。避免深层命名空间层次结构简化了共享库边界(llama.h、ggml.h)的导出。
7.3. C 风格数据结构与 POD 类型
llama.cpp 优先使用 POD(Plain Old Data)结构体、静态函数和显式函数签名,而不是面向对象的 C++ 层次结构。
- 代码隔离通过 .cpp 文件内的编译单元(文件作用域静态函数)管理,而不是将组件包装在嵌套的
namespace llama { namespace detail { ... } }块中。 - 这既保持了全局命名空间污染的低水平,又保留了单个实现文件内的直接内存控制和静态可见性。
7.4. 极简的"零开销 C++"哲学
llama.cpp 遵循一种极简的 C++ 变体,通常被称为 "带类的 C"(C with Classes)或"面向数据的 C++"(Data-Oriented C++)。
- 代码库有选择地使用标准 C++ 特性(如
std::vector、std::string或std::thread)来简化内存管理和并发,同时避免深度嵌套的命名空间、繁重的模板元编程或复杂的类继承体系。
8. 模板的使用
在 C++ 中,通过模板进行泛型编程可以编写可重用、类型安全的算法和数据结构,而不会有运行时性能损失。通过在编译时生成代码,模板消除了间接寻址,允许深度编译器内联,并直接针对具体类型优化性能。
让我们探索 llama.cpp 中是否定义了模板:
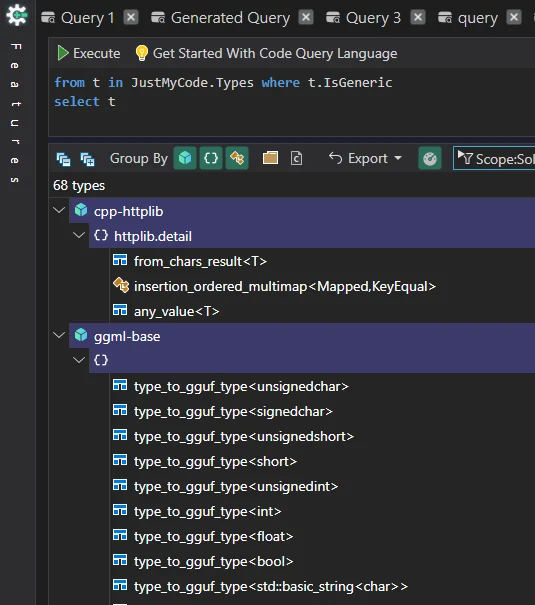
为了直观地探索模板定义的位置,我们可以将查询结果导出到矩形树图视图:
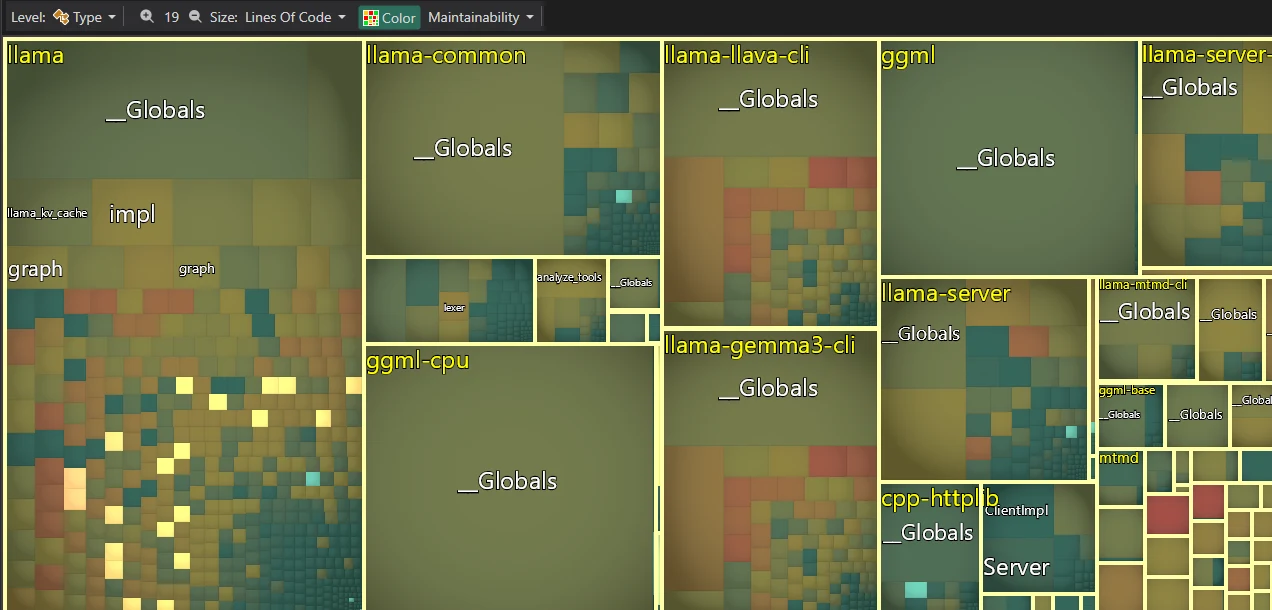
相关类型已高亮显示,如矩形树图所示,它们定义在少数几个库中,特别是 llama 库。
llama.cpp 没有依赖模板繁重的 C++ 泛型,而是出于具体的工程原因选择了 C 风格的过程式代码、通过枚举(ggml_type)的动态分发和宏:
8.1. 消除模板代码膨胀(二进制体积膨胀)
当你跨多种数据类型(例如 float、fp16、int8、int4)实例化 C++ 模板时,编译器会为每种类型排列组合生成一份单独的机器码副本。
- 指令缓存未命中:重复的模板实例化函数会使最终二进制可执行文件体积膨胀。大二进制文件会给 CPU 指令缓存(I-Cache)带来压力,导致缓存未命中,从而减慢执行循环。
- 过程式代码共享:ggml 使用显式枚举分发(
switch (type))来共享单一实现入口点,而不是用模板化函数膨胀代码段。
8.2. 大幅减少编译时间
繁重的 C++ 模板元编程会严重增加构建时间,因为头文件必须在各个翻译单元中反复解析、展开和编译。
- 通过使用扁平的 C 结构体(
struct ggml_tensor)、基本的枚举标志(GGML_TYPE_F32、GGML_TYPE_Q4_0)和普通的 C 头文件,llama.cpp 的编译只需几秒钟——即使在 Raspberry Pi 或低配置笔记本等慢速设备上也是如此——而重度模板化的 C++ 库(如 PyTorch C++ 或 Eigen)可能需要 20 分钟以上的构建时间。
8.3. 动态运行时类型 vs 静态编译期泛型
在机器学习运行时中,张量数据类型、维度和执行图通常在运行时确定(例如加载具有混合 Q4_K_M 和 Q8_0 量化的 GGUF 模型)。
- C++ 模板要求类型在编译时固定。
- 如果 ggml 依赖 C++ 泛型来处理张量类型,每种模型类型组合都需要预编译到巨大的模板矩阵中,或者代码将不得不诉诸大规模的模板展开块。
- 使用运行时类型枚举(
ggml_tensor->type = GGML_TYPE_Q4_K)允许单一、统一的 C 结构在内存中动态表示任何张量类型,而无需模板参数。
8.4. 简化的 GPU 与 SIMD 加速器后端
llama.cpp 将张量计算卸载到不同的硬件后端(CUDA、Metal、Vulkan、OpenCL、AVX-512、ARM NEON)。
- 为 GPU 编写设备内核或原始 SIMD 内在函数需要对底层汇编布局、内存对齐和寄存器使用进行细粒度控制。
- 将内部 SIMD/GPU 循环抽象在复杂的 C++ 泛型模板之后,会使检查生成的汇编、调试向量对齐问题或优化特定硬件的 SIMD 寄存器变得明显更加困难。
架构对比总结
| 特性 | 泛型模板(template<typename T>) | llama.cpp 动态枚举(ggml_type) |
|---|---|---|
| 类型决策 | 编译期 | 运行时 |
| 二进制体积 | 按类型膨胀(臃肿) | 单一过程式实现(精简) |
| 编译速度 | 慢(繁重的头文件解析) | 极快 |
| 硬件内省 | 被抽象层遮蔽 | 直接的 C / SIMD 寄存器控制 |
9. 关于设计选择的一些事实
9.1. 方法过多的类型
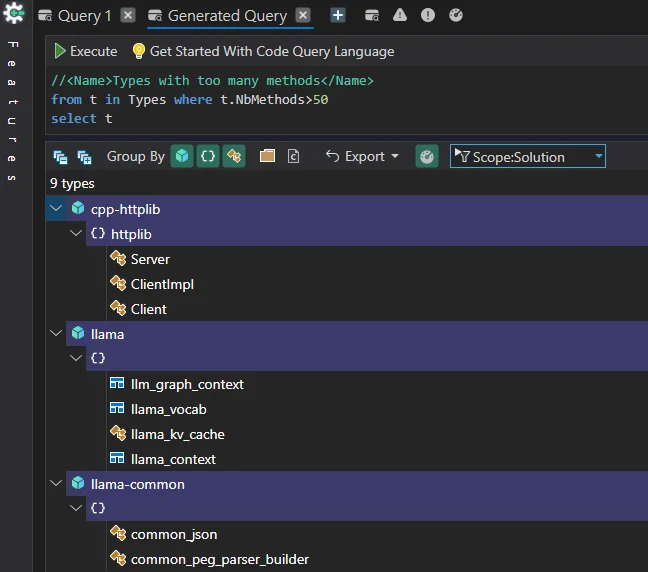
少数类型拥有大量方法,但在 llama.cpp 中,每种情况都有合理的工程原因。例如,以下是此类类型在 HTTP 库中被预期出现的原因:
- 自包含的单头文件架构:cpp-httplib 被有意设计为单头文件 HTTP 库,便于跨平台嵌入。为了保持第三方集成的简单性并避免复杂的依赖图,协议特性直接封装在主要的客户端和服务器抽象中。
- 流畅且对开发者友好的 API:完整的 HTTP 客户端或服务器自然需要广泛的方法集来处理各种请求选项、头部、超时和回调,而不会迫使最终用户连接单独的底层处理程序对象。
- 内部委托模式:httplib::Client 将其核心工作委托给 httplib::ClientImpl。虽然 ClientImpl 累积了底层 socket、SSL 和传输逻辑,但这种分离干净地保护了公共 Client API 免受内部平台特定细节的影响。
9.2. 内聚性不足的类型
类型内聚性(或面向对象编程中的类内聚性)衡量单个类型的职责、字段和方法之间的紧密相关性和专注程度。
让我们探索 llama.cpp 中有多少个内聚性不足的类型:
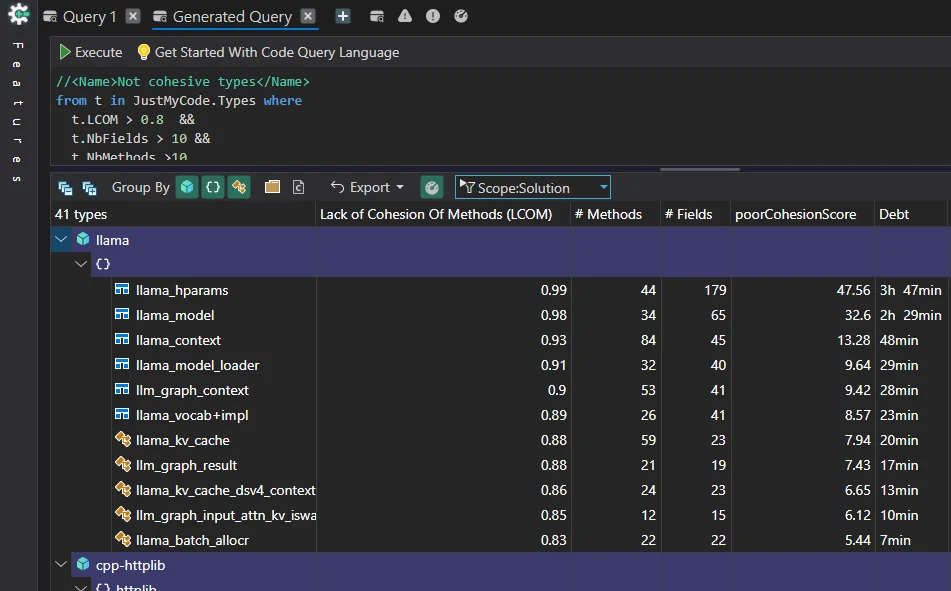
为什么低内聚性对某些模型元数据是有意为之
- POD / DTO 数据模式:
llama_hparams充当数据传输对象(DTO)或 C 风格结构体,而不是有状态的面向对象领域类。它的唯一职责是保存从 GGUF 元数据头解析出的完整模型超参数状态。 - 统一的模型架构表示:现代 Transformer 架构(Llama、Mistral、Gemma、Qwen)需要大量的配置标志。将这些设置分组到单个统一的超参数结构体中,可以保证张量分配例程、KV 缓存计算器和执行图在单个内存块中接收完整的模型元数据。
- 数据与执行逻辑解耦:在 C/C++ 引擎设计中,数据结构(
llama_hparams)与处理算法(ggml 计算图)保持解耦。对被动数据结构强制实施 OOP 风格的内聚性规则会增加不必要的抽象开销,而不会提高性能或安全性。
9.3. 过大的方法
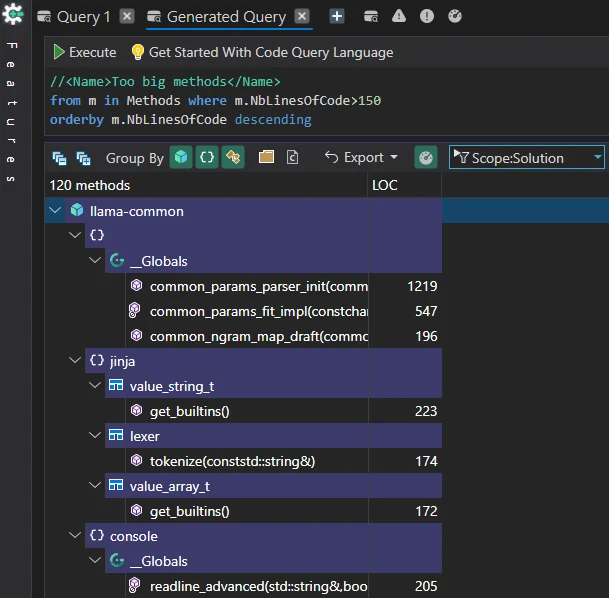
在 llama.cpp 这样的高性能 C++ 代码库中,某些设计模式——例如中央配置调度器或大规模的硬件执行 switch——是完全可预期且实用的。
案例研究:common_params_parser_init
CppDepend 因其高行数和圈复杂度而标记了 common_params_parser_init(位于 llama-common 中):
- 静态分析标记它的原因:它在一个地方包含了数十个命令行标志定义、参数解析块、帮助字符串格式化规则和回退默认值。
- 为什么这是正常的工程实践:大型 ML 模型的 CLI 参数解析器自然会累积数百个参数(
--n-gpu-layers、--ctx-size、--temp、--rope-scaling等)。将这个初始化拆分为数十个微小的辅助函数会碎片化参数定义并降低代码可读性,而不会带来真正的架构收益。
9.4. 未注释的大方法
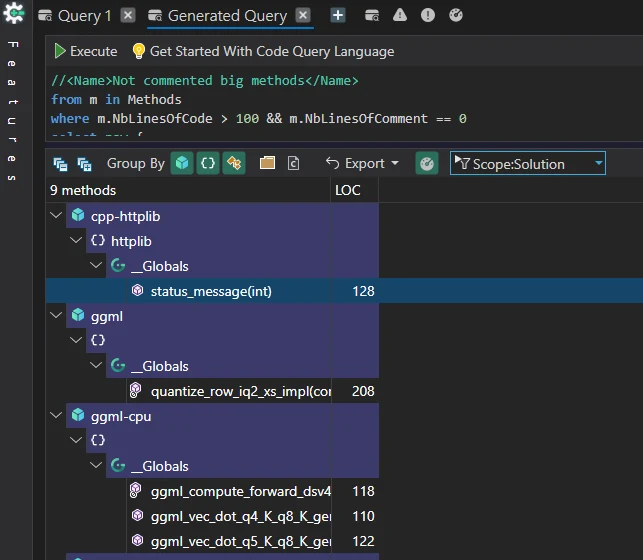
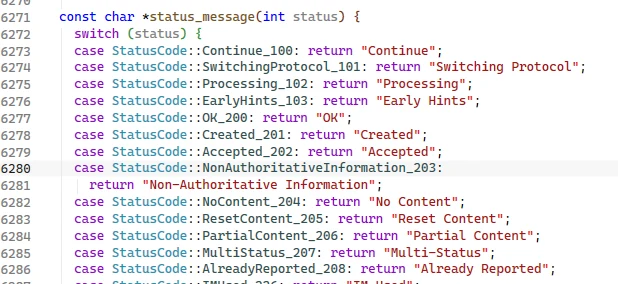
虽然有一些大型的未注释方法,但仔细观察 status_message 这样的函数会发现注释是不必要的,因为代码本身就不言自明。
结论:超越 Linter 的工程之道
通过静态代码分析来研究 llama.cpp 揭示了一种迷人的二元性。在微观层面,函数长度指标和圈复杂度警告会触发传统的"代码异味"警报。然而在宏观层面,该架构展现了非凡的结构纪律性——由严格的层隔离、零循环依赖和清晰的 GRASP 对齐模块解耦所驱动。
llama.cpp 证明了世界级的 C++ 性能并不在于教条地遵守 OOP 设计模式或安全关键的 linter 规则。它在于做出有意的工程权衡:在热点执行路径中牺牲微观层面的优雅,以实现最大的指令缓存局部性、零开销的硬件分发和锐利的执行速度。