現代のソフトウェア工学では、開発者は単一の言語パラダイムに厳密に従うように教えられることが多い。純粋なオブジェクト指向 C++、厳格な関数型プログラミング、あるいはモノリシックな C API である。
llama.cpp の並外れた成功は、異なるテーゼを証明している:実用主義は教義に勝る。
プロジェクト全体に統一されたデザインパターンを強制するのではなく、llama.cpp は階層構造として構築されており、各層は低レベルの C メモリアリーナから最新の C++ 抽象化に至るまで、特定の問題領域に最適なパラダイムで意図的に設計されている。
CppDepend を使って llama を分析し、llama.cpp の全体的なコード品質を探ってみよう:
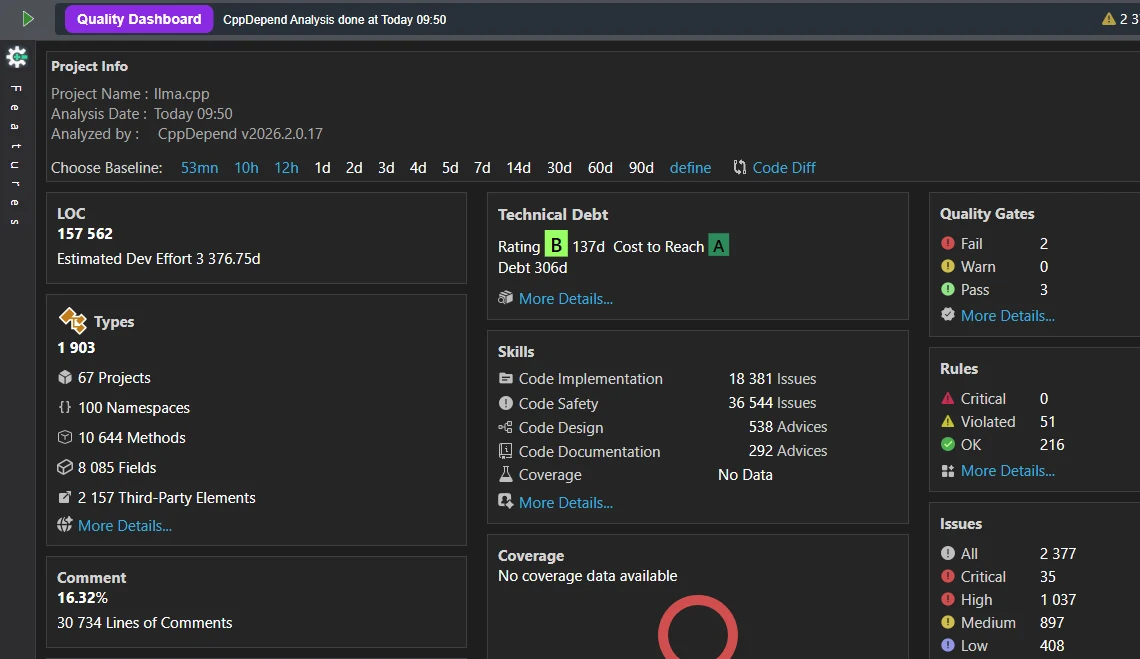
このプロジェクトは、全体的なコード品質と技術的負債において B 評価を達成しており、十分に構造化されたアーキテクチャと比較的低い技術的負債密度を示している。
1. Code City として llama.cpp を探索する
サマリーダッシュボードを評価した後、Code City 機能を使って、コードのどこを改善できるかを視覚的に探索できる。コードベースを 3D Code City として可視化することで、結合度、ホットスポット、コードスメル、メソッドサイズ、問題の分布について即座に視覚的な洞察が得られる。
この Code City では、各ビルがメソッドを表し、色は健全性と問題の深刻度を示す。ビルにホバーすると、詳細な診断メトリクスが表示される。
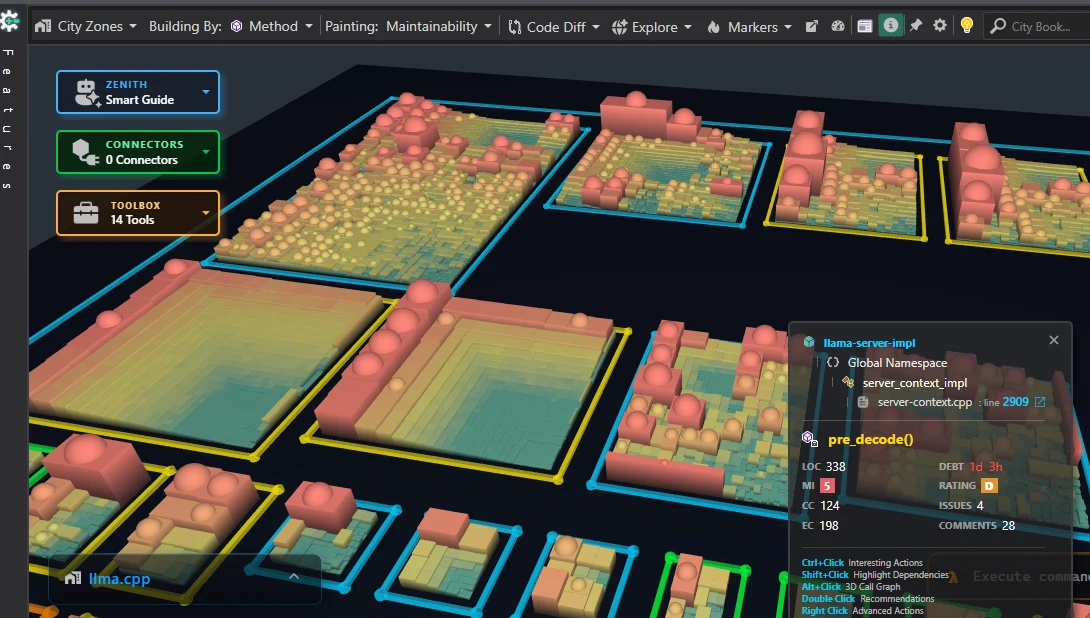
多くのメソッドが赤くハイライトされているが、よく見るとそれらは一般的にコードスメルである。Issues Explorer が示すように、多くのコードスメルが検出されている:
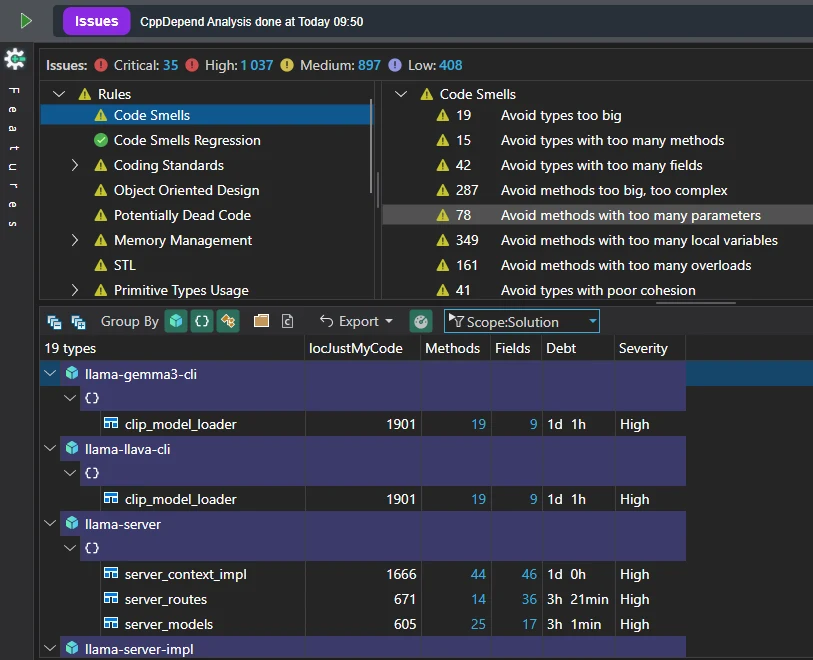
設計が意図的であっても、これらの関数がコードスメル警告をトリガーする理由をいくつか挙げる:
1.1. インライン化とキャッシュ局所性(関数呼び出しオーバーヘッドの回避)
低レベルの SIMD および行列演算カーネルでは、500 行のループを 10 個の小さなヘルパー関数に分割すると実行効率が損なわれる:
- レジスタスピルと命令オーバーヘッド:関数呼び出しはレジスタをスタックにプッシュし、ジャンプ命令を生成する。毎秒数十億回実行されるタイトなループ(内部の量子化 GEMM ループなど)では、関数呼び出しのオーバーヘッドがパフォーマンスを大幅に低下させる。
- 命令キャッシュラインのヒット:単一のモノリシックなループは、ホットな実行命令を CPU の命令キャッシュ(I-Cache)または GPU 共有メモリ内で連続させ、パイプラインストールを防ぐ。
1.2. 集中ディスパッチによる大規模モデルサポート
llama.cpp は、モノリシックなグラフ構築関数(例:llama_build_graph)内で数十のモデルアーキテクチャ(Llama、Mistral、Gemma、Mixtral、DeepSeek、Command R)をサポートしている。
- 網羅的なアーキテクチャ switch ブロック:複雑な C++ オブジェクト指向継承階層(例:
class LlamaModel : public ModelBase)を使用する代わりに、llama.cpp はモデルアーキテクチャ enum に対する巨大な switch 文を使用している。 - トレードオフ:静的アナライザーはその巨大さゆえにこれらを「Brain Methods」や「God Functions」としてフラグを立てるが、この手続き型レイアウトはグラフノード構築を完全に透過的に保ち、1 つの連続したコードブロックで可視化する。
1.3. 量子化型の爆発(ggml_type switch ループ)
単一の数学演算(テンソル乗算など)は、F32、F16、Q4_0、Q4_K_M、Q8_0、IQ3_XXS などの組み合わせを処理しなければならない。
// Common pattern triggering complexity warnings in GGML
switch (tensor->type) {
case GGML_TYPE_Q4_0: /* SIMD unroll for Q4_0 */ break;
case GGML_TYPE_Q4_K: /* SIMD unroll for Q4_K */ break;
case GGML_TYPE_Q8_0: /* SIMD unroll for Q8_0 */ break;
// ... 20+ quantization types unrolled directly in line
}各量子化型には独自のブロックレイアウトとベクトル逆量子化演算があるため、これらのループには循環的複雑度メトリクスを急上昇させる大規模なネストブロックが含まれている。
1.4. 急速なオープンソースの進化(「ハッカー C」文化)
llama.cpp は単一ファイルの C++ 概念実証から大規模なコミュニティプロジェクトへと進化した:
- 機能統合の速度:新しい論文やモデルアーキテクチャが公開されると(カスタム RoPE 埋め込みや MoE のエキスパートルーティングなど)、貢献者は既存のグラフ構築関数に直接実行ブランチを追加する。
- 抽象化よりも実用主義:このプロジェクトは、厳格な OOP デザインパターンよりも、生の実行速度と単一ファイルでの変更の容易さを意図的に優先している。
2. llama.cpp:GRASP パターンを使いこなす技術
llama.cpp は、個別のワークスペースモジュールにわたって GRASP(General Responsibility Assignment Software Patterns)の原則を適用し、コアの責任を分離しながら、実行時の強い結合を回避している。
2.1. 高レベルのモジュラー分解(GRASP Scope)
巨大なモノリシックな実行ファイルを構築する代わりに、プロジェクトは機能を個別のモジュールに分割している:
2.2. GRASP 原則が分離を推進する仕組み
高凝集性と単一責任(SRP)
- ggml(テンソルランタイム):テンソル構造(
ggml_tensor)、メモリ割り当てアリーナ、計算グラフ構築(ggml_cgraph)、バックエンドオーケストレーションのみに特化。LLM トランスフォーマー、トークン化、プロンプトフォーマットについては一切認識していない。 - libllama(include/llama.h、src/llama.cpp):トランスフォーマーのメカニズム、GGUF ファイルの読み込み、KV キャッシュの割り当て、シーケンスサンプリングを管理。行列演算は完全に ggml に委譲する。
- common(llama-common / common/):横断的な CLI ユーティリティ、引数パース、コンソールログ、CPU アフィニティ、ベンチマーク、投機的実行ロジックをカプセル化。コアエンジンのコンシューマーは common に依存せず、libllama を直接リンクできる。
Information Expert
- ハードウェアバックエンド(ggml-cuda、ggml-metal、ggml-vulkan):各バックエンドは、そのハードウェアターゲット上でテンソル演算を実行する唯一のエキスパートとして機能する。ハードウェアの詳細が llama.cpp や高レベルのアプリケーションコードに漏れることはない。
Protected Variations と低結合
- 純粋な C API 境界(include/llama.h):高レベルのアプリケーションは、C スタイルのハンドル(
llama_model*、llama_context*)を通じてのみエンジンと対話する。これによりアーキテクチャ上のファイアウォールが生まれ、llama.cpp の内部実装全体を、下流のツールやバインディング(Python、Node.js、Rust)を壊すことなくリファクタリングできる。
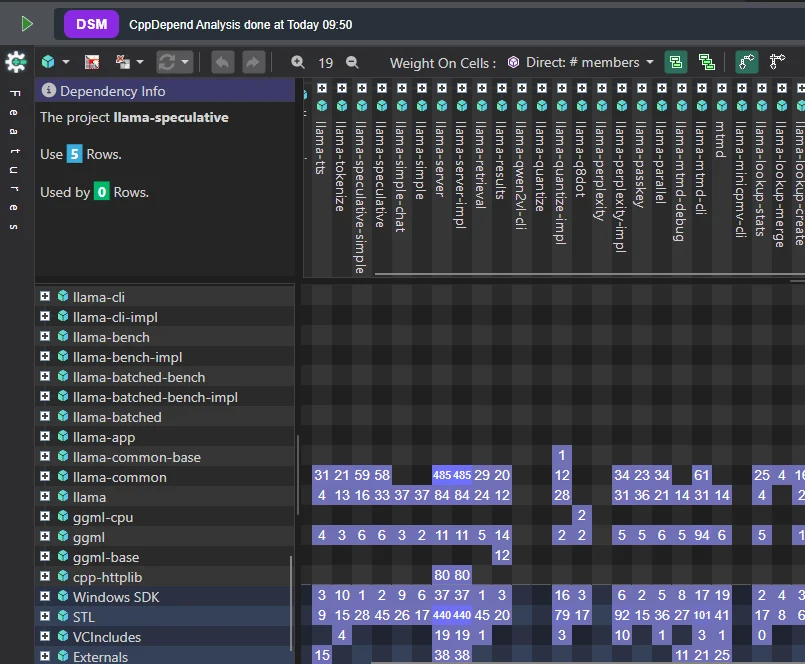
2.3. 依存関係マトリクスの洞察:「ブロック対角」パターン
このマルチプロジェクト構成を Dependency Structure Matrix(DSM)で評価すると:
- クリーンなブロック分離:マトリクスは ggml、llama、common に対応する明確な対角ブロックとして描画される。
- 不要なクロストークなし:ggml コンポーネントは llama.cpp や common を参照しない。llama コンポーネントは ggml に依存するが、高レベルの CLI コードを完全に認識していない。
- プラガブルアーキテクチャ:common/ と tools/ を取り除き、最小限のフットプリントで libllama を組み込みランタイムやデスクトップアプリケーションに直接リンクできる。
3. コードベースの抽象化の定量化
抽象型は、クリーンで分離重視の設計を実現するために最新の C++ で広く使用されているが、llama.cpp もそうだろうか?このクエリを使ってコードベース全体の抽象型を検索してみよう:
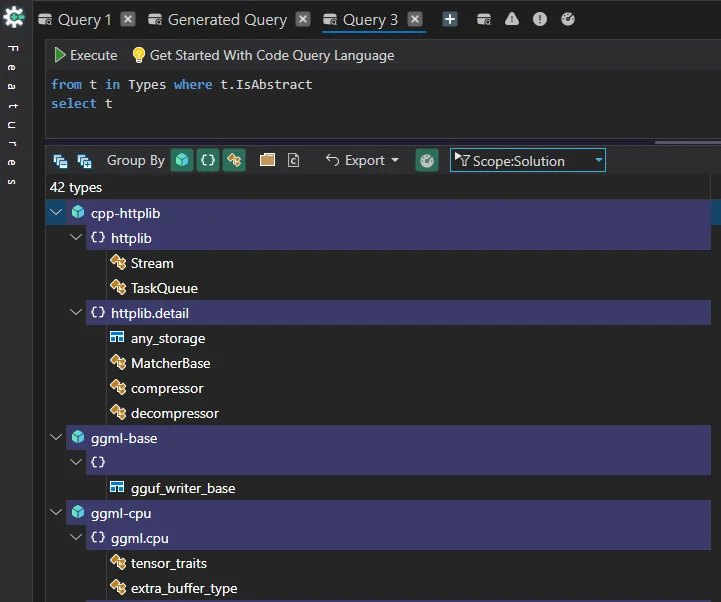
抽象型はごくわずかで、llama.cpp は抽象基底クラス、動的ディスパッチ(仮想関数)、深い継承階層といった古典的なオブジェクト指向プログラミング(OOP)パラダイムを意図的に回避している。
この設計上の選択は、4 つのコアエンジニアリングトレードオフに起因する:
3.1. vtable ペナルティと間接参照の排除
高性能 C++ では、仮想関数呼び出しは仮想テーブル(vtable)での関数ポインタの検索を必要とする。
- キャッシュミスとポインタチェイシング:深いテンソルグラフの実行ループで毎秒数千回の仮想呼び出しを行うと、分岐予測ミスが発生し、CPU パイプラインがストールする。
- インライン化のブロッカー:コンパイラは、コンパイル時に具象型が不明なため、仮想メソッド呼び出しをインライン化できないことが多い。プレーンな C 構造体、明示的な関数ポインタ、静的テンプレートを使用することで、コンパイラはコードを生のアセンブリループイテレーションに直接インライン化できる。
3.2. 多態ポインタストレージよりも予測可能なメモリレイアウト
抽象クラスは、動的ディスパッチをサポートするためにポインタまたはスマートポインタ(std::unique_ptr<ITensor>)での作業を強制する。
- ポインタはヒープ割り当て(malloc/new)につながり、ヒープ全体でメモリが断片化する。
- ggml(基盤となるテンソルエンジン)は、フラットで連続した bump 割り当てアリーナ(
ggml_context)に依存している。メモリオフセットは実行開始前に単一の静的グラフレイアウトに事前計画されている。標準的な OOP 抽象化は連続したメモリレイアウトを破壊し、L1/L2 キャッシュ局所性を損なう。
3.3. C / 外国語バインディング間の ABI 安定性
llama.cpp は、Python(llama-cpp-python)、Rust、Go、Swift、C#、Node.js に埋め込まれ、どこでも実行されることを意図している。
- 仮想テーブルを持つ最新の C++ クラス階層は、GCC、Clang、MSVC 間で異なるコンパイラマングリングされたシンボル名を持つ。
- フラットな C スタイル構造体(
struct llama_model、struct llama_context)と C 関数(llama_decode())を使用することで、llama.cpp はクリーンな C ABI 境界を公開する。どの言語も、複雑な C++ ランタイムラッパーを必要とせずに、標準的な C ヘッダーを利用できる。
3.4. シンプルな計算グラフアーキテクチャ vs オブジェクトグラフ
標準的なソフトウェアアプリケーションでは、多態性はビジネスエンティティをモデル化する(例:class Dog : public Animal)。LLM 推論エンジンでは、ドメインモデルは静的計算グラフとテンソルで構成される:
- モデルアーキテクチャは、テンソル数学ノード(
ggml_mul_mat、ggml_add)のシーケンスとして表現され、深いオブジェクトツリーではない。 - バックエンド間のバリエーション(CUDA、Metal、Vulkan、CPU SIMD)は、すべての演算を多態ランタイムラッパーで包むのではなく、静的バックエンドディスパッチ、enum フラグ、コンパイル時実行パイプラインで処理される。
アーキテクチャトレードオフのまとめ
| デザインパターン | OOP / 抽象クラス | llama.cpp C スタイル / 手続き型 |
|---|---|---|
| ディスパッチメカニズム | 動的(vtable 検索) | 静的 / 直接 C 関数ディスパッチ |
| メモリ割り当て | ヒープポインタ(new/malloc) | 連続した事前割り当てアリーナ(ggml_context) |
| コンパイラ最適化 | 制限あり(仮想呼び出しがインライン化をブロック) | 最大(ホットな SIMD ループを容易にインライン化) |
| 言語間相互運用 | 困難(複雑な C++ バインディングが必要) | 容易(標準 C ABI を公開) |
4. Llama モデルでの POD 型の使用
C++ の POD(Plain Old Data)型は、最新の C++ オブジェクト指向のオーバーヘッドなしにデータを保持する、シンプルで C 互換のデータ構造である。
このコードクエリを使って、llama.cpp で使用されている POD 型を検索してみよう:
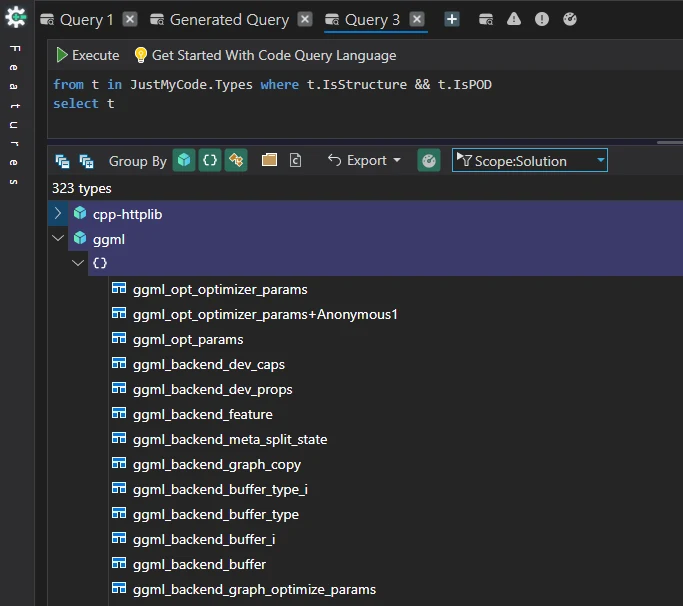
llama.cpp があらゆる場所でシンプルな POD 構造体を使用する理由は次のとおり:
4.1. 予測可能な C 互換メモリレイアウト
C++ の POD 構造体は、隠れたコンパイラ挿入ポインタ(仮想関数用の vptr など)のない、連続した決定論的なメモリフットプリントを持つ。
- 直接シリアライズ/デシリアライズ:GGUF モデルファイルを読み込む際、POD 構造により、生バイトをディスクからメモリへ(fread または mmap)構造体に直接読み込むことができ、複雑なパース、コンストラクタ、オブジェクト割り当てが不要になる。
- C ABI 互換性:POD 構造体は標準 C データ構造に 1:1 で対応する。これにより、非 C++ 言語(Python、Rust、Go、Swift、C#)がマーシャリングオーバーヘッドなしで、まったく同じ構造体レイアウトをメモリにマッピングできる。
4.2. 極限のキャッシュ局所性(L1/L2 キャッシュ効率)
最新の CPU はメイン RAM よりも数千倍高速に動作する。LLM 推論のパフォーマンスは、CPU/GPU パイプラインにデータを供給し続けることに大きく依存する。
- 連続配列:POD 型は内部に隠れたオーバーヘッドやヒープポインタを持たないため、フラットで連続した配列(
std::vector<llama_token_data>や生のメモリアリーナ)にタイトにパックできる。 - シーケンシャルキャッシュプリフェッチ:トークンサンプリングや KV キャッシュ管理中に連続した POD 構造体の配列を反復処理すると、ハードウェアプリフェッチャーはループが要求する前に次の要素を L1/L2 キャッシュに容易にロードする。
4.3. カスタムアリーナアロケータとの互換性(ggml)
非トリビアルなコンストラクタ/デストラクタを持つ標準 C++ オブジェクトは new と delete を必要とし、ヒープ全体に動的にメモリを割り当てる。
- ヒープ割り当てはメモリ断片化と予測不可能な割り当てレイテンシを引き起こす。
- llama.cpp は
ggml_contextを介して bump/アリーナアロケータを使用する。生メモリは巨大なチャンクとして一度予約され、POD 構造体はこの事前割り当てメモリオフセットに直接配置される。POD はデストラクタを必要としないため、メモリの回収やリセットは、単一のポインタをゼロにリセットする(offset = 0)のと同じくらい高速である。
4.4. ゼロランタイムオーバーヘッドとトリビアルコピー
POD 構造体には、舞台裏で動作する隠れたロジックがない:
- POD 構造体のコピーやムーブは、単なる高速なメモリコピー操作(memcpy)である。
- POD 構造体を値または const 参照で渡しても、隠れたコピーコンストラクタやデストラクタ呼び出しは発生せず、開発者はホットな内部ループでの実行パフォーマンスを完全に制御できる。
5. 標準テンプレートライブラリ(STL)のフットプリントと使用状況
STL がどこでどのように使用されているかを確認するために、依存関係マトリクスを分析して、コードベース全体での使用状況の詳細ビューを取得できる。
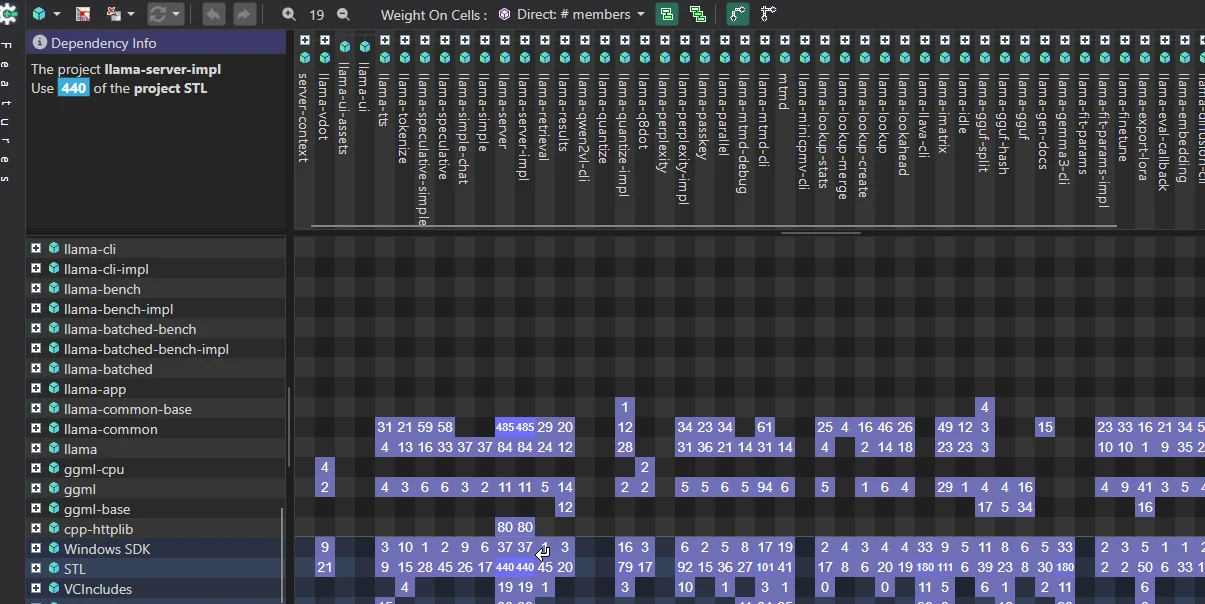
ご覧のとおり、STL は高レベルモジュールで多用されている一方、低レベルモジュールではほとんど使用されていない。
5.1. llama-server:複雑なオーケストレーションには高レベルの抽象化が必要
llama-server は、マルチスレッド、非同期 I/O、スロット管理、JSON パース、キューイング、HTTP 状態を処理する HTTP API デーモンである。
低レベルの手続き型 C/C++ でネットワークオーケストレーションコードを書くのは非現実的なため、標準ライブラリの機能(std::*)を多用している:
- 並行性と同期:
std::thread、std::mutex、std::condition_variable、std::future、std::atomicが受信 Web リクエストを管理し、推論タスクをキューに入れる。 - 複雑なデータ構造:
std::unordered_map、std::queue、std::map、std::vectorがマルチテナントセッションスロット、コンテキスト状態、トークンシーケンスを処理する。 - 文字列処理とフォーマット:
std::string、std::stringstream、正規表現操作が OpenAI 互換 REST エンドポイントの JSON 入出力をフォーマットする。
5.2. コアエンジン(ggml と llama):生のパフォーマンスのための STL 回避
対照的に、ggml とコア llama の低レベル推論コードは、パフォーマンス上の重要な理由から STL の深い使用を避けている:
- 非決定的割り当ての回避:
std::vectorやstd::stringのようなコンテナは、ヒープ上で動的にメモリを割り当て・再割り当てする(malloc/free)。ホットなテンソル行列乗算ループでは、動的割り当てが OS システムコールをトリガーし、テールレイテンシスパイクを引き起こす。ggml は代わりに静的に事前割り当てされたメモリアリーナ(ggml_context)を使用する。 - バイナリサイズとコンパイル速度:重い C++ STL テンプレート展開(
<iostream>、<regex>、<algorithm>)はバイナリサイズを大幅に膨張させ、コンパイル時間を遅くする。コア計算ファイルを最小限に保つことで、組み込みシステムや軽量マイクロランタイムでの高速コンパイルが可能になる。 - 最大のポータビリティとベアメタル実行:ggml は、リソース制約のあるプラットフォーム、WASM(Web ブラウザ)、マイクロコントローラー、カスタムハードウェアアクセラレータ上で動作し、完全な C++ 標準ランタイム環境が削減、欠落、または非効率な場合がある。
6. 例外の使用
コア C++ 例外は内部計算層(ggml と llama)では厳密に回避されているが、高レベルのヘルパーラッパー(llama-common、common/arg.cpp、llama-server)には例外が存在する。
このコードクエリを使って、どのモジュールが std::exception クラスを使用しているかを調べてみよう:
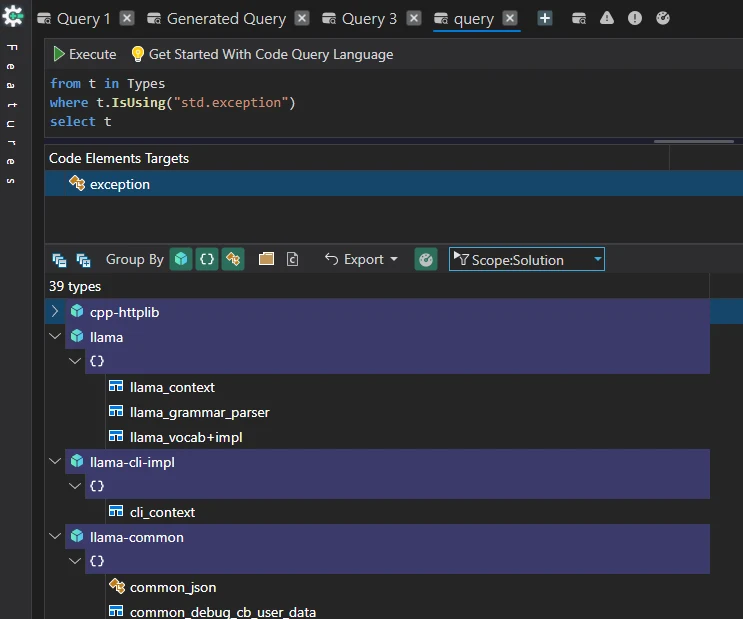
llama.cpp は、アーキテクチャ全体でエラー処理方法を厳密に分割している:
6.1. ggml とコア llama:C スタイルのエラーコードとアサーション
基盤層では、例外処理は意図的に省略されている:
- リターンコードと null ポインタ:
llama_decode()、llama_model_load()、内部割り当てルーチンなどのメソッドは、std::exceptionをスローする代わりに、nullptr、整数エラーステータスコード(0、-1)、またはブールフラグを返す。 - 明示的なアサーション:回復不可能な不変条件チェック(テンソル次元の不一致やコンテキスト実行の範囲外など)は、スタックを巻き戻すのではなく、即座に中止するか安全にエラーをログするマクロアサーション(
GGML_ASSERT/assert())を使用する。 - C ABI 境界の安全性:llama.h が公開する主要なパブリック API は C ABI である。C 言語境界を越えて C++ 例外をスローすることは C++ では未定義動作であるため、コア関数は例外を決して逃がしてはならない。
6.2. 高レベルラッパー(llama-common と llama-server):選択的な C++ 例外
例外は、開発者の利便性のために高レベルツールに現れる:
- CLI 引数パース(arg.cpp):コマンドラインパラメータのパース時に
std::runtime_errorまたはstd::invalid_argumentをスローする(不正なフラグオプションや欠落したモデルパスなど)。 - サーバーとサードパーティライブラリ(llama-server):nlohmann::json や HTTP パーサーなどのライブラリを利用し、これらは不正なペイロードのパース中に自然に例外をスローする。これらはサーバーループの最上位の try/catch ブロック内でキャッチされる。
コア推論が例外を回避する理由
- ゼロスタックアンワインディングオーバーヘッド:例外を有効にする(-fexceptions)と、バイナリコードの膨張と隠れた制御フローパスが導入される。ホットループで例外を無効化または回避することで、SIMD 実行パイプラインとコンパイラ最適化を積極的に保つ。
- 決定論的制御フロー:LLM 行列演算とメモリアリーナ(
ggml_context)は明示的なクリーンアップを必要とする。スローされた例外は、非 RAII カスタムアリーナデストラクタを容易にバイパスし、大規模な GPU/CPU メモリリークにつながる可能性がある。 - 言語間の安全性:言語バインディング(Python、Rust、C#、Go)は、独自のネイティブ言語ランタイム内で例外をクリーンにマッピングするために、シンプルな C スタイルのリターンコードを期待する。
7. 名前空間の使用
最新の C++ では、名前空間はコードを論理グループに整理し、ライブラリ間の名前衝突を防ぐためのスコープ境界である。
llama.cpp で名前空間が広く使用されているかを探ってみよう:
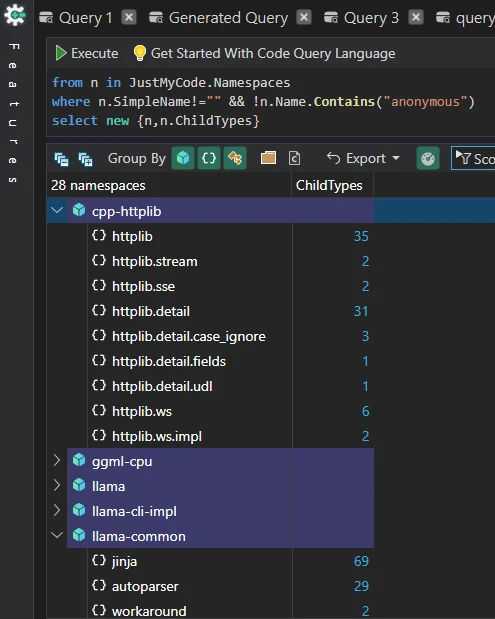
名前空間は cpp-httplib と llama-common で顕著だが、残りのライブラリでは事実上存在しない。このパターンの理由をいくつか挙げる:
7.1. コアエンジン(ggml)は純粋な C
llama.cpp の基盤は ggml テンソル評価ライブラリである。ggml は、ハードウェアバックエンド(CPU、CUDA、Metal、Vulkan、OpenCL)間でポータブルなランタイム実行を確保するために、標準 C(C99/C11)で書かれている。
- C は名前空間をサポートしていないため、ggml は関数と構造体に明示的な
ggml_プレフィックス(ggml_init、ggml_tensor、ggml_cgraphなど)を使用して、C++ 名前空間を必要とせずにシンボルを分離している。
7.2. ABI 安定性と C API 互換性
llama.cpp の主要な設計目標の 1 つは、他の言語(Python、Rust、Go、Java、Swift、C#)のバインディング用の埋め込み可能な軽量エンジンとして機能することである。
- C++ 名前マングリング:C++ 名前空間はコンパイル時にエクスポートされたシンボル名を変更する。
- dlopen や C FFI ラッパーとシームレスに動作するクリーンでマングリングされていないシンボルを公開するために、コアヘッダーはプレーンな C ABI(
extern "C")をエクスポートする。深い名前空間階層を避けることで、共有ライブラリ境界(llama.h、ggml.h)のエクスポートが簡素化される。
7.3. C スタイルのデータ構造と POD 型
llama.cpp は、オブジェクト指向 C++ 階層よりも、POD(Plain Old Data)構造体、静的関数、明示的な関数シグネチャを優先する。
- コードの分離は、コンポーネントをネストされた
namespace llama { namespace detail { ... } }ブロックで包むのではなく、.cpp ファイル内のコンパイルユニット(ファイルスコープの静的関数)で管理される。 - これにより、グローバル名前空間の汚染を低く抑えながら、個々の実装ファイル内での直接メモリ制御と静的可視性を維持できる。
7.4. ミニマリストの「ゼロオーバーヘッド C++」哲学
llama.cpp は、「C with Classes」または「Data-Oriented C++」と呼ばれることの多い、ミニマリストな C++ の変種に従っている。
- コードベースは、メモリ管理と並行性を簡素化するために標準 C++ 機能(
std::vector、std::string、std::threadなど)を選択的に使用する一方、深くネストされた名前空間、重いテンプレートメタプログラミング、複雑なクラス継承階層を回避している。
8. テンプレートの使用
C++ では、テンプレートによるジェネリックプログラミングにより、ランタイムパフォーマンスのペナルティなしに、再利用可能で型安全なアルゴリズムとデータ構造を記述できる。コンパイル時にコードを生成することで、テンプレートは間接参照を排除し、深いコンパイラインライン化を可能にし、具象型に対して直接パフォーマンスを最適化する。
llama.cpp でテンプレートが定義されているかを探ってみよう:
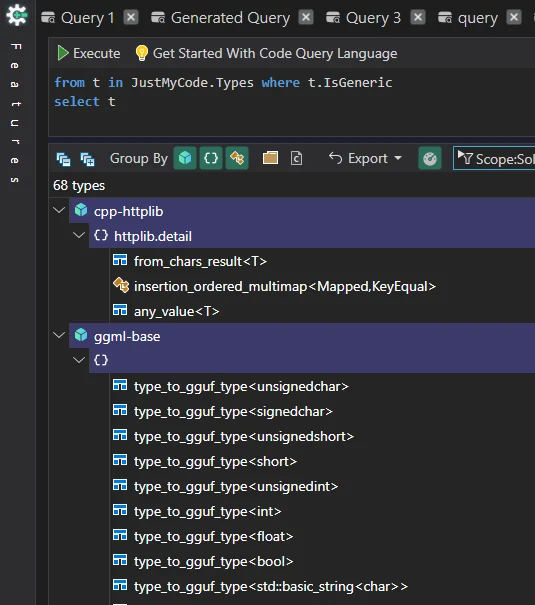
テンプレートがどこで定義されているかを視覚的に探索するために、クエリ結果をツリーマップビューにエクスポートできる:
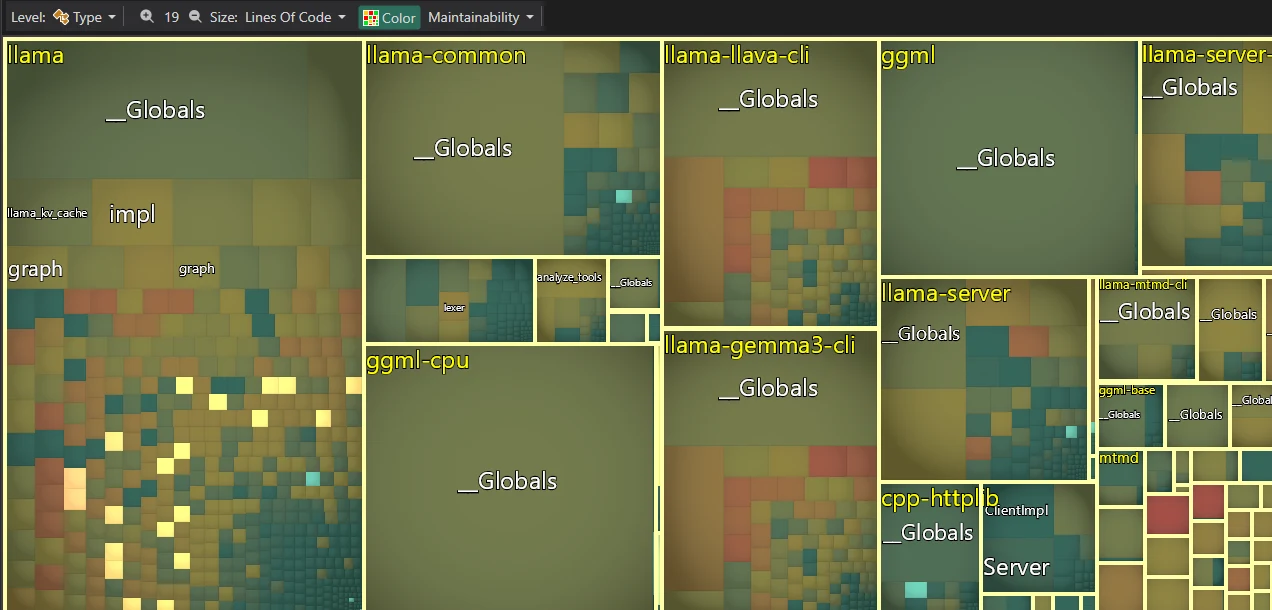
関連する型がハイライトされており、ツリーマップに示されているように、それらは少数のライブラリ、特に llama ライブラリで定義されている。
テンプレート中心の C++ ジェネリクスに依存する代わりに、llama.cpp は特定の工学的理由から、C スタイルの手続き型コード、enum(ggml_type)による動的ディスパッチ、マクロを選択している:
8.1. テンプレートコード膨張の排除(バイナリサイズの膨張)
複数のデータ型(float、fp16、int8、int4 など)にわたって C++ テンプレートをインスタンス化すると、コンパイラは型の組み合わせごとに機械コードの個別のコピーを生成する。
- 命令キャッシュミス:重複するテンプレートインスタンス化関数は、最終バイナリ実行ファイルサイズを膨張させる。大きなバイナリは CPU の命令キャッシュ(I-Cache)に負荷をかけ、キャッシュミスを引き起こして実行ループを遅くする。
- 手続き型コード共有:ggml は明示的な enum ディスパッチ(
switch (type))を使用して単一の実装エントリポイントを共有し、テンプレート化された関数でコードセグメントを膨張させない。
8.2. コンパイル時間の大幅な短縮
重い C++ テンプレートメタプログラミングは、ヘッダーを翻訳単位間で繰り返しパース、展開、コンパイルする必要があるため、ビルド時間を深刻に増加させる。
- フラットな C 構造体(
struct ggml_tensor)、基本的な enum フラグ(GGML_TYPE_F32、GGML_TYPE_Q4_0)、プレーンな C ヘッダーを使用することで、llama.cpp は数秒でコンパイルできる——Raspberry Pi や低スペックのラップトップのような低速デバイスでも——一方、重度にテンプレート化された C++ ライブラリ(PyTorch C++ や Eigen など)は 20 分以上のビルド時間がかかることがある。
8.3. 動的ランタイム型付け vs 静的コンパイル時ジェネリクス
機械学習ランタイムでは、テンソルデータ型、次元、実行グラフはしばしば実行時に決定される(混合 Q4_K_M と Q8_0 量子化を持つ GGUF モデルの読み込みなど)。
- C++ テンプレートは、型がコンパイル時に固定されていることを要求する。
- ggml がテンソル型に C++ ジェネリクスに依存していた場合、すべてのモデル型の組み合わせを巨大なテンプレートマトリクスに事前コンパイルするか、コードは大規模なテンプレート展開ブロックに頼らざるを得なくなる。
- ランタイム型 enum(
ggml_tensor->type = GGML_TYPE_Q4_K)を使用すると、単一の統一された C 構造がテンプレートパラメータなしで、メモリ内の任意のテンソル型を動的に表現できる。
8.4. 簡素化された GPU および SIMD アクセラレータバックエンド
llama.cpp は、テンソル計算を多様なハードウェアバックエンド(CUDA、Metal、Vulkan、OpenCL、AVX-512、ARM NEON)にオフロードする。
- GPU 用のデバイスカーネルや生の SIMD 組み込み関数を書くには、低レベルのアセンブリレイアウト、メモリアライメント、レジスタ使用に対する細粒度の制御が必要である。
- 内部 SIMD/GPU ループを複雑な C++ ジェネリックテンプレートの背後に抽象化すると、生成されたアセンブリの検査、ベクトルアライメント問題のデバッグ、ハードウェア固有の SIMD レジスタの最適化が大幅に困難になる。
アーキテクチャ対比のまとめ
| 機能 | ジェネリックテンプレート(template<typename T>) | llama.cpp 動的 enum(ggml_type) |
|---|---|---|
| 型決定 | コンパイル時 | 実行時 |
| バイナリサイズ | 型ごとに膨張(肥大化) | 単一の手続き型実装(スリム) |
| コンパイル速度 | 低速(重いヘッダーパース) | 非常に高速 |
| ハードウェアイントロスペクション | 抽象化レイヤーによって曖昧化 | 直接的な C / SIMD レジスタ制御 |
9. 設計上の選択に関するいくつかの事実
9.1. メソッドが多すぎる型
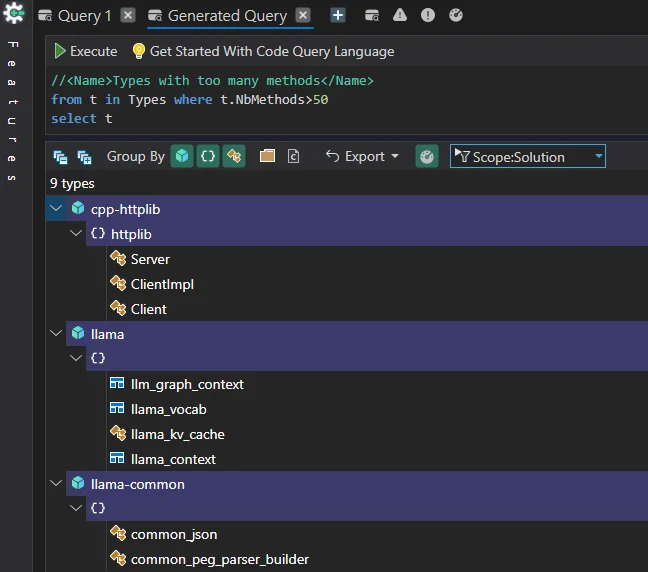
少数の型は多数のメソッドを持っているが、llama.cpp では各ケースに正当な工学的理由がある。例えば、HTTP ライブラリでこのような型が期待される理由は次のとおり:
- 自己完結型ヘッダーオンリーアーキテクチャ:cpp-httplib は、クロスプラットフォームへの容易な埋め込みのために、意図的にシングルヘッダー HTTP ライブラリとして設計されている。サードパーティ統合をシンプルに保ち、複雑な依存グラフを避けるために、プロトコル機能は主要なクライアントおよびサーバー抽象化内に直接カプセル化されている。
- 流暢で開発者フレンドリーな API:完全な HTTP クライアントまたはサーバーは、エンドユーザーに個別の基盤ハンドラーオブジェクトの配線を強制せずに、さまざまなリクエストオプション、ヘッダー、タイムアウト、コールバックを処理するための幅広いメソッドを自然に必要とする。
- 内部デリゲートパターン:httplib::Client はコアワークを httplib::ClientImpl に委譲する。ClientImpl は低レベルのソケット、SSL、トランスポートロジックを蓄積するが、この分離はパブリック Client API を内部のプラットフォーム固有の詳細からクリーンに保護する。
9.2. 凝集性の低い型
型凝集性(オブジェクト指向プログラミングのクラス凝集性)は、単一の型の責任、フィールド、メソッドがどれほど密接に関連し、集中しているかを測定する。
llama.cpp に凝集性の低い型がいくつあるかを探ってみよう:
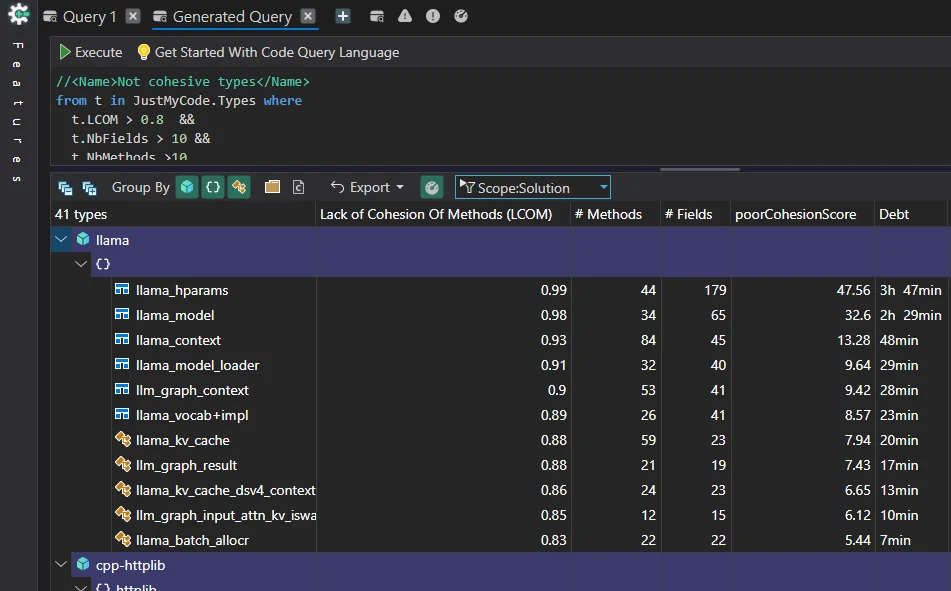
一部のモデルメタデータで低凝集性が意図的である理由
- POD / DTO データパターン:
llama_hparamsは、ステートフルなオブジェクト指向ドメインクラスではなく、Data Transfer Object(DTO)または C スタイル構造体として機能する。その唯一の責任は、GGUF メタデータヘッダーからパースされた完全なモデルハイパーパラメータ状態を保持することである。 - 統一されたモデルアーキテクチャ表現:最新の Transformer アーキテクチャ(Llama、Mistral、Gemma、Qwen)は、広範な設定フラグを必要とする。これらの設定を単一の統一ハイパーパラメータ構造体にグループ化することで、テンソル割り当てルーチン、KV キャッシュ計算機、実行グラフが単一のメモリブロックで完全なモデルメタデータを受け取ることが保証される。
- データと実行ロジックの分離:C/C++ エンジン設計では、データ構造(
llama_hparams)は処理アルゴリズム(ggml 計算グラフ)から分離されている。受動的なデータ構造に OOP スタイルの凝集性ルールを強制すると、パフォーマンスや安全性を向上させることなく、不要な抽象化オーバーヘッドが追加される。
9.3. 大きすぎるメソッド
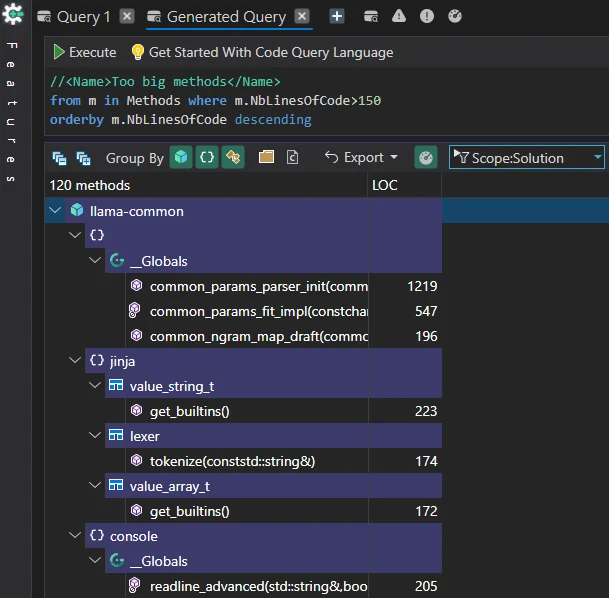
llama.cpp のような高性能 C++ コードベースでは、中央設定ディスパッチャーや大規模なハードウェア実行 switch などの特定のデザインパターンは、完全に予期され実用的である。
ケーススタディ:common_params_parser_init
CppDepend は、行数と循環的複雑度の高さにより common_params_parser_init(llama-common 内)にフラグを立てる:
- 静的解析がフラグを立てる理由:数十のコマンドラインフラグ定義、引数パースブロック、ヘルプ文字列フォーマットルール、フォールバックデフォルトが 1 か所に含まれている。
- これが通常のエンジニアリング慣行である理由:大規模 ML モデルの CLI 引数パーサーは、本来、数百のパラメータ(
--n-gpu-layers、--ctx-size、--temp、--rope-scalingなど)を蓄積する。この初期化を数十の小さなヘルパー関数に分割すると、パラメータ定義が断片化し、実際のアーキテクチャ上の利点を提供せずにコードの可読性が低下する。
9.4. コメントのない大きなメソッド
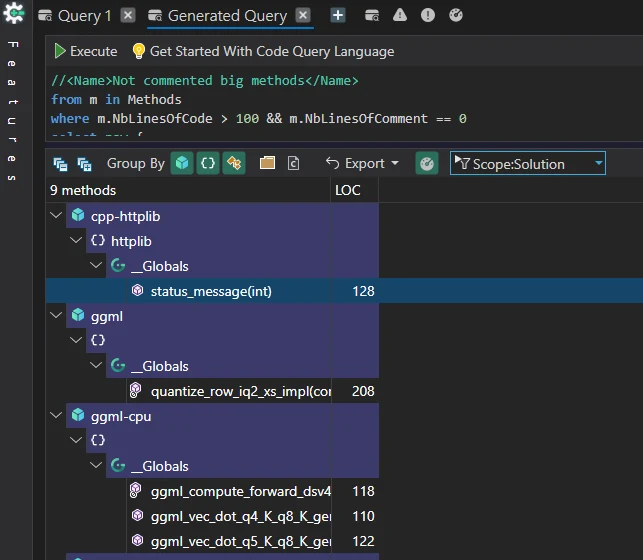
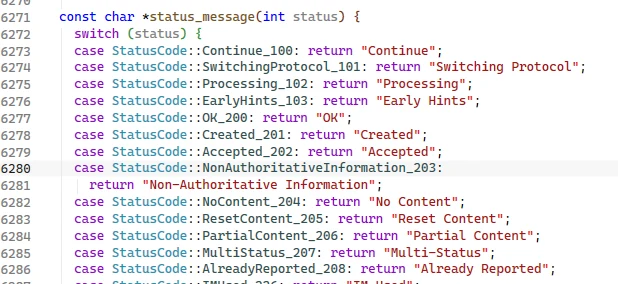
コメントのない大きなメソッドはいくつかあるが、status_message のような関数をよく見ると、コードは自己説明的であるためコメントは不要であることがわかる。
結論:Linter を超えたエンジニアリング
静的コード解析を通じて llama.cpp を分析すると、魅力的な二重性が明らかになる。ミクロレベルでは、関数長メトリクスと循環的複雑度警告が従来の「コードスメル」アラートをトリガーする。しかしマクロレベルでは、アーキテクチャは、厳密なレイヤー分離、ゼロの循環依存、クリーンな GRASP 準拠のモジュール分離によって駆動される、例外的な構造的規律を示している。
llama.cpp は、世界クラスの C++ パフォーマンスとは、OOP デザインパターンや安全重要な linter ルールに教条的に従うことではないことを証明している。それは意図的なエンジニアリングトレードオフを行うことである:最大の命令キャッシュ局所性、ゼロオーバーヘッドのハードウェアディスパッチ、鋭い実行速度を達成するために、ホットな実行パス内でミクロレベルの優雅さを犠牲にすることである。