In der modernen Softwareentwicklung lernen Entwickler oft, sich strikt an ein einziges Sprachparadigma zu halten: rein objektorientiertes C++, strikte funktionale Programmierung oder monolithische C-APIs.
Der außergewöhnliche Erfolg von llama.cpp beweist eine andere These: Pragmatismus schlägt Dogma.
Anstatt ein einheitliches Designmuster über das gesamte Projekt zu erzwingen, ist llama.cpp als geschichtete Hierarchie aufgebaut, in der jede Ebene bewusst mit dem Paradigma entwickelt wurde, das am besten zu ihrer jeweiligen Problemdomäne passt – von Low-Level-C-Speicherarenen bis hin zu modernen C++-Abstraktionen.
Analysieren wir llama mit CppDepend und erkunden die allgemeine Codequalität von llama.cpp:
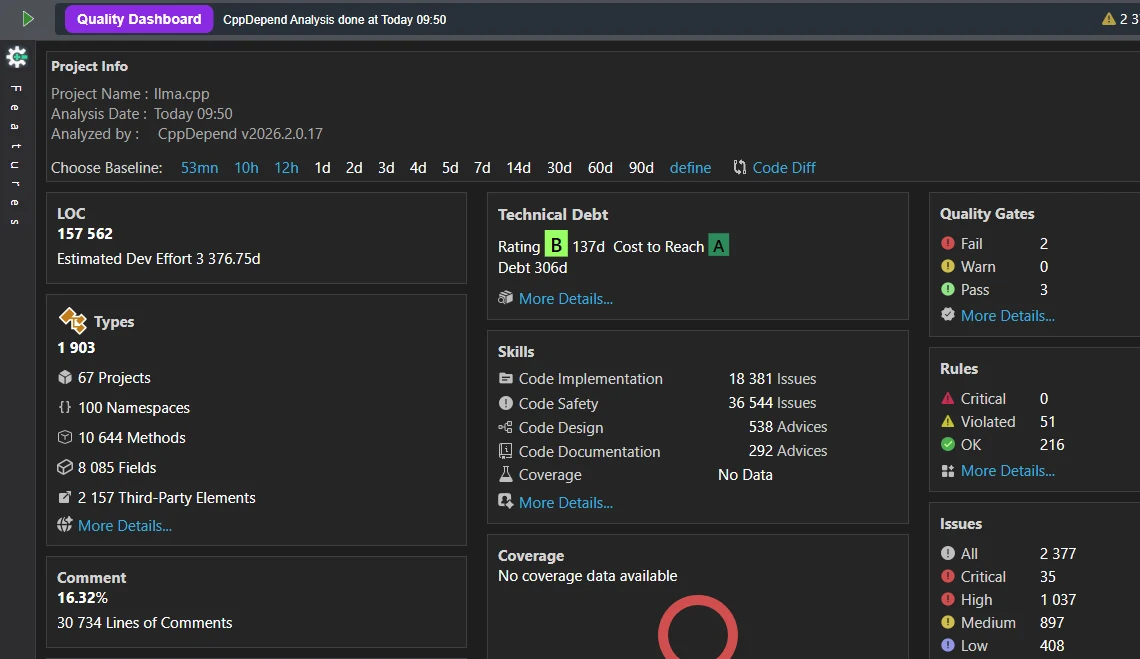
Das Projekt erreicht eine B-Bewertung für die allgemeine Codequalität und technische Schulden und demonstriert damit eine gut strukturierte Architektur mit relativ geringer technischer Schulddichte.
1. llama.cpp als Code City erkunden
Nach der Auswertung des Zusammenfassungs-Dashboards können wir mit der Code-City-Funktion visuell erkunden, wo der Code verbessert werden kann. Die Visualisierung der Codebasis als 3D-Code-City liefert sofortige visuelle Einblicke in Kopplung, Hotspots, Code Smells, Methodengrößen und die Verteilung von Problemen.
In dieser Code City repräsentiert jedes Gebäude eine Methode, während die Farbe den Gesundheitszustand und die Schwere der Probleme anzeigt. Wenn man mit der Maus über ein Gebäude fährt, erhält man detaillierte Diagnosemetriken.
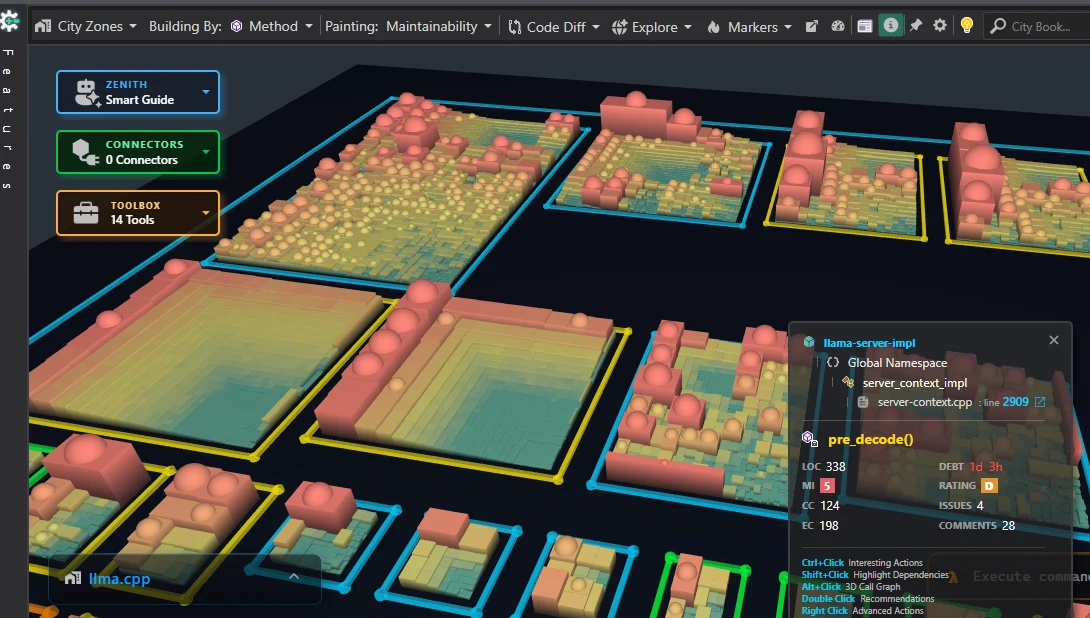
Obwohl viele Methoden rot hervorgehoben sind, zeigt ein genauerer Blick, dass es sich dabei im Allgemeinen um Code Smells handelt. Wie der Issues Explorer zeigt, werden viele Code Smells erkannt:
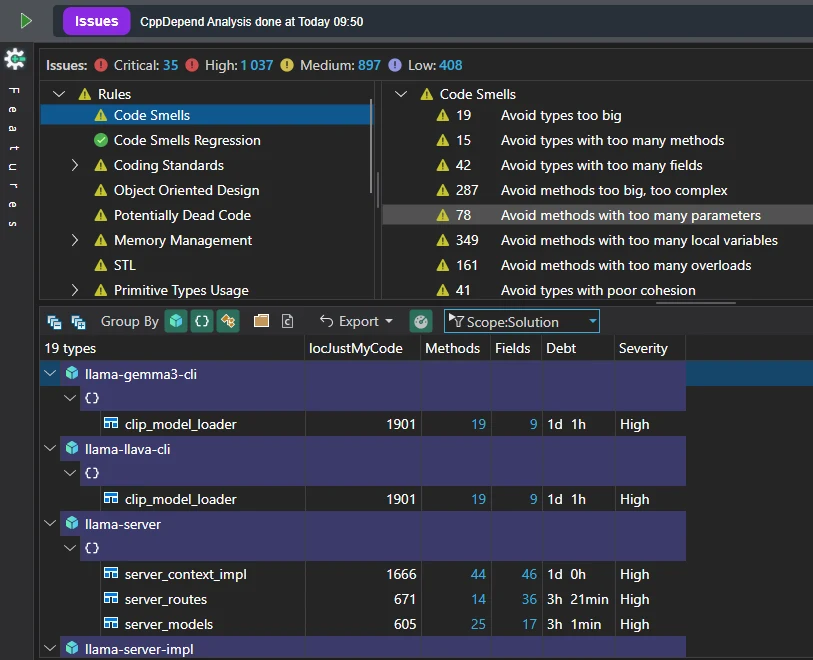
Hier sind einige Gründe, warum diese Funktionen Code-Smell-Warnungen auslösen, obwohl das Design beabsichtigt ist:
1.1. Inlining und Cache-Lokalität (Vermeidung von Funktionsaufruf-Overhead)
In Low-Level-SIMD- und Matrizen-Mathe-Kernels zerstört die Aufteilung einer 500-zeiligen Schleife in 10 kleinere Hilfsfunktionen die Ausführungseffizienz:
- Register Spilling & Befehls-Overhead: Funktionsaufrufe legen Register auf dem Stack ab und erzeugen Sprungbefehle. In engen Schleifen, die Milliarden Male pro Sekunde ausgeführt werden (wie die inneren quantisierten GEMM-Schleifen), verschlechtert der Funktionsaufruf-Overhead die Performance erheblich.
- Instruction-Cache-Treffer: Eine einzelne monolithische Schleife hält heiße Ausführungsbefehle kontinuierlich im Instruction Cache (I-Cache) der CPU oder im Shared Memory der GPU und verhindert Pipeline-Stalls.
1.2. Massive Modellunterstützung über zentralisiertes Dispatching
llama.cpp unterstützt Dutzende von Modellarchitekturen (Llama, Mistral, Gemma, Mixtral, DeepSeek, Command R) innerhalb monolithischer Graph-Konstruktionsfunktionen (z. B. llama_build_graph).
- Umfassende Switch-Blöcke für Architekturen: Anstatt komplexe C++-Vererbungshierarchien zu verwenden (z. B.
class LlamaModel : public ModelBase), nutzt llama.cpp riesige Switch-Anweisungen über Modellarchitektur-Enums. - Trade-off: Statische Analysatoren kennzeichnen diese wegen ihrer schieren Größe als „Brain Methods“ oder „God Functions“, aber dieses prozedurale Layout hält die Graphknoten-Konstruktion vollständig transparent und in einem kontinuierlichen Codeblock sichtbar.
1.3. Explosion der Quantisierungstypen (ggml_type-Switch-Schleifen)
Eine einzelne mathematische Operation (wie Tensormultiplikation) muss Kombinationen von F32, F16, Q4_0, Q4_K_M, Q8_0, IQ3_XXS und mehr verarbeiten.
// Common pattern triggering complexity warnings in GGML
switch (tensor->type) {
case GGML_TYPE_Q4_0: /* SIMD unroll for Q4_0 */ break;
case GGML_TYPE_Q4_K: /* SIMD unroll for Q4_K */ break;
case GGML_TYPE_Q8_0: /* SIMD unroll for Q8_0 */ break;
// ... 20+ quantization types unrolled directly in line
}
Da jeder Quantisierungstyp sein eigenes Blocklayout und seine eigene Vektor-Dequantisierungsmathematik hat, enthalten diese Schleifen massive verschachtelte Blöcke, die die zyklomatische Komplexität in die Höhe treiben.
1.4. Rasante Open-Source-Evolution („Hacker-C“-Kultur)
llama.cpp hat sich von einem einzeldateiigen C++-Proof-of-Concept zu einem riesigen Community-Projekt entwickelt:
- Geschwindigkeit der Feature-Integration: Wenn ein neues Paper oder eine neue Modellarchitektur erscheint (z. B. benutzerdefinierte RoPE-Embeddings oder Expert-Routing in MoE), fügen Contributors Ausführungszweige direkt in bestehende Graph-Building-Funktionen ein.
- Pragmatismus vor Abstraktion: Das Projekt priorisiert bewusst rohe Ausführungsgeschwindigkeit und einfache Einzeldatei-Modifikation gegenüber strikten OOP-Designmustern.
2. llama.cpp: Die Kunst, GRASP-Muster einzusetzen
llama.cpp wendet GRASP-Prinzipien (General Responsibility Assignment Software Patterns) über diskrete Workspace-Module hinweg an, isoliert zentrale Verantwortlichkeiten und vermeidet enge Laufzeitkopplung.
2.1. Modulare Dekomposition auf hoher Ebene (GRASP Scope)
Anstatt eine massive monolithische ausführbare Datei zu bauen, verteilt das Projekt Funktionalitäten auf eigenständige Module:
2.2. Wie GRASP-Prinzipien die Entkopplung vorantreiben
Hohe Kohäsion & Single Responsibility (SRP)
- ggml (Tensor Runtime): Ausschließlich für Tensorstrukturen (
ggml_tensor), Speicherallokations-Arenen, den Aufbau von Berechnungsgraphen (ggml_cgraph) und Backend-Orchestrierung zuständig. Es hat keinerlei Kenntnis von LLM-Transformern, Tokenisierung oder Prompt-Formatierung. - libllama (include/llama.h, src/llama.cpp): Verwaltet Transformer-Mechanik, GGUF-Dateiloading, KV-Cache-Allokation und Sequenz-Sampling. Die Matrizenmathematik wird vollständig an ggml delegiert.
- common (llama-common / common/): Kapselt übergreifende CLI-Utilities, Argument-Parsing, Konsolen-Logging, CPU-Affinität, Benchmarking und spekulative Ausführungslogik. Konsumenten der Kern-Engine können libllama direkt linken, ohne Abhängigkeiten von common zu übernehmen.
Information Expert
- Hardware-Backends (ggml-cuda, ggml-metal, ggml-vulkan): Jedes Backend fungiert als alleiniger Experte für die Ausführung von Tensoroperationen auf seinem Hardware-Ziel. Hardware-Details dringen niemals in llama.cpp oder den High-Level-Anwendungscode ein.
Protected Variations & Low Coupling
- Die reine C-API-Grenze (include/llama.h): High-Level-Anwendungen interagieren mit der Engine ausschließlich über Handles im C-Stil (
llama_model*,llama_context*). Dies schafft eine architektonische Firewall: Die gesamte interne Implementierung von llama.cpp kann refaktorisiert werden, ohne Downstream-Tools oder Bindings (Python, Node.js, Rust) zu brechen.
2.3. Dependency-Matrix-Erkenntnis: Das „Block-Diagonal“-Muster
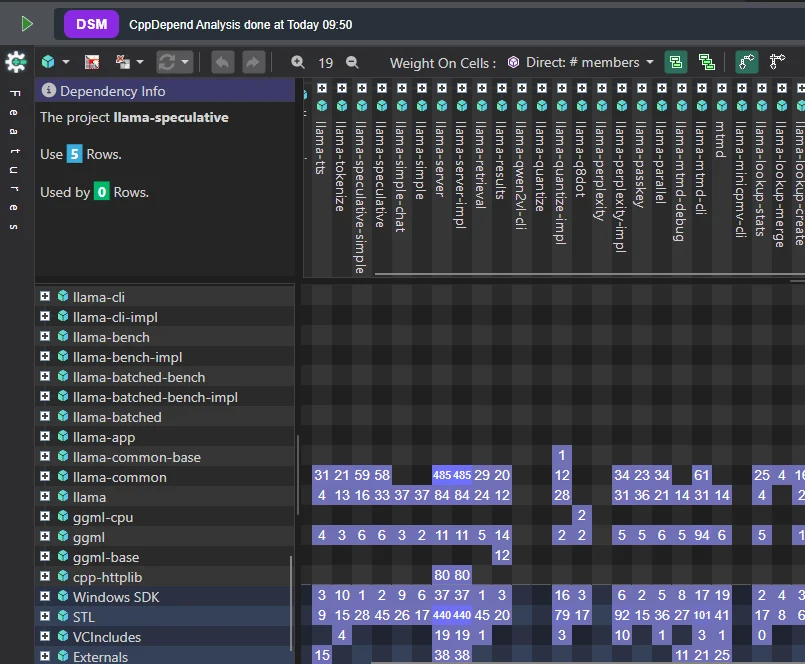
Bei der Auswertung dieses Multi-Projekt-Setups in einer Dependency Structure Matrix (DSM):
- Saubere Block-Isolation: Die Matrix stellt deutliche Diagonalblöcke dar, die ggml, llama und common entsprechen.
- Kein unerwünschtes Cross-Talk: ggml-Komponenten referenzieren niemals llama.cpp oder common. llama-Komponenten hängen von ggml ab, bleiben aber völlig unberührt vom High-Level-CLI-Code.
- Steckbare Architektur: Man kann common/ und tools/ entfernen und libllama mit minimalem Footprint direkt in eine Embedded-Runtime oder Desktop-Anwendung linken.
3. Abstraktion der Codebasis quantifizieren
Abstrakte Typen werden in modernem C++ häufig verwendet, um saubere, entkopplungsorientierte Designs zu erreichen – aber gilt das auch für llama.cpp? Suchen wir mit dieser Abfrage nach abstrakten Typen in der Codebasis:
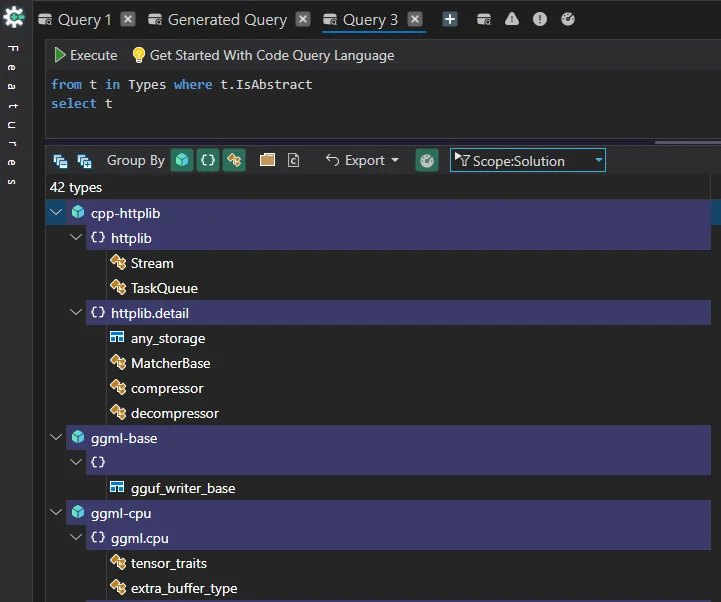
Nur wenige Typen sind abstrakt, und llama.cpp vermeidet bewusst klassische OOP-Paradigmen (Object-Oriented Programming) wie abstrakte Basisklassen, dynamisches Dispatch (virtuelle Funktionen) und tiefe Vererbungshierarchien.
Diese Designentscheidung lässt sich auf vier zentrale Engineering-Trade-offs zurückführen:
3.1. Vtable-Strafen & Indirektion eliminieren
In High-Performance-C++ erfordern virtuelle Funktionsaufrufe das Nachschlagen von Funktionszeigern in einer virtuellen Tabelle (Vtable).
- Cache Misses & Pointer Chasing: In einer tiefen Tensor-Graph-Ausführungsschleife führen Tausende virtueller Aufrufe pro Sekunde zu Branch-Mispredictions und lassen CPU-Pipelines stallen.
- Inlining-Blocker: Der Compiler kann einen virtuellen Methodenaufruf oft nicht inlinen, weil der konkrete Typ zur Compilezeit nicht bekannt ist. Durch die Verwendung einfacher C-Structs, expliziter Funktionszeiger oder statischer Templates kann der Compiler Code direkt in rohe Assembler-Schleifeniterationen inlinen.
3.2. Vorhersehbare Speicherlayouts statt polymorpher Zeigerspeicherung
Abstrakte Klassen zwingen dazu, mit Zeigern oder Smart Pointern (std::unique_ptr<ITensor>) zu arbeiten, um dynamisches Dispatch zu unterstützen.
- Zeiger führen zu Heap-Allokationen (malloc/new), was zu fragmentiertem Speicher im Heap führt.
- ggml (die zugrundeliegende Tensor-Engine) setzt auf flache, zusammenhängende Bump-allokierte Arenen (
ggml_context). Speicheroffsets werden vor Ausführungsbeginn in ein einziges statisches Graph-Layout vorgeplant. Standard-OOP-Abstraktionen zerstören zusammenhängende Speicherlayouts und ruinieren die L1/L2-Cache-Lokalität.
3.3. ABI-Stabilität über C- und Fremdsprachen-Bindings hinweg
llama.cpp soll überall laufen – eingebettet in Python (llama-cpp-python), Rust, Go, Swift, C# und Node.js.
- Moderne C++-Klassenhierarchien mit virtuellen Tabellen haben compiler-verstümmelte Symbolnamen, die sich zwischen GCC, Clang und MSVC unterscheiden.
- Durch die Verwendung flacher C-Structs (
struct llama_model,struct llama_context) und C-Funktionen (llama_decode()) legt llama.cpp eine saubere C-ABI-Grenze offen. Jede Sprache kann einen Standard-C-Header konsumieren, ohne einen komplexen C++-Runtime-Wrapper zu benötigen.
3.4. Einfache Compute-Graph-Architektur vs. Objektgraphen
In Standard-Softwareanwendungen modelliert Polymorphie Geschäftsobjekte (z. B. class Dog : public Animal). In LLM-Inferenz-Engines besteht das Domänenmodell aus statischen Compute-Graphen und Tensoren:
- Eine Modellarchitektur wird als Sequenz von Tensor-Mathe-Knoten (
ggml_mul_mat,ggml_add) dargestellt, nicht als tiefer Objektbaum. - Variationen zwischen Backends (CUDA, Metal, Vulkan, CPU SIMD) werden über statische Backend-Dispatches, Enum-Flags oder Compile-Time-Ausführungspipelines behandelt statt über polymorphe Runtime-Wrapper um jede Operation.
Zusammenfassung des architektonischen Trade-offs
| Designmuster | OOP / Abstrakte Klassen | llama.cpp C-Stil / Prozedural |
|---|---|---|
| Dispatch-Mechanismus | Dynamisch (Vtable-Lookups) | Statisch / Direktes C-Funktions-Dispatch |
| Speicherallokation | Heap-Zeiger (new/malloc) | Zusammenhängende vorab allokierte Arena (ggml_context) |
| Compiler-Optimierung | Begrenzt (virtuelle Aufrufe blockieren Inlining) | Maximal (heiße SIMD-Schleifen leicht inlinbar) |
| Sprach-Interop | Schwierig (erfordert komplexe C++-Bindings) | Trivial (legt Standard-C-ABI offen) |
4. Verwendung von POD-Typen im Llama-Modell
POD-Typen (Plain Old Data) in C++ sind einfache, C-kompatible Datenstrukturen, die Daten ohne zusätzlichen modernen C++-OO-Overhead halten.
Suchen wir mit dieser Codeabfrage nach den in llama.cpp verwendeten POD-Typen:
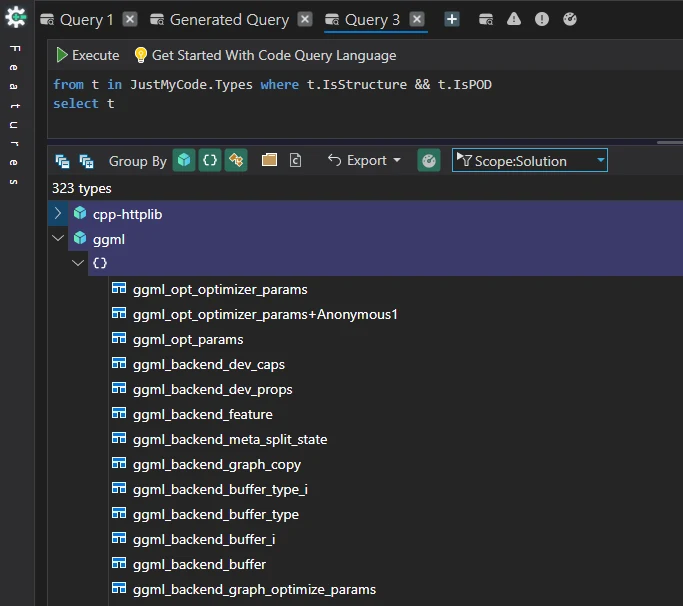
Darum verwendet llama.cpp überall einfache POD-Structs:
4.1. Vorhersehbare C-kompatible Speicherlayouts
Ein POD-Struct in C++ hat einen zusammenhängenden, deterministischen Speicher-Footprint ohne versteckte, vom Compiler eingefügte Zeiger (wie ein vptr für virtuelle Funktionen).
- Direkte Serialisierung/Deserialisierung: Beim Laden von GGUF-Modelldateien erlauben POD-Strukturen das direkte Lesen von Rohbytes von der Festplatte in den Speicher (fread oder mmap) direkt in das Struct – ohne komplexes Parsing, Konstruktoren oder Objektallokationen.
- C-ABI-Kompatibilität: POD-Structs bilden Standard-C-Datenstrukturen 1:1 ab. Dadurch können Nicht-C++-Sprachen (Python, Rust, Go, Swift, C#) exakt dasselbe Struct-Layout im Speicher abbilden – ohne Marshalling-Overhead.
4.2. Extreme Cache-Lokalität (L1/L2-Cache-Effizienz)
Moderne CPUs laufen tausendmal schneller als der Hauptspeicher. Die Performance in der LLM-Inferenz hängt stark davon ab, die CPU/GPU-Pipelines mit Daten zu versorgen.
- Zusammenhängende Arrays: Da POD-Typen keinen versteckten Overhead oder Heap-Zeiger enthalten, können sie dicht in flache, zusammenhängende Arrays gepackt werden (
std::vector<llama_token_data>oder rohe Speicherarenen). - Sequenzielles Cache-Prefetching: Bei der Iteration über ein zusammenhängendes Array von POD-Structs während Token-Sampling oder KV-Cache-Verwaltung lädt der Hardware-Prefetcher mühelos die nächsten Elemente in den L1/L2-Cache, bevor die Schleife sie anfordert.
4.3. Kompatibel mit benutzerdefinierten Arena-Allokatoren (ggml)
Standard-C++-Objekte mit nicht-trivialen Konstruktoren/Destruktoren erfordern new und delete, was Speicher dynamisch über den Heap verteilt.
- Heap-Allokationen verursachen Speicherfragmentierung und unvorhersehbare Allokationslatenz.
- llama.cpp nutzt Bump-/Arena-Allokatoren über
ggml_context. Rohspeicher wird einmal als riesiger Block reserviert, und POD-Structs werden direkt an diesem vorab allokierten Speicheroffset platziert. Da PODs keine Destruktoren benötigen, ist das Zurückgewinnen oder Zurücksetzen von Speicher so schnell wie das Zurücksetzen eines einzelnen Zeigers auf null (offset = 0).
4.4. Null Laufzeit-Overhead & triviale Kopien
POD-Structs haben keine versteckte Logik im Hintergrund:
- Das Kopieren oder Verschieben eines POD-Structs ist nur eine schnelle Speicherkopie (memcpy).
- Die Übergabe von POD-Structs per Wert oder const-Referenz führt keine versteckten Copy-Konstruktor- oder Destruktor-Aufrufe ein und gibt dem Entwickler die vollständige Kontrolle über die Ausführungsperformance in heißen inneren Schleifen.
5. STL-Fußabdruck und -Nutzung (Standard Template Library)
Um zu sehen, wo und wie die STL verwendet wird, können wir die Dependency Matrix für eine detaillierte Ansicht ihrer Nutzung in der gesamten Codebasis analysieren.
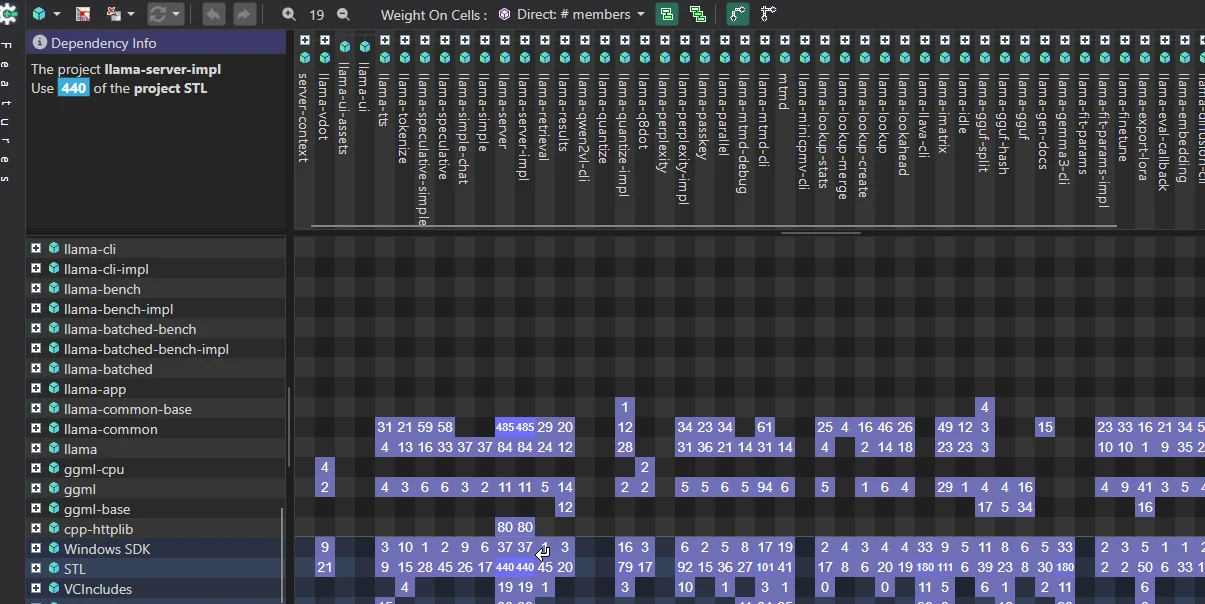
Wie man sieht, wird die STL stark in den High-Level-Modulen verwendet, während Low-Level-Module sie selten – wenn überhaupt – nutzen.
5.1. llama-server: Komplexe Orchestrierung erfordert High-Level-Abstraktionen
llama-server ist ein HTTP-API-Daemon, der Multithreading, asynchrones I/O, Slot-Management, JSON-Parsing, Queueing und HTTP-State verarbeitet.
Er nutzt stark Standard-Bibliotheks-Features (std::*), weil das Schreiben von Netzwerk-Orchestrierungscode in Low-Level-prozeduralem C/C++ unpraktisch ist:
- Concurrency & Synchronisation:
std::thread,std::mutex,std::condition_variable,std::futureundstd::atomicverwalten eingehende Web-Requests und reihen Inferenzaufgaben ein. - Komplexe Datenstrukturen:
std::unordered_map,std::queue,std::mapundstd::vectorverarbeiten Multi-Tenant-Session-Slots, Kontextzustand und Tokensequenzen. - String-Verarbeitung & Formatierung:
std::string,std::stringstreamund Regex-Operationen formatieren JSON-Ein-/Ausgaben für OpenAI-kompatible REST-Endpunkte.
5.2. Kern-Engines (ggml & llama): STL-Vermeidung für rohe Performance
Im Gegensatz dazu vermeidet Low-Level-Inferenzcode in ggml und Core-llama tiefe STL-Nutzung aus performance-kritischen Gründen:
- Vermeidung nicht-deterministischer Allokation: Container wie
std::vectoroderstd::stringallokieren und reallokieren Speicher dynamisch auf dem Heap (malloc/free). In heißen Tensor-Matrixmultiplikations-Schleifen lösen dynamische Allokationen OS-Systemaufrufe aus und erzeugen Tail-Latenz-Spitzen. ggml verwendet stattdessen statisch vorab allokierte Speicherarenen (ggml_context). - Binärgröße & Kompiliergeschwindigkeit: Schwere C++-STL-Template-Expansion (
<iostream>,<regex>,<algorithm>) bläht die Binärgrößen drastisch auf und verlangsamt die Kompilierzeiten. Minimale Kern-Compute-Dateien erlauben schnelle Kompilierung auf Embedded-Systemen und leichten Micro-Runtimes. - Maximale Portabilität & Bare-Metal-Ausführung: ggml läuft auf ressourcenbeschränkten Plattformen, WASM (Webbrowsern), Mikrocontrollern und benutzerdefinierten Hardware-Beschleunigern, wo eine vollständige C++-Standard-Runtime-Umgebung reduziert, fehlend oder ineffizient sein könnte.
6. Exception-Nutzung
Core-C++-Exceptions werden in den inneren Compute-Schichten (ggml und llama) strikt vermieden, obwohl Exceptions in High-Level-Helfer-Wrappern (llama-common, common/arg.cpp und llama-server) vorkommen.
Finden wir mit dieser Codeabfrage heraus, welche Module die Klasse std::exception verwenden:
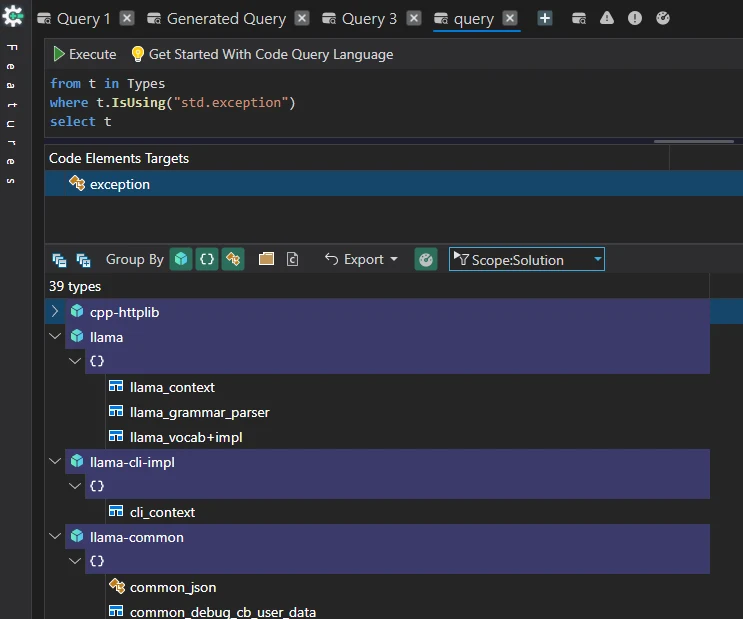
llama.cpp folgt einer strikten Trennung in der Fehlerbehandlung über seine Architektur hinweg:
6.1. ggml & Core llama: C-Fehlercodes & Assertions
In den Foundation-Schichten wird die Exception-Behandlung bewusst weggelassen:
- Rückgabecodes & Nullzeiger: Methoden wie
llama_decode(),llama_model_load()oder interne Allokationsroutinen geben nullptr, ganzzahlige Fehlerstatuscodes (0, -1) oder boolesche Flags zurück, stattstd::exceptionzu werfen. - Explizite Assertions: Nicht behebbare Invariantenprüfungen (wie nicht übereinstimmende Tensordimensionen oder Out-of-Bounds-Kontextausführung) verwenden Makro-Assertions (
GGML_ASSERT/assert()), die sofort abbrechen oder Fehler sicher loggen, statt den Stack abzuwickeln. - C-ABI-Grenzsicherheit: Die primäre öffentliche API von llama.h ist eine C-ABI. Das Werfen von C++-Exceptions über eine C-Sprachgrenze hinweg ist in C++ undefiniertes Verhalten, daher dürfen die Kernfunktionen keine Exceptions entkommen lassen.
6.2. High-Level-Wrapper (llama-common & llama-server): Selektive C++-Exceptions
Exceptions erscheinen in High-Level-Tooling für den Entwicklerkomfort:
- CLI-Argument-Parsing (arg.cpp): Wirft
std::runtime_erroroderstd::invalid_argumentbeim Parsen von Kommandozeilenparametern (z. B. fehlerhafte Flag-Optionen oder fehlende Modellpfade). - Server- & Drittanbieter-Bibliotheken (llama-server): Konsumiert Bibliotheken wie nlohmann::json oder HTTP-Parser, die beim Parsen fehlerhafter Payloads natürlicherweise Exceptions werfen. Diese werden in try/catch-Blöcken auf oberster Ebene der Server-Schleife abgefangen.
Warum die Kern-Inferenz Exceptions vermeidet
- Null Stack-Unwinding-Overhead: Das Aktivieren von Exceptions (-fexceptions) führt zu Binärcode-Bloat und versteckten Kontrollfluss-Pfaden. Das Deaktivieren oder Vermeiden von Exceptions in heißen Schleifen hält SIMD-Ausführungspipelines und Compiler-Optimierungen aggressiv.
- Deterministischer Kontrollfluss: LLM-Matrixoperationen und Speicherarenen (
ggml_context) erfordern explizites Cleanup. Eine geworfene Exception kann leicht nicht-RAII-basierte benutzerdefinierte Arena-Destruktoren umgehen, was zu massiven GPU/CPU-Speicherlecks führt. - Sprachübergreifende Sicherheit: Sprach-Bindings (Python, Rust, C#, Go) erwarten einfache C-Rückgabecodes, um Exceptions sauber in ihren eigenen nativen Sprach-Runtimes abzubilden.
7. Namespace-Nutzung
In modernem C++ sind Namespaces Bereichsgrenzen, die Code in logische Gruppen organisieren und Namenskollisionen über Bibliotheken hinweg verhindern.
Untersuchen wir, ob Namespaces in llama.cpp weit verbreitet sind:
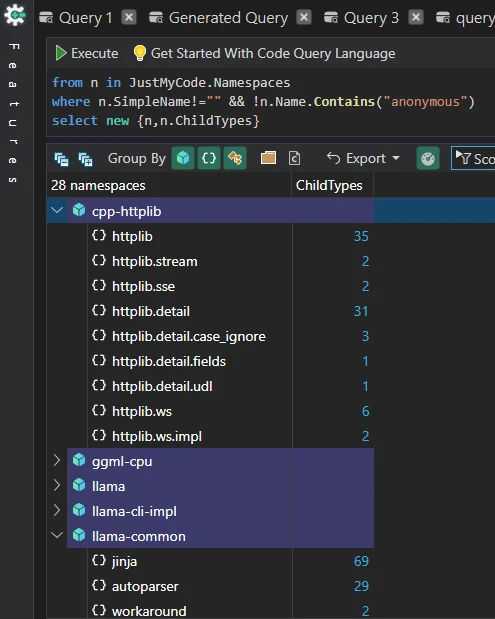
Namespaces sind in cpp-httplib und llama-common prominent, aber praktisch abwesend in den übrigen Bibliotheken. Hier sind einige Gründe für dieses Muster:
7.1. Die Kern-Engine (ggml) ist reines C
Das Fundament von llama.cpp ist die ggml-Tensor-Evaluierungsbibliothek. ggml ist in Standard-C (C99/C11) geschrieben, um portable Laufzeitausführung über Hardware-Backends (CPU, CUDA, Metal, Vulkan, OpenCL) zu gewährleisten.
- Da C keine Namespaces unterstützt, verwendet ggml explizite
ggml_-Präfixe für Funktionen und Structs (z. B.ggml_init,ggml_tensor,ggml_cgraph), um Symbole zu isolieren, ohne C++-Namespaces zu benötigen.
7.2. ABI-Stabilität & C-API-Kompatibilität
Eines der primären Designziele von llama.cpp ist es, als einbettbare, leichte Engine für Bindings in anderen Sprachen (Python, Rust, Go, Java, Swift, C#) zu dienen.
- C++ Name Mangling: C++-Namespaces verändern exportierte Symbolnamen zur Compilezeit.
- Um saubere, unverstümmelte Symbole zu exportieren, die nahtlos mit dlopen und C-FFI-Wrappern funktionieren, exportieren Kern-Header einfache C-ABIs (
extern "C"). Das Vermeiden tiefer Namespace-Hierarchien vereinfacht den Export von Shared-Library-Grenzen (llama.h, ggml.h).
7.3. C-Datenstrukturen und POD-Typen
llama.cpp priorisiert POD-Structs (Plain Old Data), statische Funktionen und explizite Funktionssignaturen gegenüber objektorientierten C++-Hierarchien.
- Code-Isolation wird über Compilation Units (dateiweite statische Funktionen) innerhalb von .cpp-Dateien verwaltet, statt Komponenten in verschachtelte
namespace llama { namespace detail { ... } }-Blöcke zu verpacken. - Dies hält die globale Namespace-Verschmutzung gering und bewahrt gleichzeitig direkte Speicherkontrolle und statische Sichtbarkeit innerhalb einzelner Implementierungsdateien.
7.4. Minimalistische „Zero-Overhead-C++“-Philosophie
llama.cpp folgt einer minimalistischen Variante von C++, oft beschrieben als „C with Classes“ oder „Data-Oriented C++“.
- Die Codebasis verwendet selektiv Standard-C++-Features (wie
std::vector,std::stringoderstd::thread), um Speicherverwaltung und Concurrency zu vereinfachen, während tief verschachtelte Namespaces, schwere Template-Metaprogrammierung oder komplexe Klassen-Vererbungshierarchien vermieden werden.
8. Template-Nutzung
In C++ ermöglicht generische Programmierung über Templates das Schreiben wiederverwendbarer, typsicherer Algorithmen und Datenstrukturen ohne Laufzeit-Performance-Einbußen. Durch die Codegenerierung zur Compilezeit eliminieren Templates Indirektion, erlauben tiefes Compiler-Inlining und optimieren die Performance direkt für konkrete Typen.
Untersuchen wir, ob Templates in llama.cpp definiert sind:
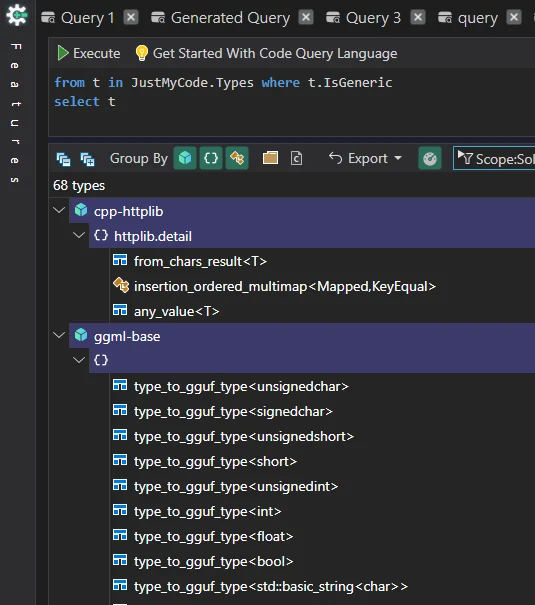
Und um visuell zu erkunden, wo die Templates definiert sind, können wir das Abfrageergebnis in die Treemap-Ansicht exportieren:
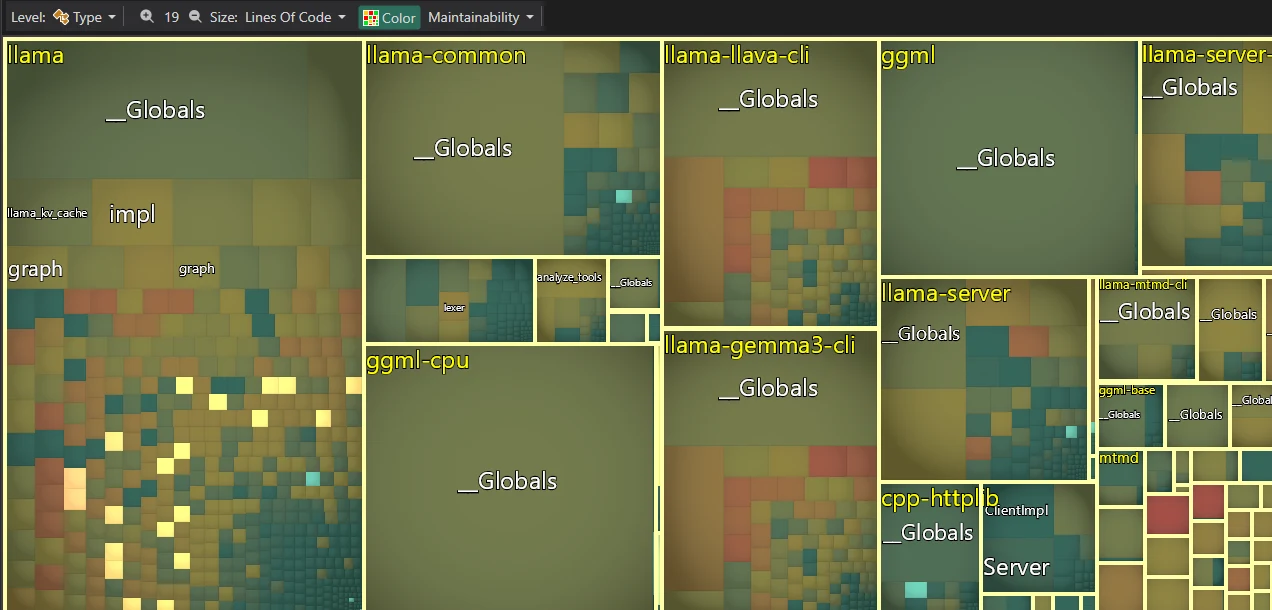
Die betroffenen Typen sind hervorgehoben, und wie die Treemap zeigt, sind sie in wenigen Bibliotheken definiert, insbesondere in der llama-Bibliothek.
Anstatt sich auf template-lastige C++-Generics zu verlassen, wählt llama.cpp prozeduralen Code im C-Stil, dynamisches Dispatch über Enums (ggml_type) und Makros – aus konkreten Engineering-Gründen:
8.1. Template-Code-Bloat eliminieren (Binärgrößen-Inflation)
Wenn C++-Templates über mehrere Datentypen (z. B. float, fp16, int8, int4) instanziiert werden, generiert der Compiler eine separate Kopie des Maschinencodes für jede Typpermutation.
- Instruction-Cache-Misses: Duplizierte template-instanziierte Funktionen blähen die endgültige Binärgröße auf. Große Binärdateien belasten den Instruction Cache (I-Cache) der CPU und verursachen Cache Misses, die Ausführungsschleifen verlangsamen.
- Prozedurales Code-Sharing: ggml verwendet explizites Enum-Dispatch (
switch (type)), um einzelne Implementierungs-Einstiegspunkte zu teilen, statt das Code-Segment mit templatisierten Funktionen aufzublähen.
8.2. Drastische Reduktion der Kompilierzeit
Schwere C++-Template-Metaprogrammierung erhöht die Build-Zeiten erheblich, weil Header wiederholt über Translation Units hinweg geparst, expandiert und kompiliert werden müssen.
- Durch die Verwendung flacher C-Structs (
struct ggml_tensor), einfacher Enum-Flags (GGML_TYPE_F32,GGML_TYPE_Q4_0) und schlichter C-Header kompiliert llama.cpp in Sekunden – selbst auf langsamen Geräten wie einem Raspberry Pi oder einem schwachen Laptop – während stark templatisierte C++-Bibliotheken (wie PyTorch C++ oder Eigen) über 20 Minuten Build-Zeit benötigen können.
8.3. Dynamische Laufzeit-Typisierung vs. statische Compile-Time-Generics
In Machine-Learning-Runtimes werden Tensor-Datentypen, Dimensionen und Ausführungsgraphen oft zur Laufzeit bestimmt (z. B. beim Laden eines GGUF-Modells mit gemischten Q4_K_M- und Q8_0-Quantisierungen).
- C++-Templates erfordern, dass Typen zur Compilezeit festgelegt werden.
- Wenn ggml für Tensortypen auf C++-Generics setzen würde, müsste jede Modelltypkombination in riesige Template-Matrizen vorkompiliert werden, oder der Code müsste auf massive Template-Expansionsblöcke zurückgreifen.
- Die Verwendung eines Laufzeit-Typ-Enums (
ggml_tensor->type = GGML_TYPE_Q4_K) erlaubt es einer einzigen, einheitlichen C-Struktur, jeden Tensortyp dynamisch im Speicher zu repräsentieren – ohne Template-Parameter.
8.4. Vereinfachte GPU- & SIMD-Beschleuniger-Backends
llama.cpp lagert Tensorberechnungen auf diverse Hardware-Backends aus (CUDA, Metal, Vulkan, OpenCL, AVX-512, ARM NEON).
- Das Schreiben von Device-Kernels für GPUs oder rohen SIMD-Intrinsics erfordert feingranulare Kontrolle über Low-Level-Assembler-Layout, Speicherausrichtung und Registerverwendung.
- Die Abstraktion innerer SIMD/GPU-Schleifen hinter komplexen C++-Generic-Templates macht es deutlich schwieriger, generierten Assembler zu inspizieren, Vektor-Ausrichtungsprobleme zu debuggen oder hardwarespezifische SIMD-Register zu optimieren.
Zusammenfassung des architektonischen Kontrasts
| Merkmal | Generische Templates (template<typename T>) | llama.cpp Dynamische Enums (ggml_type) |
|---|---|---|
| Typ-Entscheidung | Compile-Time | Laufzeit |
| Binärgröße | Expandiert pro Typ (aufgebläht) | Einzelne prozedurale Implementierung (schlank) |
| Kompiliergeschwindigkeit | Langsam (schweres Header-Parsing) | Extrem schnell |
| Hardware-Introspektion | Durch Abstraktionsschichten verschleiert | Direkte C-/SIMD-Registerkontrolle |
9. Einige Fakten zu den Designentscheidungen
9.1. Typen mit zu vielen Methoden
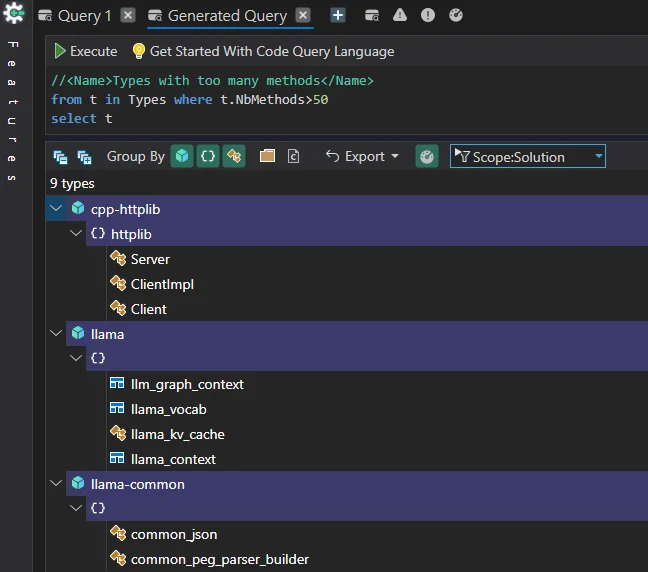
Einige Typen haben eine große Anzahl von Methoden, aber in llama.cpp hat jeder Fall einen validen Engineering-Grund. Hier zum Beispiel, warum solche Typen in einer HTTP-Bibliothek zu erwarten sind:
- Selbständige Header-Only-Architektur: cpp-httplib ist bewusst als Single-Header-HTTP-Bibliothek für einfaches plattformübergreifendes Embedding konzipiert. Um die Drittanbieter-Integration einfach zu halten und komplexe Abhängigkeitsgraphen zu vermeiden, werden Protokoll-Features direkt in den Haupt-Client- und Server-Abstraktionen gekapselt.
- Flüssige & entwicklerfreundliche API: Ein vollständiger HTTP-Client oder -Server benötigt naturgemäß eine breite Palette von Methoden, um verschiedene Request-Optionen, Header, Timeouts und Callbacks zu verarbeiten, ohne Endnutzer zu zwingen, separate zugrundeliegende Handler-Objekte zu verdrahten.
- Internes Delegate-Muster: httplib::Client delegiert seine Kernarbeit an httplib::ClientImpl. Während ClientImpl Low-Level-Socket-, SSL- und Transportlogik akkumuliert, schützt diese Trennung sauber die öffentliche Client-API vor internen plattformspezifischen Details.
9.2. Nicht kohäsive Typen
Typkohäsion (oder Klassenkohäsion in der objektorientierten Programmierung) misst, wie eng verwandt und fokussiert die Verantwortlichkeiten, Felder und Methoden eines einzelnen Typs sind.
Untersuchen wir, wie viele nicht kohäsive Typen es in llama.cpp gibt:
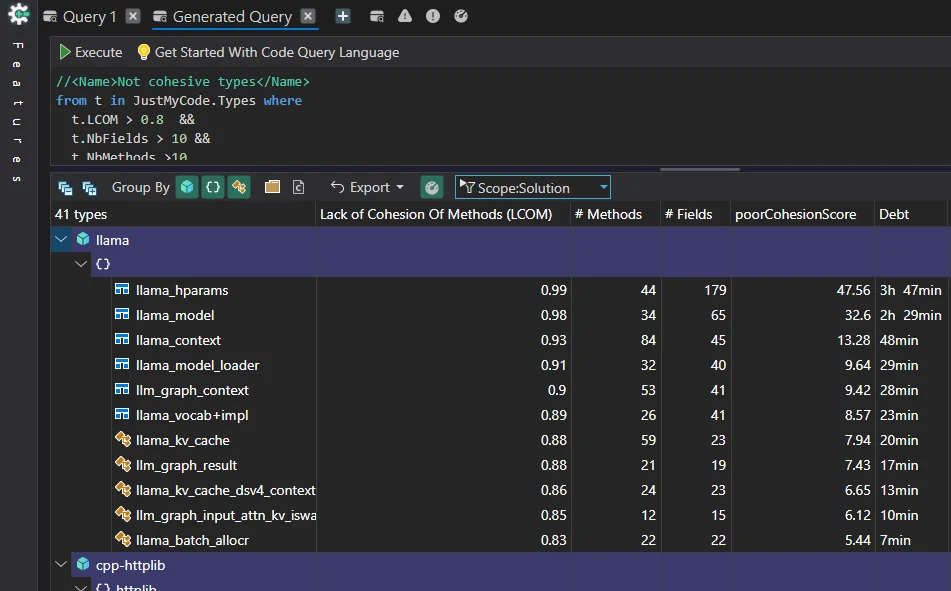
Warum geringe Kohäsion bei einigen Modell-Metadaten beabsichtigt ist
- POD-/DTO-Datenmuster:
llama_hparamsfungiert als Data Transfer Object (DTO) oder C-Struct statt als zustandsbehaftete objektorientierte Domänenklasse. Seine einzige Verantwortung ist das Halten des vollständigen Modell-Hyperparameter-Zustands, der aus GGUF-Metadaten-Headern geparst wird. - Einheitliche Modellarchitektur-Repräsentation: Moderne Transformer-Architekturen (Llama, Mistral, Gemma, Qwen) erfordern eine umfangreiche Reihe von Konfigurations-Flags. Die Gruppierung dieser Einstellungen in einem einzigen einheitlichen Hyperparameter-Struct garantiert, dass Tensor-Allokationsroutinen, KV-Cache-Berechner und Ausführungsgraphen vollständige Modell-Metadaten in einem einzigen Speicherblock erhalten.
- Entkopplung von Daten und Ausführungslogik: Im C/C++-Engine-Design werden Datenstrukturen (
llama_hparams) von Verarbeitungsalgorithmen (ggml-Compute-Graphen) entkoppelt gehalten. Das Erzwingen von OOP-Kohäsionsregeln auf passive Datenstrukturen fügt unnötigen Abstraktions-Overhead hinzu, ohne Performance oder Sicherheit zu verbessern.
9.3. Zu große Methoden
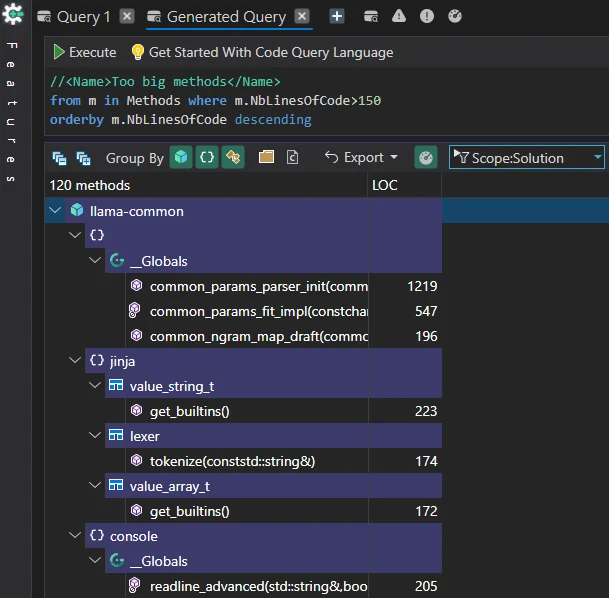
In High-Performance-C++-Codebasen wie llama.cpp sind bestimmte Designmuster – wie zentrale Konfigurations-Dispatcher oder massive Hardware-Ausführungs-Switches – völlig erwartbar und praktisch.
Fallstudie: common_params_parser_init
CppDepend kennzeichnet common_params_parser_init (in llama-common) aufgrund seiner hohen Zeilenzahl und zyklomatischen Komplexität:
- Warum die statische Analyse es kennzeichnet: Es enthält Dutzende von Kommandozeilen-Flag-Definitionen, Argument-Parsing-Blöcke, Hilfetext-Formatierungsregeln und Fallback-Defaults an einem einzigen Ort.
- Warum dies normale Engineering-Praxis ist: CLI-Argument-Parser für große ML-Modelle akkumulieren naturgemäß Hunderte von Parametern (
--n-gpu-layers,--ctx-size,--temp,--rope-scalingusw.). Die Aufteilung dieser Initialisierung in Dutzende winziger Hilfsfunktionen würde Parameterdefinitionen fragmentieren und die Codelesbarkeit senken, ohne echte architektonische Vorteile zu bieten.
9.4. Nicht kommentierte große Methoden
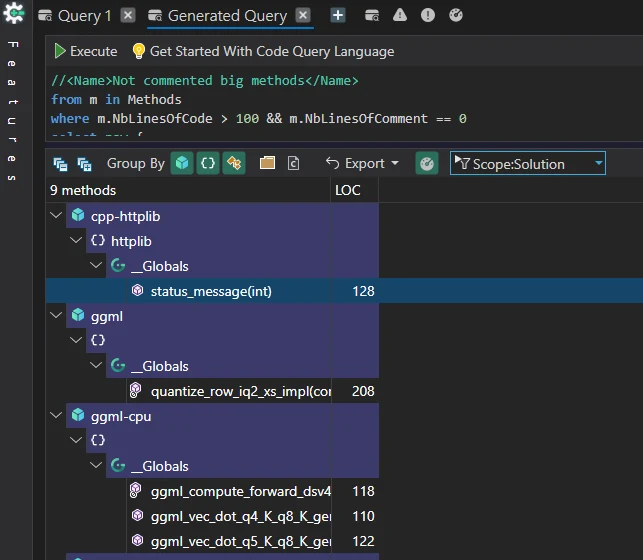
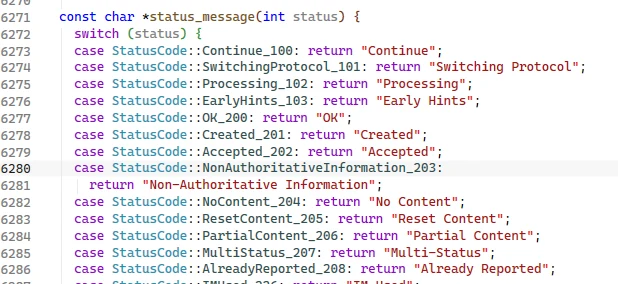
Obwohl es einige große, unkommentierte Methoden gibt, zeigt ein genauerer Blick auf Funktionen wie status_message, dass Kommentare unnötig sind, weil der Code selbsterklärend ist.
Fazit: Engineering jenseits des Linters
Die Analyse von llama.cpp durch statische Codeanalyse offenbart eine faszinierende Dualität. Auf Mikroebene lösen Funktionslängen-Metriken und zyklomatische-Komplexitäts-Warnungen traditionelle „Code-Smell“-Alarme aus. Doch auf Makroebene demonstriert die Architektur außergewöhnliche strukturelle Disziplin – angetrieben von strikter Schichtisolation, null zyklischen Abhängigkeiten und sauberer GRASP-ausgerichteter Modul-Entkopplung.
llama.cpp beweist, dass erstklassige C++-Performance nicht darin besteht, dogmatisch an OOP-Designmustern oder sicherheitskritischen Linter-Regeln festzuhalten. Es geht um bewusste Engineering-Trade-offs: das Opfern von Mikroebenen-Eleganz innerhalb heißer Ausführungspfade, um maximale Instruction-Cache-Lokalität, Zero-Overhead-Hardware-Dispatch und messerscharfe Ausführungsgeschwindigkeit zu erreichen.