Dans l'ingénierie logicielle moderne, on apprend souvent aux développeurs à s'en tenir rigidement à un seul paradigme de langage : C++ purement orienté objet, programmation fonctionnelle stricte ou API C monolithiques.
Le succès extraordinaire de llama.cpp prouve une thèse différente : le pragmatisme bat le dogme.
Au lieu d'imposer un modèle de conception uniforme sur l'ensemble du projet, llama.cpp est construit comme une hiérarchie en couches où chaque niveau est délibérément conçu avec le paradigme le mieux adapté à son domaine de problème spécifique — des arènes mémoire C bas niveau jusqu'aux abstractions C++ modernes.
Analysons llama avec CppDepend et explorons la qualité globale du code de llama.cpp :
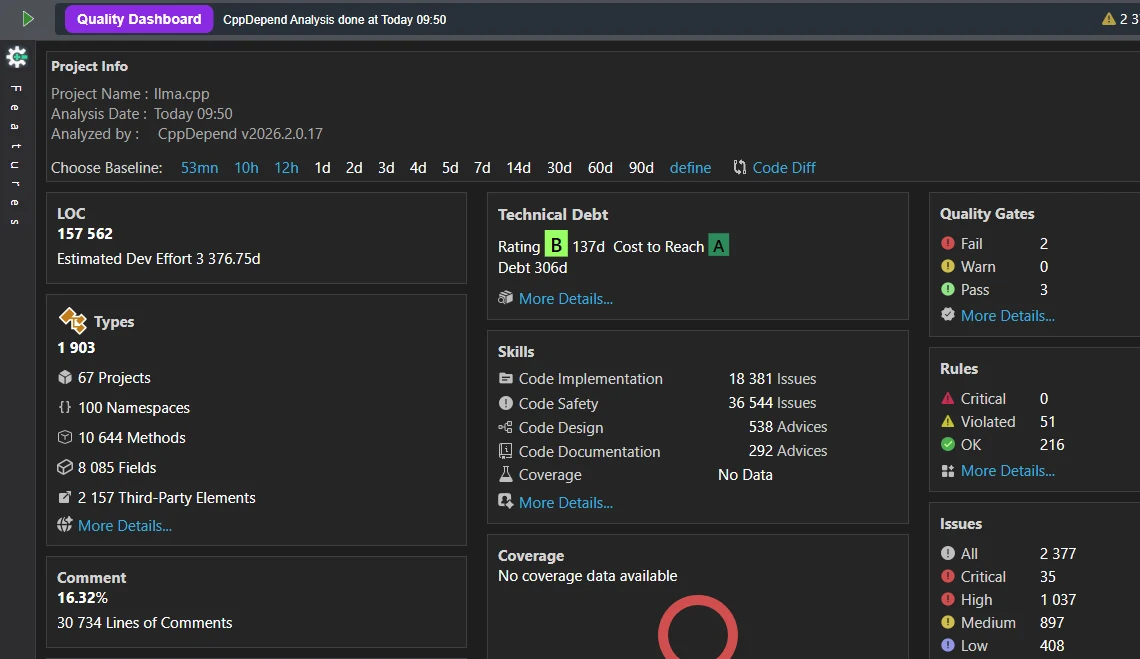
Le projet obtient une note B pour la qualité globale du code et la dette technique, démontrant une architecture bien structurée avec une densité de dette technique relativement faible.
1. Explorer llama.cpp en Code City
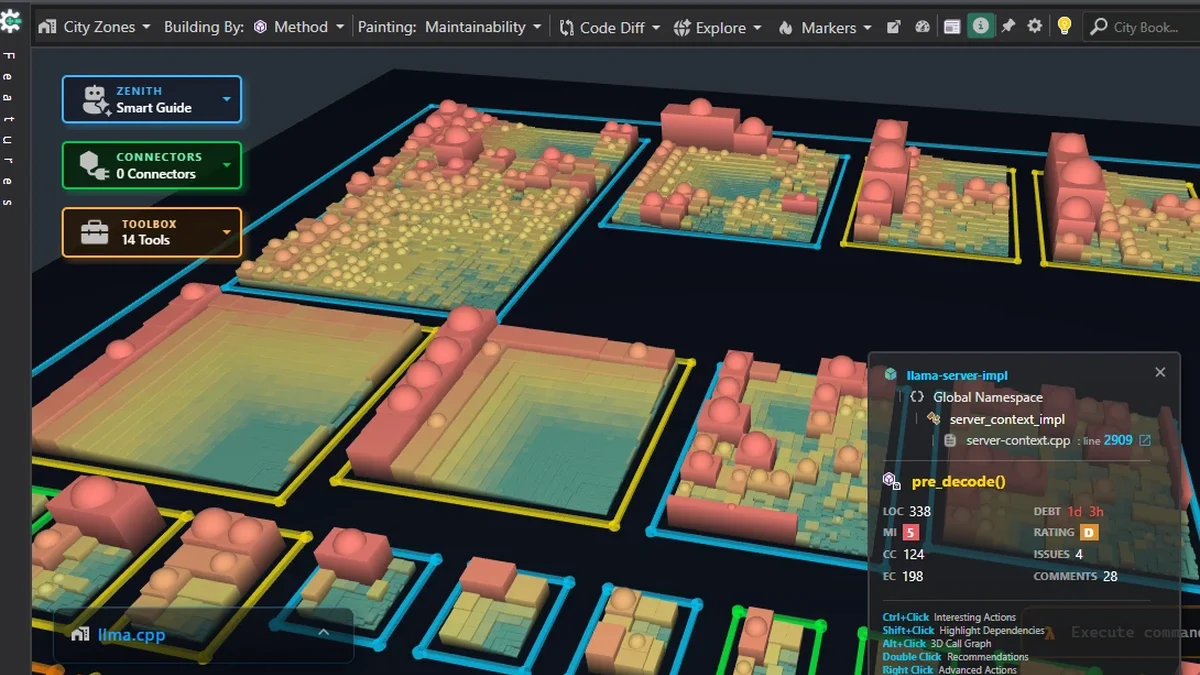
Après avoir évalué le tableau de bord récapitulatif, nous pouvons explorer visuellement où le code peut être amélioré grâce à la fonctionnalité Code City. La visualisation de la base de code en Code City 3D fournit des aperçus visuels immédiats du couplage, des hotspots, des code smells, des tailles de méthodes et de la distribution des problèmes.
Dans cette Code City, chaque bâtiment représente une méthode, tandis que la couleur indique la santé et la gravité des problèmes. Survoler un bâtiment affiche des métriques de diagnostic détaillées.
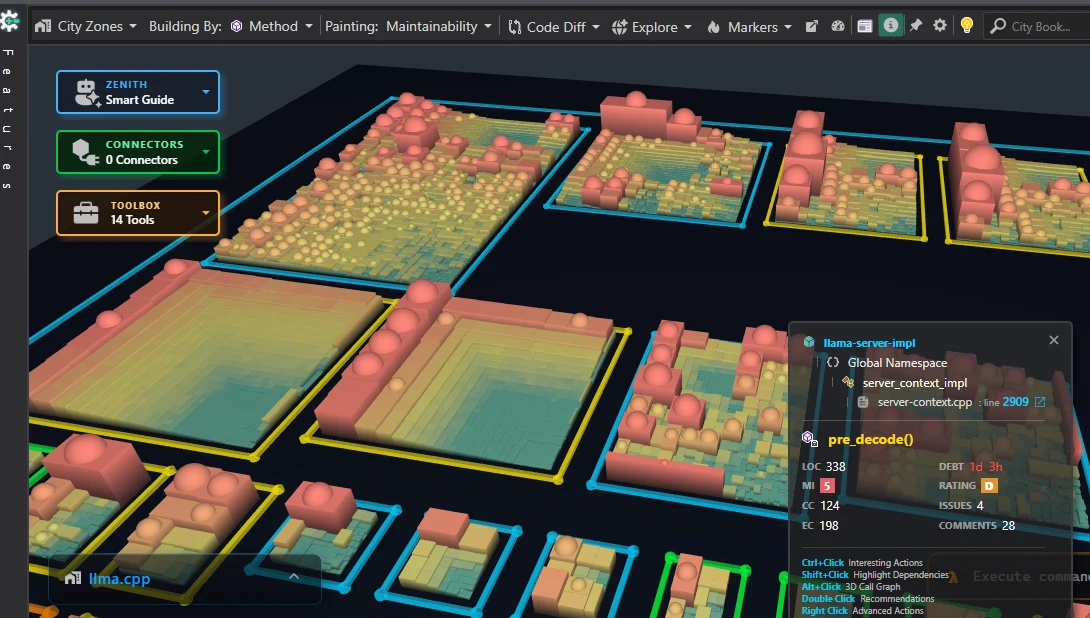
Bien que de nombreuses méthodes soient surlignées en rouge, un examen plus attentif révèle qu'il s'agit généralement de code smells. Comme le montre l'Issues Explorer, de nombreux code smells sont détectés :
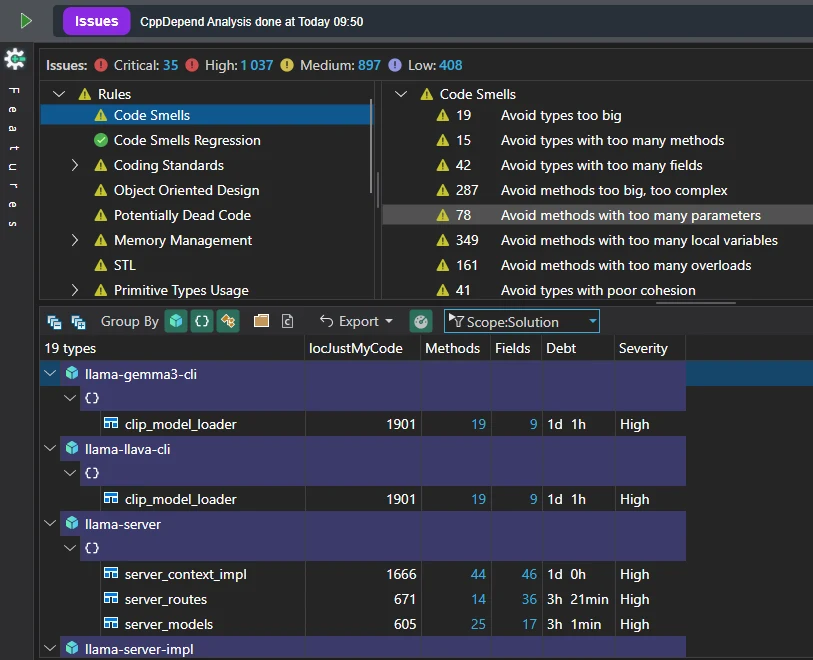
Voici quelques raisons pour lesquelles ces fonctions déclenchent des avertissements de code smell, même lorsque la conception est intentionnelle :
1.1. Inlining et localité du cache (éviter le surcoût des appels de fonction)
Dans les kernels SIMD et de calcul matriciel bas niveau, découper une boucle de 500 lignes en 10 petites fonctions auxiliaires détruit l'efficacité d'exécution :
- Register spilling et surcoût d'instructions : les appels de fonction empilent les registres sur la pile et créent des instructions de saut. Dans des boucles serrées exécutées des milliards de fois par seconde (comme les boucles GEMM quantifiées internes), le surcoût des appels de fonction dégrade significativement les performances.
- Accès au cache d'instructions : une boucle monolithique unique maintient les instructions d'exécution chaudes de façon continue dans le cache d'instructions (I-Cache) du CPU ou la mémoire partagée du GPU, évitant les blocages de pipeline.
1.2. Support massif de modèles via dispatch centralisé
llama.cpp prend en charge des dizaines d'architectures de modèles (Llama, Mistral, Gemma, Mixtral, DeepSeek, Command R) dans des fonctions monolithiques de construction de graphes (par ex. llama_build_graph).
- Blocs switch exhaustifs d'architectures : plutôt que d'utiliser des hiérarchies d'héritage C++ complexes (par ex.
class LlamaModel : public ModelBase), llama.cpp utilise d'énormes instructions switch sur des enums d'architectures de modèles. - Compromis : les analyseurs statiques les signalent comme « Brain Methods » ou « God Functions » en raison de leur taille, mais cette disposition procédurale garde la construction des nœuds du graphe totalement transparente et visible dans un bloc de code continu.
1.3. Explosion des types de quantification (boucles switch ggml_type)
Une seule opération mathématique (comme la multiplication de tenseurs) doit gérer des combinaisons de F32, F16, Q4_0, Q4_K_M, Q8_0, IQ3_XXS, et plus encore.
// Common pattern triggering complexity warnings in GGML
switch (tensor->type) {
case GGML_TYPE_Q4_0: /* SIMD unroll for Q4_0 */ break;
case GGML_TYPE_Q4_K: /* SIMD unroll for Q4_K */ break;
case GGML_TYPE_Q8_0: /* SIMD unroll for Q8_0 */ break;
// ... 20+ quantization types unrolled directly in line
}
Parce que chaque type de quantification a sa propre disposition de blocs et ses propres mathématiques de déquantification vectorielle, ces boucles contiennent d'énormes blocs imbriqués qui font exploser les métriques de complexité cyclomatique.
1.4. Évolution open-source rapide (culture « Hacker C »)
llama.cpp est passé d'une preuve de concept C++ en un seul fichier à un projet communautaire massif :
- Vitesse d'intégration des fonctionnalités : quand un nouveau papier ou une nouvelle architecture de modèle paraît (par ex. des embeddings RoPE personnalisés ou du routage d'experts dans MoE), les contributeurs ajoutent des branches d'exécution directement dans les fonctions de construction de graphes existantes.
- Pragmatisme plutôt qu'abstraction : le projet privilégie intentionnellement la vitesse d'exécution brute et la facilité de modification en un seul fichier plutôt que des design patterns OOP stricts.
2. llama.cpp : l'art d'utiliser les patterns GRASP
llama.cpp applique les principes GRASP (General Responsibility Assignment Software Patterns) à travers des modules d'espace de travail distincts, isolant les responsabilités centrales tout en évitant un couplage étroit à l'exécution.
2.1. Décomposition modulaire de haut niveau (GRASP Scope)
Au lieu de construire un exécutable monolithique massif, le projet répartit les fonctionnalités entre des modules distincts :
2.2. Comment les principes GRASP pilotent le découplage
Forte cohésion et responsabilité unique (SRP)
- ggml (Tensor Runtime) : dédié uniquement aux structures de tenseurs (
ggml_tensor), aux arènes d'allocation mémoire, à la construction de graphes de calcul (ggml_cgraph) et à l'orchestration des backends. Il n'a aucune connaissance des transformers LLM, de la tokenisation ou du formatage des prompts. - libllama (include/llama.h, src/llama.cpp) : gère la mécanique des transformers, le chargement des fichiers GGUF, l'allocation du cache KV et l'échantillonnage de séquences. Il délègue entièrement les mathématiques matricielles à ggml.
- common (llama-common / common/) : encapsule les utilitaires CLI transversaux, le parsing d'arguments, la journalisation console, l'affinité CPU, le benchmarking et la logique d'exécution spéculative. Les consommateurs du moteur central peuvent lier libllama directement sans dépendre de common.
Information Expert
- Backends matériels (ggml-cuda, ggml-metal, ggml-vulkan) : chaque backend agit comme l'unique expert pour exécuter les opérations de tenseurs sur sa cible matérielle. Les détails matériels ne fuient jamais dans llama.cpp ou le code applicatif haut niveau.
Protected Variations et faible couplage
- La frontière API C pure (include/llama.h) : les applications haut niveau interagissent avec le moteur exclusivement via des handles à la C (
llama_model*,llama_context*). Cela crée un pare-feu architectural : toute l'implémentation interne de llama.cpp peut être refactorisée sans casser les outils ou bindings en aval (Python, Node.js, Rust).
2.3. Enseignement de la matrice de dépendances : le pattern « bloc diagonal »
En évaluant cette configuration multi-projets dans une matrice de structure de dépendances (DSM) :
- Isolation nette des blocs : la matrice s'affiche en blocs diagonaux distincts correspondant à ggml, llama et common.
- Aucune interférence indésirable : les composants ggml ne référencent jamais llama.cpp ou common. Les composants llama dépendent de ggml mais restent totalement ignorants du code CLI haut niveau.
- Architecture enfichable : on peut retirer common/ et tools/ et lier libllama directement dans un runtime embarqué ou une application desktop avec une empreinte minimale.
3. Quantifier l'abstraction de la base de code
Les types abstraits sont largement utilisés en C++ moderne pour obtenir des designs propres axés sur le découplage, mais est-ce le cas pour llama.cpp ? Cherchons les types abstraits dans la base de code avec cette requête :
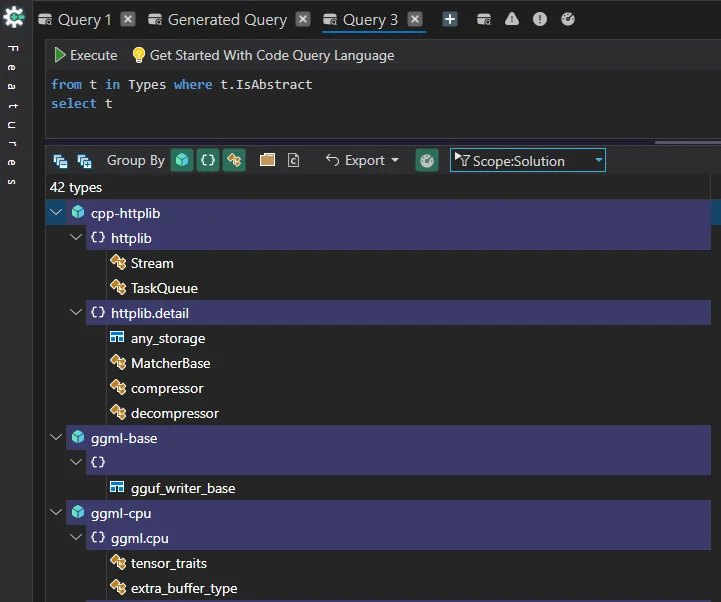
Seuls quelques types sont abstraits, et llama.cpp évite délibérément les paradigmes classiques de la programmation orientée objet (POO) comme les classes de base abstraites, le dispatch dynamique (fonctions virtuelles) et les hiérarchies d'héritage lourdes.
Ce choix de conception se résume à quatre compromis d'ingénierie fondamentaux :
3.1. Éliminer les pénalités de vtable et l'indirection
En C++ haute performance, les appels de fonctions virtuelles exigent la recherche de pointeurs de fonction dans une table virtuelle (vtable).
- Cache miss et chasse aux pointeurs : dans une boucle d'exécution de graphe de tenseurs profonde, effectuer des milliers d'appels virtuels par seconde introduit des erreurs de prédiction de branche et force les pipelines CPU à se bloquer.
- Bloqueurs d'inlining : le compilateur ne peut souvent pas inliner un appel de méthode virtuelle car le type concret n'est pas connu à la compilation. En utilisant de simples structs C, des pointeurs de fonction explicites ou des templates statiques, le compilateur peut inliner le code directement dans les itérations de boucle assembleur brutes.
3.2. Dispositions mémoire prévisibles plutôt que stockage polymorphe par pointeurs
Les classes abstraites obligent à travailler avec des pointeurs ou des smart pointers (std::unique_ptr<ITensor>) pour supporter le dispatch dynamique.
- Les pointeurs mènent à des allocations sur le tas (malloc/new), résultant en une mémoire fragmentée à travers le tas.
- ggml (le moteur de tenseurs sous-jacent) s'appuie sur des arènes bump-allouées plates et contiguës (
ggml_context). Les offsets mémoire sont pré-planifiés dans une disposition de graphe statique unique avant le début de l'exécution. Les abstractions OOP standard brisent les dispositions mémoire contiguës, détruisant la localité des caches L1/L2.
3.3. Stabilité de l'ABI à travers les bindings C et langages étrangers
llama.cpp est destiné à fonctionner partout — embarqué dans Python (llama-cpp-python), Rust, Go, Swift, C# et Node.js.
- Les hiérarchies de classes C++ modernes avec tables virtuelles ont des noms de symboles décorés par le compilateur qui diffèrent entre GCC, Clang et MSVC.
- En utilisant des structs C plats (
struct llama_model,struct llama_context) et des fonctions C (llama_decode()), llama.cpp expose une frontière ABI C propre. N'importe quel langage peut consommer un en-tête C standard sans avoir besoin d'un wrapper runtime C++ complexe.
3.4. Architecture de graphe de calcul simple vs graphes d'objets
Dans les applications logicielles standard, le polymorphisme modélise des entités métier (par ex. class Dog : public Animal). Dans les moteurs d'inférence LLM, le modèle de domaine consiste en graphes de calcul statiques et tenseurs :
- Une architecture de modèle est représentée comme une séquence de nœuds mathématiques de tenseurs (
ggml_mul_mat,ggml_add), pas comme un arbre profond d'objets. - Les variations entre backends (CUDA, Metal, Vulkan, CPU SIMD) sont gérées via des dispatches de backend statiques, des flags enum ou des pipelines d'exécution à la compilation, plutôt que par des wrappers polymorphes à l'exécution autour de chaque opération.
Résumé du compromis architectural
| Design pattern | POO / Classes abstraites | llama.cpp style C / procédural |
|---|---|---|
| Mécanisme de dispatch | Dynamique (recherches de vtable) | Statique / dispatch direct de fonctions C |
| Allocation mémoire | Pointeurs sur le tas (new/malloc) | Arène contiguë pré-allouée (ggml_context) |
| Optimisation compilateur | Limitée (les appels virtuels bloquent l'inlining) | Maximale (boucles SIMD chaudes facilement inlinées) |
| Interopérabilité des langages | Difficile (nécessite des bindings C++ complexes) | Triviale (expose une ABI C standard) |
4. Utilisation des types POD dans le modèle Llama
Les types POD (Plain Old Data) en C++ sont des structures de données simples et compatibles C qui contiennent des données sans le surcoût objet du C++ moderne.
Cherchons les types POD utilisés dans llama.cpp avec cette requête de code :
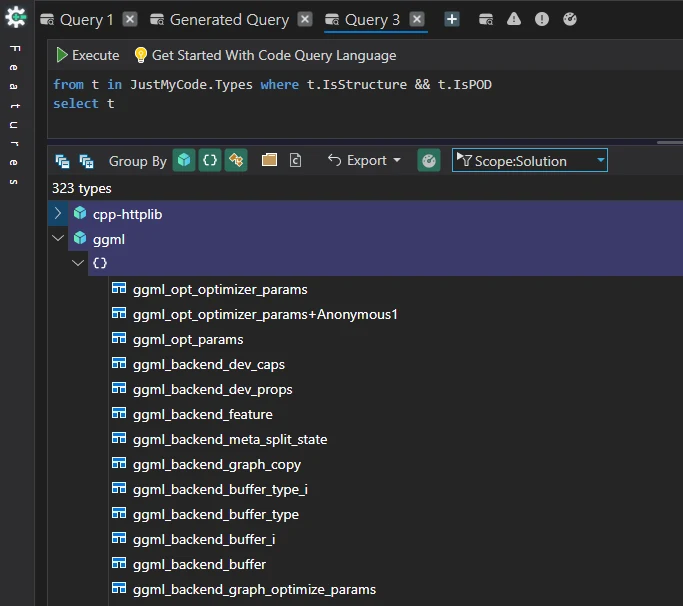
Voici pourquoi llama.cpp utilise des structs POD simples partout :
4.1. Dispositions mémoire prévisibles compatibles C
Un struct POD en C++ a une empreinte mémoire contiguë et déterministe sans pointeurs cachés insérés par le compilateur (comme un vptr pour les fonctions virtuelles).
- Sérialisation/désérialisation directe : lors du chargement des fichiers de modèle GGUF, les structures POD permettent de lire les octets bruts directement du disque vers la mémoire (fread ou mmap) directement dans le struct, sans parsing complexe, constructeurs ou allocations d'objets.
- Compatibilité ABI C : les structs POD correspondent 1:1 aux structures de données C standard. Cela permet aux langages non-C++ (Python, Rust, Go, Swift, C#) de mapper exactement la même disposition de struct en mémoire sans surcoût de marshalling.
4.2. Localité de cache extrême (efficacité des caches L1/L2)
Les CPU modernes fonctionnent des milliers de fois plus vite que la RAM principale. La performance en inférence LLM repose fortement sur le maintien des pipelines CPU/GPU alimentés en données.
- Tableaux contigus : parce que les types POD n'ont ni surcoût caché ni pointeurs de tas, ils peuvent être compactés dans des tableaux plats et contigus (
std::vector<llama_token_data>ou arènes mémoire brutes). - Prefetching séquentiel du cache : lors de l'itération sur un tableau contigu de structs POD pendant l'échantillonnage de tokens ou la gestion du cache KV, le prefetcher matériel charge sans effort les éléments suivants dans le cache L1/L2 avant même que la boucle ne les demande.
4.3. Compatible avec les allocateurs d'arène personnalisés (ggml)
Les objets C++ standard avec constructeurs/destructeurs non triviaux nécessitent new et delete, qui allouent la mémoire dynamiquement à travers le tas.
- Les allocations de tas causent la fragmentation mémoire et une latence d'allocation imprévisible.
- llama.cpp utilise des allocateurs bump/arène via
ggml_context. La mémoire brute est réservée une fois comme un énorme bloc, et les structs POD sont placés directement à cet offset mémoire pré-alloué. Comme les POD ne nécessitent pas de destructeurs, récupérer ou réinitialiser la mémoire est aussi rapide que remettre un seul pointeur à zéro (offset = 0).
4.4. Zéro surcoût à l'exécution et copie triviale
Les structs POD n'ont aucune logique cachée en arrière-plan :
- Copier ou déplacer un struct POD n'est qu'une opération rapide de copie mémoire (memcpy).
- Passer des structs POD par valeur ou par référence const n'introduit aucun appel caché de constructeur de copie ou de destructeur, donnant au développeur un contrôle total sur les performances d'exécution dans les boucles internes chaudes.
5. Empreinte et usage de la Standard Template Library (STL)
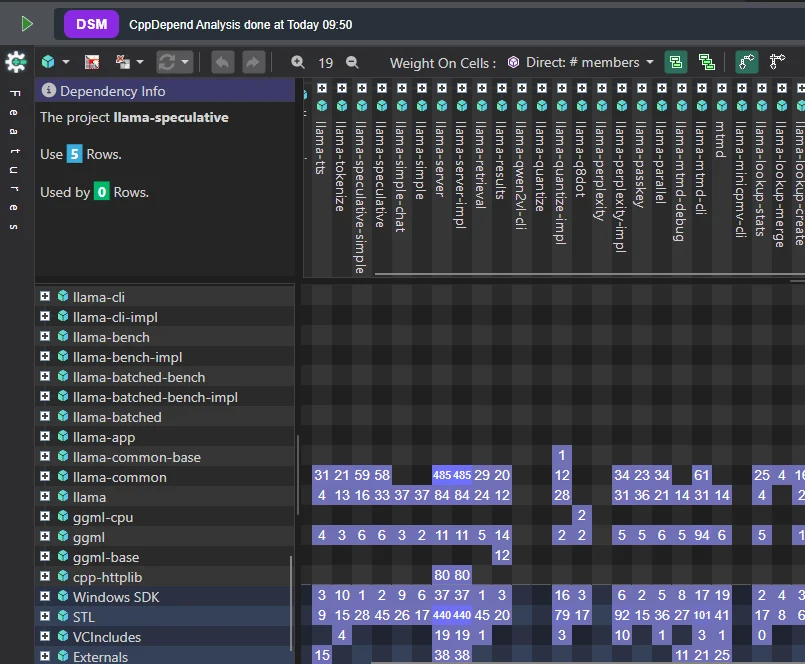
Pour voir où et comment la STL est utilisée, nous pouvons analyser la matrice de dépendances pour une vue détaillée de son usage à travers la base de code.
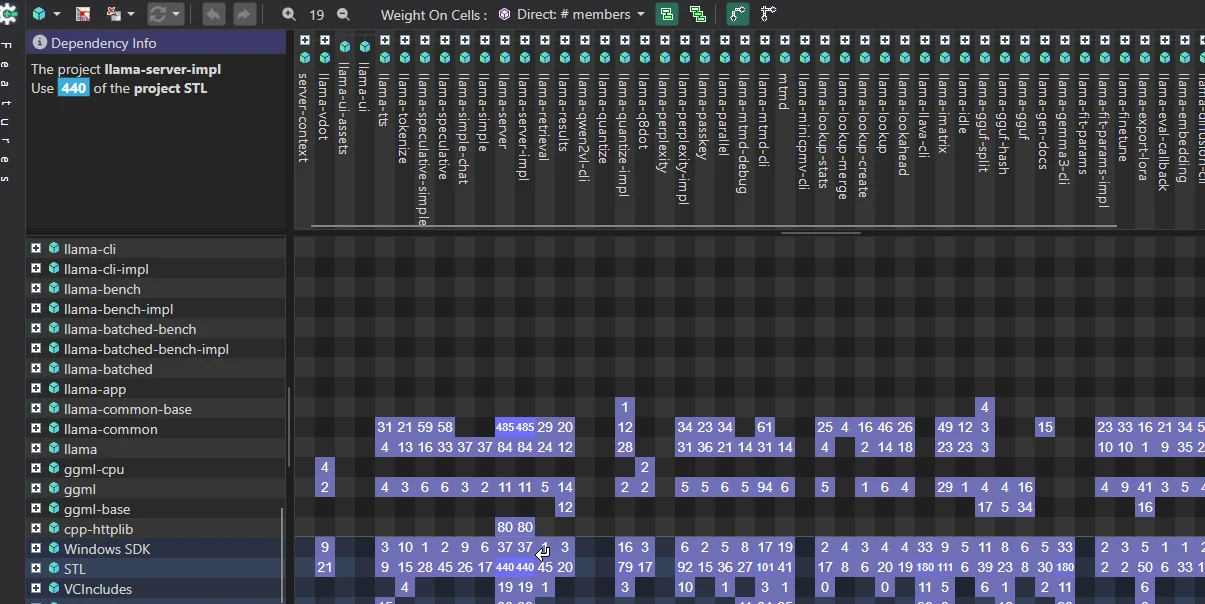
Comme on peut le voir, la STL est fortement utilisée dans les modules haut niveau, tandis que les modules bas niveau l'utilisent rarement — voire pas du tout.
5.1. llama-server : une orchestration complexe exige des abstractions haut niveau
llama-server est un démon API HTTP qui gère le multithreading, les E/S asynchrones, la gestion des slots, le parsing JSON, les files d'attente et l'état HTTP.
Il exploite fortement les fonctionnalités de la bibliothèque standard (std::*) car écrire du code d'orchestration réseau en C/C++ procédural bas niveau est impraticable :
- Concurrence et synchronisation :
std::thread,std::mutex,std::condition_variable,std::futureetstd::atomicgèrent les requêtes web entrantes et mettent en file les tâches d'inférence. - Structures de données complexes :
std::unordered_map,std::queue,std::mapetstd::vectorgèrent les slots de session multi-locataires, l'état des contextes et les séquences de tokens. - Traitement et formatage de chaînes :
std::string,std::stringstreamet les opérations regex formatent les entrées/sorties JSON pour les endpoints REST compatibles OpenAI.
5.2. Moteurs centraux (ggml et llama) : évitement de la STL pour la performance brute
En revanche, le code d'inférence bas niveau dans ggml et le cœur de llama évite l'usage profond de la STL pour des raisons de performance critiques :
- Éviter les allocations non déterministes : les conteneurs comme
std::vectoroustd::stringallouent et réallouent la mémoire sur le tas dynamiquement (malloc/free). Dans les boucles chaudes de multiplication matricielle de tenseurs, les allocations dynamiques déclenchent des appels système OS et introduisent des pics de latence de queue. ggml utilise à la place des arènes mémoire statiques pré-allouées (ggml_context). - Taille binaire et vitesse de compilation : la lourde expansion de templates STL C++ (
<iostream>,<regex>,<algorithm>) gonfle drastiquement les tailles binaires et ralentit les temps de compilation. Garder les fichiers de calcul centraux minimaux permet une compilation rapide sur les systèmes embarqués et les micro-runtimes légers. - Portabilité maximale et exécution bare-metal : ggml fonctionne sur des plateformes à ressources contraintes, WASM (navigateurs web), microcontrôleurs et accélérateurs matériels personnalisés où un environnement runtime C++ standard complet pourrait être réduit, absent ou inefficace.
6. Usage des exceptions
Les exceptions C++ sont strictement évitées dans les couches de calcul internes (ggml et llama), bien que des exceptions apparaissent dans les wrappers auxiliaires haut niveau (llama-common, common/arg.cpp et llama-server).
Découvrons quels modules utilisent la classe std::exception avec cette requête de code :
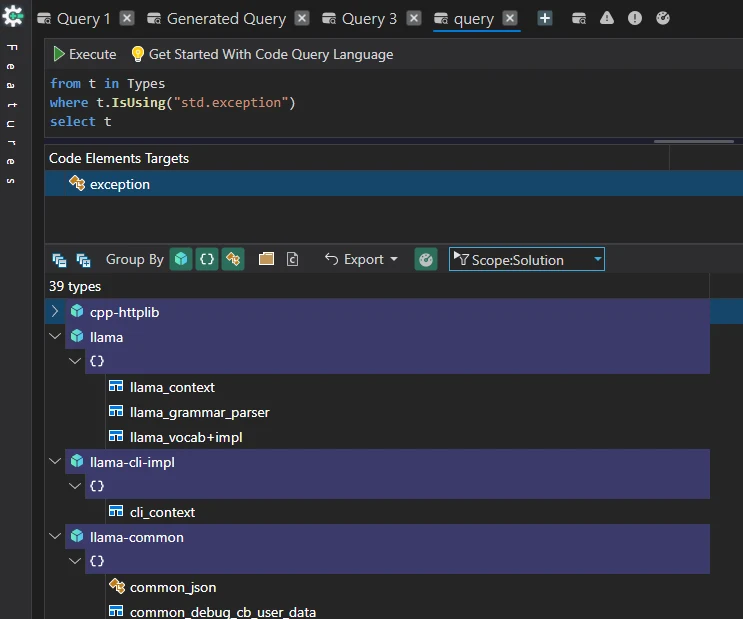
llama.cpp suit une séparation stricte dans sa gestion des erreurs à travers son architecture :
6.1. ggml et cœur de llama : codes d'erreur à la C et assertions
Dans les couches de fondation, la gestion des exceptions est intentionnellement omise :
- Codes de retour et pointeurs nuls : des méthodes comme
llama_decode(),llama_model_load()ou les routines d'allocation internes retournent nullptr, des codes d'état d'erreur entiers (0, -1) ou des flags booléens au lieu de lancerstd::exception. - Assertions explicites : les vérifications d'invariants irrécupérables (comme des dimensions de tenseurs incompatibles ou une exécution de contexte hors limites) utilisent des macros d'assertion (
GGML_ASSERT/assert()) qui interrompent immédiatement ou journalisent les erreurs de façon sûre plutôt que de dérouler la pile. - Sécurité de la frontière ABI C : l'API publique principale exposée par llama.h est une ABI C. Lancer des exceptions C++ à travers une frontière de langage C est un comportement indéfini en C++, donc les fonctions centrales ne doivent pas laisser d'exceptions s'échapper.
6.2. Wrappers haut niveau (llama-common et llama-server) : exceptions C++ sélectives
Les exceptions apparaissent dans l'outillage haut niveau pour le confort du développeur :
- Parsing d'arguments CLI (arg.cpp) : lance
std::runtime_erroroustd::invalid_argumentlors du parsing des paramètres de ligne de commande (par ex. options de flag malformées ou chemins de modèle manquants). - Serveur et bibliothèques tierces (llama-server) : consomme des bibliothèques comme nlohmann::json ou des parseurs HTTP qui lancent naturellement des exceptions lors du parsing de payloads incorrects. Celles-ci sont interceptées dans des blocs try/catch au niveau supérieur de la boucle du serveur.
Pourquoi l'inférence centrale évite les exceptions
- Zéro surcoût de déroulement de pile : activer les exceptions (-fexceptions) introduit du gonflement de code binaire et des chemins de flux de contrôle cachés. Désactiver ou éviter les exceptions dans les boucles chaudes garde les pipelines d'exécution SIMD et les optimisations du compilateur agressives.
- Flux de contrôle déterministe : les opérations matricielles LLM et les arènes mémoire (
ggml_context) exigent un nettoyage explicite. Une exception lancée peut facilement contourner les destructeurs d'arène personnalisés non-RAII, menant à des fuites mémoire GPU/CPU massives. - Sécurité inter-langages : les bindings de langages (Python, Rust, C#, Go) attendent de simples codes de retour à la C pour mapper proprement les exceptions dans leurs runtimes natifs respectifs.
7. Usage des namespaces
En C++ moderne, les namespaces sont des frontières de portée utilisées pour organiser le code en groupes logiques et prévenir les collisions de noms entre bibliothèques.
Explorons si les namespaces sont largement utilisés dans llama.cpp :
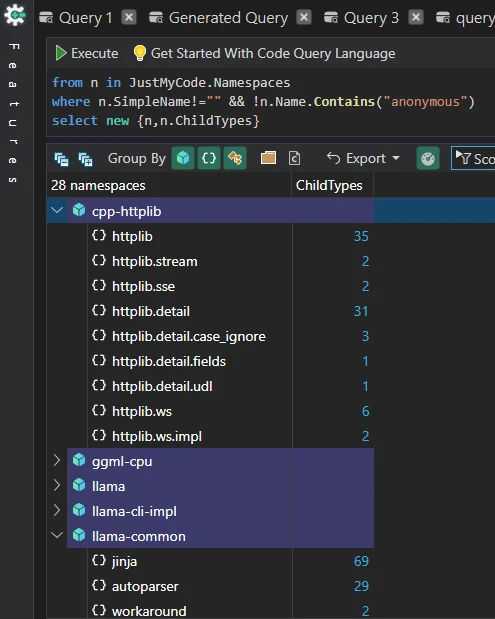
Les namespaces sont proéminents dans cpp-httplib et llama-common, mais pratiquement absents des autres bibliothèques. Voici quelques raisons de ce pattern :
7.1. Le moteur central (ggml) est du C pur
La fondation de llama.cpp est la bibliothèque d'évaluation de tenseurs ggml. ggml est écrit en C standard (C99/C11) pour garantir une exécution portable à travers les backends matériels (CPU, CUDA, Metal, Vulkan, OpenCL).
- Comme C ne supporte pas les namespaces, ggml utilise des préfixes
ggml_explicites pour les fonctions et structs (par ex.ggml_init,ggml_tensor,ggml_cgraph) afin d'isoler les symboles sans avoir besoin de namespaces C++.
7.2. Stabilité de l'ABI et compatibilité API C
L'un des objectifs de conception principaux de llama.cpp est de servir de moteur léger et embarquable pour des bindings dans d'autres langages (Python, Rust, Go, Java, Swift, C#).
- Décoration de noms C++ : les namespaces C++ modifient les noms de symboles exportés à la compilation.
- Pour exposer des symboles propres et non décorés qui fonctionnent de façon transparente avec dlopen et les wrappers FFI C, les en-têtes centraux exportent des ABI C simples (
extern "C"). Éviter les hiérarchies de namespaces profondes simplifie l'export des frontières de bibliothèques partagées (llama.h, ggml.h).
7.3. Structures de données à la C et types POD
llama.cpp privilégie les structs POD (Plain Old Data), les fonctions statiques et les signatures de fonctions explicites plutôt que les hiérarchies C++ orientées objet.
- L'isolation du code est gérée via des unités de compilation (fonctions statiques à portée fichier) dans les fichiers .cpp plutôt qu'en encapsulant les composants dans des blocs imbriqués
namespace llama { namespace detail { ... } }. - Cela maintient la pollution du namespace global à un niveau bas tout en préservant le contrôle mémoire direct et la visibilité statique dans les fichiers d'implémentation individuels.
7.4. Philosophie minimaliste « C++ zéro surcoût »
llama.cpp suit une variante minimaliste de C++ souvent décrite comme « C with Classes » ou « Data-Oriented C++ ».
- La base de code utilise sélectivement des fonctionnalités C++ standard (comme
std::vector,std::stringoustd::thread) pour simplifier la gestion mémoire et la concurrence, tout en évitant les namespaces profondément imbriqués, la métaprogrammation de templates lourde ou les hiérarchies d'héritage de classes complexes.
8. Usage des templates
En C++, la programmation générique via les templates permet d'écrire des algorithmes et structures de données réutilisables et sûrs en types sans pénalité de performance à l'exécution. En générant le code à la compilation, les templates éliminent l'indirection, permettent un inlining profond par le compilateur et optimisent la performance directement pour les types concrets.
Explorons si des templates sont définis dans llama.cpp :
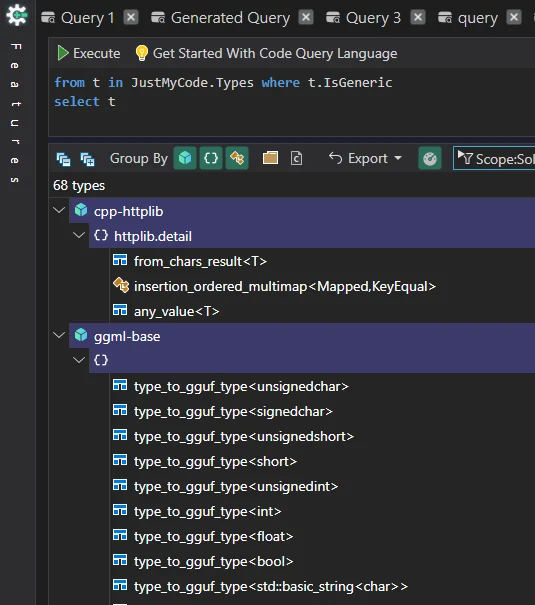
Et pour explorer visuellement où les templates sont définis, nous pouvons exporter le résultat de la requête vers la vue treemap :
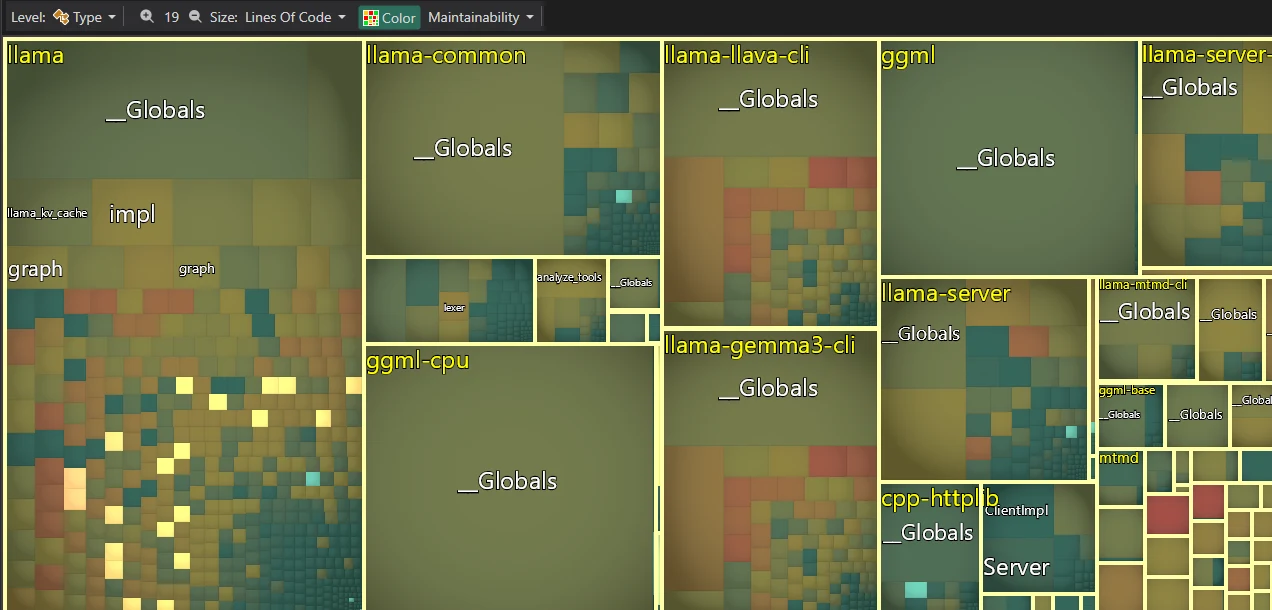
Les types concernés sont surlignés, et comme le montre la treemap, ils sont définis dans quelques bibliothèques, notamment la bibliothèque llama.
Au lieu de s'appuyer sur la généricité C++ riche en templates, llama.cpp choisit du code procédural à la C, un dispatch dynamique via des enums (ggml_type) et des macros, pour des raisons d'ingénierie spécifiques :
8.1. Éliminer le gonflement du code template (inflation de la taille binaire)
Quand on instancie des templates C++ sur plusieurs types de données (par ex. float, fp16, int8, int4), le compilateur génère une copie séparée du code machine pour chaque permutation de type.
- Cache miss d'instructions : les fonctions dupliquées instanciées par templates gonflent la taille de l'exécutable final. Les gros binaires sollicitent le cache d'instructions (I-Cache) du CPU, causant des cache miss qui ralentissent les boucles d'exécution.
- Partage de code procédural : ggml utilise un dispatch enum explicite (
switch (type)) pour partager des points d'entrée d'implémentation uniques plutôt que de gonfler le segment de code avec des fonctions templatisées.
8.2. Réduction drastique du temps de compilation
La métaprogrammation de templates C++ lourde augmente sévèrement les temps de build car les en-têtes doivent être parsés, expansés et compilés à répétition à travers les unités de traduction.
- En utilisant des structs C plats (
struct ggml_tensor), des flags enum basiques (GGML_TYPE_F32,GGML_TYPE_Q4_0) et de simples en-têtes C, llama.cpp compile en quelques secondes — même sur des appareils lents comme un Raspberry Pi ou un laptop modeste — alors que des bibliothèques C++ fortement templatisées (comme PyTorch C++ ou Eigen) peuvent prendre plus de 20 minutes à compiler.
8.3. Typage dynamique à l'exécution vs généricité statique à la compilation
Dans les runtimes de Machine Learning, les types de données des tenseurs, les dimensions et les graphes d'exécution sont souvent déterminés à l'exécution (par ex. chargement d'un modèle GGUF avec des quantifications mixtes Q4_K_M et Q8_0).
- Les templates C++ exigent que les types soient fixés à la compilation.
- Si ggml s'appuyait sur la généricité C++ pour les types de tenseurs, chaque combinaison de types de modèles devrait être pré-compilée dans d'énormes matrices de templates, ou le code devrait recourir à des blocs d'expansion de templates massifs.
- Utiliser un enum de type à l'exécution (
ggml_tensor->type = GGML_TYPE_Q4_K) permet à une structure C unique et uniforme de représenter n'importe quel type de tenseur dynamiquement en mémoire sans paramètres de template.
8.4. Backends accélérateurs GPU et SIMD simplifiés
llama.cpp décharge les calculs de tenseurs sur divers backends matériels (CUDA, Metal, Vulkan, OpenCL, AVX-512, ARM NEON).
- Écrire des kernels device pour GPU ou des intrinsics SIMD bruts exige un contrôle fin sur la disposition assembleur bas niveau, l'alignement mémoire et l'usage des registres.
- Abstraire les boucles SIMD/GPU internes derrière des templates génériques C++ complexes rend significativement plus difficile l'inspection de l'assembleur généré, le débogage des problèmes d'alignement vectoriel ou l'optimisation des registres SIMD spécifiques au matériel.
Résumé du contraste architectural
| Fonctionnalité | Templates génériques (template<typename T>) | Enums dynamiques llama.cpp (ggml_type) |
|---|---|---|
| Décision de type | À la compilation | À l'exécution |
| Taille binaire | S'étend par type (gonflée) | Implémentation procédurale unique (légère) |
| Vitesse de compilation | Lente (parsing d'en-têtes lourd) | Extrêmement rapide |
| Introspection matérielle | Obscurcie par les couches d'abstraction | Contrôle direct C / registres SIMD |
9. Quelques faits sur les choix de conception
9.1. Types avec trop de méthodes
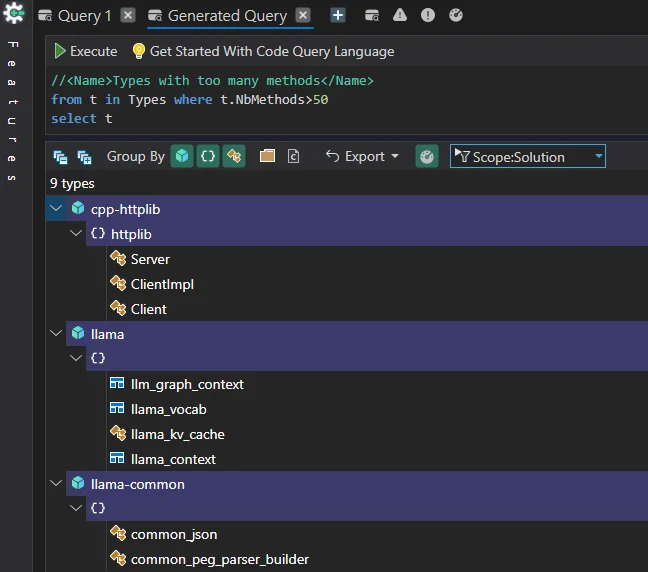
Quelques types ont un grand nombre de méthodes, mais dans llama.cpp, chaque cas a une raison d'ingénierie valide. Par exemple, voici pourquoi de tels types sont attendus dans une bibliothèque HTTP :
- Architecture header-only autonome : cpp-httplib est intentionnellement conçue comme une bibliothèque HTTP en un seul en-tête pour un embarquage multiplateforme facile. Pour garder l'intégration tierce simple et éviter des graphes de dépendances complexes, les fonctionnalités du protocole sont encapsulées directement dans les abstractions client et serveur principales.
- API fluide et conviviale pour le développeur : un client ou serveur HTTP complet nécessite naturellement un large éventail de méthodes pour gérer les diverses options de requêtes, en-têtes, timeouts et callbacks, sans forcer les utilisateurs finaux à câbler des objets handlers sous-jacents séparés.
- Pattern de délégation interne : httplib::Client délègue son travail central à httplib::ClientImpl. Alors que ClientImpl accumule la logique bas niveau de sockets, SSL et transport, cette séparation protège proprement l'API publique Client des détails internes spécifiques à la plateforme.
9.2. Types non cohésifs
La cohésion de type (ou cohésion de classe en programmation orientée objet) mesure à quel point les responsabilités, champs et méthodes d'un type unique sont étroitement liés et focalisés.
Explorons combien de types non cohésifs nous avons dans llama.cpp :
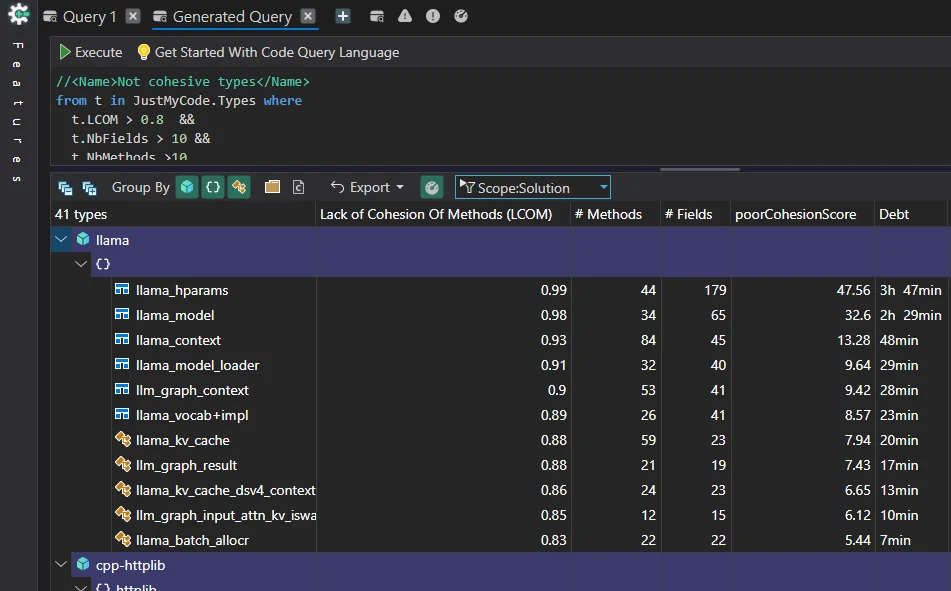
Pourquoi une faible cohésion est intentionnelle pour certaines métadonnées de modèle
- Pattern de données POD / DTO :
llama_hparamsagit comme un Data Transfer Object (DTO) ou un struct à la C plutôt qu'une classe de domaine orientée objet avec état. Sa seule responsabilité est de contenir l'état complet des hyperparamètres du modèle parsé depuis les en-têtes de métadonnées GGUF. - Représentation unifiée de l'architecture de modèle : les architectures Transformer modernes (Llama, Mistral, Gemma, Qwen) nécessitent un vaste ensemble de flags de configuration. Regrouper ces paramètres dans un struct d'hyperparamètres unifié unique garantit que les routines d'allocation de tenseurs, les calculateurs de cache KV et les graphes d'exécution reçoivent les métadonnées complètes du modèle dans un seul bloc mémoire.
- Découplage des données et de la logique d'exécution : dans la conception de moteurs C/C++, les structures de données (
llama_hparams) sont maintenues découplées des algorithmes de traitement (graphes de calcul ggml). Forcer des règles de cohésion à la OOP sur des structures de données passives ajoute un surcoût d'abstraction inutile sans améliorer les performances ou la sécurité.
9.3. Méthodes trop grosses
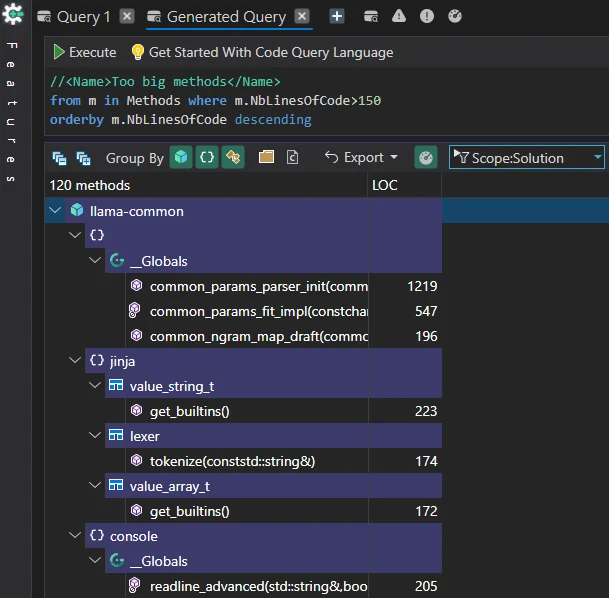
Dans les bases de code C++ haute performance comme llama.cpp, certains design patterns — comme les dispatcheurs de configuration centraux ou les énormes switches d'exécution matérielle — sont totalement attendus et pratiques.
Étude de cas : common_params_parser_init
CppDepend signale common_params_parser_init (située dans llama-common) en raison de son nombre de lignes élevé et de sa complexité cyclomatique :
- Pourquoi l'analyse statique la signale : elle contient des dizaines de définitions de flags de ligne de commande, de blocs de parsing d'arguments, de règles de formatage de chaînes d'aide et de valeurs par défaut de repli en un seul endroit.
- Pourquoi c'est une pratique d'ingénierie normale : les parseurs d'arguments CLI pour les grands modèles ML accumulent naturellement des centaines de paramètres (
--n-gpu-layers,--ctx-size,--temp,--rope-scaling, etc.). Découper cette initialisation en dizaines de petites fonctions auxiliaires fragmenterait les définitions de paramètres et réduirait la lisibilité du code sans apporter de réels bénéfices architecturaux.
9.4. Grosses méthodes non commentées
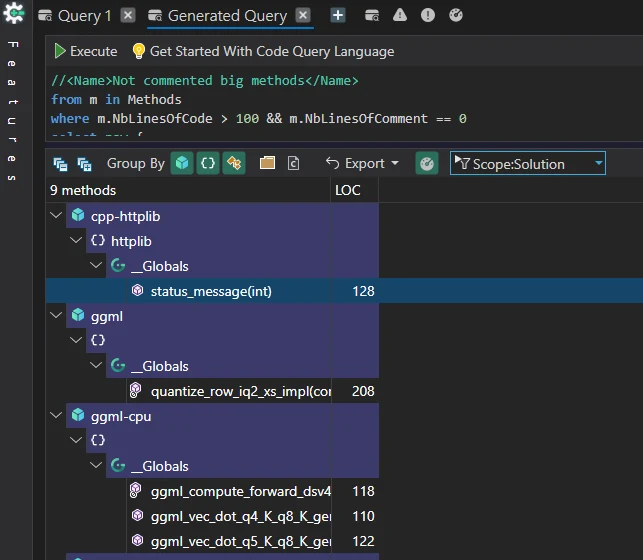
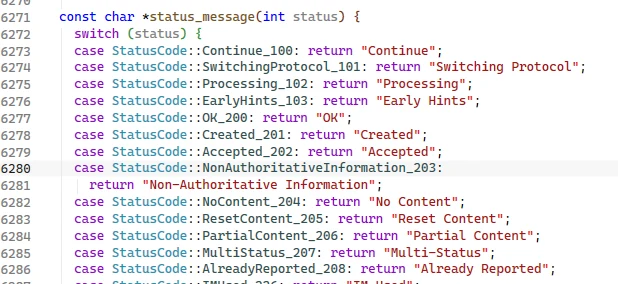
Bien qu'il y ait quelques grosses méthodes non commentées, un examen plus attentif de fonctions comme status_message montre que les commentaires sont inutiles car le code est auto-explicatif.
Conclusion : l'ingénierie au-delà du linter
Analyser llama.cpp par l'analyse statique de code révèle une dualité fascinante. Au niveau micro, les métriques de longueur de fonction et les avertissements de complexité cyclomatique déclenchent des alertes de « code smell » traditionnelles. Pourtant au niveau macro, l'architecture démontre une discipline structurelle exceptionnelle — portée par une isolation stricte des couches, zéro dépendance cyclique et un découplage de modules propre aligné sur GRASP.
llama.cpp prouve que la performance C++ de classe mondiale ne consiste pas à adhérer dogmatiquement aux design patterns OOP ou aux règles de linter critiques pour la sécurité. Il s'agit de faire des compromis d'ingénierie intentionnels : sacrifier l'élégance au niveau micro dans les chemins d'exécution chauds pour atteindre une localité maximale du cache d'instructions, un dispatch matériel sans surcoût et une vitesse d'exécution affûtée comme une lame.